

2026/11/22
AIニュース
Google、Gemini APIにTool Retrievalを導入 AIエージェントのツール定義を必要な時だけ読み込み
この記事の要点
Googleは、必要なツールの引数仕様だけを読み込むTool RetrievalをGemini APIでプレビュー公開しています。多数の業務機能を接続する際の入力削減が狙いですが、検索処理や取得済みスキーマにも課金が発生します。企業の導入判断では、ツールの利用頻度と会話全体の費用・応答時間・処理品質を実測することが必要です。
目次
業務ツールが増えるほど膨らむ「説明書」の負担
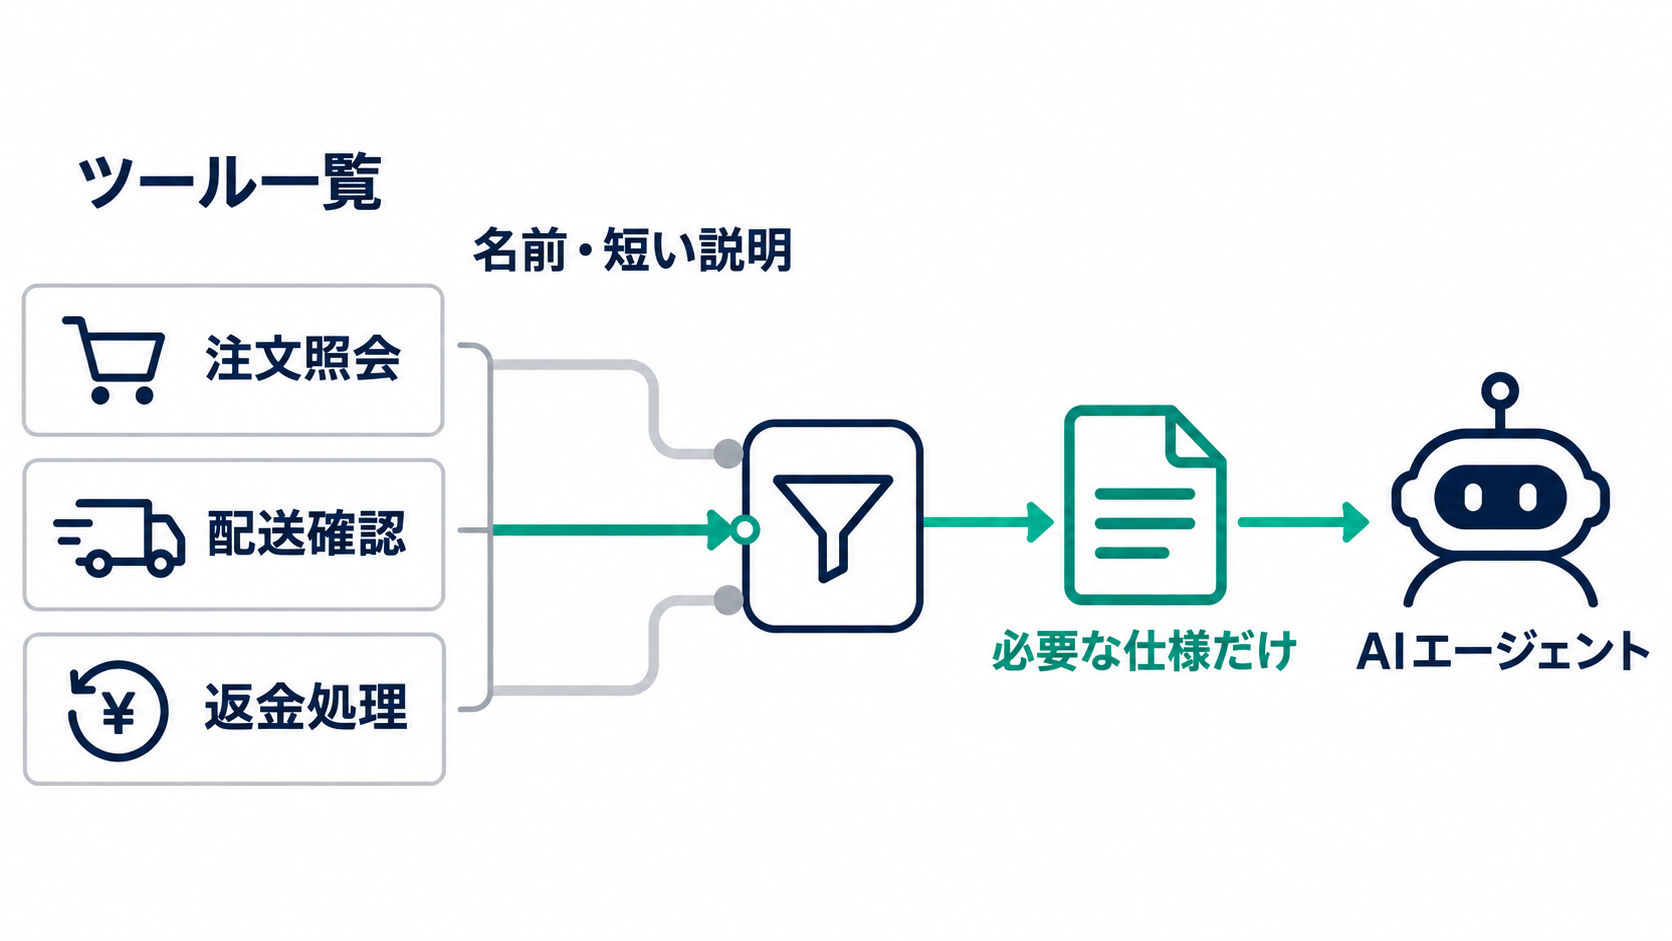
問い合わせ対応のAIエージェントに、注文照会、配送確認、返金処理と機能を追加していくと、利用者の依頼を処理する前の段階で入力が膨らみます。モデルに渡す情報には会話だけでなく、利用できる各機能の説明や引数の仕様も含まれるためです。実際には使わない機能まで毎回詳しく説明すれば、その分も処理対象になります。
Googleは、この負担に対応するTool RetrievalをGemini APIのInteractions APIでプレビュー公開しています。中心となる仕組みは、ツールの引数を定義する「パラメータスキーマ」の遅延読み込みです。利用可能なツールを待機させておき、現在の依頼に必要な仕様だけをモデルの処理対象に加えます。Googleの発表で概要を確認できます。
ここでいうツールは、AIが外部の処理を呼び出すための関数などを指します。パラメータスキーマは、その処理に何を渡すかを定める説明書に相当します。たとえば返金処理なら、注文番号や金額といった入力項目の型、必須項目の指定などです。ツールの名前が短くても、こうした定義が積み重なると入力は長くなります。
企業が注目すべき点は、接続できる機能の多さと、毎回モデルに読ませる仕様の量を切り離せることです。ただし、遅延読み込みを有効にすれば必ず安くなるわけではありません。検索にも処理が発生するため、導入判断ではツール数だけでなく、実際にどの機能を何回使うかを見る必要があります。今回の機能は、業務連携を増やす際の入力設計を見直す選択肢として捉えるのが適切でしょう。
名前と短い説明から選び、引数の仕様を後から取得
サーバー側でTool Retrievalを利用する場合、リクエストのtools配列に、typeをtool_searchとする項目を追加します。そのうえで、読み込みを遅らせたい関数にdefer_loading: trueを設定します。モデルにはツールの名前と短い説明が見えますが、引数の詳しいスキーマは必要になるまで読み込まれません。
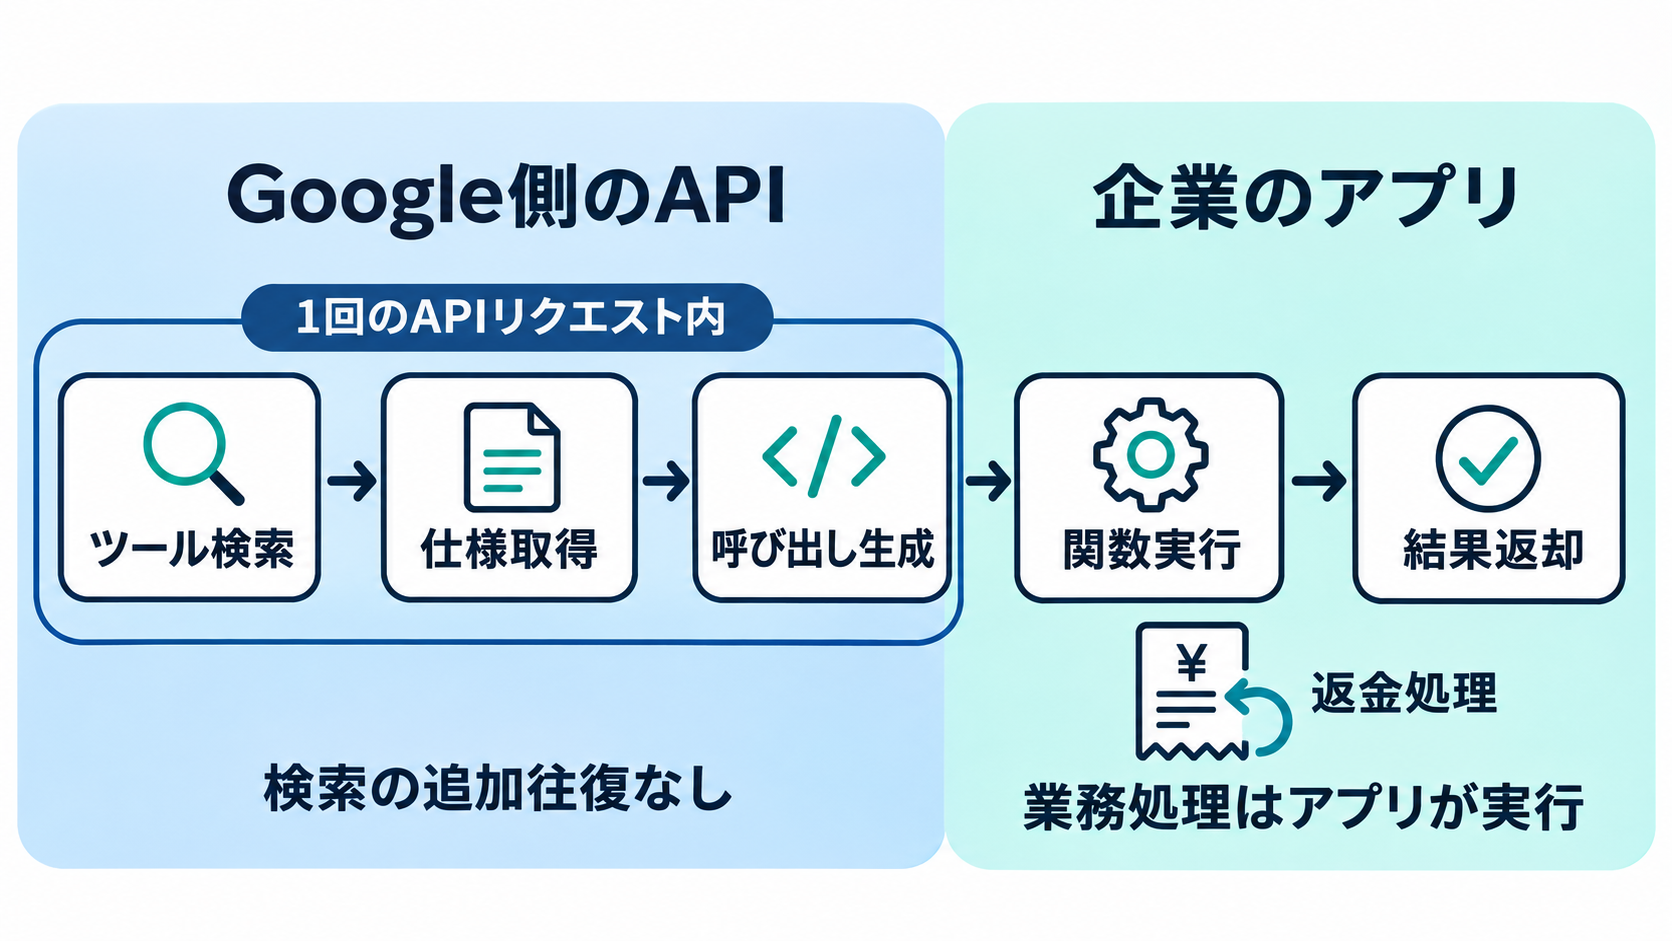
返金依頼を例にすると、モデルは利用可能な機能の概要から返金用の関数を選び、その関数の仕様を取得してから、注文番号や金額を含む呼び出しを生成します。応答には、検索要求のtool_search_call、仕様取得結果のtool_search_result、実行要求のfunction_callという段階が現れます。前の二つはAPI側で処理され、アプリケーションは通常の関数呼び出しと同様に、実処理を実行してfunction_resultを返します。
サーバー側の方式では、検索、スキーマ読み込み、関数呼び出しの生成までが一つのAPIリクエスト内で進みます。ただし、アプリケーションが実行する返金処理や、その結果を返す通信まで不要になるという意味ではありません。追加の検索用往復をアプリケーション側で実装せずに済む点が利点です。
この仕組みでは、名前と短い説明がツールを選ぶ入口になります。企業側の設計としては、似た名前の機能を並べるだけでなく、「返金する機能」と「返金状況を照会する機能」の違いが伝わる説明に整えるとよいでしょう。遅延読み込みを設定した関数には、任意のshort_descriptionも指定できます。説明を短くする際は、文字数を削ることより、機能を取り違えないための情報を残すことが優先されます。
検索をGoogleに任せるか、自社で制御するか
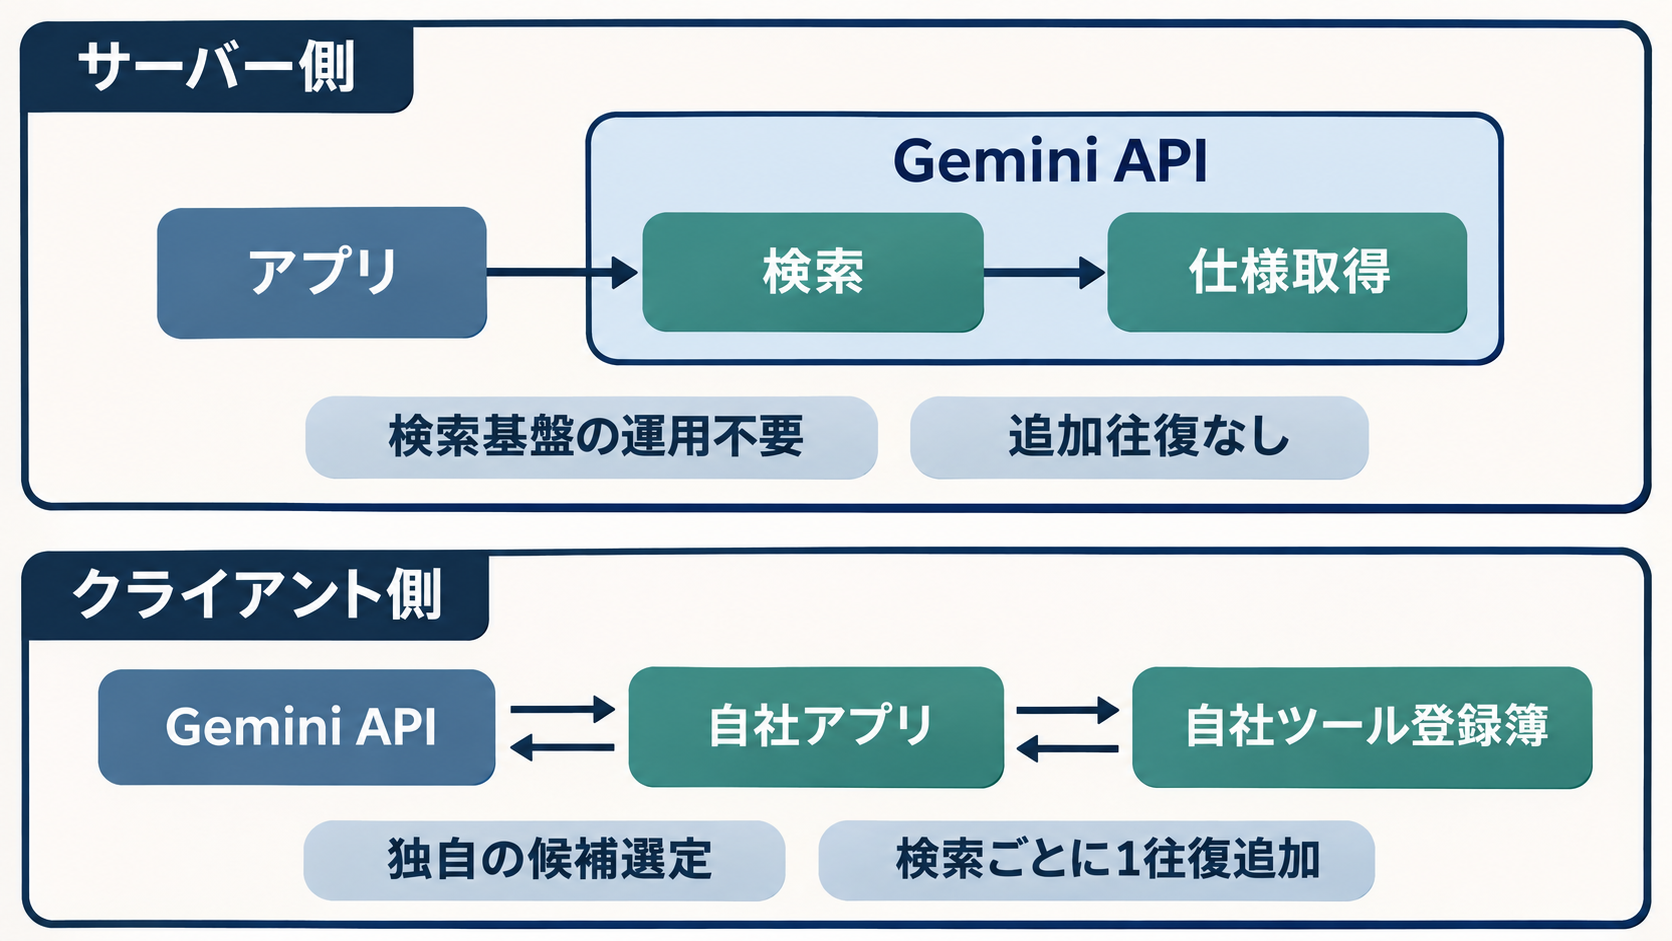
Tool Retrievalには、標準のサーバー側検索と、アプリケーション側で検索するクライアント側検索があります。サーバー側ではGoogle側が検索を担うため、専用の検索インデックスを自社で構築・運用する必要がありません。利用するツールがあらかじめ分かっており、検索基盤の管理を増やしたくない場合に検討しやすい構成です。
クライアント側を選ぶ場合は、tool_searchにexecution: clientを設定します。アプリケーションが自社のツール登録簿や検索インデックスを参照し、該当する関数定義をfunction_result.resultで返します。初回のtools配列に含めていなかった機能も、会話の途中から提示できます。ただし、検索のたびにAPIとの往復が一回増えるため、独自制御の柔軟さと応答時間の両面で判断する必要があります。
| 比較項目 | サーバー側 | クライアント側 |
| --- | --- | --- |
| 検索の実行主体 | Google側 | 自社アプリケーション |
| 自社の検索基盤 | 不要です | 自社で用意します |
| 検索ごとの追加往復 | ありません | 1回増えます |
| 会話途中のツール追加 | 事前に宣言したツールを扱います | 初回に未宣言のツールも提示できます |
日本企業での活用を考えるなら、利用者や部門によって提示する機能を変えたい場面が、クライアント側検索の検討対象になります。検索時に権限で候補を絞る設計が可能だからです。ただし、候補として提示する制御と、実行時に処理を許可する認可は役割が異なります。検索結果に含まれたことだけを根拠に、業務処理を許可する設計にはできません。
一つのリクエストに指定できるtool_searchは一つで、両方式の併用はできません。検索精度、応答時間、運用負担のうち、どこに自社固有の要件があるかを整理すると、方式を選びやすくなります。
追加料金なしでも、検索と会話継続に費用が発生
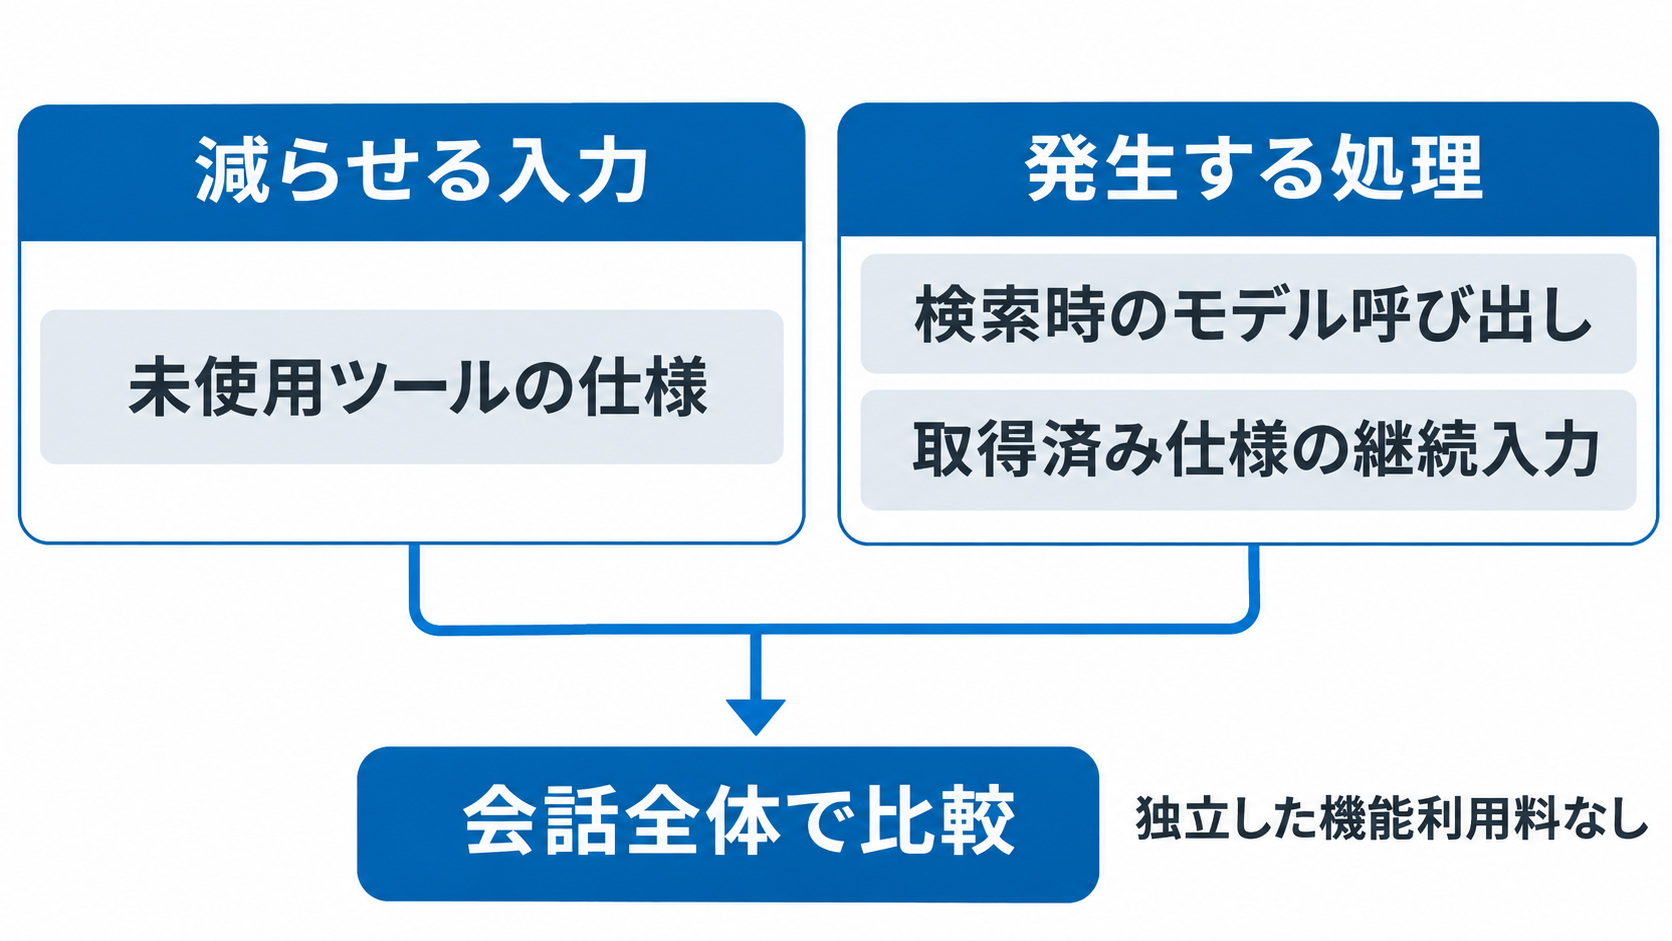
Tool Retrievalに独立した機能利用料はありません。トークンは利用モデルの通常の入力、キャッシュ、出力の料金体系で課金されます。ただし、「追加料金なし」を「検索に費用がかからない」と読むと、見積もりを誤るおそれがあります。遅延読み込みで省ける入力と、検索によって増える処理を合わせて評価する必要があります。
Googleの仕様では、サーバー側検索のたびに、会話全体と読み込み済みスキーマを含む追加のモデル呼び出しが内部で発生します。その入力トークンはtotal_tool_use_tokensに計上され、入力料金で課金されます。また、取得したスキーマは会話中に残り、その後も入力として課金対象になります。詳細は料金とトークン使用量の説明に記載されています。
この性質から、候補の大半を使わない業務では、遅延読み込みによる入力削減が期待できます。反対に、少数の機能を毎回ほぼすべて使う処理では、検索を挟む利点が小さくなると考えられます。Googleは、安定したツールが20個未満の場合、静的な読み込みを選択肢として示しています。これは利用上限ではなく、構成を選ぶ際の目安です。
長い会話では、途中までに多くのスキーマを取得すれば、その後に残る入力も増えていきます。短い問い合わせを一件ずつ完了する使い方と、複数の業務を一つの会話で続ける使い方では、同じツール群でも費用の傾向が変わるでしょう。
測定では、最初の一回の入力削減だけを見るべきではありません。検索回数、読み込んだスキーマ、会話終了までの総トークン数を記録し、業務一件を完了する費用で比較すると判断しやすくなります。使用頻度の高い関数を最初から読み込み、利用頻度の低い関数だけを遅延させる構成も検証候補です。
MCP連携とキャッシュは、読み込みの単位に注意
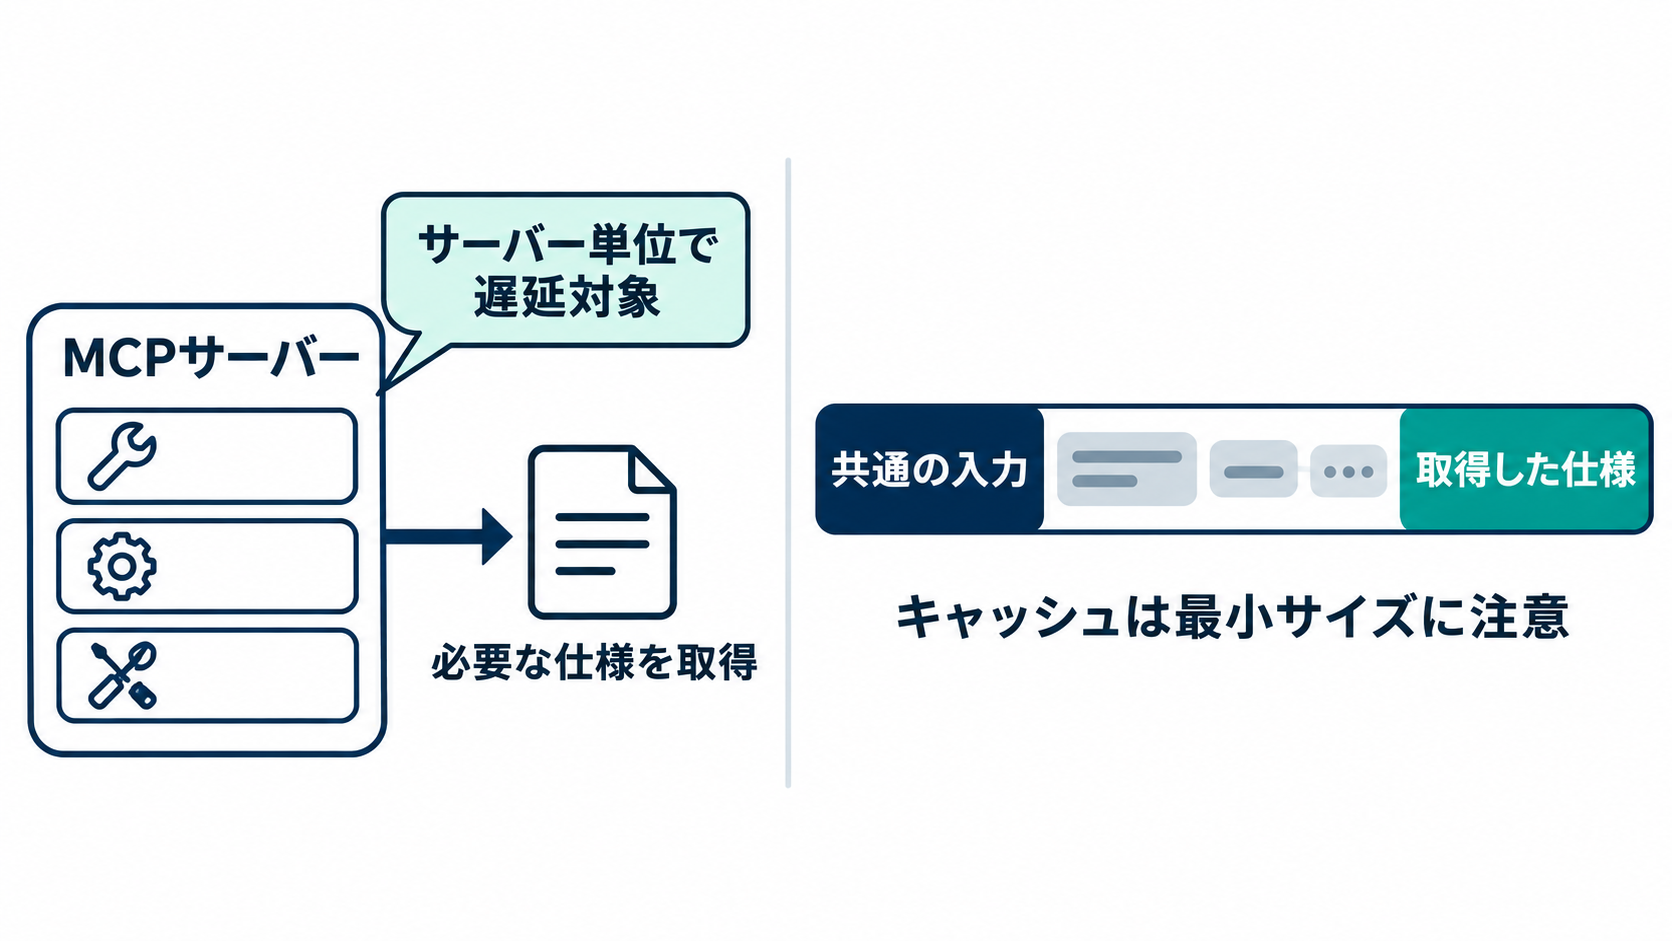
Tool Retrievalは、外部サービスとの接続に使われるMCPにも対応します。MCPはModel Context Protocolの略で、AIアプリケーションと外部のツールやデータをつなぐための共通仕様です。Gemini APIでは、mcp_serverの項目にdefer_loading: trueを設定すると、そのサーバーが公開するツール全体を遅延読み込みの対象にできます。
企業にとっては、接続先が多数の機能をまとめて公開している場合でも、それぞれの詳しい仕様を最初からモデルに読み込ませずに済む点が実務上の利点です。遅延対象のMCPツールも、Gemini APIのMCP対応を通じてリモートで実行されます。前の章で扱った、自社アプリケーションが通常の関数を実行する流れとは、実行主体を区別して把握しておく必要があります。
入力の再利用に関わるキャッシュも確認事項です。遅延したスキーマはプロンプトの先頭部分に入らず、取得時に会話内へ追加されます。この構成では、先頭部分を再利用する暗黙的キャッシュを引き続き利用できます。ただし、キャッシュにはモデルごとの最小サイズがあり、遅延読み込みで入力が短くなると、その基準を下回る可能性があります。
そのため、入力トークン数が減った割合と、請求額が下がった割合は一致するとは限りません。従来はキャッシュされていた入力が、構成変更後には対象外になる場合も考えられるからです。費用を比較する際は、総入力だけでなく、キャッシュの適用状況も確認したいところです。
MCPの接続先を増やす検証では、公開されるツール数だけを記録するのでは足りません。実際に呼ばれる機能、取得されるスキーマ、会話の長さを併せて観察すると、どのサーバーを遅延対象にするか検討しやすくなります。接続の拡張と入力の効率化を、同じ測定の中で扱うことが有効です。
導入判断は、自社の業務一件あたりの実測から
Tool Retrievalは、2026年11月22日時点でプレビュー段階にあり、Interactions APIのv1betaで利用する機能です。既存システムに組み込む場合は、利用中のAPIとの違いを確認する必要があります。試験導入では、APIの対応状況だけでなく、検索結果と関数呼び出しを現在のアプリケーションが正しく扱えるかまで確認しておきたいところです。
ツール検索に相当する機能は、AnthropicやOpenAIも提供しています。ただし、各社が公表する削減率は、それぞれのモデルやタスクで測定された値です。今回のGoogleの公開情報では、同条件で比較できる削減率や精度の数値は示されていません。他社の割合をそのままGemini導入時の見積もりに使うことはできません。
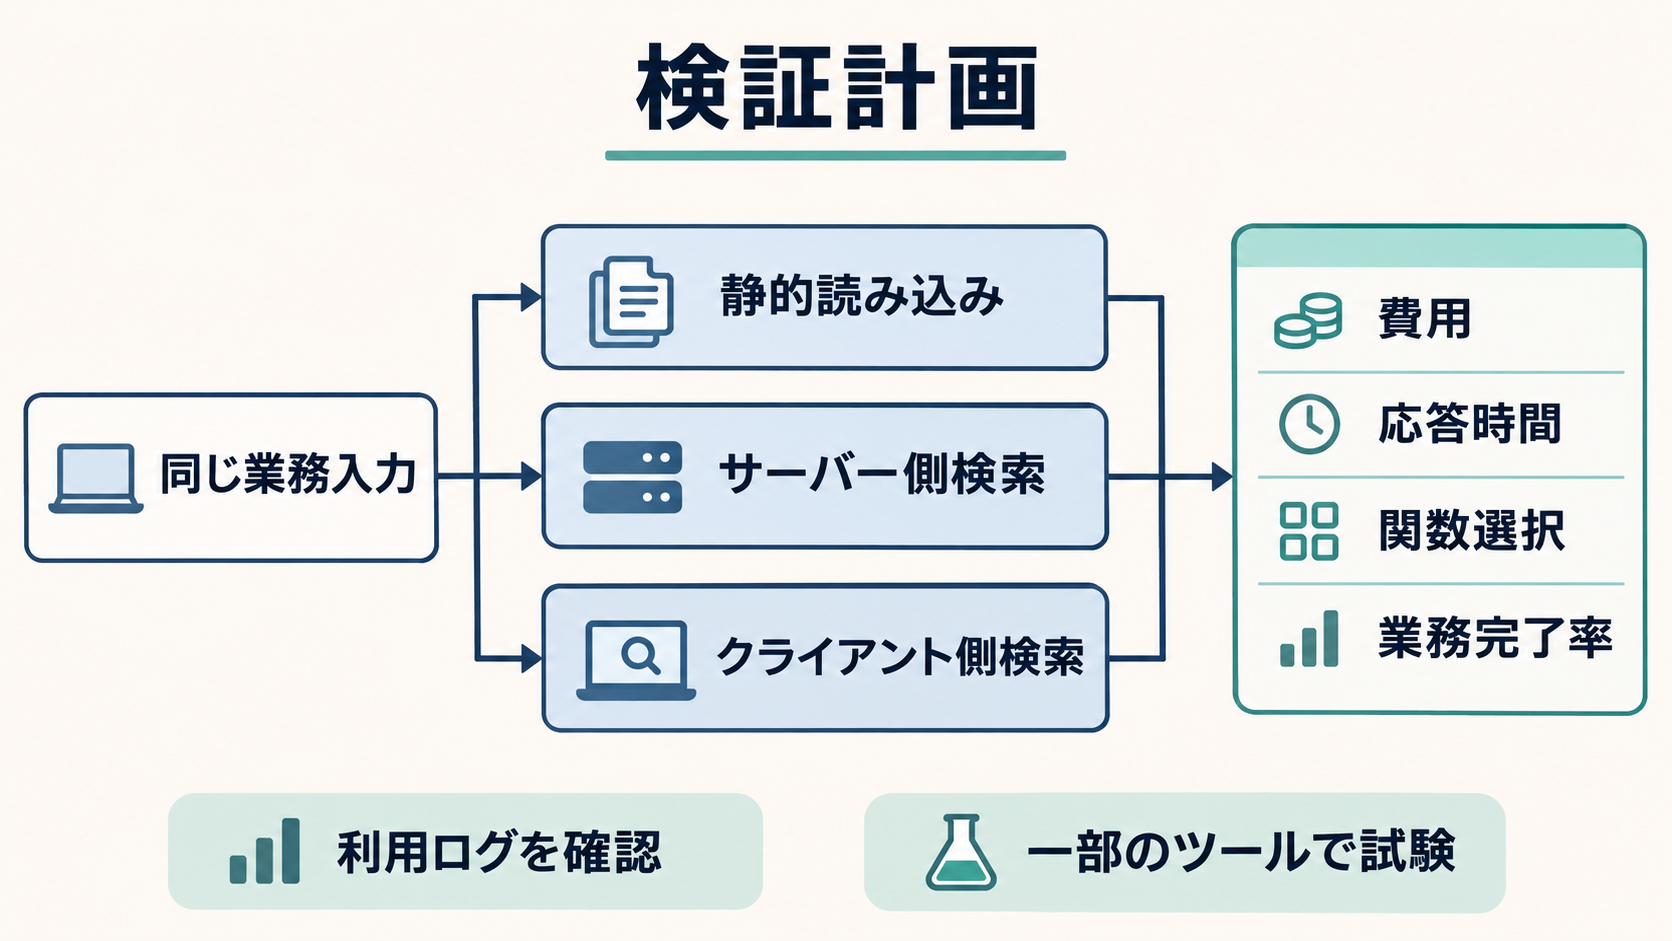
自社検証では、同じ業務入力に対して、静的読み込み、サーバー側の遅延読み込み、必要に応じたクライアント側検索を比較するとよいでしょう。費用だけでなく、目的の関数を選べたか、引数が正しいか、利用者への応答までに何秒かかったかを確認します。検索で入力が減っても、機能の選び直しや再試行が増えれば、業務全体の効率は上がらない可能性があります。
対象業務には、使う機能がほぼ固定されたものと、依頼によって必要な機能が変わるものを含めると、適した範囲が見えやすくなります。たとえば注文照会だけを行う処理と、照会結果に応じて配送確認や返金へ進む処理では、候補ツールと実際に使うツールの関係が異なります。これは検証の組み立て方の例であり、効果を保証する条件ではありません。
着手点は、現在のツール定義と利用ログを照合し、頻繁に使う関数、まれに使う関数、長いスキーマを持つ関数を洗い出すことです。そのうえで、利用頻度の低い一群だけを遅延対象にし、業務一件あたりの費用・応答時間・完了率を比較すれば、適用範囲を具体的に判断できます。