

2026/11/21
AIニュース
OpenAIのGPT-Live-1.1、音声AIの待機料金を毎分0.02ドルに――企業が見るべき費用と応答品質
この記事の要点
OpenAIのGPT-Live-1.1は、話しながら聞ける多言語音声モデルです。スタンバイではWebRTC接続を維持したまま推論を休止し、待機料金を毎分0.05ドルから0.02ドルへ抑えられます。ただし、通話全体の削減率は待機時間によって変わり、バックエンド費用も別途発生します。企業の導入判断には、日本語の識別番号の扱いや待機後の応答時間を含む業務検証が必要です。
目次
通話中の「待つ時間」を安くするスタンバイ
顧客が注文番号を探している間も、音声AIとの接続は続きます。担当者の代わりに問い合わせを受ける音声エージェントでは、こうした沈黙も運用コストに関わります。OpenAIがAPIで提供するGPT-Live-1.1と、同時期に案内したスタンバイ機能は、その待ち時間の扱いを変える更新です。会話の品質向上に加えて、接続を維持したまま推論を休止し、待機中の料金を抑えられます。
GPT-Live-1.1は、話しながら相手の声を聞ける全二重の音声モデルです。APIのモデルIDは「gpt-live-1.1」で、多言語の会話に対応します。OpenAIは、従来のGPT-Live-1に比べて発音やアクセントの一貫性、文字起こしなどを改善したと説明しています。公式の更新履歴には、2026年11月19日付で提供が記載されています。OpenAIの更新履歴
企業の導入判断で押さえたいのは、待機料金の引き下げとモデルの更新が別の選択肢になっている点です。スタンバイはGPT-Live-1にも対応するため、費用削減のためだけに新モデルへ移行する必要はありません。既存モデルで待機機能を試し、新モデルの会話品質は別途評価する進め方も考えられます。
また、安くなるのは所定の条件を満たした待機時間です。通話全体の単価が一律に下がるわけではありません。自社の問い合わせに、資料を探す時間や入力を待つ時間がどの程度含まれるかによって、更新の経済的な意味は変わります。
毎分60%の値下げと、通話全体の削減率の違い
GPT-Liveの音声セッションは、利用時間に応じて課金されます。通常の稼働状態は毎分0.05ドル、スタンバイは毎分0.02ドルです。待機中の単価は通常時より60%低くなりますが、この割引が適用されるのは、WebRTC接続で推論が休止している時間に限られます。WebRTCは、ブラウザーなどでリアルタイムの音声通信を行うための技術です。GPT-Live-1.1の料金と仕様
| セッションの状態 | 1分当たりの料金 | 同じ状態が1時間続いた場合 |
| --- | --- | --- |
| 稼働中 | 0.05ドル | 3.00ドル |
| スタンバイ | 0.02ドル | 1.20ドル |
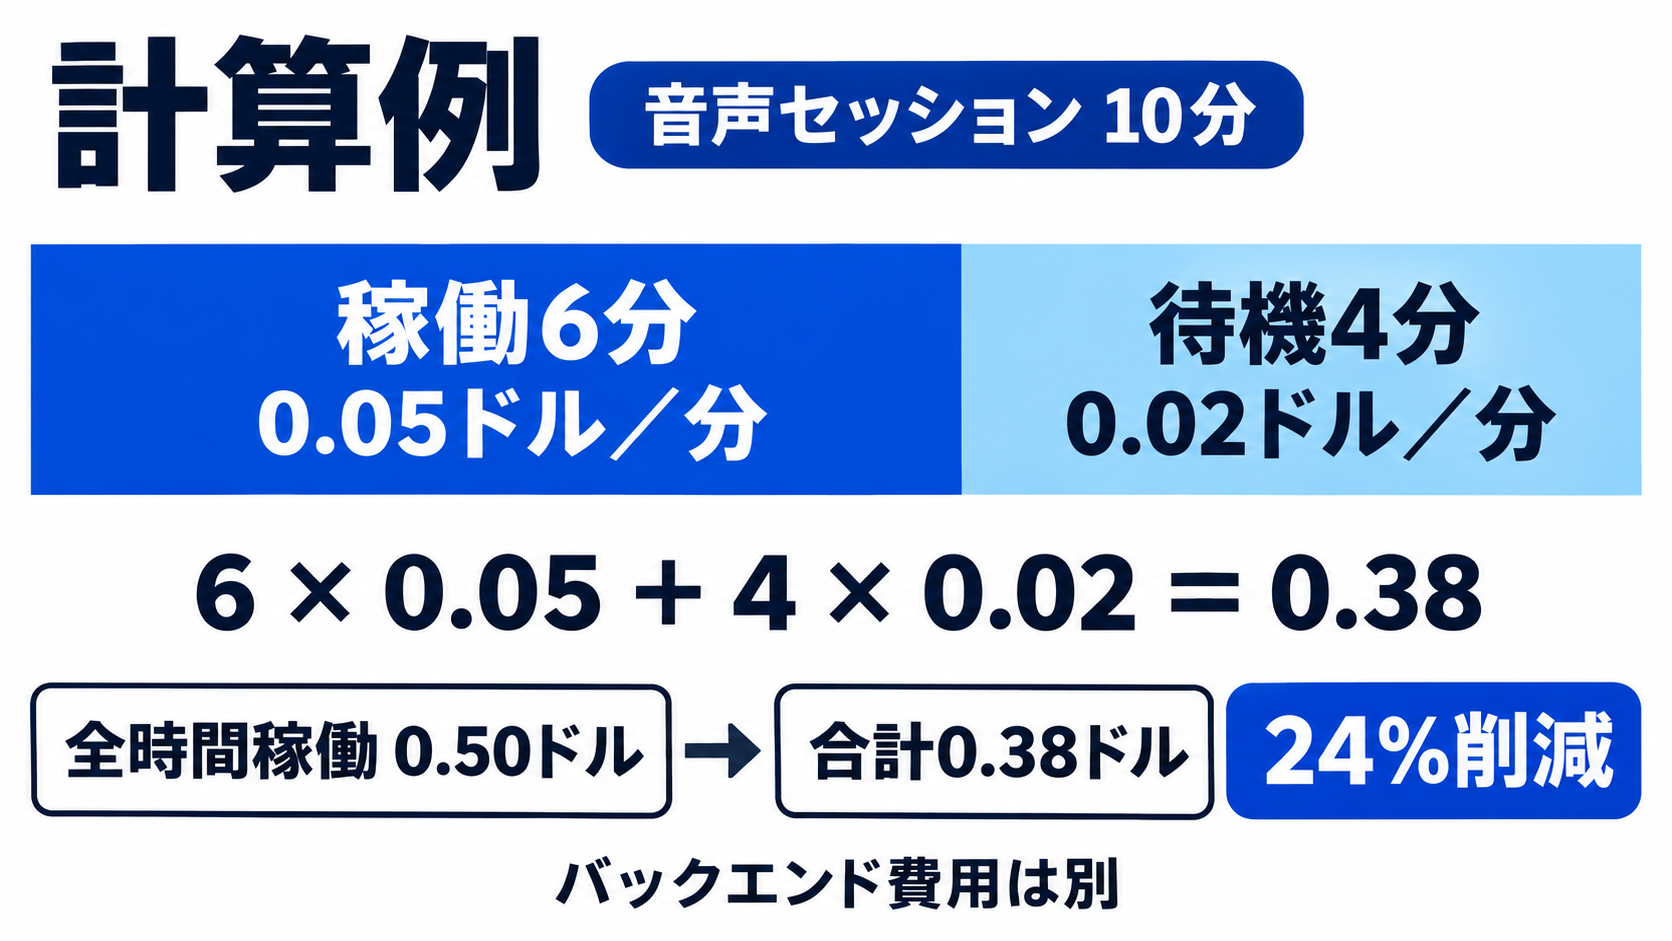
例えば、計算上の例として、10分間のセッションのうち6分間が稼働状態、4分間がスタンバイだったと仮定します。音声部分の料金は、6分×0.05ドルと4分×0.02ドルを合計した0.38ドルです。10分間すべてが稼働状態なら0.50ドルなので、この例での削減率は24%になります。待機単価の60%減を、そのまま総費用の削減率として使うことはできません。
実際には、無音になってから待機へ移るまでの時間も設定します。そのため、通話に沈黙が多くても、すべてが割引対象になるとは限りません。短い間が何度も入る会話と、長い確認作業が挟まる会話では、同じ通話時間でも費用の構成が異なるでしょう。
バックエンドのモデルやツールの利用料金は別途発生します。社内情報の検索や複雑な判断を頻繁に呼び出す構成では、音声部分の節約だけを見ても総費用は把握できません。見積もりでは、音声の稼働時間、実際のスタンバイ時間、バックエンド処理の三つを分ける必要があります。
スタンバイは接続を切らずに推論を休止
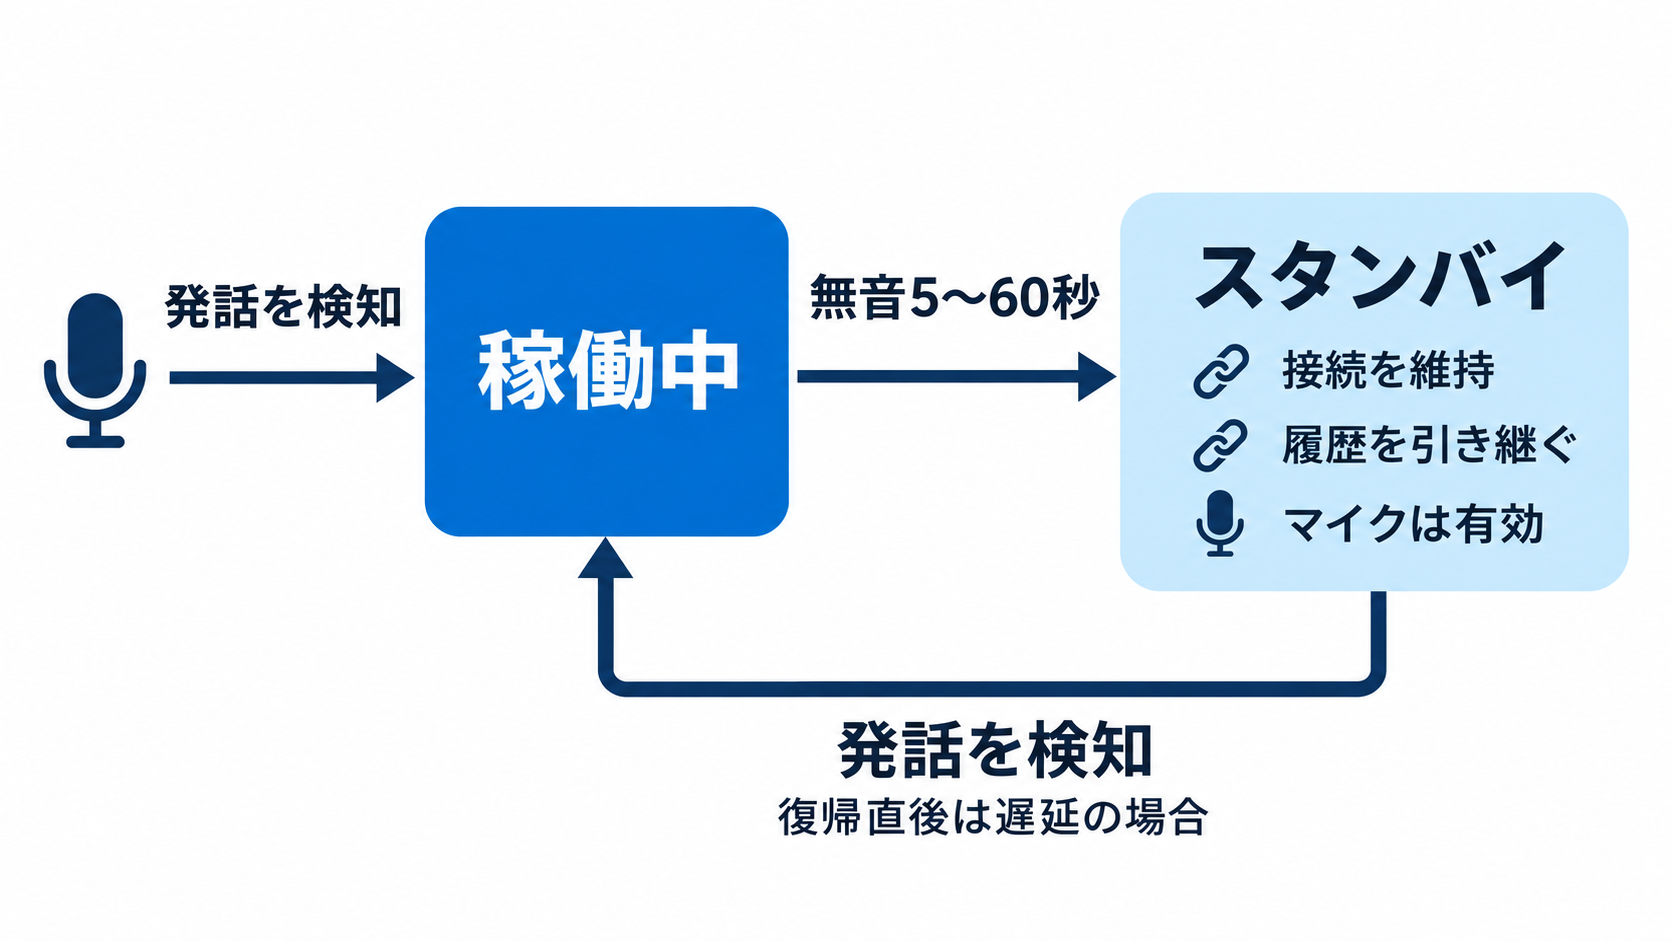
スタンバイは、通話を終了してから再接続する仕組みではありません。WebRTCの接続を保ちながら推論を止め、利用者の発話を検知すると再開します。セッションIDと会話履歴を引き継ぐため、待機のたびに新しい会話を始め直す必要はありません。ただし、復帰後の短い発話に対する最初の応答は、遅くなる場合があるとOpenAIは案内しています。
設定では「session.wake_policy.type」を「speech」に指定し、発話を待って推論を開始するようにします。「session.idle_timeout_s」は5〜60秒の整数で指定でき、入出力の文字起こしがその秒数だけ途絶えるとスタンバイへ戻ります。このタイムアウトを省略すると、最初の起動後はセッション終了まで推論が稼働し続けます。セッション管理の公式ガイド
発話検知のしきい値には、任意設定の「session.wake_policy.vad_threshold」を使います。指定範囲は0〜1、初期値は0.5です。VADは音声区間検出を指し、人が話しているかを判定します。しきい値を高くすると、発話と判断するために、より強い根拠が必要になります。待機中もマイクの音声トラックは有効にしておく必要があります。
運用では、タイムアウトを短くすれば必ず有利になるとは限りません。考えながら少しずつ話す利用者では、待機と復帰が繰り返される可能性があります。反対に、長く設定すれば短い沈黙のたびに復帰する状況を減らせるものの、割引が始まるまでの時間は延びます。
検証時には、休止を示す「session.paused」と再開を示す「session.resumed」のイベントを記録すると、設定と実際の動作を照合しやすくなります。費用だけでなく、待機から戻った直後の応答時間も同じ通話で確認する設計が必要です。
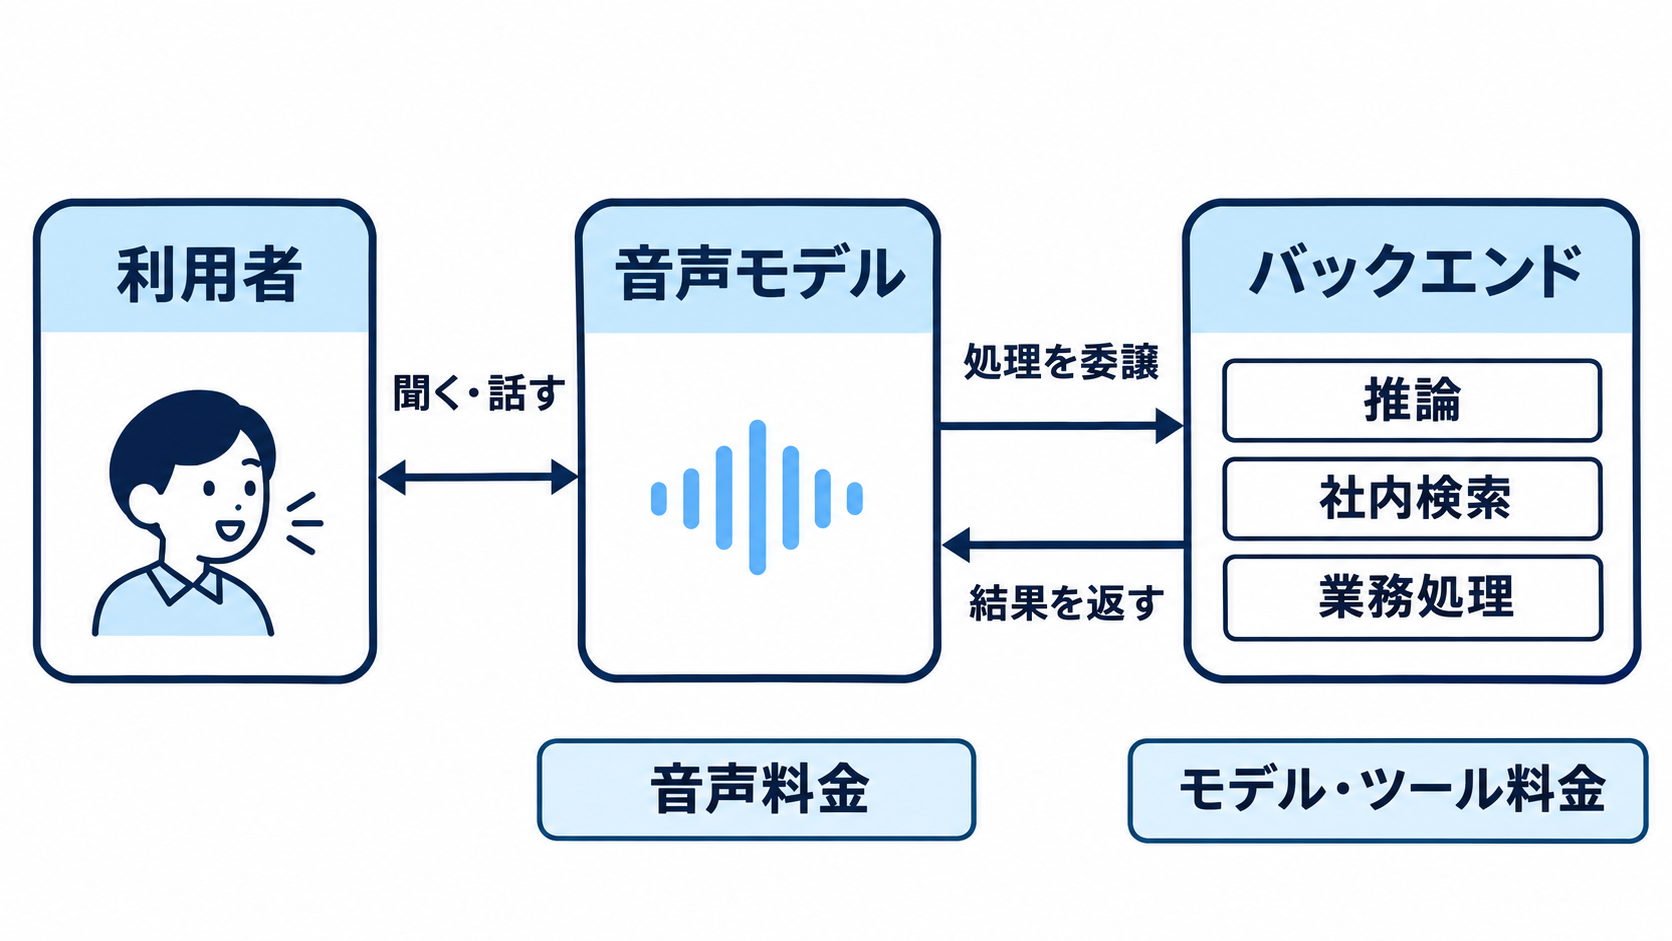
話しながら聞く音声モデルと、業務を処理するバックエンド
一般的な音声AIには、音声を文字に変換し、言語モデルが回答を作り、それを音声へ戻す構成があります。GPT-Live系列は、入力と出力の音声を単一モデルで扱う設計を採用しています。相手が話し終えるまで聞く処理と話す処理を完全に分けず、自分が発話している間も相手の音声を受け取れることが特徴です。
この性質は、説明の途中で利用者が条件を訂正する場面を考えると理解しやすいでしょう。例えば、案内の途中で「その商品ではなく、別の型番です」と発話する状況です。ただし、音声を同時に受け取れることと、訂正を正しく理解して業務処理へ反映できることは、別々に評価する必要があります。聞き取りの自然さだけで、業務全体の正確さを判断することはできません。
複雑な推論やツールを使う仕事は、バックエンドへ委譲できます。「responses」方式では、指定したOpenAIモデルを使って処理を進めます。「client」方式では、アプリケーション側が自社のワークフローやバックエンドを実行し、結果を音声モデルへ返します。後者は、返答前に検索結果を確認したり、必要な情報だけに絞ったりしたい構成で検討できます。処理の委譲とツール連携の公式ガイド
企業向けシステムでは、会話を担当する層と、業務上の判断や操作を担当する層を分けて捉えると設計しやすくなります。例えば、注文番号を聞き取る処理と、その番号で注文を検索する処理、注文内容を変更する処理では、確認すべき条件が異なります。
どの時点でバックエンドを呼ぶかは、応答時間と費用にも影響します。何でも外部処理に回せば待ち時間が増え、会話側に任せすぎれば確認不足につながるおそれがあります。自社の業務に沿って、委譲する条件を具体的に定めることが導入設計の中心になります。
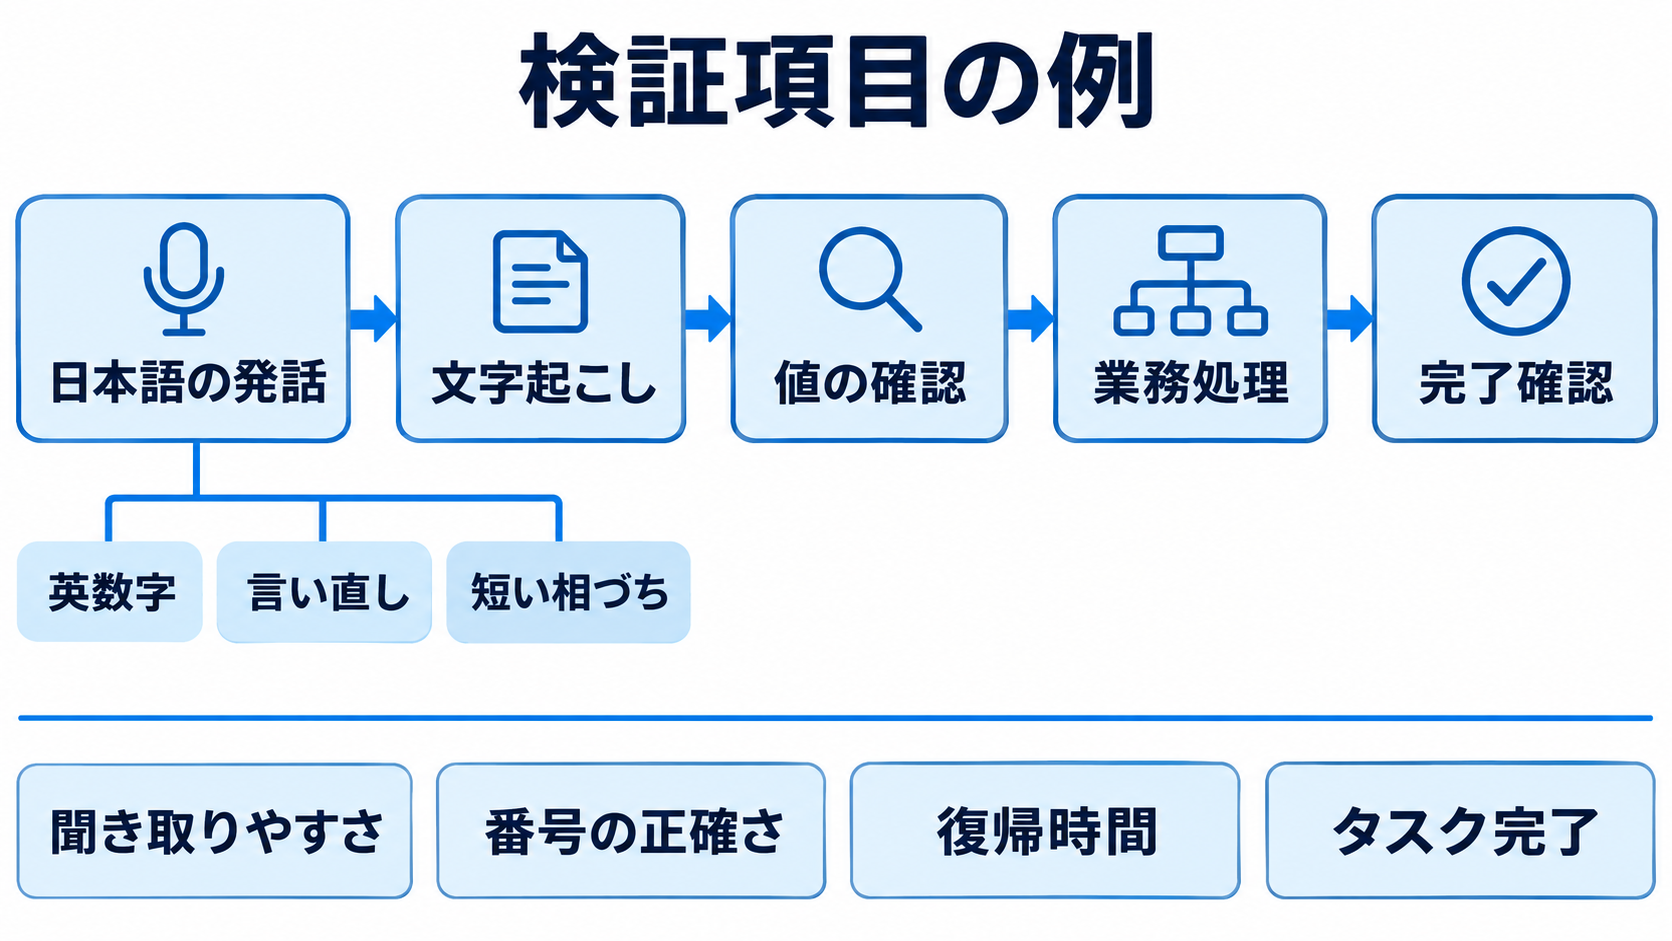
発音改善を、日本語の業務精度に置き換えて検証
OpenAIがGPT-Live-1.1で挙げている改善点は、言語をまたいだ自然で一貫したアクセント、文字起こしの精度、文字や数字など細かな情報の扱い、指示への追従とタスク完了の信頼性です。企業向けの用途では、とりわけ文字や数字の扱いが判断材料になります。会話が滑らかでも、注文番号や予約日時を取り違えれば、その後の処理は正しく進みません。
ただし、GPT-Live-1.1の改善幅を示すベンチマークスコアは、今回確認できた情報では公開されていません。開発元による改善の説明と、自社の日本語業務で期待できる結果は区別して考える必要があります。多言語対応の説明だけから、日本語の社名、商品名、英数字が混在する識別番号の正確さまで保証されるわけではありません。
評価用の会話には、数字の読み上げ、アルファベットを含む番号、途中での言い直し、短い相づちを含めるとよいでしょう。これは製品の実績を示すものではなく、導入企業が用意する検証例です。同じ条件を旧モデルと新モデルに与え、聞き取った内容と、最終的にバックエンドへ渡した値を照合します。
発音の印象と業務結果は、別の項目として記録するほうが比較しやすくなります。聞き取りやすさが改善しても、確認の往復が増えれば通話時間は延びるかもしれません。逆に、番号の訂正が減れば、利用者の負担と処理時間を同時に下げられる可能性があります。こうした効果は、実際のタスクを通して確かめる必要があります。
スタンバイも併せて試す場合は、通常時と復帰直後を分けて測ることが有効です。短い「はい」や「お願いします」が続く場面で、反応の遅れが会話にどう影響するかを確認します。平均応答時間だけでは見えない待ち方を把握することが、設定値を選ぶ根拠になるでしょう。
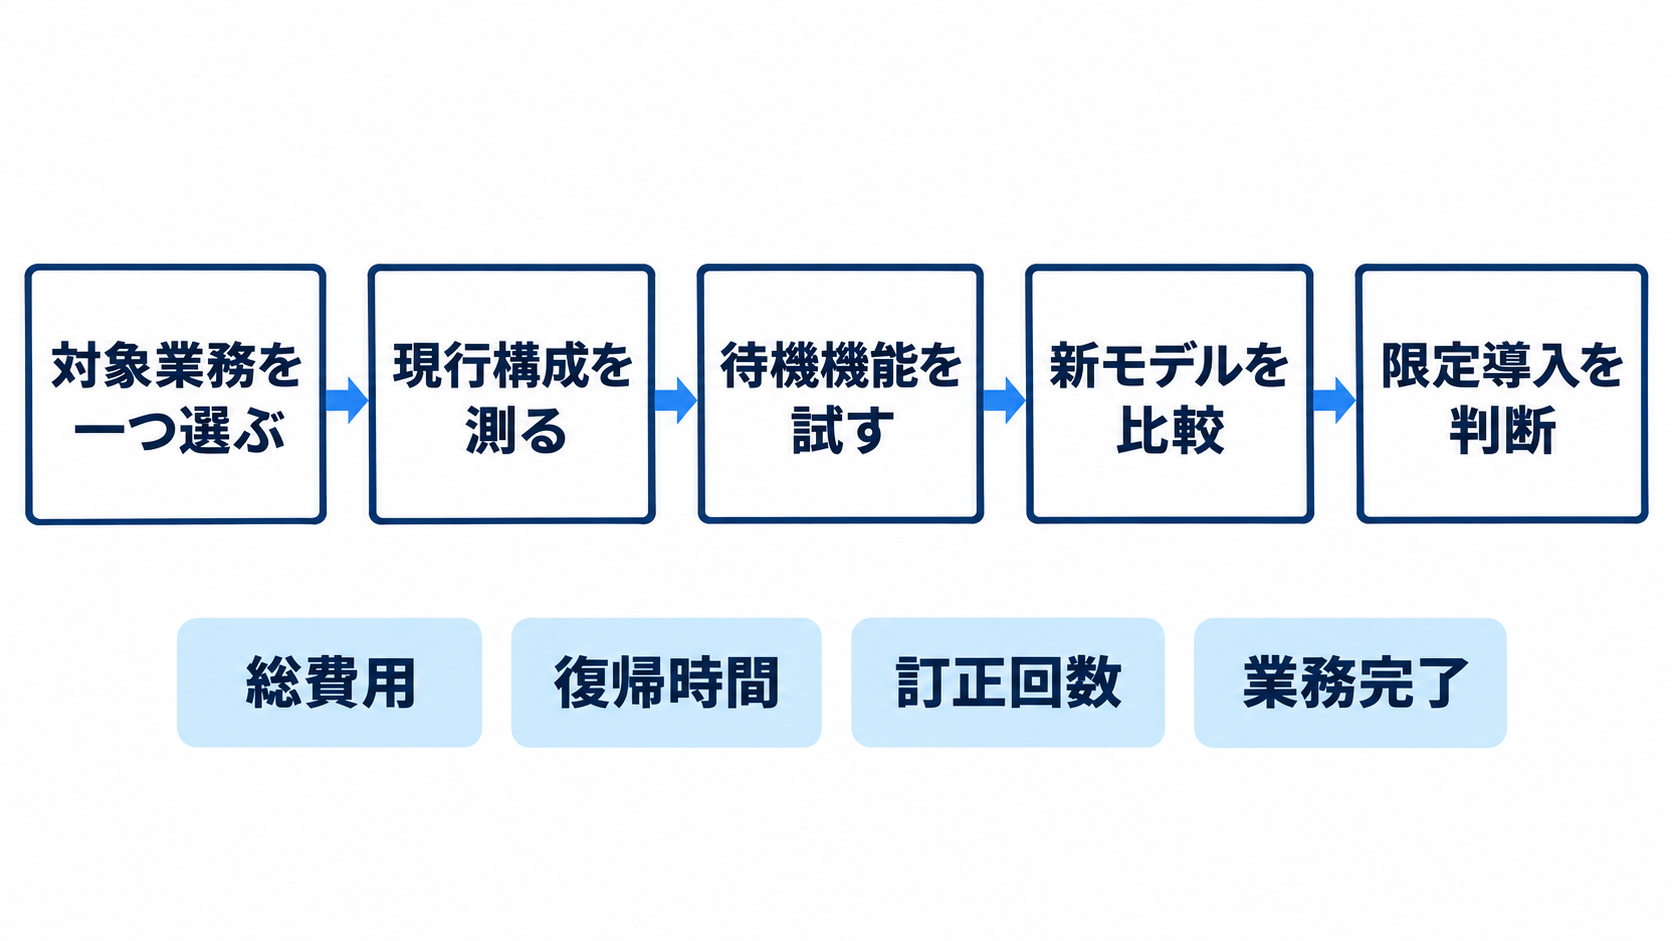
導入判断は、対象業務を一つ選ぶところから
GPT-Live-1.1は音声とテキストの入出力に対応し、ストリーミングと関数呼び出しを利用できます。画像と動画の入力、決められた形式への出力を保証する構造化出力、追加学習のファインチューニングには対応していません。利用者が見せる画面や写真を直接理解する用途では、音声モデル以外の構成も検討する必要があります。会話の柔軟さと、システムが必要とする入力・出力の条件を照らし合わせることが先決です。
提供形態はOpenAIのクラウド上のAPIで、重みを取得して自社環境へ配置する方式ではありません。Liveセッションでは「v1/live/sessions」を使い、モデルに「gpt-live-1.1」を指定します。モデルを変更するには新しいセッションが必要です。また、GPT-Live-1とGPT-Live-1.1の同時セッション上限は別に設定されているため、本番移行前に自社アカウントの上限を確認しておく必要があります。
導入効果を確かめるなら、情報を確認するための待ち時間がある業務を一つ選ぶと、費用と体験の関係を観察しやすくなります。例えば、利用者が手元の番号を探してから照会する流れを検証対象にできます。これは活用の提案であり、特定企業での導入実績を示すものではありません。
比較する際は、現在の構成を基準に、待機機能を加えた場合と、新モデルも使った場合を分けて記録するとよいでしょう。通話時間、実際の待機時間、番号などの訂正回数、業務の完了状況、バックエンドを含む費用を、同じ条件で確認します。新モデルの品質改善とスタンバイの節約効果を分ければ、どの変更に投資するかを判断しやすくなります。
最初の一歩は、自社の代表的な通話シナリオに「利用者が情報を探す沈黙」と「待機後の短い返答」を組み込むことです。その一連の処理で費用、復帰時間、業務結果を測れば、単価表だけでは決められない導入条件が見えてきます。