
2026/10/29
AIニュース
Block「Dessa」が挑む音声AIの再設計──文字を介さず、人の会話だけで学ぶフルデュプレックスモデル
文字を経由しない音声AIという設計転換
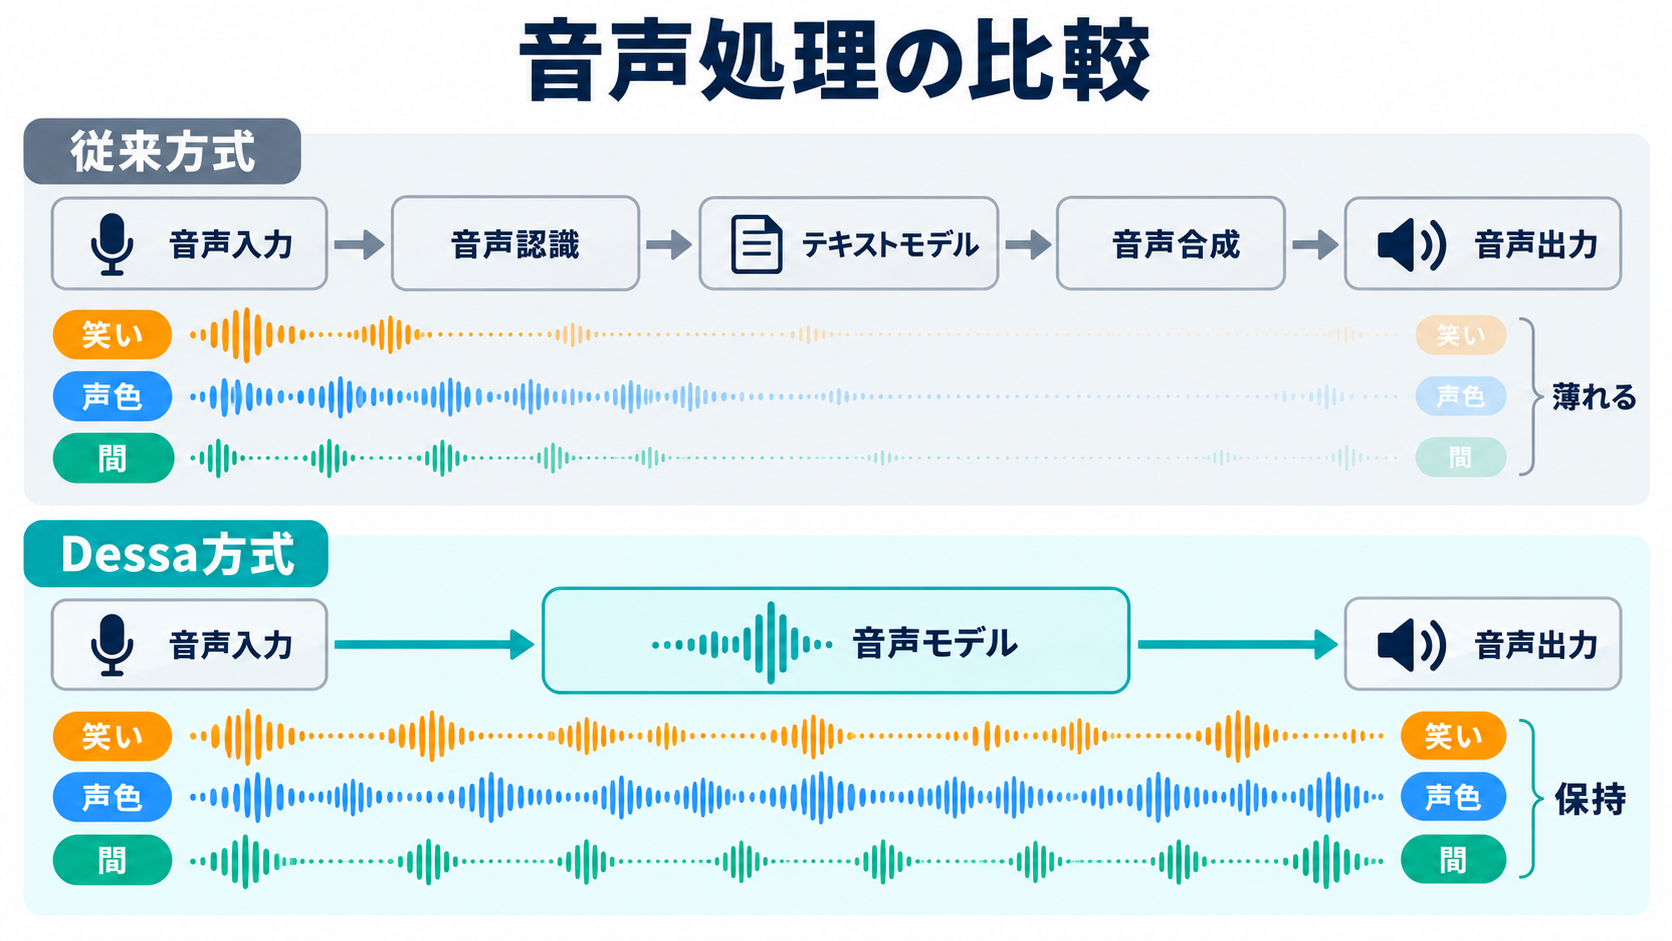
音声エージェントに話しかけている途中で返答が始まったり、相づちが不自然な間隔で挟まったりすると、利用者はすぐに「機械と話している」と感じます。現在の多くのシステムでは、音声を文字へ変換し、言語モデルで回答を作り、それを再び音声に戻しています。この分業構成は実装しやすい半面、笑い、ため息、声の強弱、皮肉を含んだ話し方など、文字にしにくい情報が途中で失われる可能性があります。決済サービスなどを展開するBlockのAI研究部門は、2026年10月23日、研究プレビューとして音声モデル「Dessa」を発表しました。Dessaは、入力された音声から直接音声を生成するスピーチ・ツー・スピーチモデルです。Blockによると、学習には人間同士の会話音声だけを使い、テキストデータや事前学習済みモデルは利用していません。
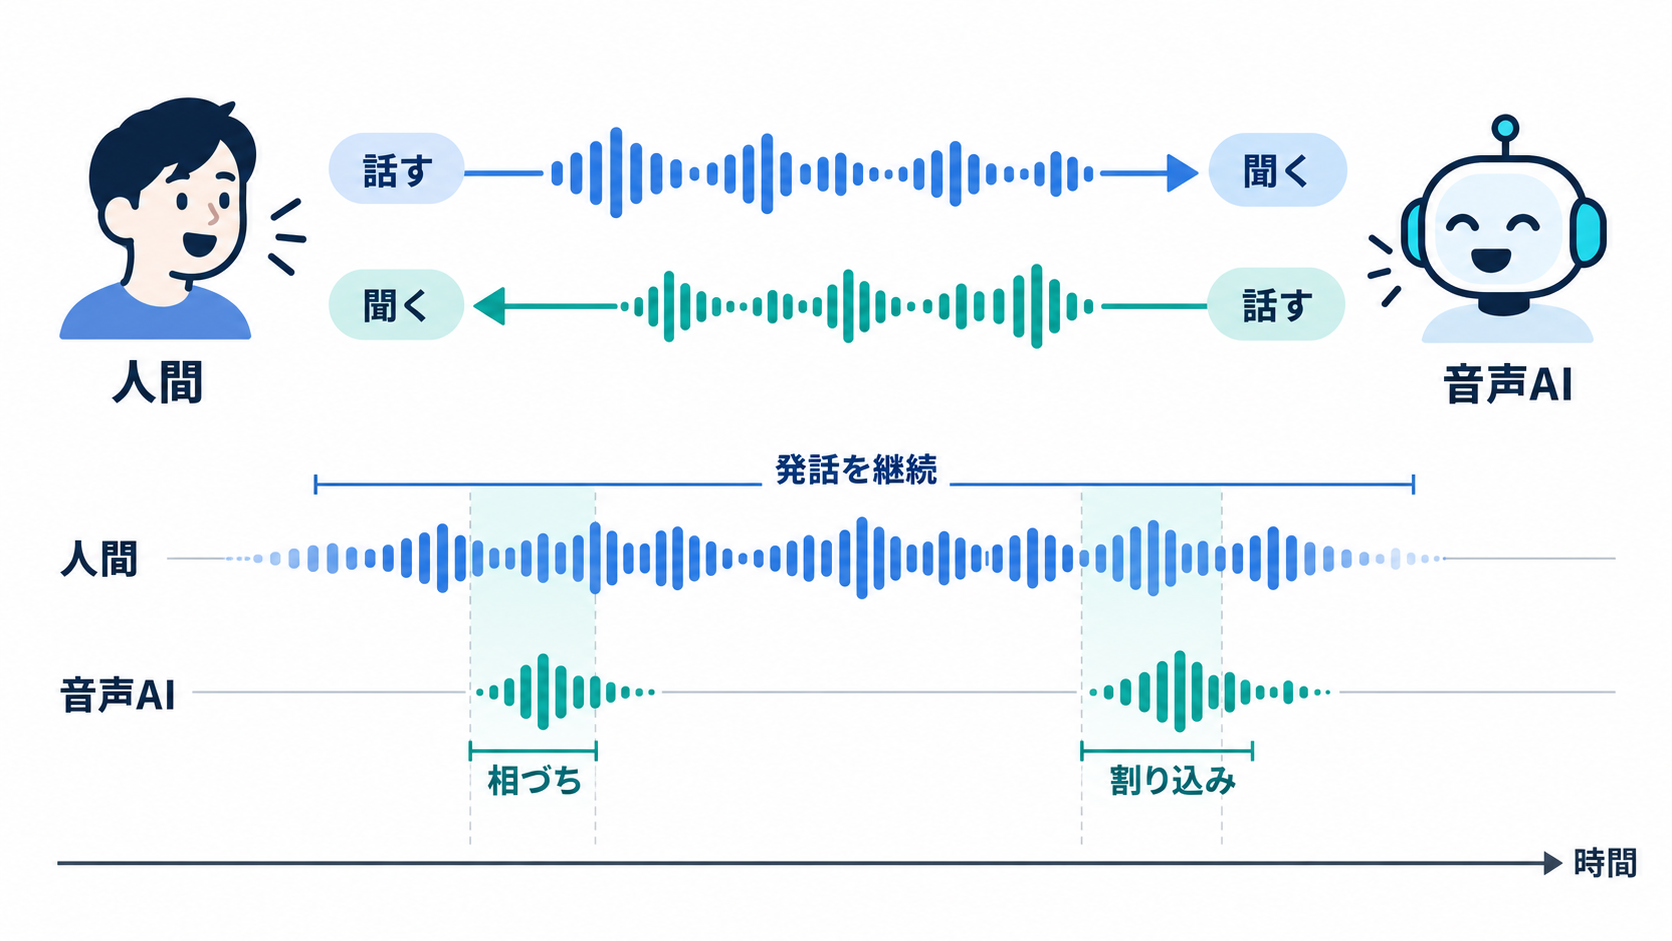
Dessaの特徴は、単に音声で応答できることではありません。相手の声を聞きながら自分も話せる「フルデュプレックス」に対応し、会話の流れに応じて発話を続けたり、短い相づちを入れたり、途中で割り込んだりします。電話のように双方が同時に音声を送受信できる仕組みを、AIとの対話へ持ち込もうとする設計です。
企業向け音声AIの観点では、この設計思想が中心的な論点になります。問い合わせ内容を正しく処理するだけなら、既存の音声認識と言語モデルを組み合わせる方式でも対応できます。しかし、人が話し終わるまでの沈黙や、考えながら発する短い言葉まで含めて対話を成立させるには、文字列だけでは捉えにくい時間的な情報が欠かせません。Dessaは、意味の処理と会話のタイミングを分離せずに学習させることで、その問題へ取り組んでいます。
相づち、笑い、割り込みを含む「会話らしさ」
会話の自然さは、回答内容の正しさだけでは決まりません。相手が話している最中の「はい」「なるほど」といった短い反応や、発話を始めるタイミング、言い直しへの追従も体験を左右します。Dessaは相手の発話中も音声を受け取り続けるため、自分の出力を止めずに聞き、状況に応じて応答を変えられるとBlockは説明しています。公開されたデモには、Dessaが文章の途中で笑う場面や、声を大きくするよう求められて音量を上げる場面が含まれます。OpenAIの「GPT-Live-1」とDessaを会話させた例も示されました。Blockは、これらのクリップについて、人による誘導や操作は行っていないとしています。短い「そうですね」「分かりました」に相当するバックチャネルも、人間の会話から学習した振る舞いの一つです。
ここで区別したいのが、応答の速さと会話制御の違いです。返答開始までの待ち時間を短くしても、相手の発話が続いているのに回答を始めれば、体験はかえって悪化します。反対に、割り込みを一切許さない設計では、利用者が訂正したいときにも長い回答を聞き続けなければなりません。フルデュプレックスモデルには、音を同時に処理する能力だけでなく、「今は聞くべきか、話すべきか」を継続的に判断する能力が求められます。
ただし、現在確認できる成果はデモ映像が中心です。笑いや割り込みが特定の会話だけで再現されたのか、話者や話題が変わっても安定するのかは、公開情報から判断できません。Blockが示した挙動は設計の方向性を理解する材料にはなりますが、業務環境での品質を証明するベンチマークとは分けて評価する必要があります。
音声だけで学習する狙いと技術的な難しさ
一般的な音声エージェントは、音声認識、テキスト言語モデル、音声合成という三つの処理を直列につなぎます。この方式では各部品を個別に改善でき、既存のテキスト向けAIも活用できます。その反面、音声認識の段階で言葉以外の情報が落ちれば、後段のモデルは失われた手がかりを利用できません。文字としては同じ「大丈夫です」でも、声の震えや間の取り方によって意図が異なる場合があります。Dessaは音声を直接入力し、音声として出力します。Blockの説明では、学習にテキストや事前学習済みモデルを使わず、人間の会話音声から言語と対話の振る舞いを獲得しました。テキストを中間表現に固定しないため、声色、笑い、ため息、発話の重なりといった特徴を、意味と切り離さず扱える余地があります。
この方法はデータ処理の負担を増やします。同じ単語でも話者、速度、音程、録音環境によって波形は異なり、まったく同じ音声が繰り返されることはほぼありません。Blockは、話し言葉一語分の音声が、同じ単語を文字で表した場合より数千倍多くのバイトを必要とすると説明しています。モデルは大量の連続データから、意味、話者の特徴、周囲の雑音、会話のタイミングを整理しなければなりません。
Blockはまた、Dessaが大規模言語モデルより数百倍少ない単語数から言語を学習したと主張しています。ただし、学習音声の総時間、データの言語構成、重複の扱い、評価条件は開示されていません。このため、データ効率の数字を他モデルと直接比較する段階には至っていないでしょう。音声だけで学べるという技術的主張と、どの範囲の会話を安定して処理できるかという実用上の問いは、別々に検証する必要があります。
72基のGPUによる学習とMacでのローカル実行
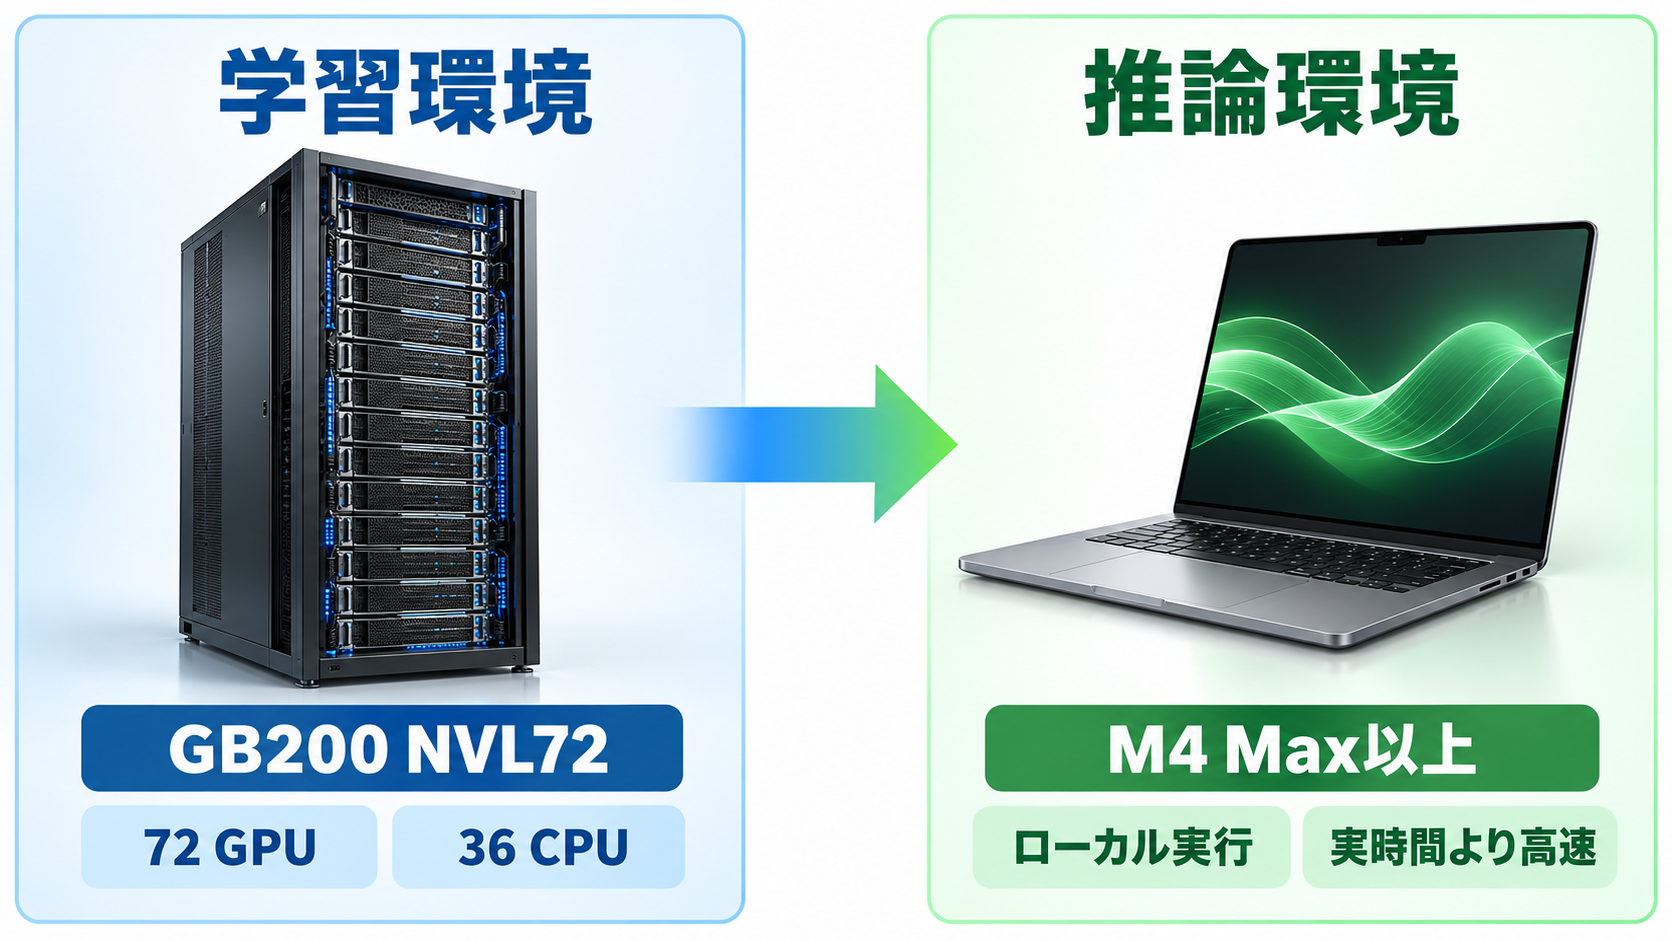
Blockが開示した学習環境は、NVIDIAの「GB200 NVL72」一式です。このラックスケールシステムは72基のBlackwell GPUと36基のGrace CPUを接続した構成で、Dessaの学習には1ラックが使われました。個別のGPU台数だけを見れば、1,016基のH100 GPUを利用したとされるMoshiより少ない構成です。もっとも、72基と1,016基という数字だけでモデルの効率を断定することはできません。GPUの世代や性能、学習期間、データ量、モデル規模、最適化方法が異なれば、必要な計算資源も変わります。Dessaについてはパラメーター数やアーキテクチャ、学習時間が公表されていないため、計算量を揃えた比較はできない状況です。ここで確認できるのは、Blockが単一のGB200 NVL72ラックで学習したと報告している点に限られます。
推論については、M4 Maxを搭載したMacBook Pro以上の環境で、実時間を上回る速度でローカル実行できるとされています。「実時間より速い」とは、例えば10秒分の音声を処理するのに10秒以上を要しないという処理能力を示す表現です。ただし、会話中の応答遅延、割り込み検出までの時間、必要メモリー量など、実際の利用感を判断する数値は明らかにされていません。
ローカル実行は、クラウド通信への依存を減らせる可能性があるため、企業の関心を集めやすい要素です。しかし、現時点ではモデルの重みや実行ソフトウェアが公開されておらず、待機リスト経由の研究プレビューにとどまります。自社端末で動かせるという説明と、企業が直ちに導入・監査できることは同義ではありません。運用を検討する際は、配布形態やライセンス、更新方法の開示を待つ必要があるでしょう。
Moshi、PersonaPlex、GPT-Live-1との違い
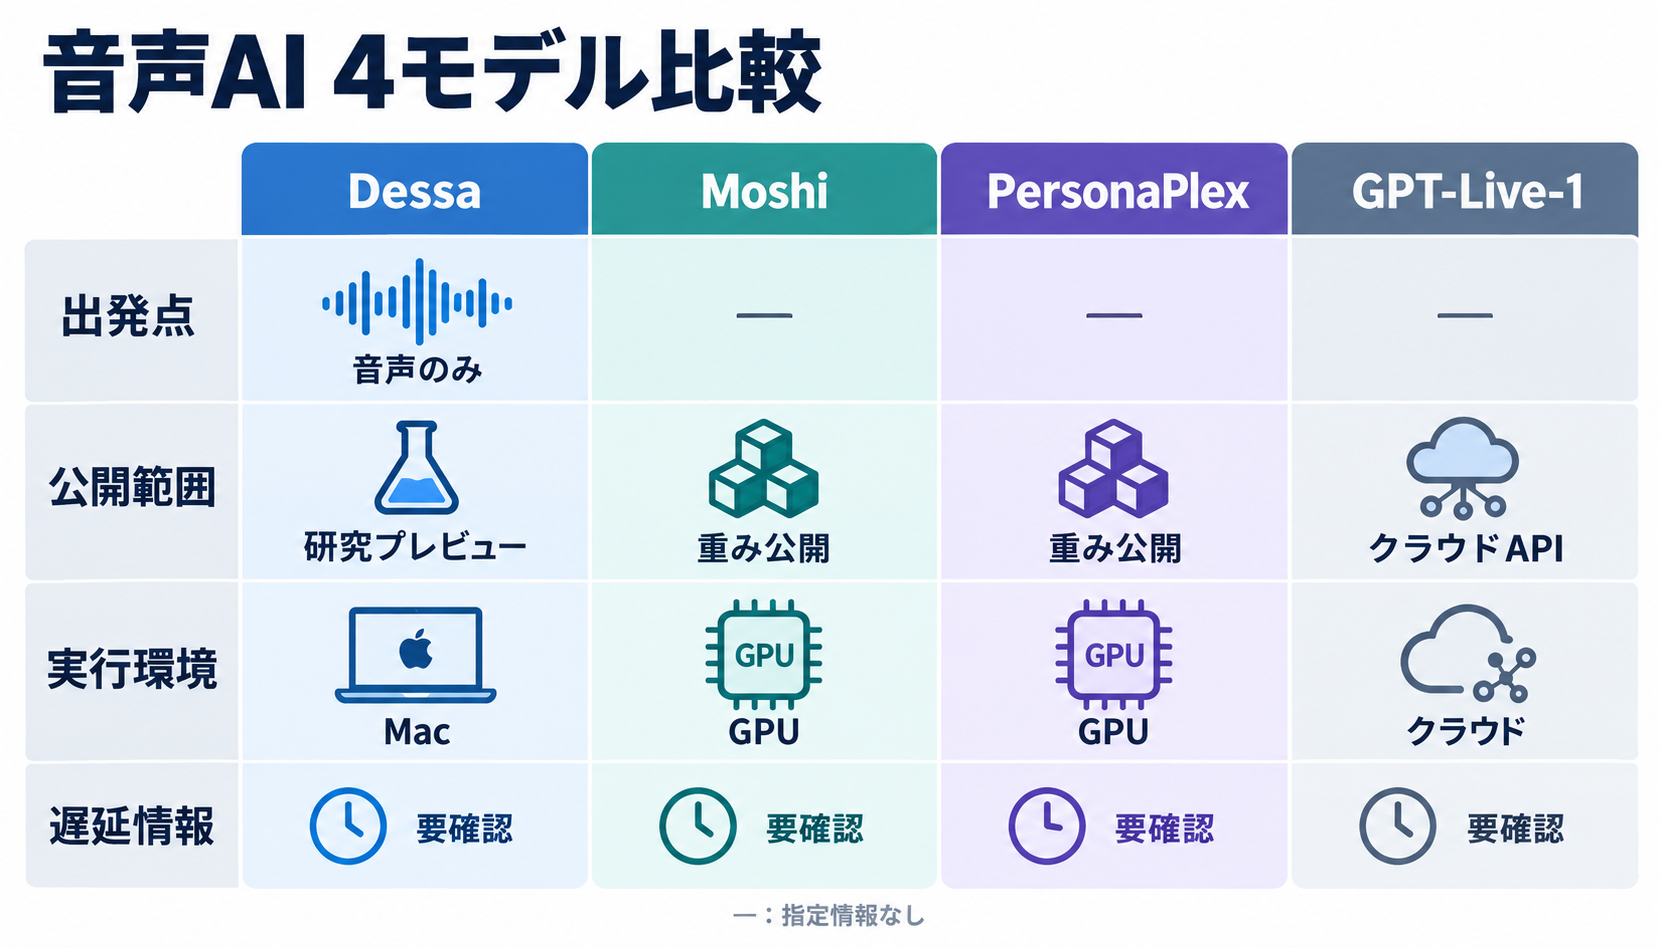
フルデュプレックス音声AIには、同じ目的へ異なる設計で取り組むモデルがあります。代表例として挙げられているのが、Kyutaiの「Moshi」、NVIDIAの「PersonaPlex-7B-v1」、OpenAIの「GPT-Live-1」です。Dessaの位置づけを把握するには、デモの印象だけでなく、出発点、公開範囲、実行環境を分けて見る必要があります。| 比較項目 | Dessa | Moshi | PersonaPlex-7B-v1 | GPT-Live-1 |
|---|---|---|---|---|
| 開発主体 | Block | Kyutai | NVIDIA | OpenAI |
| 学習の出発点 | 音声のみ。テキストと事前学習モデルは不使用 | Heliumテキスト言語モデルと音声処理 | Moshi系のMoshiko重みを微調整 | 詳細非公開。推論はバックエンドエージェントへ委任 |
| パラメーター数 | 非公開 | 80億 | 70億 | 非公開 |
| 公開された学習情報 | GB200 NVL72を1ラック使用 | 700万時間の事前学習音声などを使用し、H100を1,016基利用 | Fisher英語音声など1万時間未満 | 非公開 |
| 遅延情報 | 実時間より高速との説明のみ | 実運用約200ミリ秒、理論値160ミリ秒 | 発話交代0.170秒、割り込み0.240秒 | モデルページでは非公開 |
| 提供形態 | 研究プレビュー、待機リスト | 重みを公開、CC BY 4.0 | 重みを公開、NVIDIA Open Model License | クラウドAPI |
| 主な実行環境 | M4 Max搭載MacBook Pro以上 | GPU、MLX・Candle・PyTorch用チェックポイント | A100またはH100を搭載したLinux | OpenAIのクラウド |
Moshiは、テキスト言語モデルを基盤に、時間を合わせたテキストトークンを予測してから音声トークンを扱います。Dessaがテキストを使わない点とは対照的です。PersonaPlexはMoshi系の重みから調整されたモデルで、公開ベンチマークでは発話交代と割り込みの遅延が示されています。GPT-Live-1はAPIで提供され、掲載情報では音声レイヤーの料金が1分当たり0.05ドルとされています。
Dessaはローカル実行と音声のみの学習を掲げる一方、比較に必要な情報が最も限られています。MoshiやPersonaPlexでは重みを入手して同じ入力を試せますが、Dessaにはその条件がありません。したがって、現段階で「どのモデルが優れているか」を順位づけするより、Dessaは設計仮説を示す研究成果、公開モデルは検証可能な実装、GPT-Live-1は利用可能なクラウドサービスとして整理するほうが実態に合っています。
企業導入を判断するために不足している情報
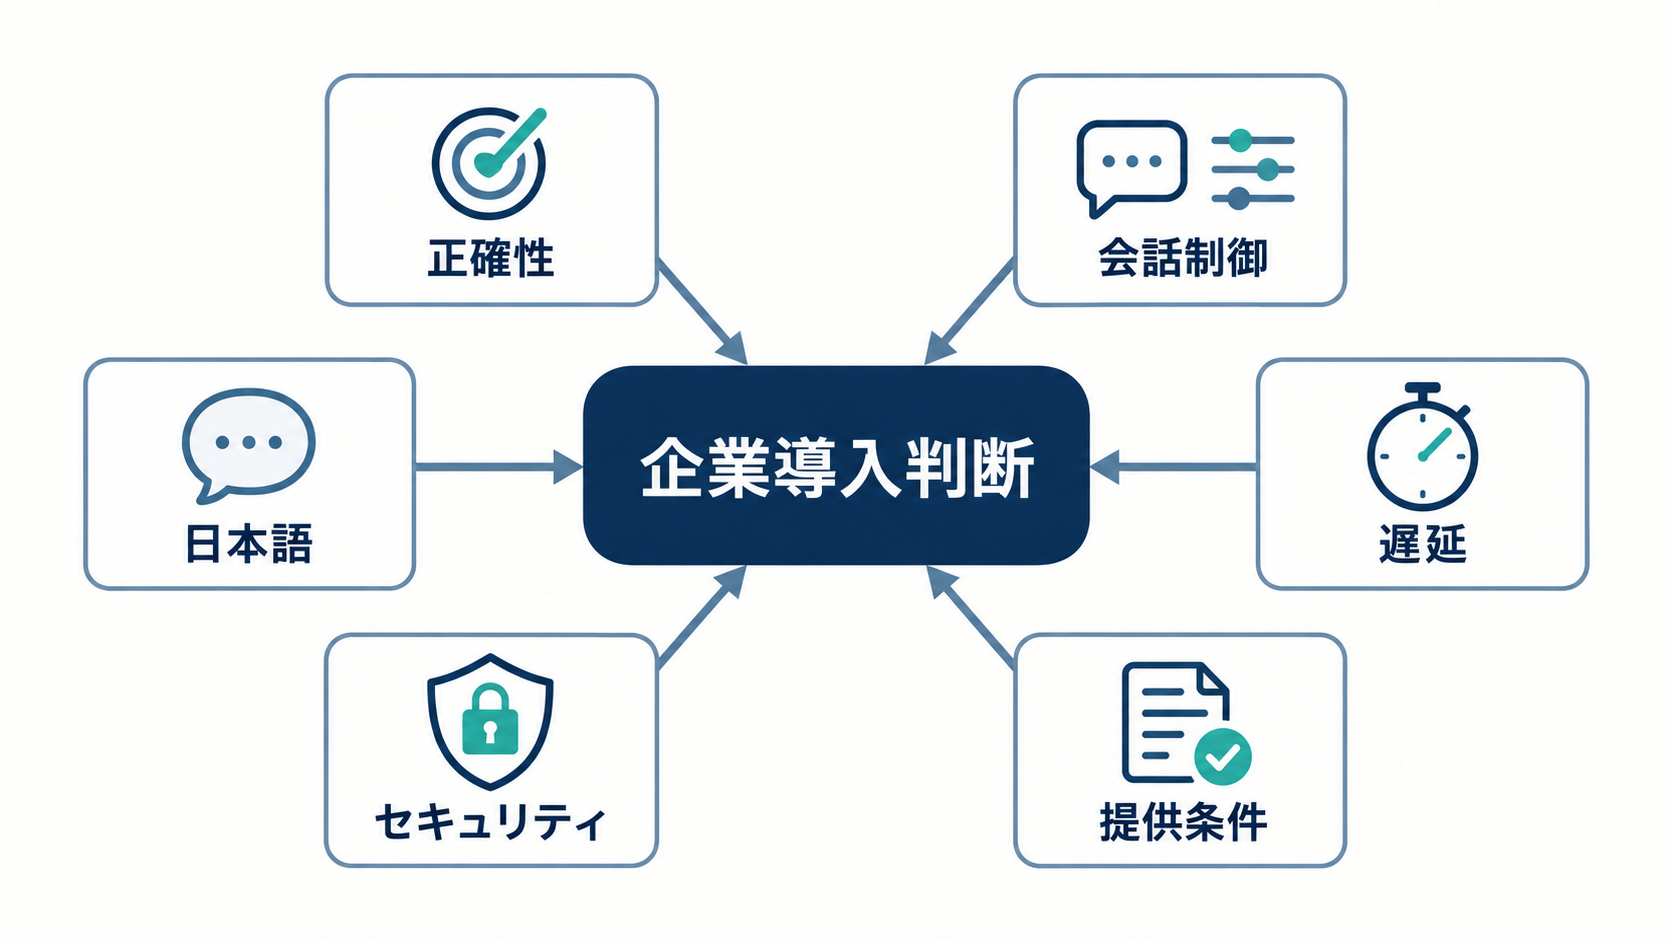
Dessaには、ベンチマークスコア、パラメーター数、モデルの重み、論文、API、料金が公開されていません。研究プレビューとして設計の方向性を示す段階であり、調達候補として比較表へ載せるには情報が足りない状態です。企業が必要とするのは印象的な会話デモだけではなく、想定業務での再現性と、失敗した場合の制御方法でしょう。評価時には、発話内容の正確性と会話の自然さを別の指標として扱う必要があります。相づちが自然でも、顧客名や金額を誤認すれば業務には使いにくくなります。反対に、文字起こし精度が高くても、利用者の訂正を受け付けず話し続けるシステムでは電話対応の負担を減らせません。雑音、複数話者、通信品質の変化、専門用語を含む発話についても、同じ条件で繰り返し試すことが欠かせません。
日本企業にとっては、日本語への対応状況も未確定要素です。学習データの言語構成が公開されていないため、敬語、相づちの頻度、発話を譲るタイミング、固有名詞の読み分けをどこまで扱えるかは判断できません。英語で自然に見える割り込み方が、日本語の顧客対応でも受け入れられるとは限らないため、言語ごとの評価が必要になります。
セキュリティ面では、ローカルで動作するという一点だけで要件を満たしたと考えるべきではありません。音声データの保存範囲、ログの扱い、モデル更新時の通信、権限管理、監査記録といった運用全体を確認する必要があります。重みやライセンスが提供されていない現状では、社内環境への組み込み方も確定できません。待機リストへ登録する場合は、技術情報の入手を目的とする調査段階として位置づけるのが妥当です。
日本企業が始められる検証の組み立て方
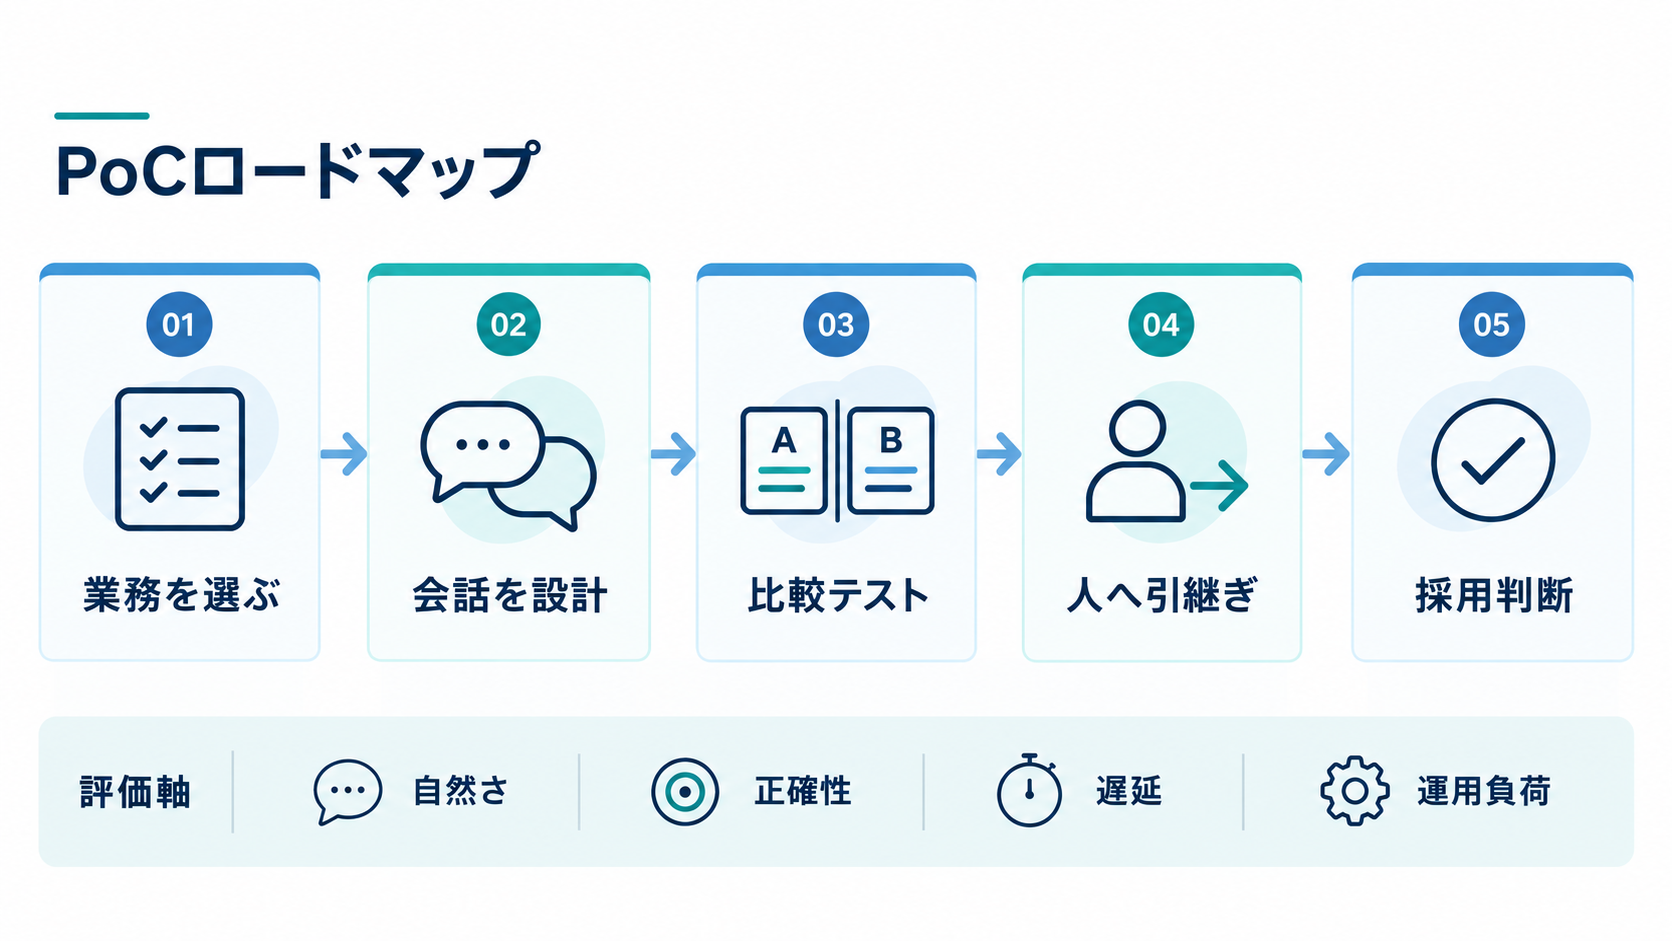
Dessaの公開を受けて企業が取るべき行動は、製品採用を急ぐことではなく、フルデュプレックス音声AIを何の業務に使うかを具体化することです。コールセンター、社内ヘルプデスク、店舗端末、音声入力支援では、許容できる遅延や割り込みの頻度が異なります。「人間らしい会話」という抽象的な目標を、そのまま評価項目にしても判断基準にはなりません。検証用の会話では、通常の質問だけでなく、利用者が途中で訂正する場面、聞き取れずに言い直す場面、沈黙して考える場面を用意します。モデルが発話を止めるまでの時間、相づちが内容理解と一致しているか、訂正後に古い情報を引きずらないかを記録すると、会話制御の品質を比較しやすくなります。音声認識の正答率だけでは見えない差を、業務に即した形で捉えられるでしょう。
対象業務は、誤りが直ちに契約や支払いへ反映されない範囲から選ぶのが現実的です。人間へ引き継ぐ条件を定め、AIが判断できないときに会話を終わらせず、担当者へ状況を渡せる設計も求められます。Dessaのような統合型モデルでは内部の処理を部品ごとに確認しにくい可能性があるため、入出力の記録と異常検知を外側に用意する考え方も必要です。
比較対象には、従来の音声認識・言語モデル・音声合成を組み合わせた構成と、検証可能なフルデュプレックスモデルの双方を含めます。自然さ、正確性、遅延、計算資源、運用負荷を同じシナリオで測れば、統合型モデルを選ぶ理由が明確になります。Dessaについて追加情報や利用手段が提供された際に備え、最初の一歩として、日本語の代表的な会話シナリオと合格条件を社内で定義しておくとよいでしょう。