

2026/11/22
AI活用
Codexで受注一覧のN+1クエリを改善する――表示と権限を守る調査・修正・回帰テスト
対象読者:上級者向け
この記事の要点
Codexを使い、受注一覧のN+1クエリ調査から限定修正、回帰テストまでを進める上級者向けの実践案です。従来工程と対応付けながら、表示内容・権限・ページ分割を守る検証と、準備やレビューを含む効果の確かめ方を紹介します。
目次
受注一覧が重いとき、開発者は何を調べているか
営業担当者から「受注一覧の表示が重い」と相談を受けた保守開発者を想定します。一覧には受注番号、顧客名、担当者名、受注金額が並び、期間や受注状態で絞り込めます。目的は、表示内容や閲覧権限を変えずに、一覧表示で繰り返される関連データの取得を減らすことです。以下は架空の業務例であり、実際のシステムで操作・計測した結果ではありません。
AIを利用しない場合も、開発者は既存のSQLログ、コード検索、テスト環境を使って調査できます。問い合わせ時の条件を再現し、一覧の取得処理から表示用データの組み立てまでをたどります。受注の取得後に顧客や担当者への問い合わせが繰り返されていないか、ログと関連取得コードを対応させて確認する工程です。
この例では、一覧の各行を組み立てる際に関連データを個別取得している疑いを、N+1クエリの調査対象とします。ただし、同じ形のSQLが並んでいるだけで原因を確定してはいけません。対象リクエストのログか、別の処理が混ざっていないか、表示件数の増減と問い合わせの増減が対応しているかを確認する必要があります。
Codexの活用先は、この調査から修正候補、回帰テストまでを一画面の範囲でつなぐ作業です。本稿は、SQL、ORM、Gitの差分確認、既存テストの実行に慣れた開発者を対象にしています。単に取得回数を減らすだけでなく、権限やページ分割の条件をテストへ落とし込めることが前提です。採用する修正とリリースの可否は、開発者が判断します。
手間の中心は、ログとコードと仕様の突き合わせ
調査の負担は、ファイルを探す作業だけではありません。SQLログに現れる問い合わせが、コードのどの関連参照から発生するのかを特定し、その参照をまとめても業務上の条件を守れるか判断するところに手間がかかります。取得処理が簡潔でも、表示用の変換処理や共通部品で関連データを参照している場合を、この例の確認対象に含めます。
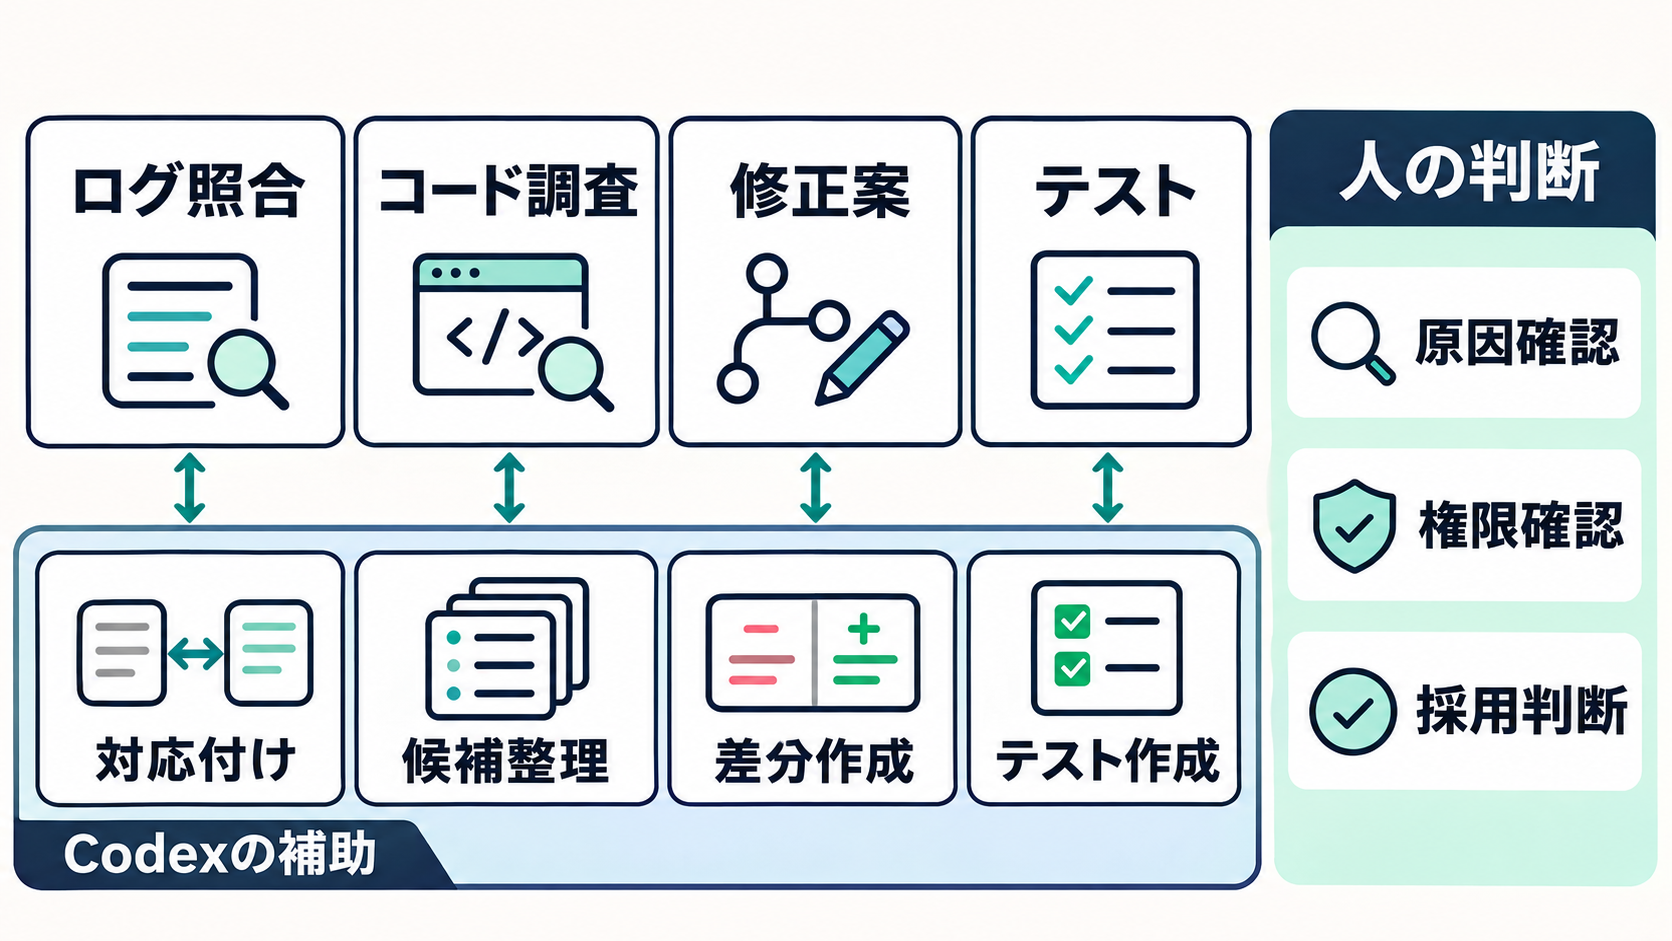
従来工程を分けると、資料探しでは対象ルート、一覧取得処理、関連定義、既存テストを探します。分類ではSQLを発生箇所ごとに整理し、集計では同じ計測範囲の取得回数を数えます。修正案を作る段階では、既存ORMで採用されている関連取得方法を調べ、表示順や権限制約への影響を検討します。最後にテストを追加し、修正前後の結果を比較します。
Codexを使う提案でも、入力と完成条件はそろえます。対象のコード、匿名化したデータ、再現条件を渡し、成果物を「原因候補の根拠、限定した修正差分、回帰テスト、実行記録」と定めます。AIを使う場合だけ品質条件を緩めてしまうと、工程を比較できません。
| 工程 | AIを使わない進め方 | Codexへの依頼例 | 人が残す判断 |
| --- | --- | --- | --- |
| 調査 | ログとコードを照合します | 発生箇所と根拠を整理してもらいます | 原因の説明が再現条件に合うか確認します |
| 修正 | 関連取得方法を検討します | 既存実装に沿う限定的な差分を依頼します | 取得範囲と保守性を評価します |
| テスト | 条件を選び検証します | 回帰ケースとテスト実装を依頼します | 期待値と計測方法を確認します |
省略を狙うのは、根拠を探して転記する往復や、似たテストを組み立てる繰り返しです。業務仕様の決定まで省く提案ではありません。例えば「顧客が無効状態の受注も一覧に残すか」という条件は、コードから推測させるより、担当者が仕様として明示した方が修正の方向を定めやすくなります。
修正前に、対象範囲と変えてはいけない条件を渡す
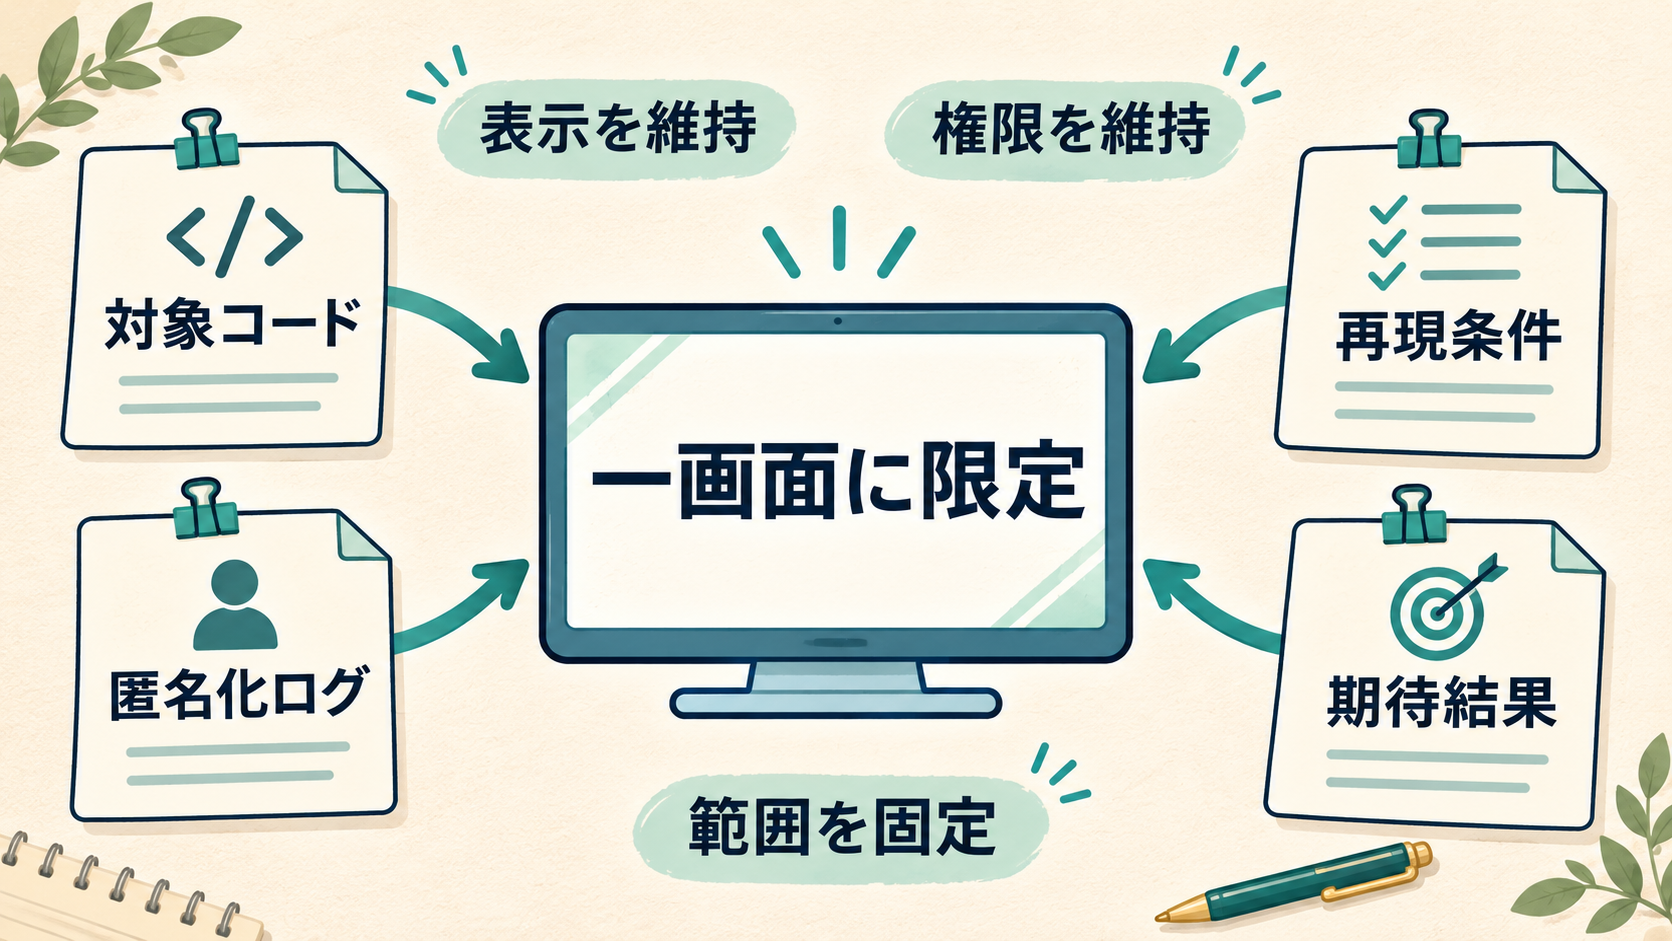
準備では、対象リポジトリを開発用の作業場所に用意し、既存テストが実行できる状態を確認します。Codexを利用できる既存環境があることを前提とし、ここでは導入画面や契約条件を扱いません。渡す資料は、対象画面の取得・表示コード、関連モデルの定義、該当テスト、匿名化したSQLログ、再現条件に絞る提案です。ログの値は、関連関係を追える形で架空値に置き換えます。
OpenAIの公式Cookbookでは、Codexが任意のAGENTS.mdをリポジトリの継続的な指針として読むことや、作業を小さな段階に分け、受け入れ条件と検証の証拠を整理する進め方が紹介されています。また、掲載されている他の計画ファイル群は、Codexの必須ファイルではなく推奨される運用上の慣例と説明されています。(出典: OpenAI Cookbook)
今回も専用の文書群を一式作る必要はありません。既存のAGENTS.mdがあれば内容を確認し、画面固有の条件は依頼文やチームの作業メモにまとめます。例えば、対象は受注一覧だけ、表示項目と並び順を維持、既存の権限チェックを維持、依存関係やデータベース定義の変更は今回の範囲外、と定めます。これは本稿の運用提案です。
テストデータも、件数だけを増やすより条件の違いを用意します。同じ顧客の複数受注、異なる顧客の受注、担当者が未設定の受注、別の閲覧権限に属する受注を架空データとして準備する例が考えられます。期待する受注IDの集合と順序を開発者が先に定めれば、修正後の出力をそのまま正解にする失敗を避けやすくなります。
既存テストの実行方法やログ取得方法も、リポジトリ内の説明から確認します。不明なコマンドを推測して埋める必要はありません。未確定の手順は未確定と記し、比較に必要な環境が整ってから実装へ進めます。
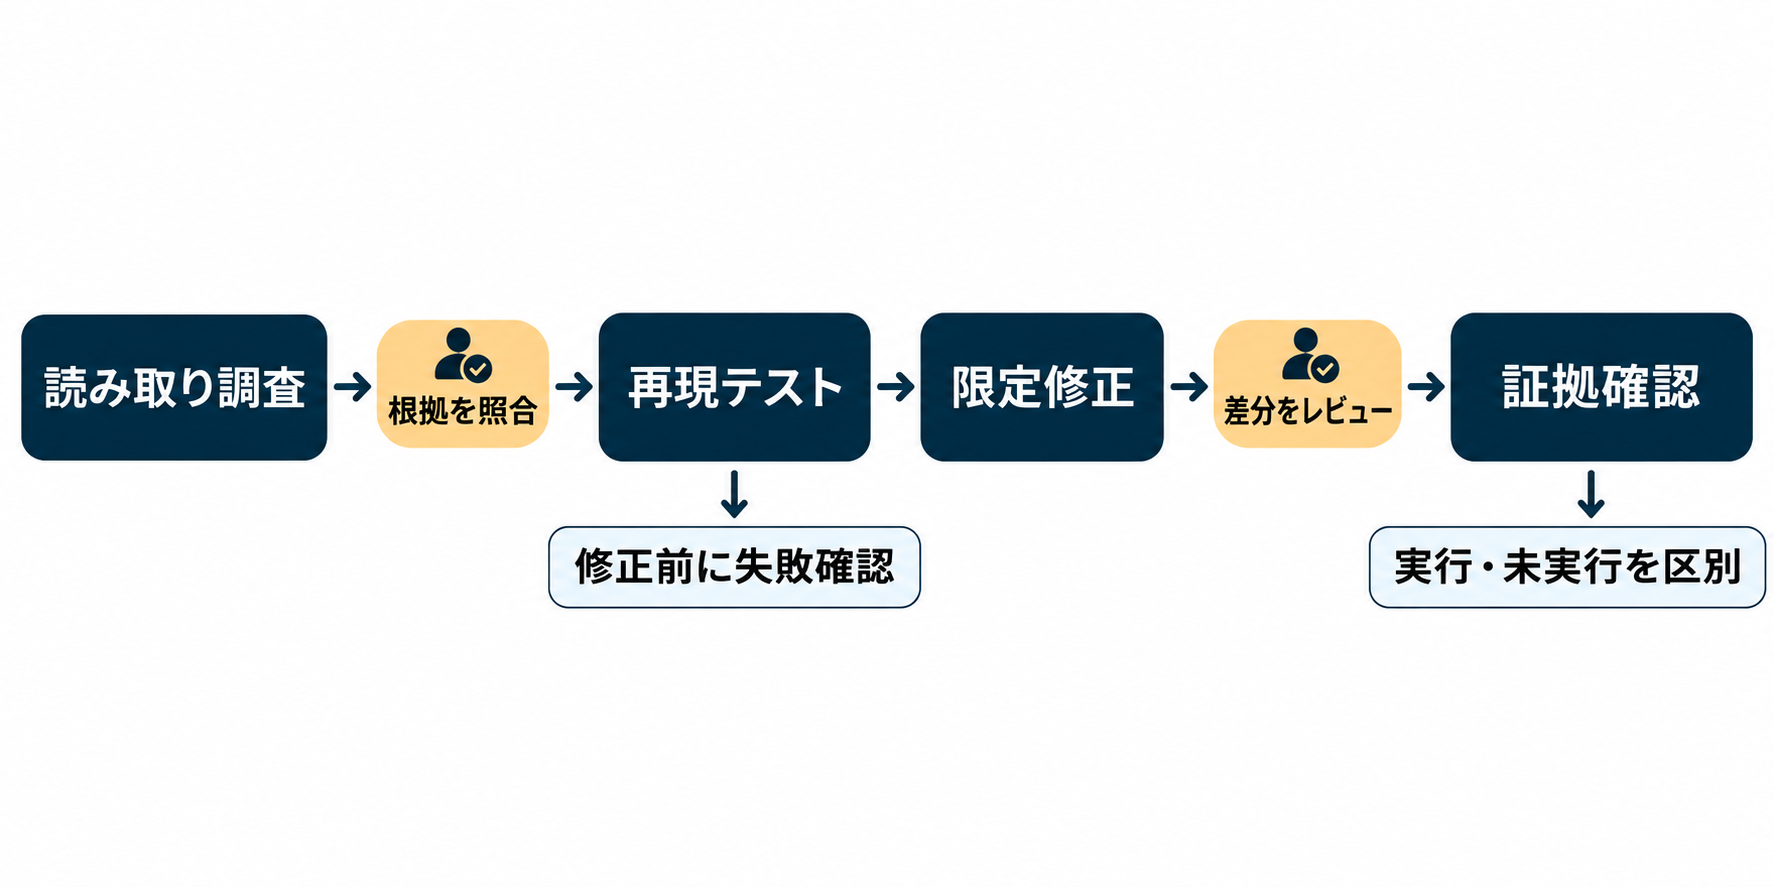
調査、再現テスト、修正を四段階で依頼する
操作は、既存のCodexの入力欄から、対象リポジトリを参照できるセッションへ依頼する想定です。以下のお願い文は本稿の提案例です。山括弧の箇所を実在するパスや条件へ置き換え、資料の内容と一致することを確認してから使います。製品固有のコマンドを追加する手順ではありません。
第一段階は読み取りによる調査です。原因と修正を一度に決めず、関連参照の発生箇所を根拠付きで整理してもらいます。コピーして使う調査用のお願い文です。
受注一覧画面のN+1クエリの疑いを調査してください。
今回は調査のみを行い、ファイルは変更しないでください。

対象コード: <一覧取得処理と表示処理のパス>
関連定義: <モデル定義のパス>
既存テスト: <該当テストのパス>
匿名化SQLログ: <ログのパス>
再現条件と期待結果: <作業メモのパス>

適用されるAGENTS.mdと既存のテスト方法を確認してください。
繰り返されるSQLと、原因候補の関連参照を対応付けてください。
根拠となるファイル位置を示し、事実と仮説を分けてください。
修正候補、影響範囲、必要な回帰テストを提案してください。
不明点は推測で補わず、未確認としてください。
第二段階では、開発者が調査結果を読み、対象リクエストのログとコード位置を照合します。そのうえで、問題を再現するテストを依頼します。表示結果を検証するテストと、関連取得の繰り返しを検出するテストを分け、修正前にどの理由で失敗する想定なのか説明してもらいます。
第三段階は、採用する方針を指定した修正です。コピーして使う実装用のお願い文を示します。
確認済みの調査結果に基づき、受注一覧だけを修正してください。
採用する方針: <レビューした修正方針>

既存ORMとテストの書き方に合わせてください。
表示項目、受注IDの集合と順序、絞り込み、ページ分割、
閲覧権限を維持してください。
依存関係、DB定義、他画面は変更範囲に含めません。

先に回帰テストを実行し、想定した理由で失敗するか確認してください。
その後、必要な修正を行い、対象テストを再実行してください。
実行できない場合は、理由を報告してください。
変更ファイル、実行内容、観測した結果、未確認事項をまとめてください。
コミット、プッシュ、デプロイは今回の依頼に含めません。
第四段階は、差分と検証記録の受け取りです。成果物の形式例は「原因候補:一覧の行変換時の関連参照です」「修正方針:既存の関連取得方式にそろえる案です」「検証:実行したテストと未実行の項目を分けて報告します」といった形です。これは回答形式の架空例であり、成功結果ではありません。修正案が範囲を超えた場合は、対象画面内の変更へ絞って再提案するよう依頼します。
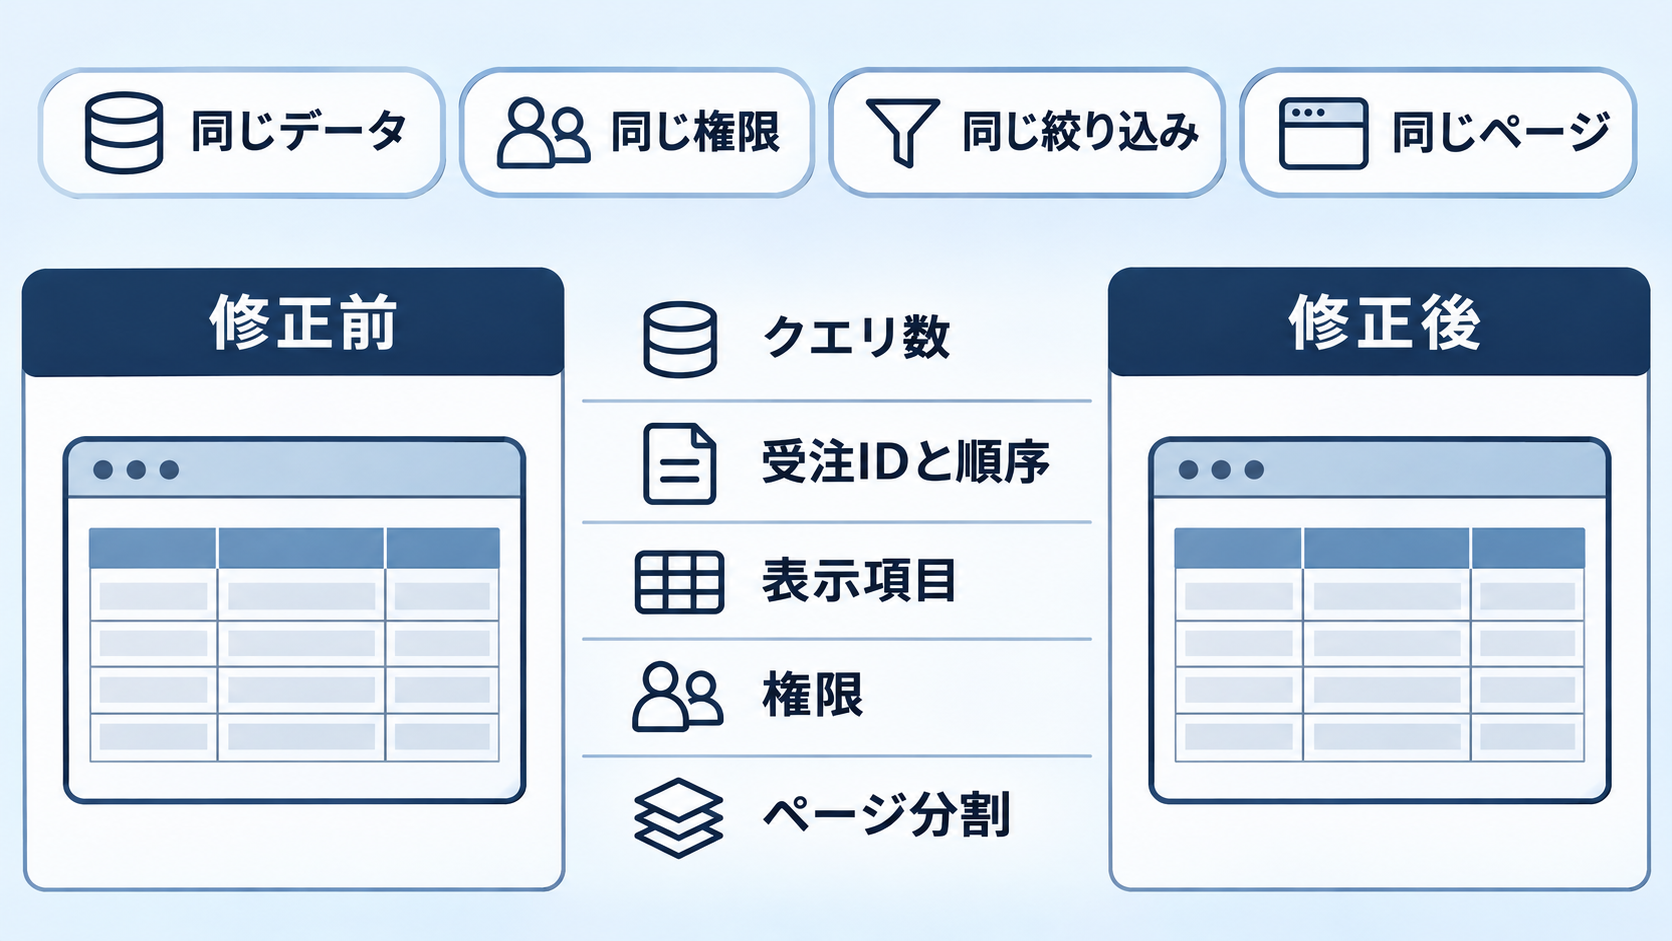
クエリ数と同時に、一覧の中身と権限を確かめる
レビューでは、取得回数が減ったという報告だけで完了にしません。同じデータ、同じ利用者権限、同じ絞り込み、同じページ条件で、修正前後の取得結果を比較します。受注IDの集合と順序、顧客名や担当者名、金額、欠損値の扱いを照合する確認手順を提案します。画面の見た目が似ていても、対象外の受注が混ざっていれば受け入れられません。
クエリ数の計測では、どこからどこまでを数えるか決めます。例えば、対象画面の応答を組み立てる範囲とし、データ準備や別リクエストを混ぜない方針です。初回の準備処理やキャッシュの条件もそろえ、除外する問い合わせがあれば理由を記録します。修正前を冷えた状態、修正後をキャッシュ済みの状態で測るような比較では、変更の効果を判断しにくくなります。
回帰テストでは、架空の検証条件として表示件数を10件と30件に変え、関連データ取得の回数が表示件数に追随して増えるかを観測する方法があります。これらは実測値ではありません。固定の期待クエリ数は実装と計測結果から決め、根拠のない上限をテストに埋め込まないようにします。
ページ分割も重点項目です。関連取得方法を変更した差分を見て、ページ内の受注が重複・欠落しないか、総件数や並び順が保たれるかを確認します。権限については、一覧本体の絞り込みだけでなく、関連データの取得条件にも着目します。権限の異なる架空データを用意し、期待した受注だけが表示されることをテストします。
最後に、人が既存の権限チェック、変更した問い合わせ、追加テストの期待値を読みます。Codexが作成したテストでも、その期待値が仕様から導けるかは別途確認が必要です。対象テストの後には、プロジェクトで必要とされる関連テストやチェックを実行し、未実行のものは理由とともに残します。取得回数が減っても応答時間まで改善したとは限らないため、性能を評価する場合は時間や取得量も同条件で別途測定します。
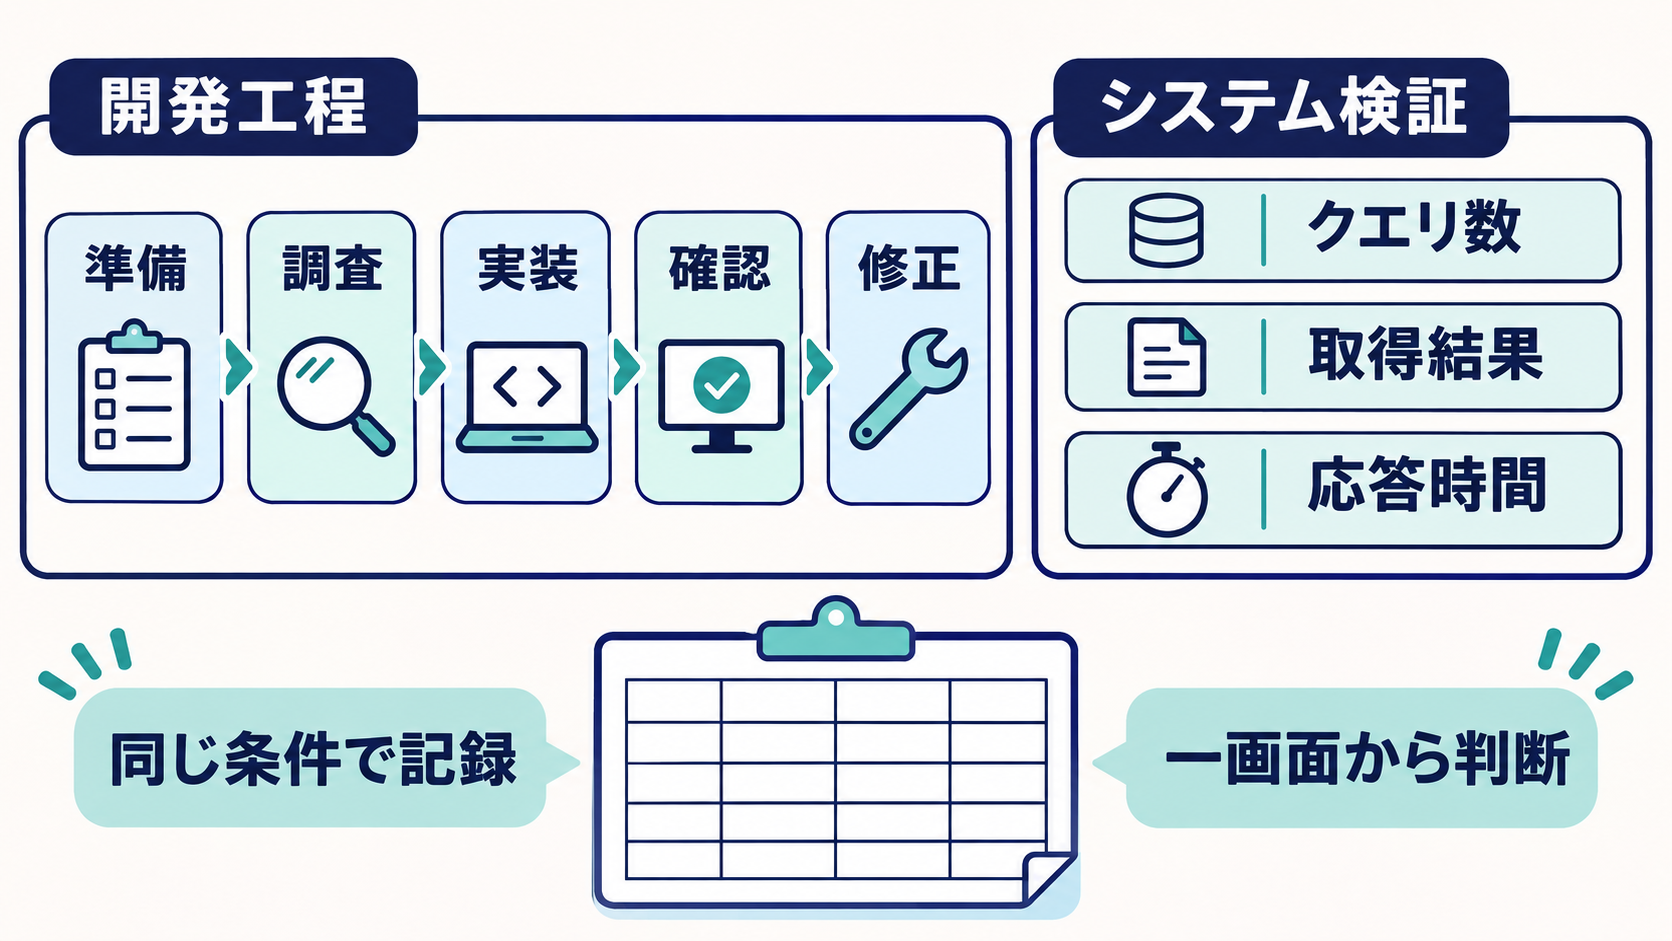
準備とレビューを含めて、一画面で効果を判断する
今回の活用で手間を減らせる可能性があるのは、ログとコードの対応付け、修正候補の下書き、既存の書き方に沿った回帰テスト作成です。関連する資料がそろい、画面の範囲が明確なら、調査結果からテストへ情報を移す繰り返しをまとめやすくなります。反対に、仕様や再現条件が曖昧なままでは、提案の読み直しや追加説明が増える可能性があります。
効果を確かめる際は、AIが修正案を返すまでの時間だけを記録しません。匿名化や入力整理、調査、実装、テスト実行、レビュー、追加修正に分けて担当者の作業を記録します。従来工程と比較する場合も、同じ入力と成果物、同じ品質条件を用います。既に原因を知っている再演を、初回調査と同等の条件として扱わないことも必要です。
システム側の改善と、開発工程の改善は別々に評価します。前者では、同条件でのクエリ数、取得結果、必要に応じた応答時間を確認します。後者では、資料準備やレビューを含む負担と手戻りを見ます。クエリ数が減っても修正差分が読みづらければ、保守上の負担が残るかもしれません。短時間で案が出ても、検証不足なら採用を見送る判断になります。
一回の結果から削減率を一般化する必要はありません。「関連コードを探す負担は減ったが、権限テストの準備には従来どおり確認が必要でした」といった、工程ごとの観測を残す方が、次の依頼を改善する材料になります。本稿では実測していないため、時間短縮や性能向上の数値は示していません。
最初の一歩は、N+1の疑いがある受注一覧を一つ選び、再現条件と期待する受注IDを作業メモに書くことです。そのメモと匿名化ログを渡し、読み取り調査だけを依頼してください。根拠となるコード位置を自分で照合できた段階で、回帰テストと限定した修正へ進めます。