

2026/11/14
AIニュース
OpenAIがロボット研究を再編と報道、汎用AIは専用モデルをどこまで代替できるのか
この記事の要点
OpenAIがロボット研究者を主要研究・応用開発組織へ移すと報じられています。背景には汎用モデルをロボットへ応用する期待がありますが、シミュレーションの成果と実機での完遂率は分けて評価する必要があります。日本企業には、対象作業を絞り、成功率や人の介入、処理時間を比較する検証が求められます。
目次
ロボット研究の再編が示す、開発の重心の変化
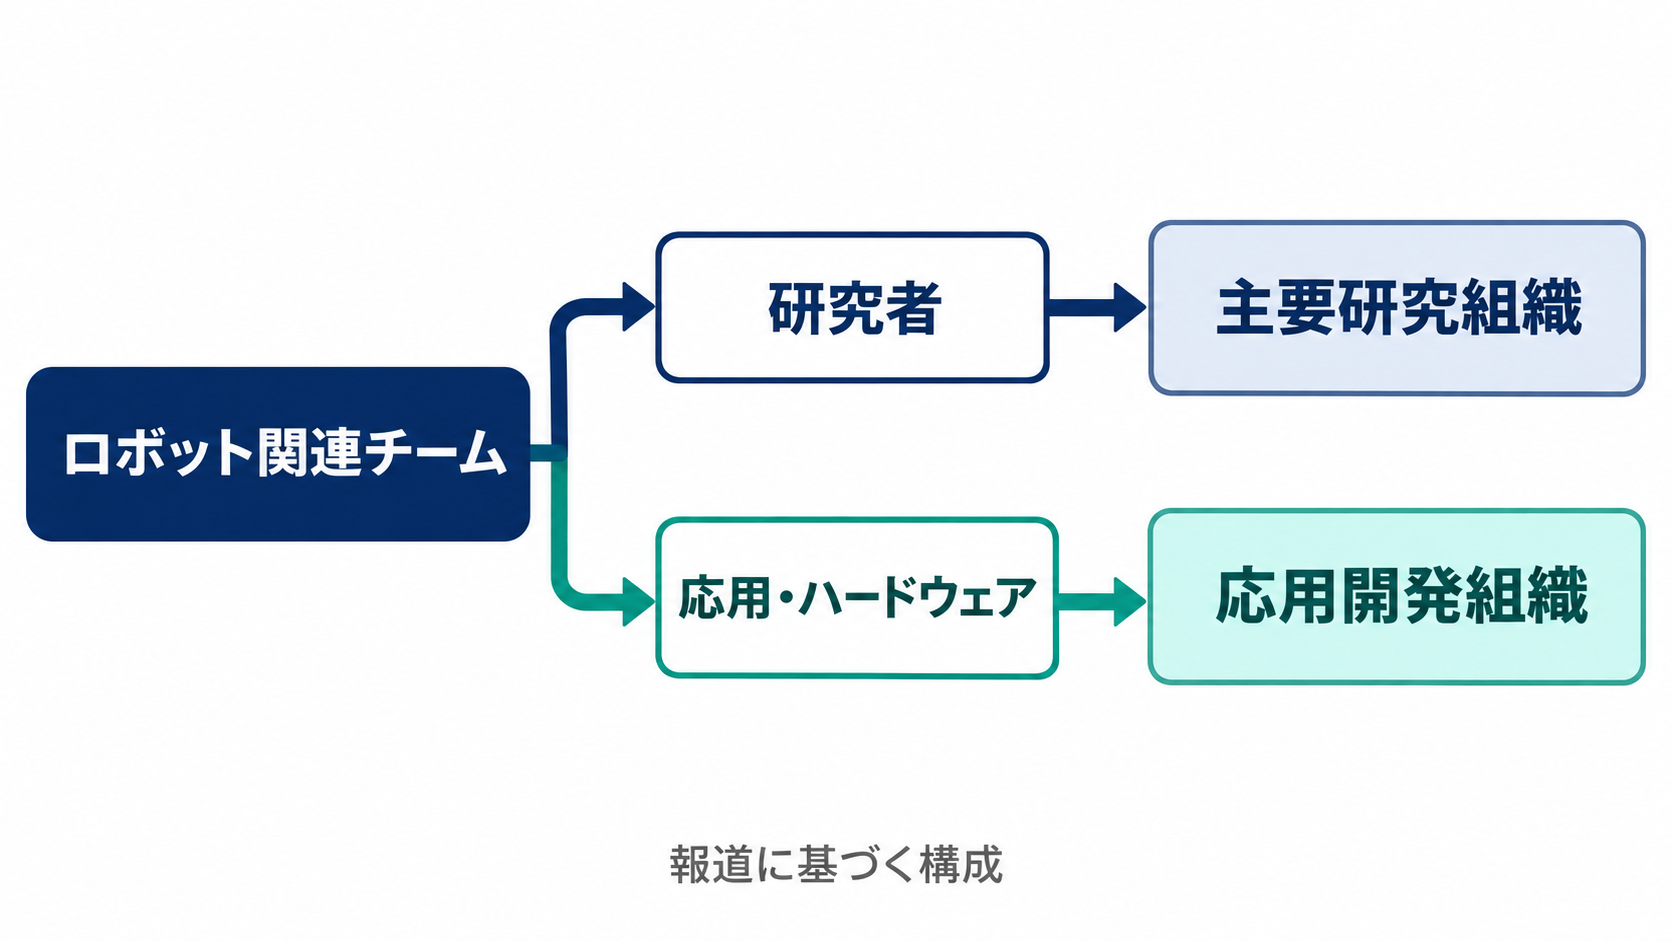
ロボットを賢くするには、ロボット専用のAIを育てる必要があるのでしょうか。OpenAIの組織再編を巡る報道は、この問いを改めて投げかけています。テックメディアのTHE DECODERによると、同社はロボティクス研究者を別の研究・開発組織へ移す方針です。ロボット研究から撤退するというより、汎用モデルの開発と結び付けて進める判断と伝えられています。
報道では、研究者は最高研究責任者のMark Chen氏が率いる主要研究チームへ、応用ロボティクスとハードウェアのチームはGreg Brockman氏の応用開発組織へ移るとされています。組織上の境界を変える動きですが、これだけで個々の研究テーマの継続や終了まで判断することはできません。焦点は、ロボットのための独立したモデル開発をどこまで必要とするかにあります。
背景にあるのは、GPT-6 Astraのような汎用モデルがロボットの制御も担えるという見方です。文章を扱うAIと、現実の物体を扱うAIを別々に育てるのではなく、共通のモデルの能力向上をロボットへ生かす発想と理解できます。ただし、今回の情報は報道に基づくもので、OpenAIが正式に示した技術戦略と同一視するのは適切ではありません。
Fortuneの報道として紹介されているのは、米テキサス州オースティンで開かれたロボット学習の学会、Conference on Robot Learning(CoRL)での出来事です。OpenAIは出展ブースを予約していたものの、当日は空いたままだったとされています。再編が急だったことをうかがわせる逸話ですが、技術的な成果や撤退を裏付ける証拠とは分けて受け止める必要があります。
成功率74.8%を、実機の性能と混同しない
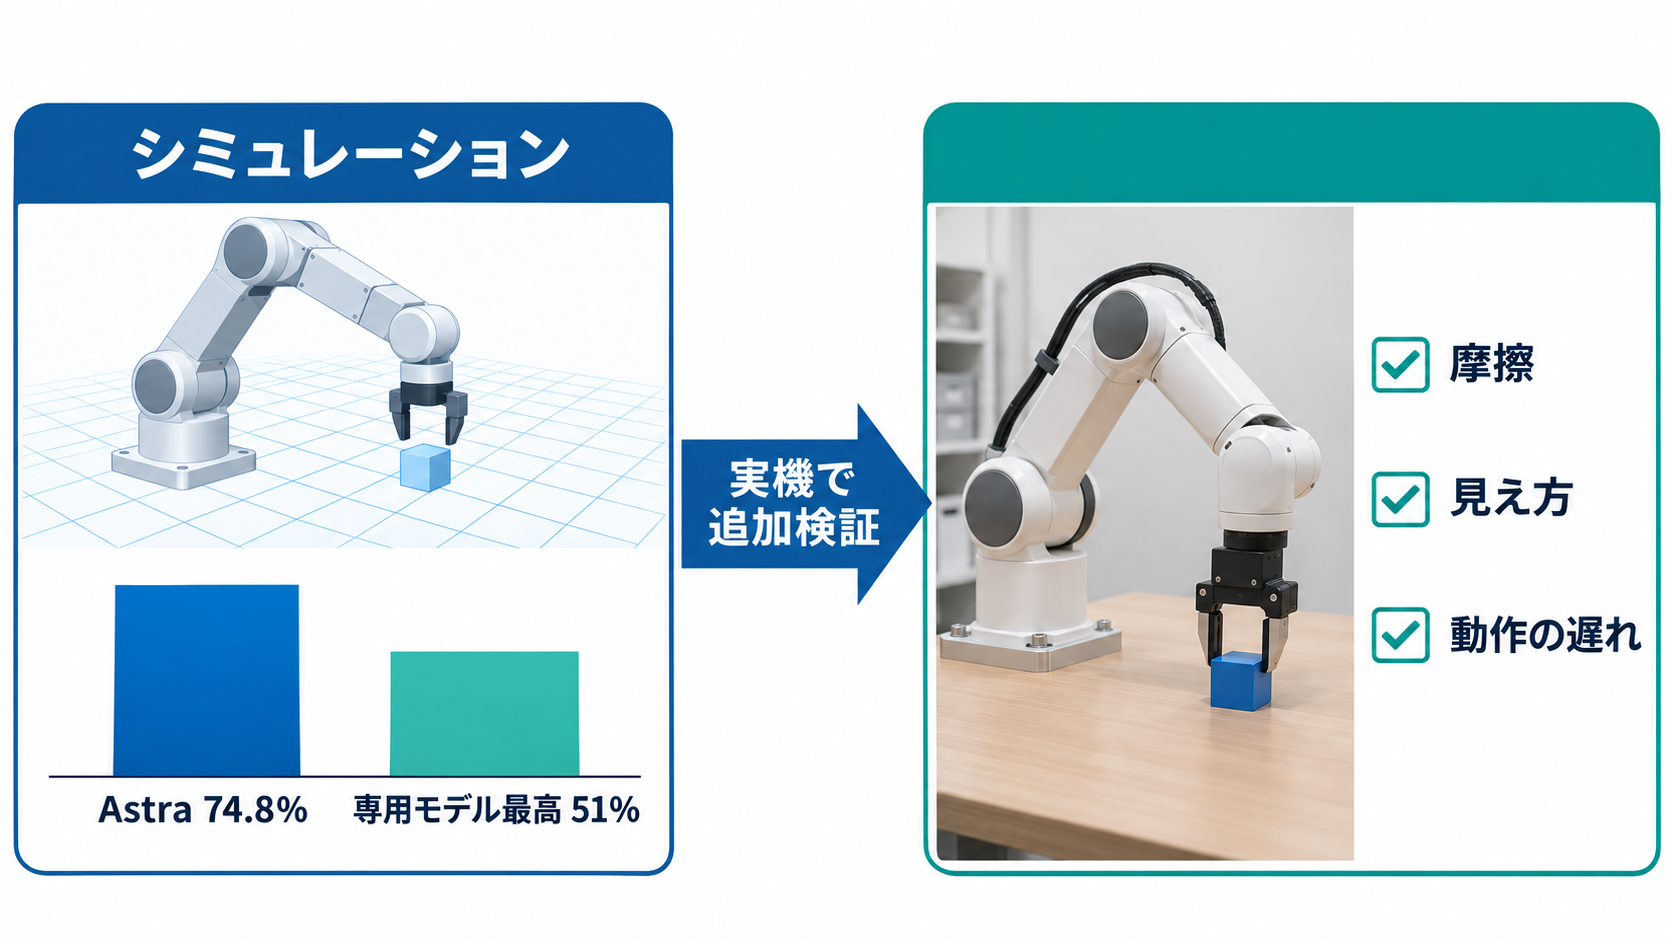
汎用モデルへの期待を支える材料として、Nvidiaの研究で示された数値が紹介されています。Astraを使ったエージェントは、シミュレーション上のロボット課題で74.8%の成功率を記録し、比較対象の専用モデルで最も高かった51%を上回ったとされています。同じ評価条件での差としては注目に値しますが、ここには実務上見落とせない条件があります。
試験で使われたのは、物理的なロボットではなく、シミュレーション上のDROIDロボットです。コンピューター内の環境で行動を試す評価と、実際の機械が物体に触れる評価では、確認できる範囲が異なります。したがって、この数値をそのまま工場や倉庫における作業成功率として扱うことはできません。
一般に、実機ではカメラの見え方、物体の摩擦、部品のたわみ、動作の遅れなどが結果に影響します。シミュレーションは条件をそろえて繰り返し試すのに役立ちますが、そこで表現していない要因まで検証したことにはなりません。これは今回のモデルに固有の欠点ではなく、仮想環境の成果を現場へ移す際に共通する確認事項です。
また、汎用モデルが行動を選べることと、センサーやモーターを含む制御全体を単独で担えることも別の話です。ロボットのシステムには、作業の判断、動作の生成、機械の制御など複数の役割があります。今回紹介された情報だけでは、Astraと他の構成要素がどの役割を分担したのか、詳細までは明らかではありません。
企業がこの結果を評価するなら、成功率の大小に加え、何を入力し、どの単位で行動を出力し、どの条件を成功と定義したかを確認する必要があるでしょう。74.8%という値は、汎用モデルをロボットへ応用する研究の有望な手掛かりです。ただし、導入先の性能を保証する数字として受け取る段階ではありません。
実機試験では、優位性と低い完遂率が同時に見える
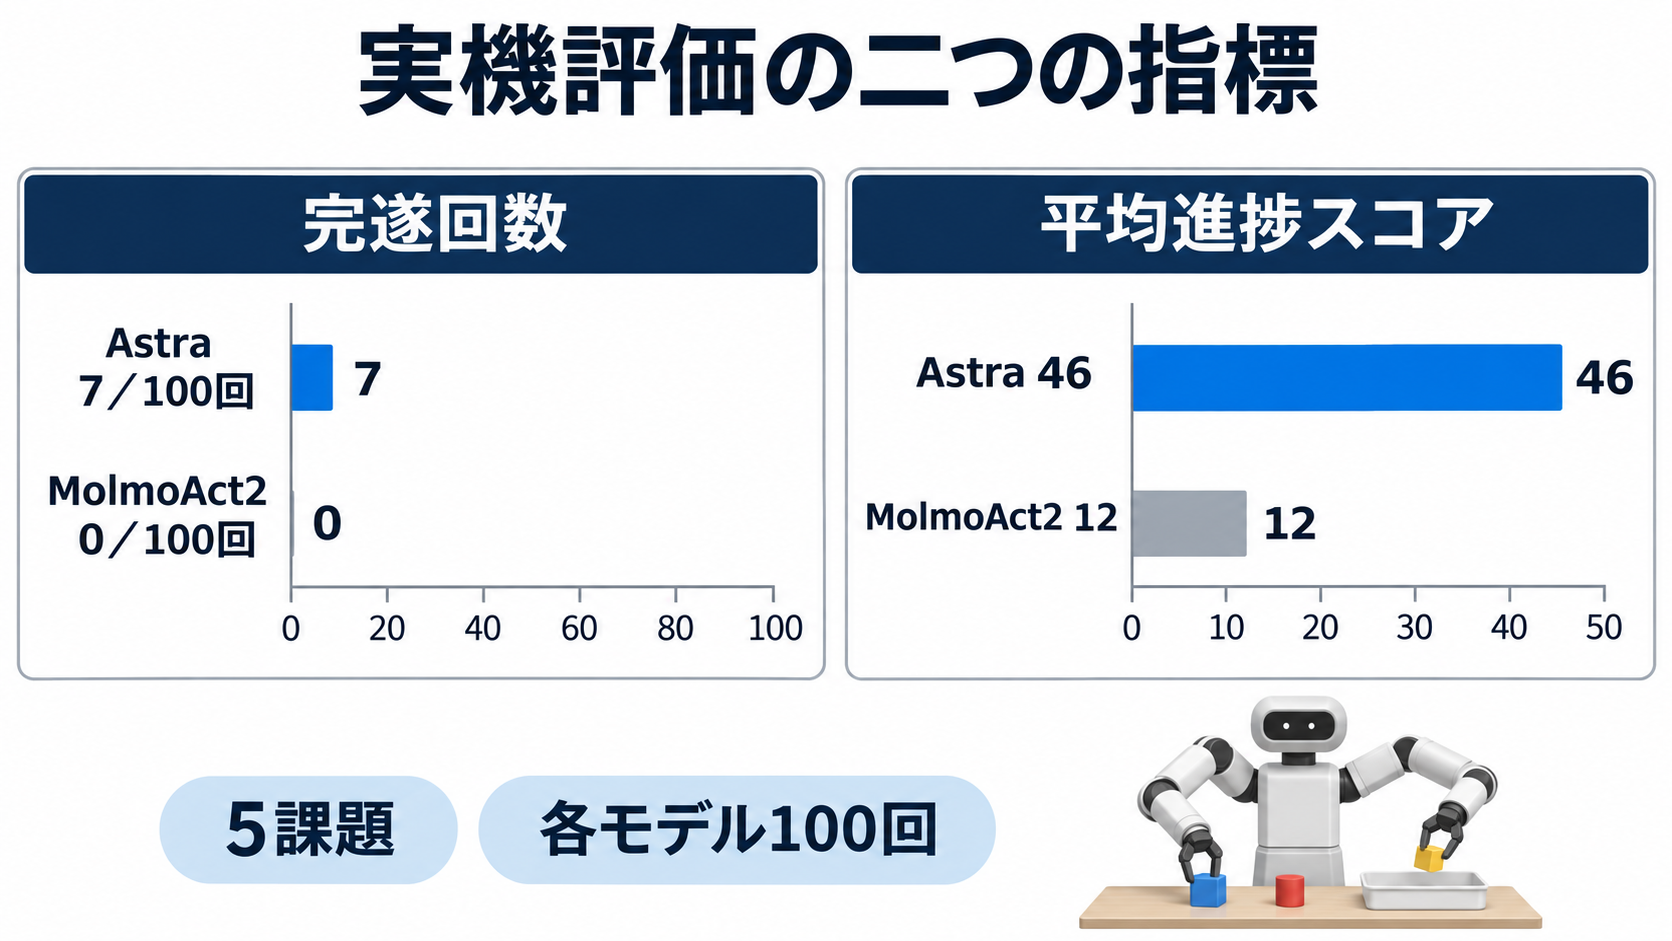
実際のロボットを使った評価として紹介されているのが、StationeryBenchという新しいベンチマークです。机の上の物体を扱う五つの課題で、GPT-6 Astraと、AI研究組織Ai2のMolmoAct2を比較しています。使用されたのは、二本のアームを備えるYAMのロボットです。ここでは、比較相手を上回ることと、仕事を最後まで終えられることの間にある距離が見えてきます。
両モデルを合わせた試行回数は200回で、Astraは100回中7回、課題を完全に達成したとされています。MolmoAct2の完遂は100回中0回でした。作業がどこまで進んだかを示す平均進捗スコアは、Astraが46、MolmoAct2が12と紹介されています。このスコアは完遂率とは異なる指標であり、そのまま百分率として読むことはできません。
この結果には二つの読み方があります。Astraは比較対象よりも多くの作業を進められた一方、100回のうち93回は完全な達成に至っていません。研究上の前進と、業務を任せられる水準かどうかは、異なる基準で評価する必要があります。進捗スコアだけを見れば、この差を見落とすおそれがあるでしょう。
例えば、物をつかんで目的地の近くまで運べても、指定した場所へ置けなければ、その後に人の手直しが必要になる場合があります。これは結果を理解するための一般的な例であり、StationeryBenchで実際に起きた失敗の内訳を示すものではありません。業務では途中まで進む能力にも価値がありますが、最終成果物や後工程の条件と結び付けて考える必要があります。
別の試験では、人型ロボット上で動作するAstraがキッチン内を移動し、片付けを行ったと紹介されています。ただし、繰り返した際の成功率や、人が介入した条件までは今回の情報から確認できません。実演によって可能な行動が見えることと、同じ作業を安定して再現できることを分けて見る姿勢が、導入判断には欠かせません。
空間を理解する能力が、文章と動作をつなぐ
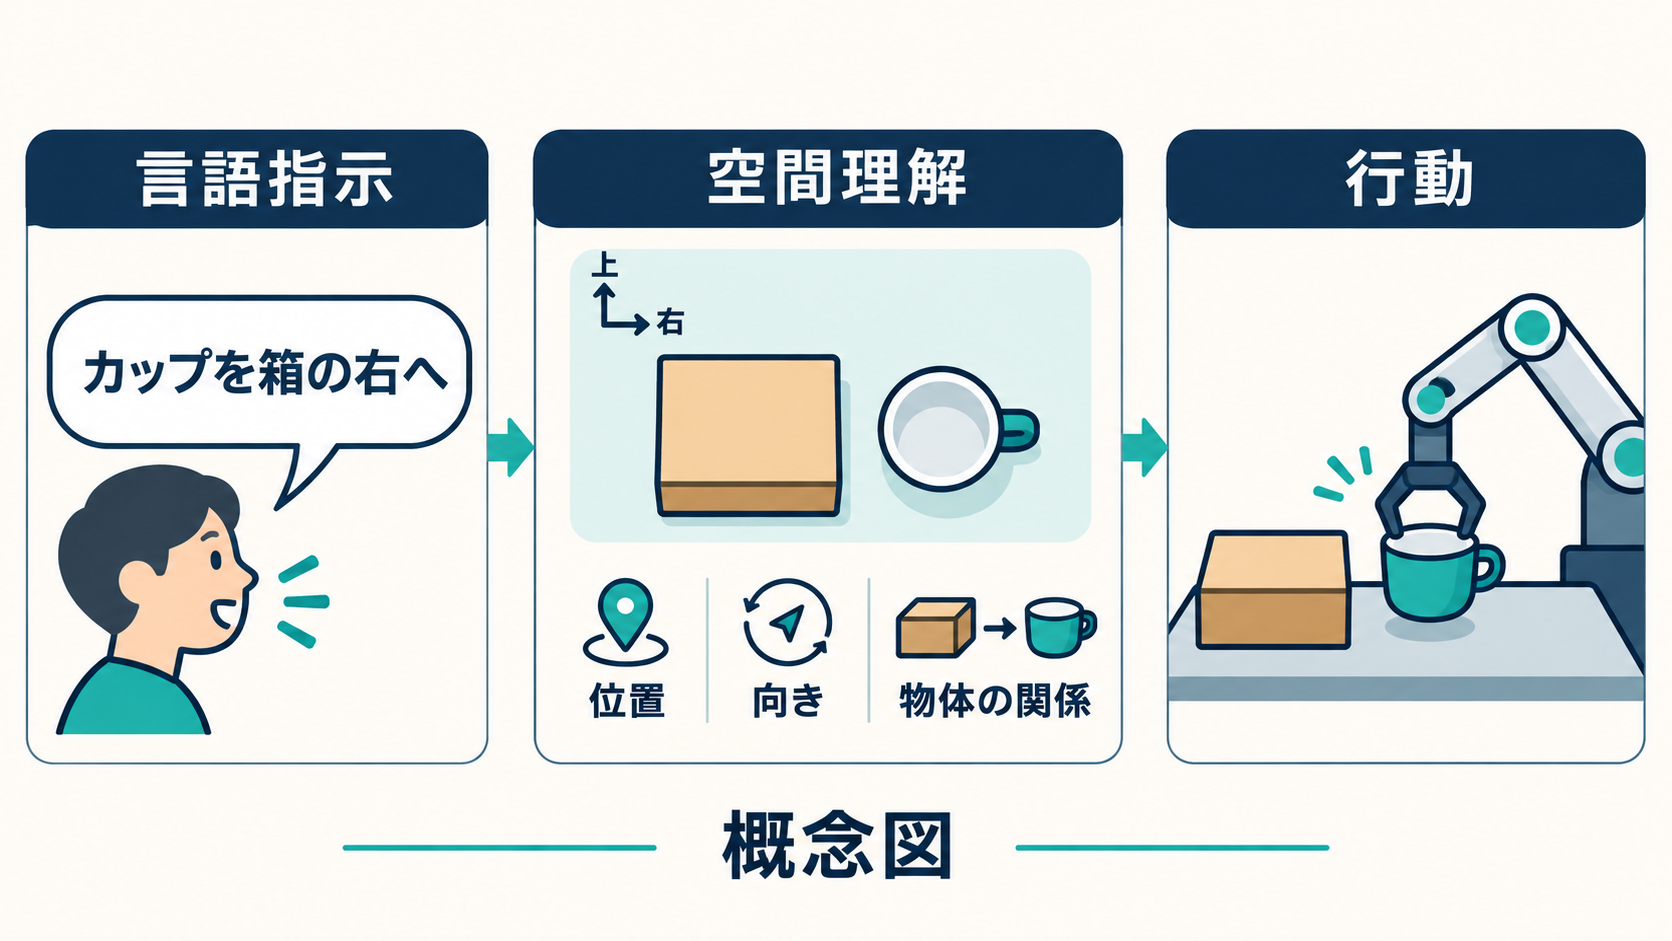
ロボットへの応用を考えるうえでは、指示文を理解する能力に加えて、物体の位置や向き、互いの関係を捉える能力が必要です。「カップを箱の右側へ置いてください」という指示でも、何がカップで、箱はどこにあり、どの方向を右とするのかを判断しなければなりません。言葉を正しく読み取れても、それだけで適切な動作が決まるわけではありません。
コーネル大学とGoogle DeepMindに所属するAI研究者のYoav Artzi氏は、Astraの空間理解を大きな進歩と評価しています。同氏によると、まだ公開されていないREMAPというベンチマークで、GPT-6 Astraは人間に近い正確さに達しているとのことです。ただし、評価の詳細が公開されていないため、どの条件での正確さなのかを独立して検討できる範囲には限りがあります。
Artzi氏は、OpenAIがBlenderのシーンなど、大量の3Dデータを学習に使った可能性を推測しています。Blenderは3Dモデルや空間の制作に使うソフトウェアです。人工的に作った場面のデータは、物体の配置や視点の違いを表現する手段になり得ますが、OpenAIが実際にどのデータをどれだけ利用したかは明らかではありません。
ここでは、観察された能力と、その能力が生まれた理由の仮説を区別することが大切です。空間課題でよい成績を示したという報告があっても、特定の学習手法が原因だったとまでは断定できません。ロボット関連のデータが学習にどの程度含まれていたかについても、不明な点が残っています。
企業にとっての着眼点は、汎用モデルが文章の処理を越え、視覚情報と作業指示を結び付けられるかという点でしょう。既知の配置で正解する能力と、物の位置や見え方が変わっても対応する能力を分けて評価すれば、自社の業務との距離を測りやすくなります。空間理解の成果は有用な材料ですが、それだけで実際の動作の確実さまで保証されるものではありません。
専用モデルの価値は、汎用性だけでは決まらない
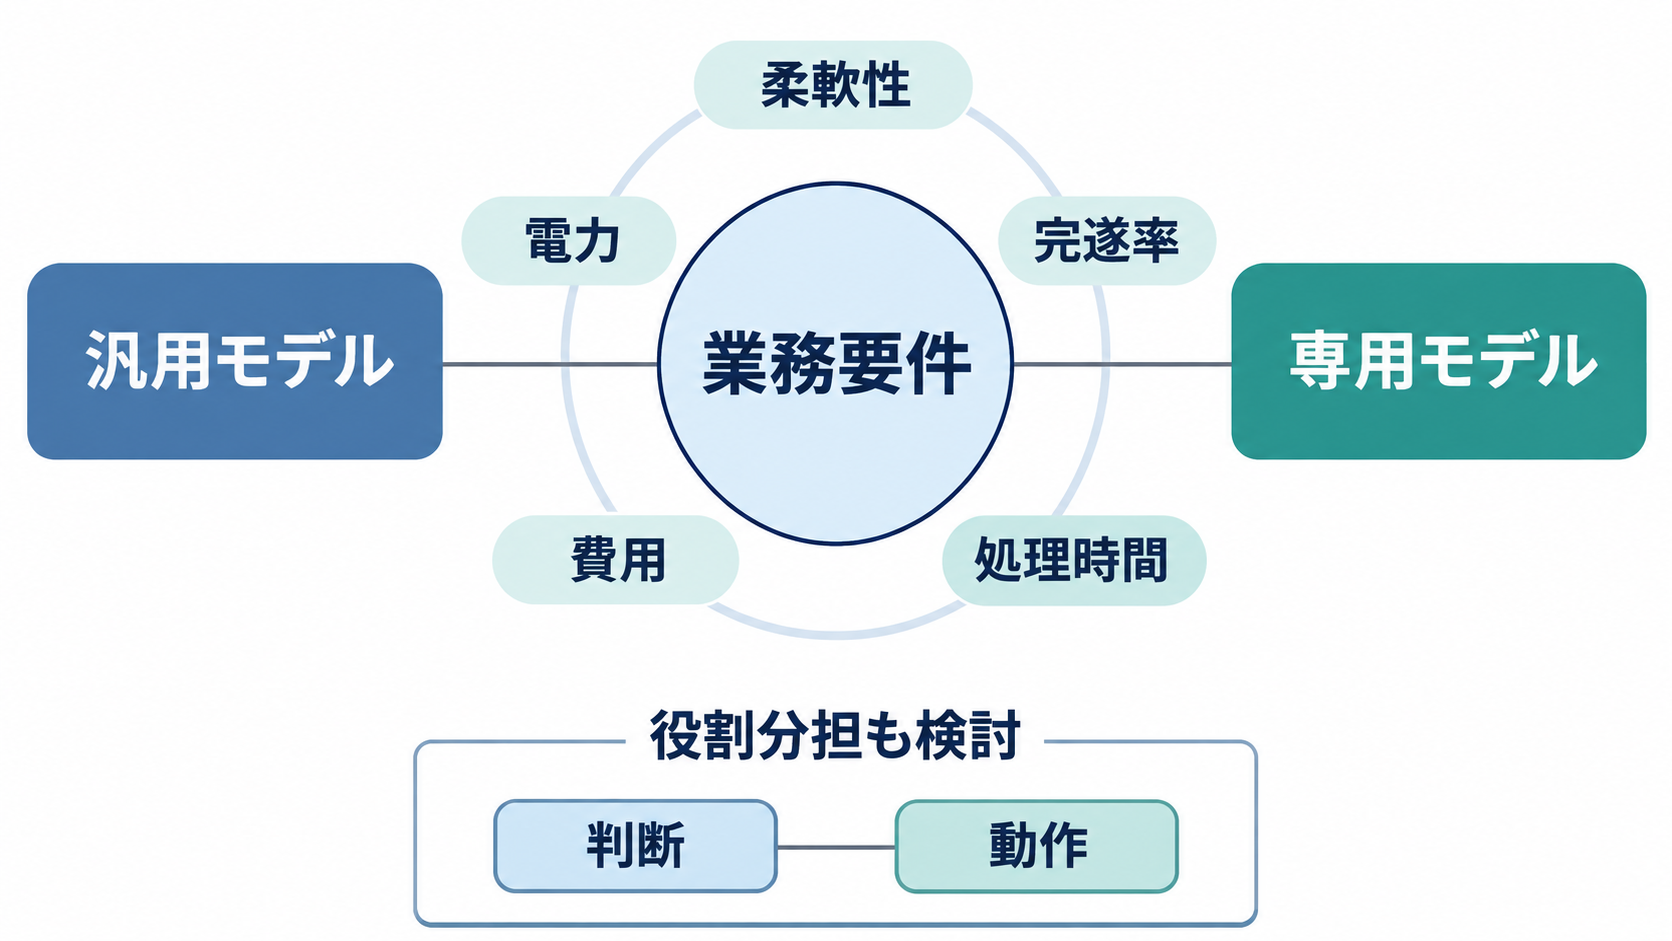
汎用モデルがロボット課題で成果を示しても、専用モデルの役割が直ちになくなるとは限りません。今回の報道でも、専用モデルにはコスト、信頼性、速度、エネルギー消費の面で利点が残る可能性が指摘されています。幅広い作業への対応力と、決まった仕事を効率よく続ける能力は、同じ尺度では測れません。
例えば、多様な物品や曖昧な指示を扱う業務では、状況に応じて判断できる柔軟さが価値になります。それに対し、対象物や手順が限定された工程では、処理時間の予測しやすさや動作の再現性が重視されるでしょう。これは個別製品の優劣を示す話ではなく、業務条件によって望ましい構成が変わるという一般的な考え方です。
汎用モデルが作業の意図や周囲の状況を判断し、専用の仕組みが細かな動作を担当する構成も、検討の余地があります。その場合、企業が選ぶのはモデル単体ではなく、役割分担を含めたシステム全体です。ただし、今回のOpenAIの再編がこの構成を採用することを意味しているわけではありません。
OpenAIは2020年にもロボティクス部門を閉鎖しています。共同創業者のWojciech Zaremba氏の説明として、必要な学習データが不足し、大規模言語モデルの方が汎用人工知能への近道と考えられたことが紹介されています。同社は2024年にチームを再建しており、今回の動きは研究領域と組織の関係を再び見直すものと捉えられます。
Sam Altman最高経営責任者が2027年の初の公開ロボット実演を目指しているとも報じられていますが、これは確定した製品発売日ではありません。THE DECODERは、主力のAI事業へ集中する財務上の圧力にも言及しています。技術面の期待と事業上の資源配分が重なる再編と考えられるものの、組織変更だけから将来の製品構成まで読み切ることは難しいでしょう。
日本企業は、任せたい一作業から評価を始める
日本企業が今回のニュースから検討すべきなのは、専用AIをすぐに置き換えるかどうかより、自社で何をロボットに任せたいかです。モデルの汎用性が高まれば、従来は個別の調整を必要とした作業へ対応できる可能性があります。ただし、ベンチマークでの優位性が、そのまま自社設備や作業条件での有用性につながるとは限りません。
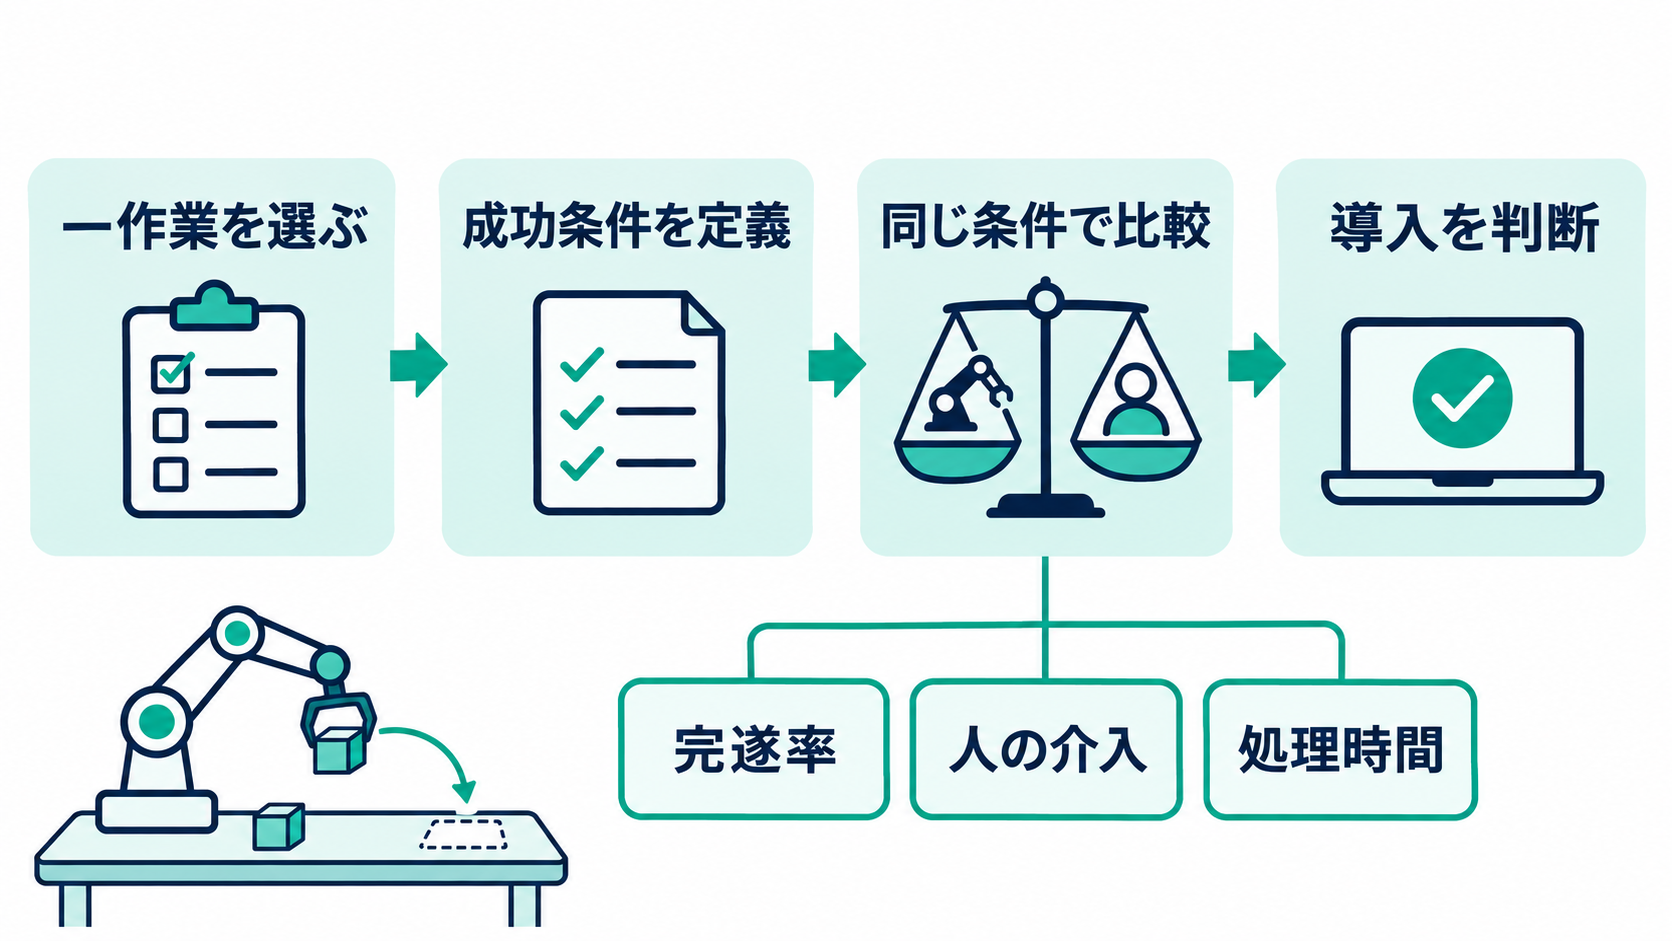
評価の出発点としては、対象を一つの作業に絞る方法が考えられます。対象物、開始時の配置、終了とみなす状態を明確にし、人がどの時点で介入したかも記録します。「片付けられました」という説明だけでは比較が難しくても、「指定の物を所定の場所に置けた回数」なら、同じ条件で検証しやすくなるでしょう。
確認したいのは、完全に達成した割合、処理にかかった時間、人の手直しの頻度です。途中まで進む能力にも用途はありますが、残った作業を人が引き受けるなら、その負担まで含めて評価する必要があります。StationeryBenchで示された完遂回数と進捗スコアの違いは、この考え方を具体的に示しています。
導入先の違いも無視できません。対象物が固定された工程と、日々異なる物を扱う場所では、求める柔軟さが異なります。汎用モデルの採用を検討する際も、既存の専用モデルや制御方式を同じ作業条件で比較すれば、追加の能力に見合う費用や処理時間かどうかを判断しやすくなります。
今回の報道は、ロボット研究の成果が専用チームの規模だけでは測れなくなる可能性を示しています。しかし、企業の導入判断を支えるのは、自社の仕事をどれだけ確実に完了できるかという証拠です。検討を進めるなら、任せたい作業を一つ選び、成功条件と人の介入を記録する項目を決めてください。その小さな評価設計が、新しいモデルの発表を具体的な投資判断へつなげる足場になります。