

2026/11/14
AIニュース
大量の文書を16個のメモリトークンへ、Stanford発「Memorilla」の性能と企業導入の論点
この記事の要点
Stanford大学の研究チームが、文書集合の情報を16個のメモリトークンに集約するMemorillaを公開しました。FactKGでは全文入力を上回る精度と入力削減を報告していますが、短い文献の質問応答では比較手法を下回ります。企業導入では、日本語の精度、GPU要件、根拠提示を含めた検証が必要です。
目次
文書をすべて読ませる運用を、16個のメモリで変える発想
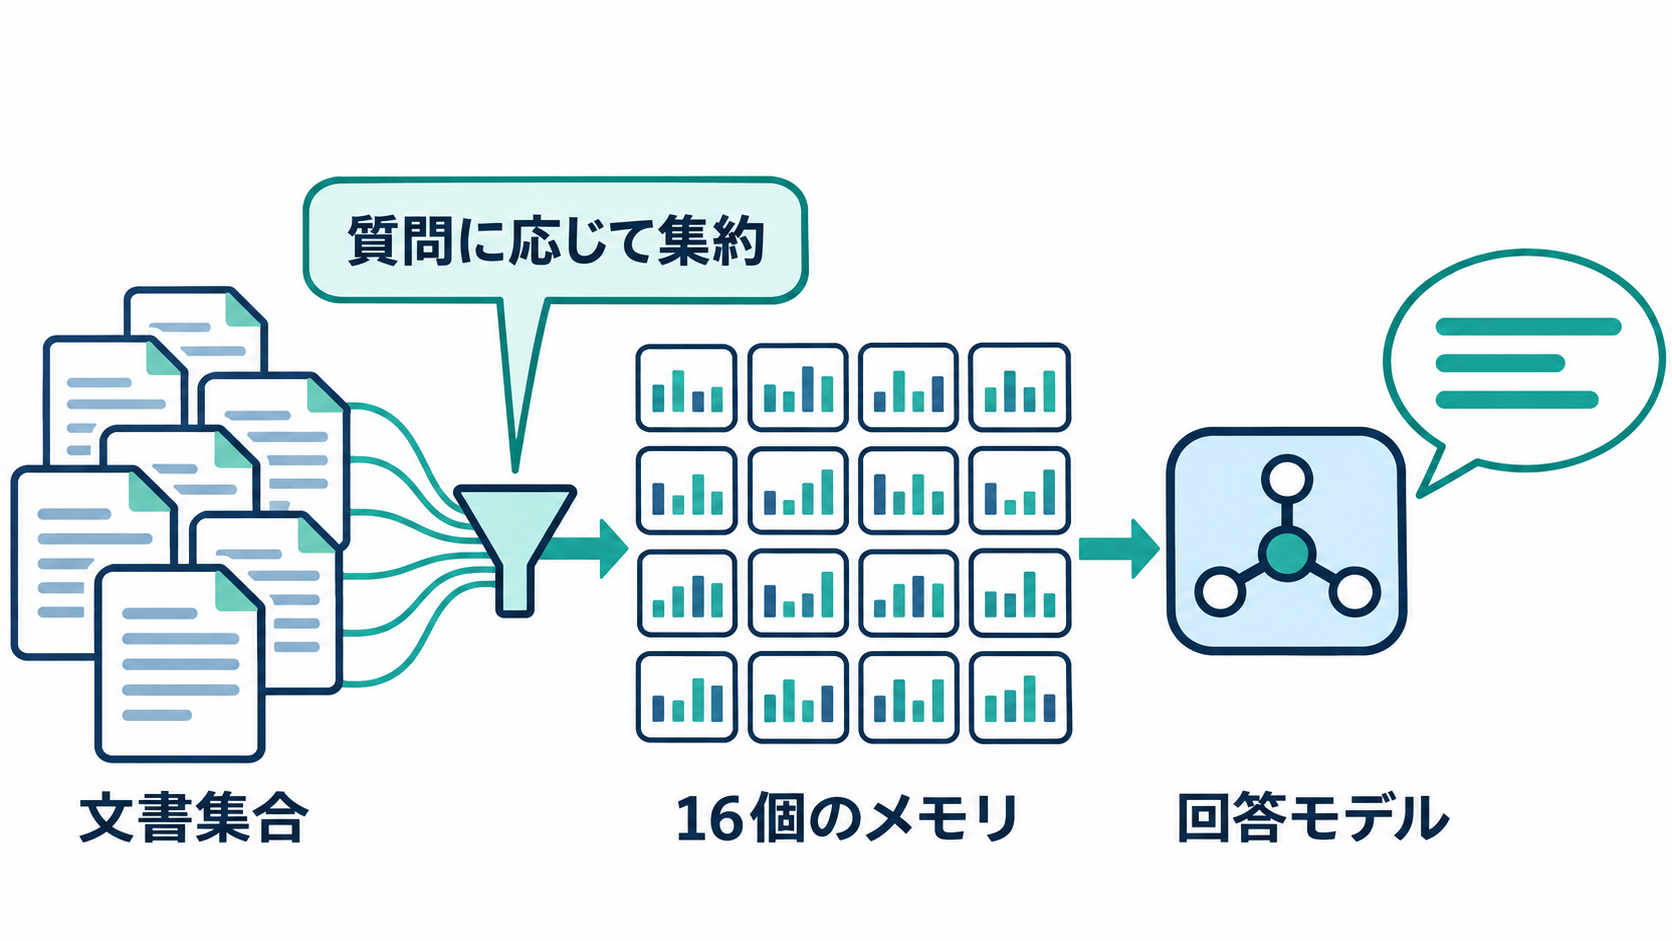
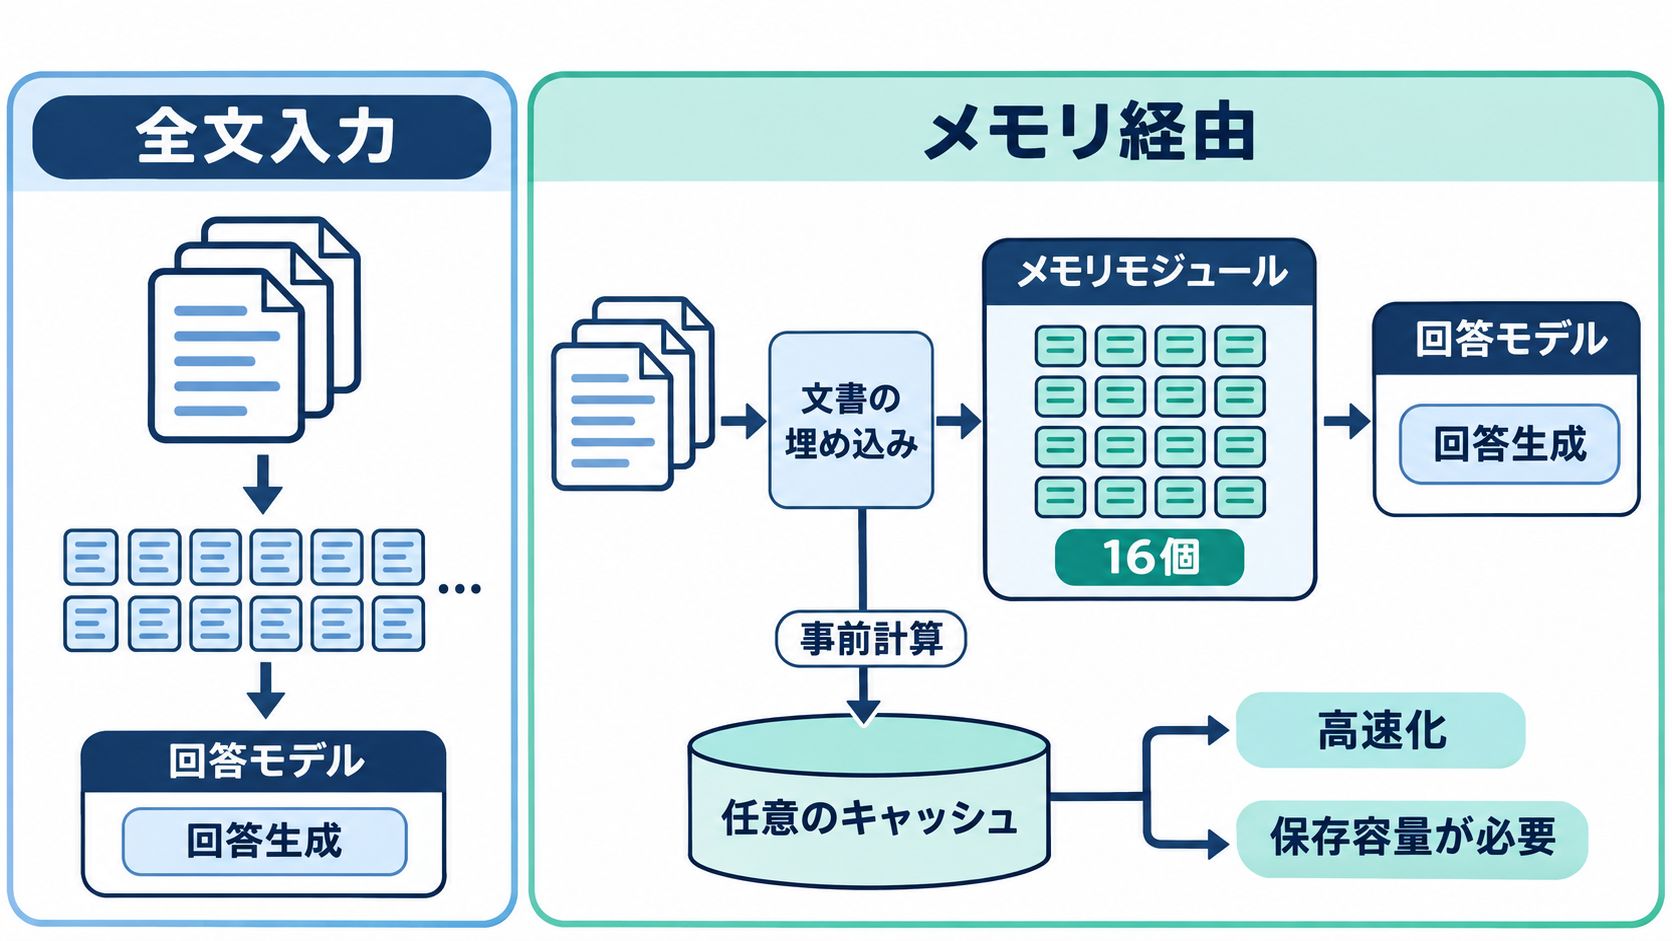
社内文書を参照するAIに、どこまで資料を渡すべきでしょうか。関連しそうな文書を増やせば回答の手掛かりは増えますが、入力が長くなり、応答を待つ時間も延びます。検索で絞り込む場合は、質問と表現が似ていない重要な情報を取りこぼすかもしれません。Stanford大学の研究チームが公開した「Memorilla」は、この問題に対し、文書集合の情報を16個のメモリトークンに集約して言語モデルへ渡す方法を提案しています。
開発を担うのは、Stanford大学でネットワーク分析などを研究するJure Leskovec氏のSNAPグループで、トロント大学、ペンシルベニア大学、MITの研究者も参加しています。Memorillaの特徴は、回答を生成する大規模言語モデルそのものを追加学習せず、情報を渡すためのメモリモジュールを学習する点です。文書集合の規模が変わっても、回答モデルに渡すメモリは16個に固定されます。
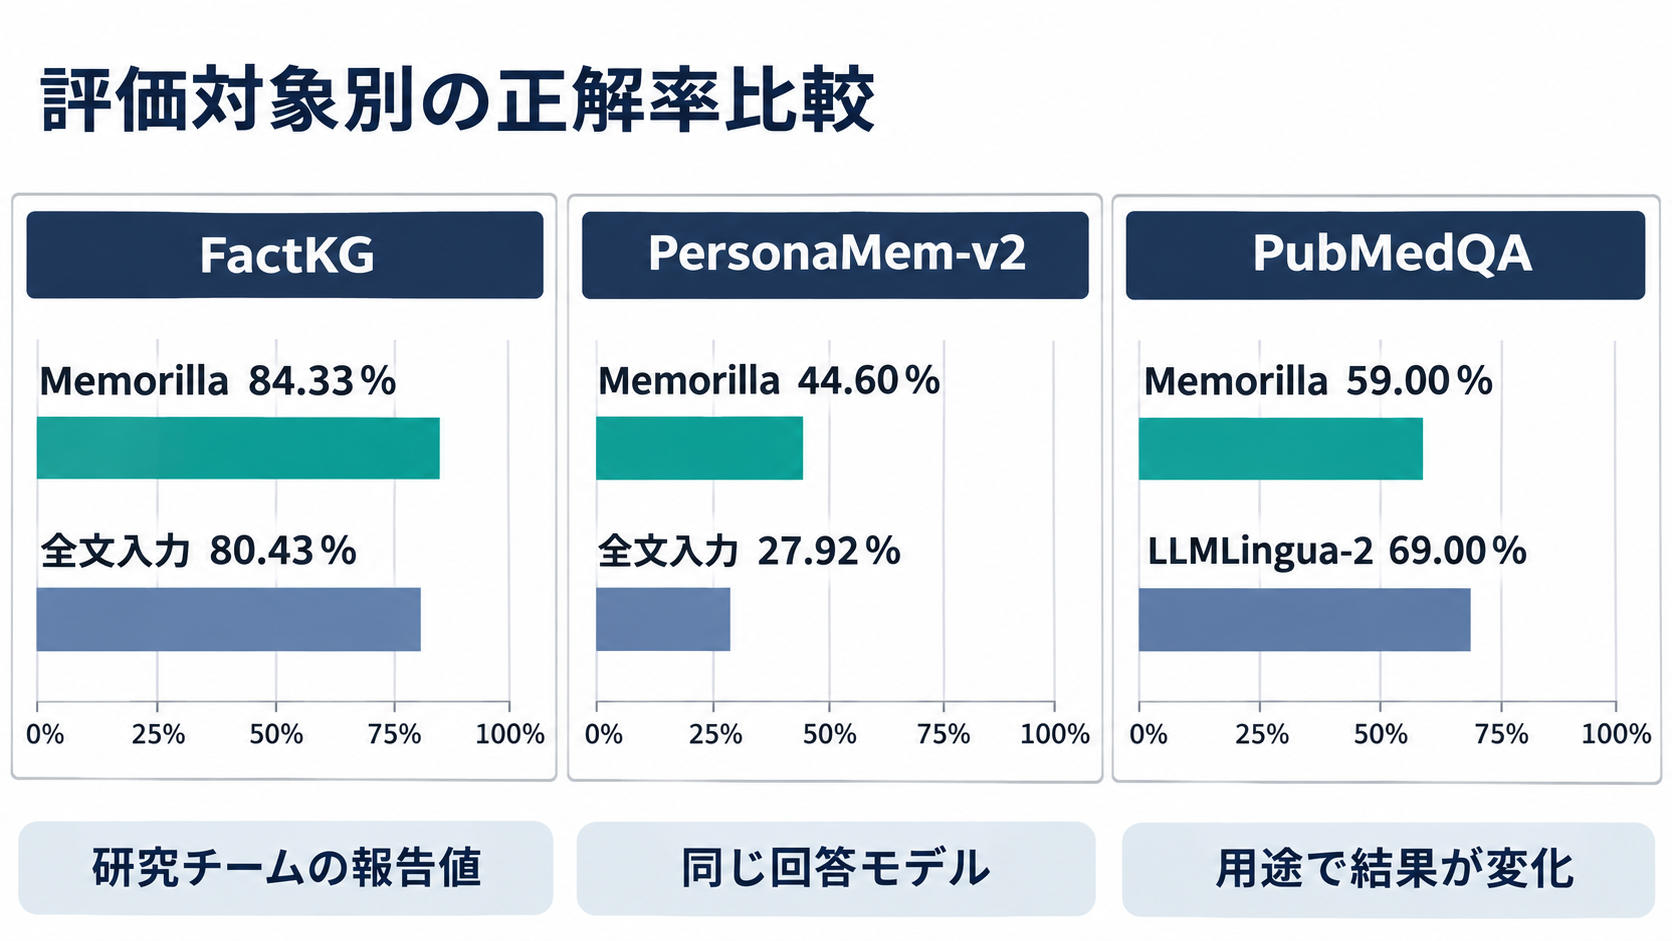
研究チームの報告では、事実検証ベンチマークのFactKGで、Memorillaを使ったQwen3-8Bの正解率は84.33%でした。すべての文書を入力した場合の80.43%を上回り、文書情報を渡すトークン数は108分の1に減っています。入力を圧縮すると精度も落ちる、という単純な関係には収まらない結果です。
ただし、16個という数字は、システム全体が16トークン分の処理だけで動くことを意味しません。文書の事前処理や質問に応じた読み出しは必要です。企業が注目すべき中心的な論点は、情報を短く表現できること自体よりも、自社業務で必要な情報を保ちながら回答モデルの入力負担を減らせるかどうかにあります。
16個のトークンは、短い文章ではなく学習したベクトル
Memorillaが出力するメモリトークンは、人が読める16語の要約ではありません。文書の情報を数値で表現したベクトルで、回答モデルの入力として使うために学習されます。文章の抜粋を貼り付ける一般的なRAG、つまり検索拡張生成とは、情報の受け渡し方が異なります。この違いを押さえると、圧縮率の高さと導入上の制約を理解しやすくなります。
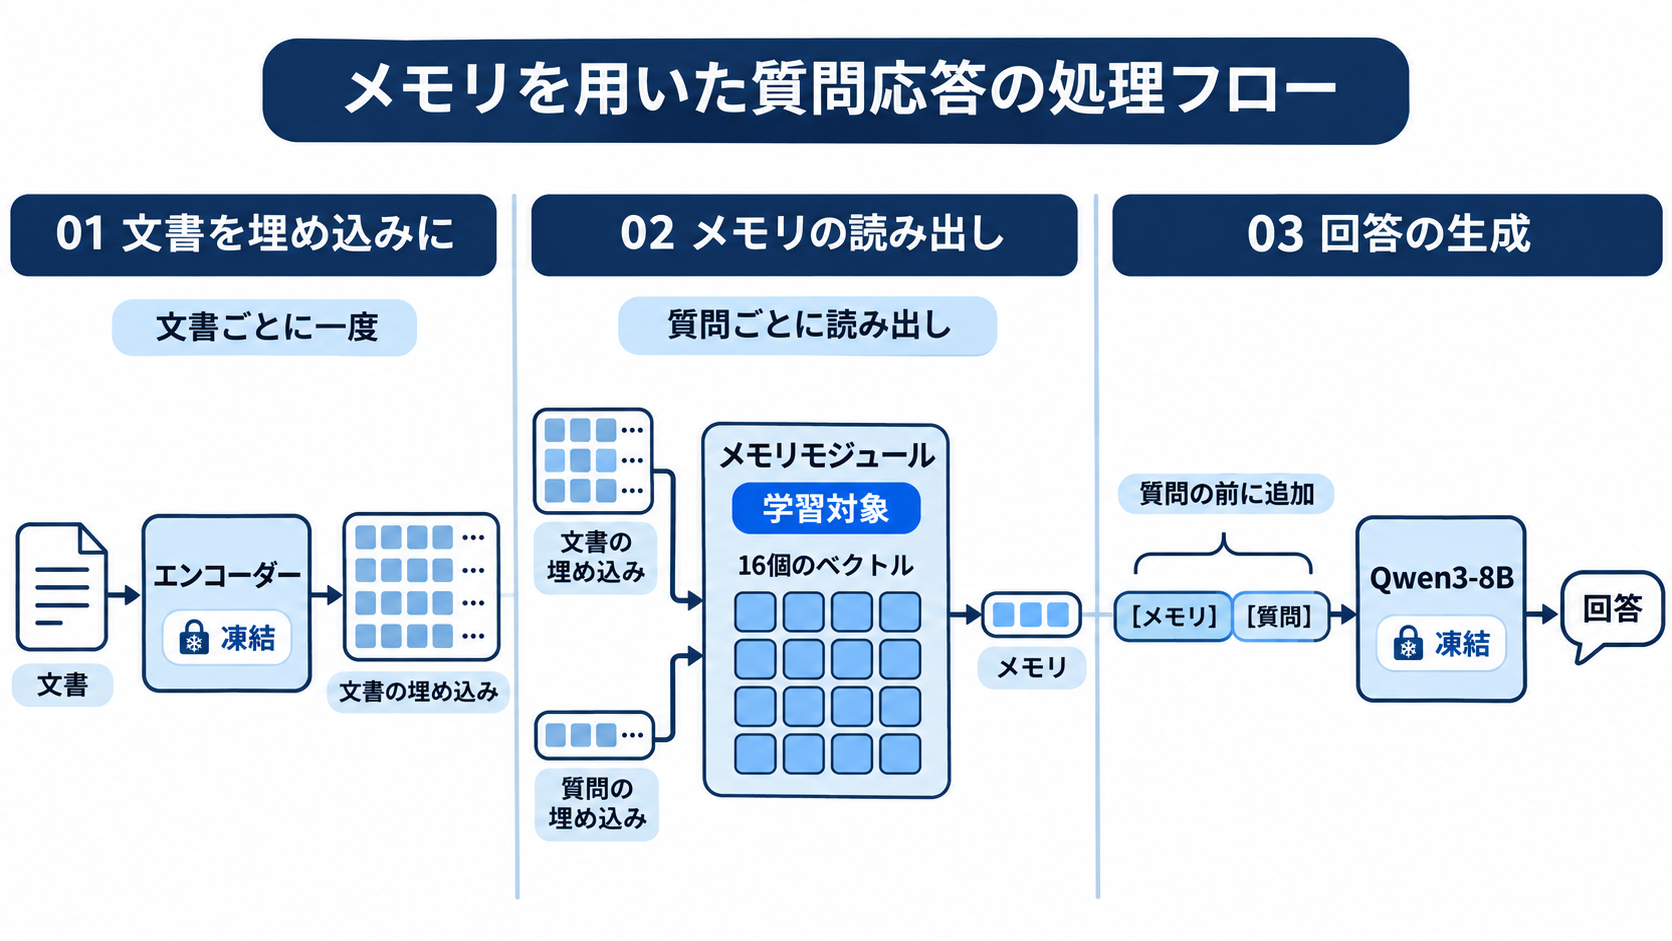
処理は文書の埋め込みから始まります。Qwen3-Embedding-4Bが各文書を一度だけ読み、数値表現に変換します。新しい文書を追加しても、既存文書の埋め込みをやり直す必要はありません。ここで使うエンコーダーと、回答を生成するQwen3-8Bは、いずれも学習時にパラメーターを更新しない「凍結」状態です。
質問が届くと、16個の学習可能なスロットが質問と文書集合を参照します。モジュールは、二つのクロスアテンション層と八つのヘッドを使い、必要な情報を取り込みます。クロスアテンションは、別の情報集合のどこに注目するかを計算する仕組みです。最後に、スロットをQwen3-8Bが受け取れる入力表現へ変換し、質問の前に付け加えます。
この構造から、Memorillaは文書集合を一度だけ固定の要約に変えて使い回す方式とは異なります。質問ごとに参照の仕方が変わるため、同じ資料群でも問い合わせに応じたメモリを生成できます。学習対象は約1億9,400万パラメーターのメモリモジュールです。企業で扱う際には、文書の保存・更新と、質問時の情報選択、最終回答の生成を別々の処理として捉えると、性能を測る場所や障害の原因を整理しやすいでしょう。
精度は用途で分かれ、短い医療文献では優位に立たない
研究チームは、同じ凍結済みQwen3-8Bを使って比較手法を評価しています。報告された八つのベンチマークでは、Memorillaは五つで最高スコアを獲得し、平均スコアは49.68でした。ただし、これらは研究チームによる報告値です。また、正解率や文章の一致度など、評価指標が異なる課題を含むため、平均値を「企業業務の約半分に正しく答えられる」と読み替えることはできません。
特徴が表れているのは、個人に関する情報を扱うPersonaMem-v2です。Memorillaの正解率は44.60%で、全文入力の27.92%を上回りました。比較手法の中で次点だったxRAGは30.90%でした。履歴の中から質問に必要な情報を選び出す用途では、全文をそのまま渡すよりも、学習したメモリを介する方が良い結果につながる可能性を示しています。
| 評価対象 | 指標 | Memorilla | 比較対象 |
| --- | --- | --- | --- |
| FactKG | 正解率 | 84.33% | 全文入力80.43% |
| PersonaMem-v2 | 正解率 | 44.60% | 全文入力27.92% |
| PubMedQA | 正解率 | 59.00% | LLMLingua-2は69.00% |
| NarrativeQA | ROUGE-L | 19.31 | MemoRAGは20.51 |
弱点もあります。医学文献の質問応答を評価するPubMedQAでは59.00%にとどまり、入力圧縮手法のLLMLingua-2が記録した69.00%を下回りました。この評価で扱う抄録は合計324トークンと短く、圧縮による利点が出にくい条件です。PersonalizationV4とNarrativeQAでも、MemoRAGが上回っています。
業務への適用を考えるなら、長い履歴から必要な傾向を取り出す質問と、細かな条件や個別の事実を正確に答える質問を分けて評価する必要があります。全体平均で採用を決めるより、誤答がどの種類の質問に集中するかを確認する方が、運用上の判断につながるでしょう。
応答は速くなる一方、文書側の計算と保存は残る
回答モデルが読む情報を短くすると、どの程度速くなるのでしょうか。研究チームは、H100 GPU一基で512文書、約12万8,000トークンを扱う条件において、Memorillaの回答時間を0.74秒と報告しています。全文入力方式は、文書量の増加に伴って0.75秒から19.9秒へ延び、比較対象の条件ではMemorillaが約27倍速い結果でした。メモリモジュール自体の処理は約2ミリ秒です。
ここでは、回答までの時間と、メモリを読み出す部分の処理時間を区別する必要があります。約2ミリ秒という値だけを見て、利用者への回答がその時間で完了すると解釈してはいけません。回答文の生成などを含めた値として示されているのは0.74秒です。企業の性能評価でも、内部処理の速さと利用者が待つ時間をそれぞれ測ることが欠かせません。
大規模な文書集合向けには、クロスアテンションで使うキーとバリューを事前計算する任意のメモリキャッシュも用意されています。B200 GPU一基で測った質問時のメモリ処理は、100万文書で8.1ミリ秒、400万文書で33ミリ秒でした。PyTorchの最適化機能であるtorch.compileを使うと、100万文書の条件では5.0ミリ秒になったとしています。これらを、H100で測った回答全体の所要時間と直接比較することはできません。
キャッシュには保存コストも伴い、400万文書では80GiBを消費します。NarrativeQAでは6万7,385の文書トークンを16個のメモリトークンに置き換え、約4,212分の1に圧縮していますが、それだけでシステム全体の必要メモリ量や運用費用まで同じ割合で減るわけではありません。文書の事前処理、キャッシュ、回答生成を含む構成全体で費用を見積もる必要があります。
公開コードがあっても、導入にはGPUとモデルの組み合わせの確認が必要
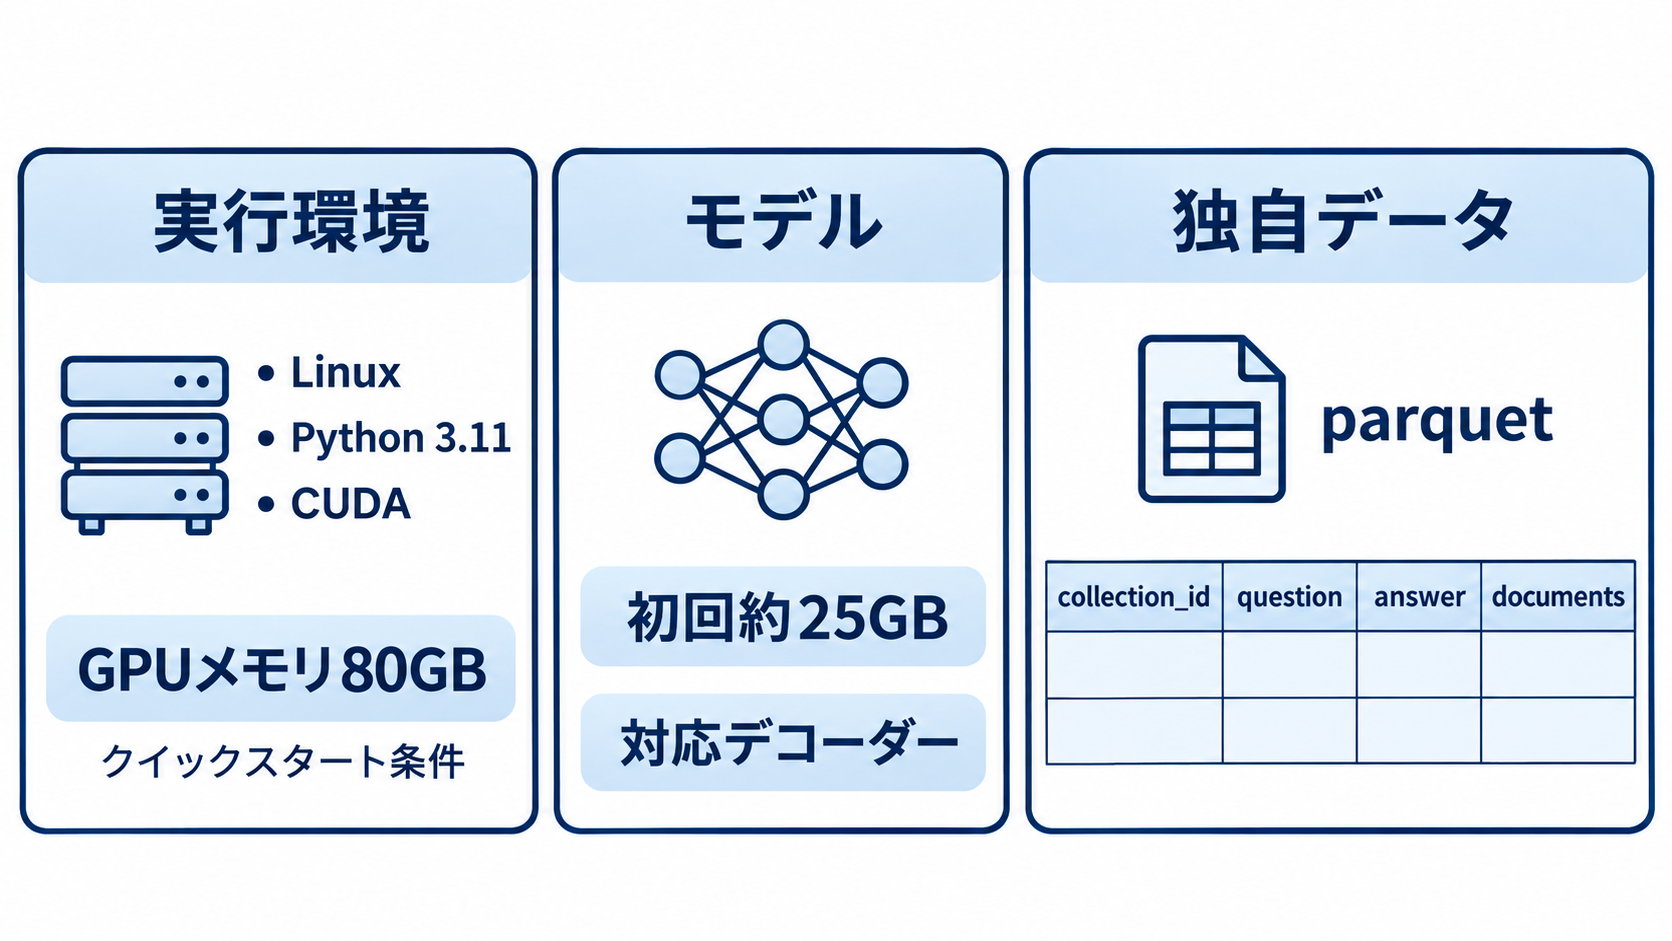
Memorillaのコード、学習手順、チェックポイントは、Apache 2.0ライセンスで公開されています。社内で挙動を検証したり、独自データで実験したりするための材料がそろっている点は、企業の技術評価に役立ちます。ただし、オープンソースであることと、小規模な環境ですぐに動くことは別の条件です。クイックスタートでは、80GBのGPUメモリを備えたGPU一基が必要とされています。
実行環境はLinux、CUDA対応GPU、Python 3.11です。Python環境管理ツールのuvで導入し、MemoryVLLM.from_pretrainedを使ってモデルを読み込みます。初回には約25GBのモデルがダウンロードされます。量子化版は公開情報で示されていないため、より小さなGPUで同等に動作することを前提に計画を立てるべきではありません。
チェックポイントはHugging Faceのmemorilla/Memorilla-Qwen3-8Bで提供され、Stage 1、Stage 2、Stage 3、PV4、PMv2のフォルダーに分かれています。各チェックポイントは、学習時に組み合わせたデコーダーで動かす必要があります。メモリの出力は特定の回答モデルの入力表現に合わせて学習されるため、既存の社内LLMへそのまま差し替えられるとは限りません。
学習は三段階で、約198万件のWikipedia言い換え再構成例から始まり、約134万件の質問応答・要約の例を追加し、最後に八つのベンチマークで微調整します。一連の学習手順はH100四基で約19時間と報告されています。独自データには、collection_id、question、answer、documentsの列を持つparquet形式のファイルが必要です。導入担当者は、公開済みモデルを動かす検証と、自社用に追加学習する検証の予算を分けて考えると、必要な準備を具体化しやすいでしょう。
日本企業の検証は、長い履歴と細かな事実を分けるところから
日本企業にとってMemorillaを試す価値がありそうなのは、会話履歴や文書が増えるほど、入力の長さが応答時間の制約になる業務です。たとえば、過去のやり取りを踏まえる社内支援や、複数資料を横断する問い合わせ対応が検証候補になります。これは技術の構造から考えられる用途であり、これらの業務で有効性が実証されたという意味ではありません。
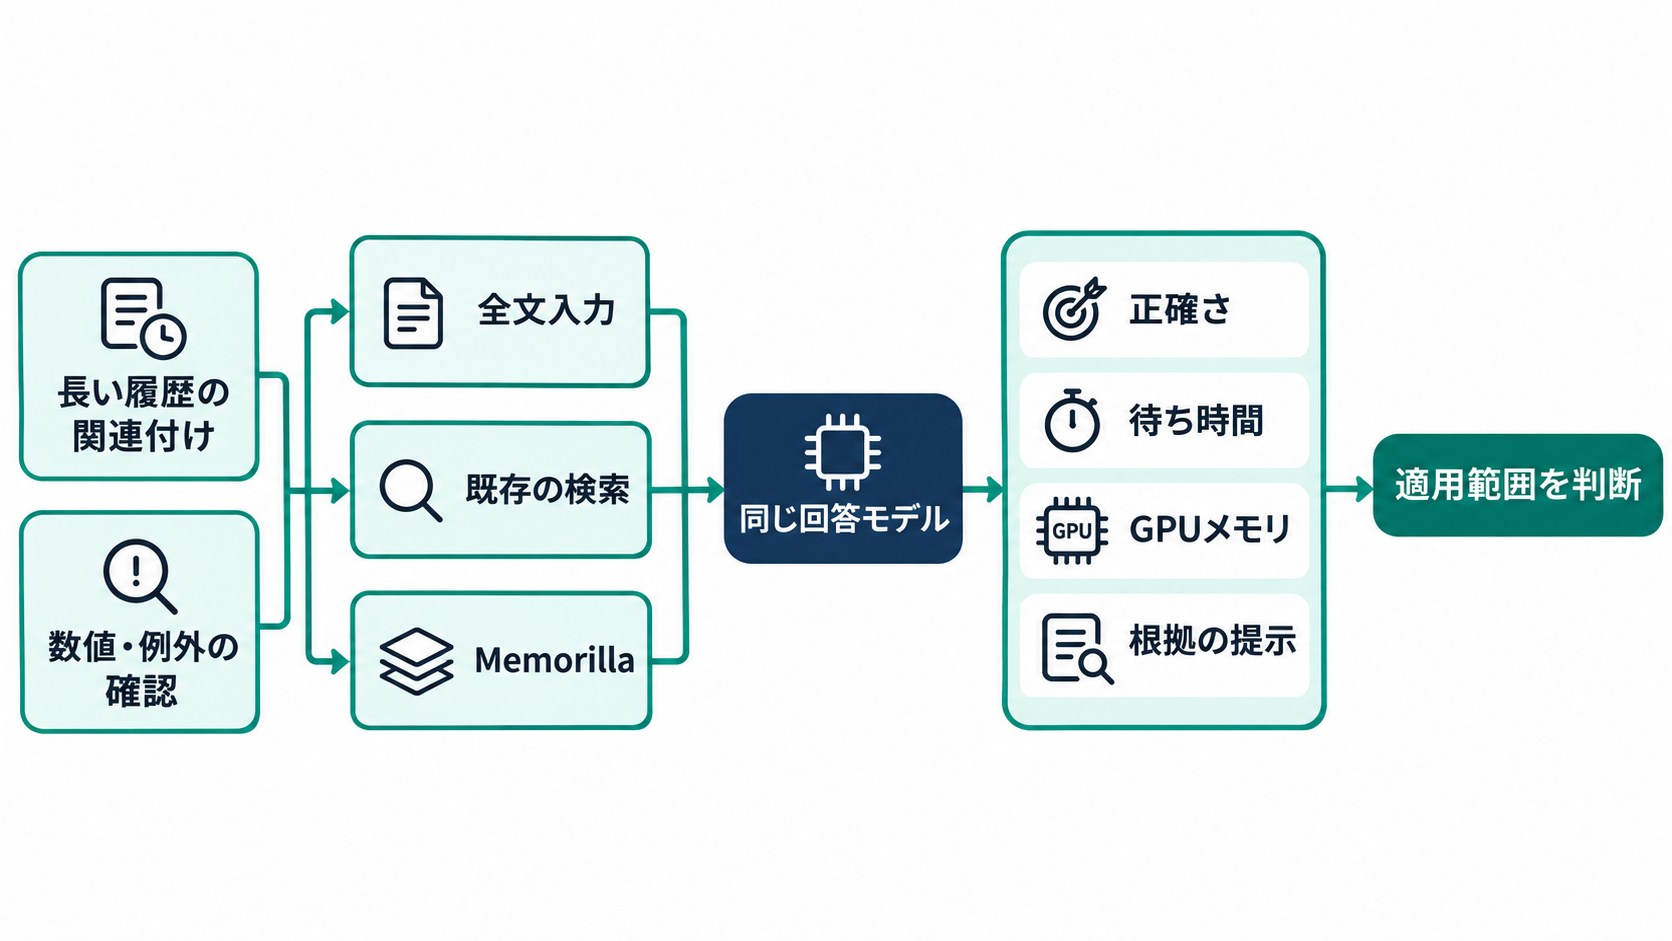
評価では、質問を二種類用意すると違いを捉えやすくなります。一つは、長い履歴に散らばる情報を関連付ける質問です。もう一つは、特定の数値、例外条件、文書中の細かな記述を正確に取り出す質問です。後者は、圧縮によって必要な情報が十分に保持されるかを確かめる役割があります。PubMedQAで比較手法を下回った結果を踏まえても、入力が短い課題や精密な事実確認まで、一律に圧縮へ寄せる判断は早計でしょう。
日本語での性能も確認が必要です。今回示されている評価結果だけでは、日本語の社内文書や独自の略語を含む問い合わせで、同じ精度が得られるかは判断できません。また、メモリトークンは人が読む文章ではないため、その表現を見て回答根拠を直接確認することは困難です。根拠文書の提示が必要な業務では、回答精度とは別に、参照箇所を利用者へ示す仕組みをどう設けるかが論点になります。
着手するなら、実際の問い合わせから小さな評価用セットを作り、同じ回答モデルで全文入力、既存の検索方式、Memorillaを比較する方法が考えられます。正答率に加え、回答までの時間、GPUメモリ使用量、文書を追加した際の処理負担を記録します。長い資料群で待ち時間を減らせても、業務上欠かせない条件を落とすなら採用範囲を絞る必要があります。自社で省略できない情報を先に定めることが、16個のメモリを使うべき場面を見極める第一歩です。