

2026/11/18
今更聞けないAI知識
AIの「モデル」はアプリのこと?画面の奥にある仕組みと役割の違い
この記事の要点
AIのモデルは、データから学んだパターンを使って予測や生成を担う仕組みで、アプリの構成要素になります。架空の文章作成アプリを例に、画面とモデルの役割、学習と回答生成の違い、モデル名だけでは検索機能や回答の正しさを判断できない理由を説明します。
目次
「どのAIを使っていますか」で名前が食い違う理由
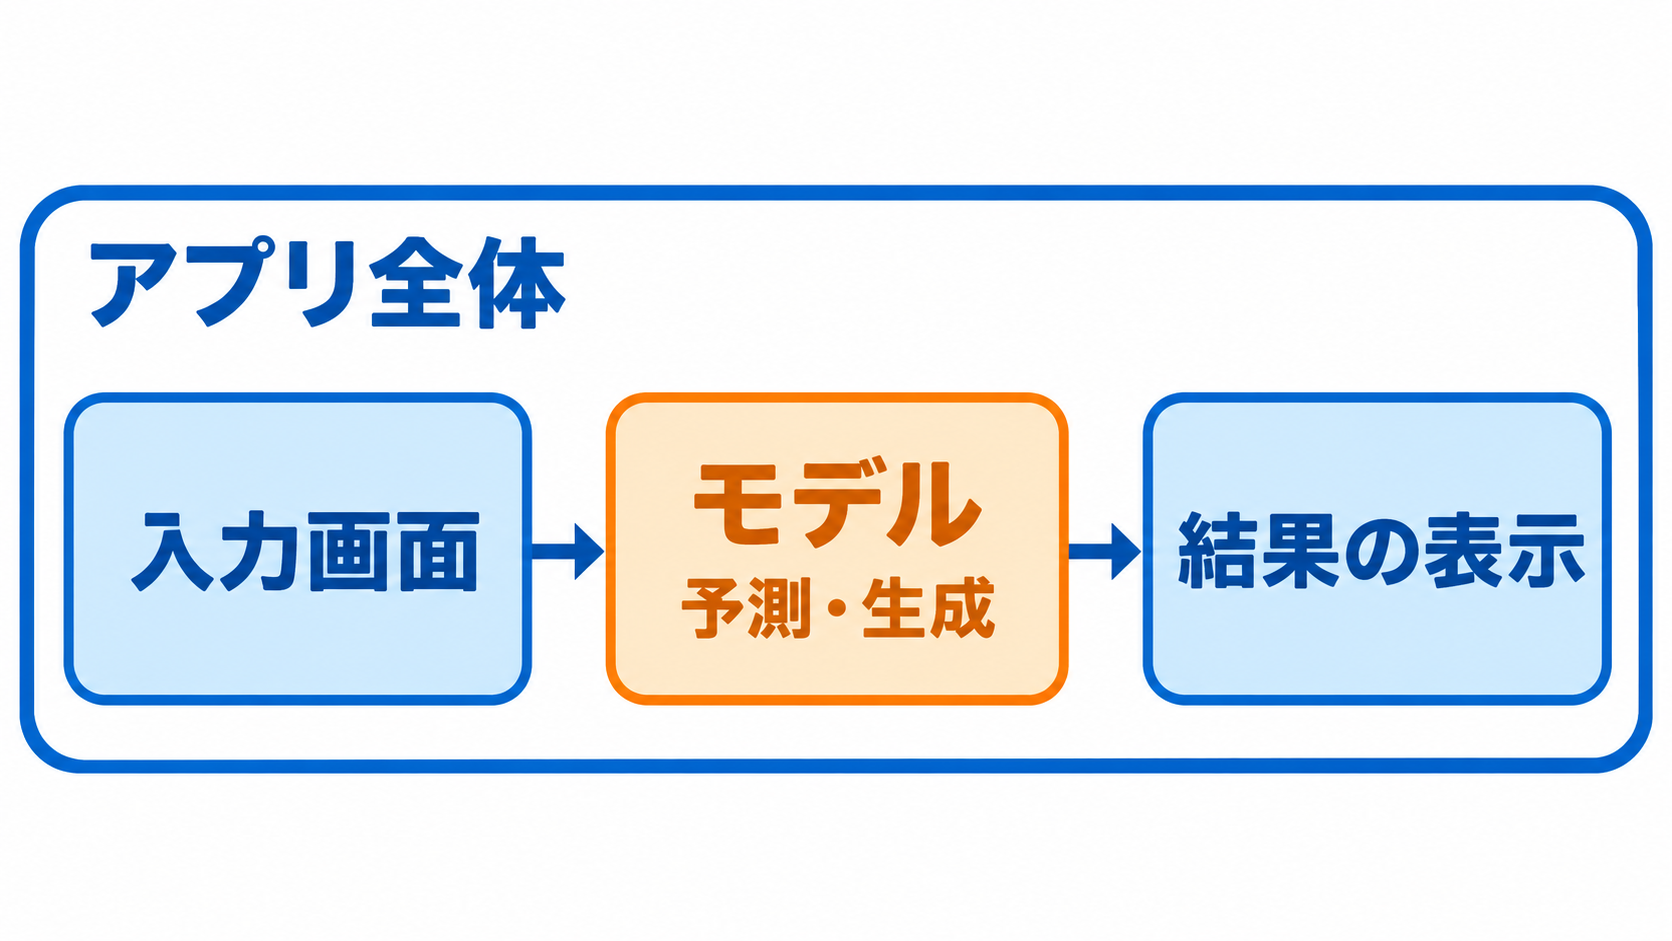
「どのAIを使っていますか」と聞かれて、いつも開くアプリの名前を答えたら、相手から別の名前が返ってきます。説明を読むと「このアプリは○○モデルを使用」と書かれています。同じものを指しているのか、別々に選ぶものなのか、戸惑う場面ではないでしょうか。この疑問を整理する鍵は、利用するアプリ全体と、その中で予測や生成を担うモデルを分けて見ることです。
一言で答えるなら、AIのモデルは「データから学んだパターンを使って予測や生成を行う仕組みで、アプリの構成要素になるもの」です。Google Cloudの解説では、機械学習のモデルは、学習用のデータに処理の手順を適用して得られるものと説明されています。機械学習とは、データからパターンを学ぶAIの手法です。(出典: Google Cloud)
ここでいう「モデル」は、商品の見本や外見の型という意味ではありません。利用者が文字を入力する画面そのものでもありません。文章を作るAIを例にすれば、入力を受けて文章の生成を担う仕組みと、それを使いやすく届けるアプリには、それぞれ役割があります。
この違いを知る目的は、専門用語を覚えることだけではありません。「モデルが文章を作れるなら、このアプリでインターネットも検索できるはず」といった、説明にない機能まで期待するのを避けるためです。反対に、画面が使いやすいという感想だけで、モデルの回答が正確かどうかを判断することもできません。
この記事では、架空の文章作成アプリを共通の例にして、この境目を見ていきます。アプリを開いたときに見えるものと、その奥で働く仕組みを区別できれば、製品紹介に並ぶ名前をすべて覚えなくても、確認すべき説明を探しやすくなるでしょう。
家電の本体と内部のエンジンで考える役割の違い
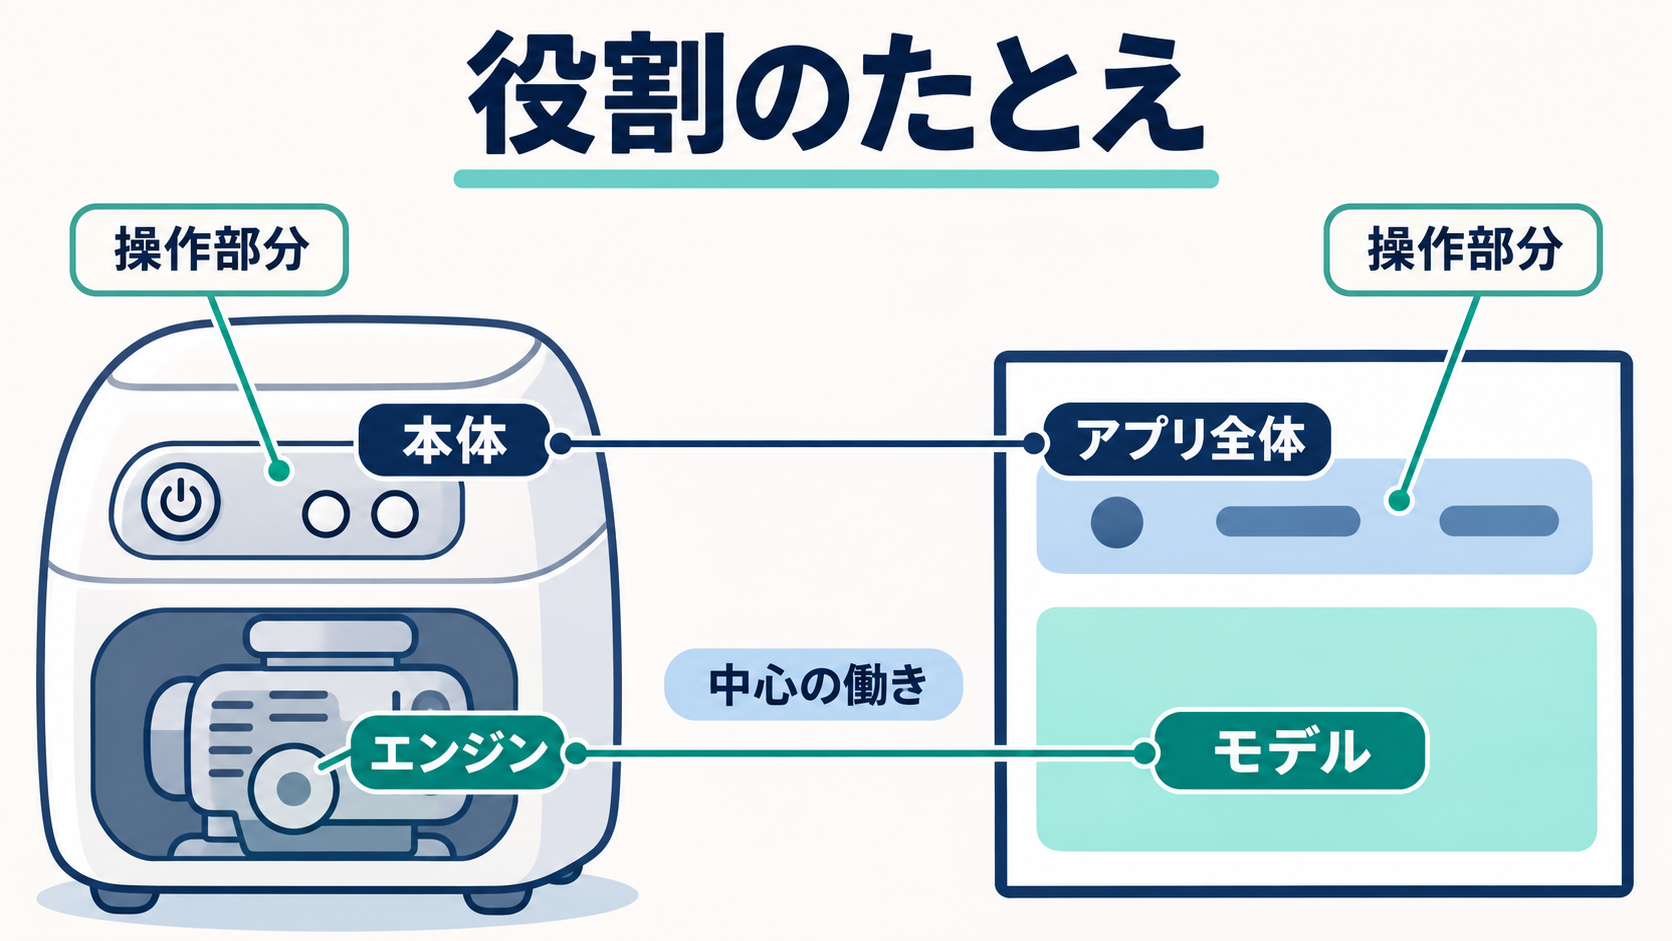
アプリとモデルの関係は、家電の本体と、その内部で中心的な働きをするエンジンにたとえると整理しやすくなります。利用する人は、操作するボタンや本体の形、仕上がりなどを含めて製品を選びます。内部のエンジンは製品の働きを支えますが、その名前だけで、ボタンの配置や付属機能まで分かるわけではありません。これは役割の違いを説明するためのたとえです。
AIを使うアプリでも、利用者に見える部分と、予測や生成を行うモデルを分けて考えられます。Google Cloudは、機械学習を、より広いAIシステムの学習などを支えるエンジンとして説明しています。また、Googleの用語集では、チャットボットは大規模言語モデルを利用するアプリケーションとされています。大規模言語モデルとは、大量のパラメータを持つ言語モデルで、文章の生成や質問への応答に使われるものです。(出典: Google Cloud、Google Developers)
ただし、このたとえを「エンジンさえ同じなら、どの製品も同じ」と受け取る必要はありません。架空の文章作成アプリを考えると、文章を入力する欄を広く取る設計も、目的を選ぶ欄を設ける設計も想像できます。ここで挙げた画面は説明用の仮定で、実在する製品の仕様ではありません。
利用する人にとっては、内部の仕組みだけでなく、必要な情報を渡しやすいか、出てきた文章を確認しやすいかも判断材料になります。モデルの説明を読んでいるのか、製品全体の説明を読んでいるのかを意識すると、こうした違いを混同せずに済むでしょう。
たとえの限界も押さえておきたいところです。モデルは、アプリの中に物理的な部品として入っているという意味ではありません。また、すべてのアプリで利用者がモデルを交換できる、という意味でもありません。「中心的な処理を担う仕組み」と「それを含めて利用者に届ける製品」の役割を分けるための見取り図として使うと、理解の助けになります。
架空の文章作成アプリで入力から回答までをたどる
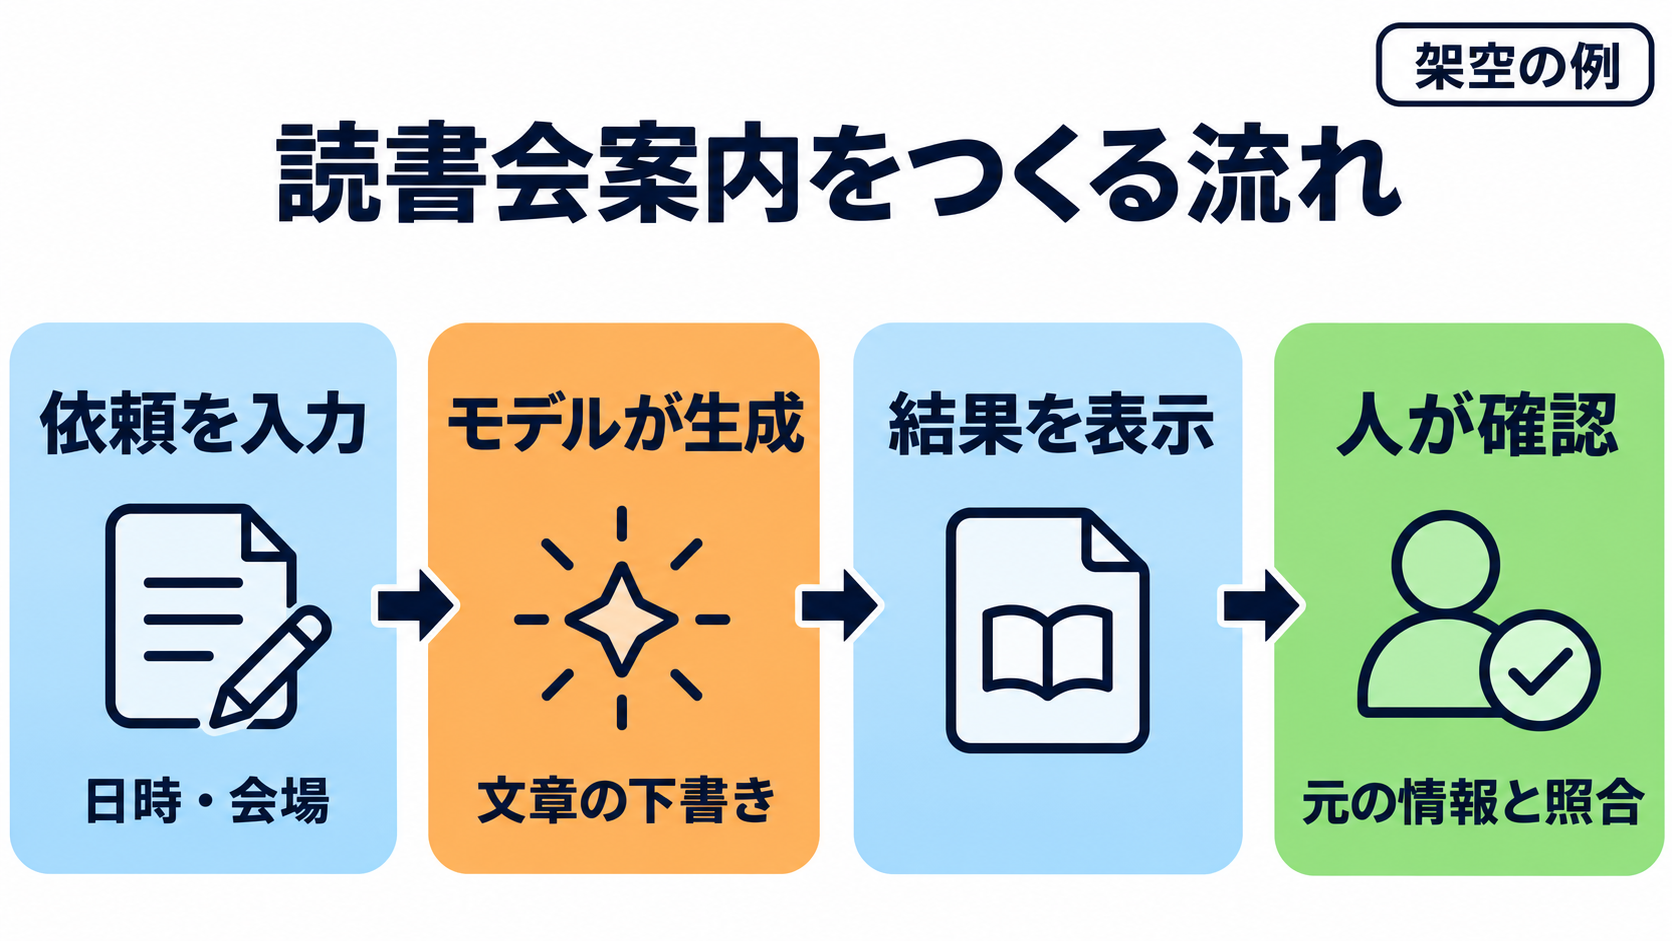
ここからは、架空の文章作成アプリ「お知らせ下書き」を例にします。地域の読書会について、参加者向けの案内文を作るアプリという設定です。画面には依頼を書く欄と、生成された文章を表示する場所があるものとします。実在するサービスの紹介や操作手順ではなく、アプリとモデルの担当を理解するための例です。
利用者は「読書会の案内文を作ってください。日時は来月の第2土曜日の午後、会場は地域センターです。初めての人にも親しみやすい文面にしてください」と入力します。このように、AIに渡す依頼や情報をプロンプトと呼びます。入力欄は、その依頼を利用者が書くためのアプリ側の窓口と考えると分かりやすいでしょう。
モデルが担うのは、渡された入力に応じて文章を生成する部分です。Googleの用語集では、大規模言語モデルにおける「推論」は、学習済みのモデルを使って入力プロンプトへの応答を生成する処理と説明されています。日常語の「推理する」と完全に同じ意味ではなく、ここでは回答を作る処理の名前として捉えれば十分です。(出典: Google Developers)
この架空のアプリでは、生成された文章を画面に表示するところまでを一連の利用体験として考えます。利用者から見ると一つのアプリの動きですが、説明する際には「依頼を受け付ける」「文章を生成する」「結果を見せる」という役割に分けられます。モデルという言葉が指す範囲は、この体験全体より狭いことが分かるのではないでしょうか。
なお、例の依頼には、開催する月や正確な日付が十分に書かれていません。文章が自然に整っても、実際の案内として必要な情報がそろったとは限らないでしょう。利用上の提案としては、日時や会場名など、確定している情報を具体的に渡し、出力後にも照合する方法が考えられます。画面が文章を表示できることと、案内の内容が正しいことは、別々に確認したい点です。
モデルを作る「学習」と回答を作る処理は別の段階
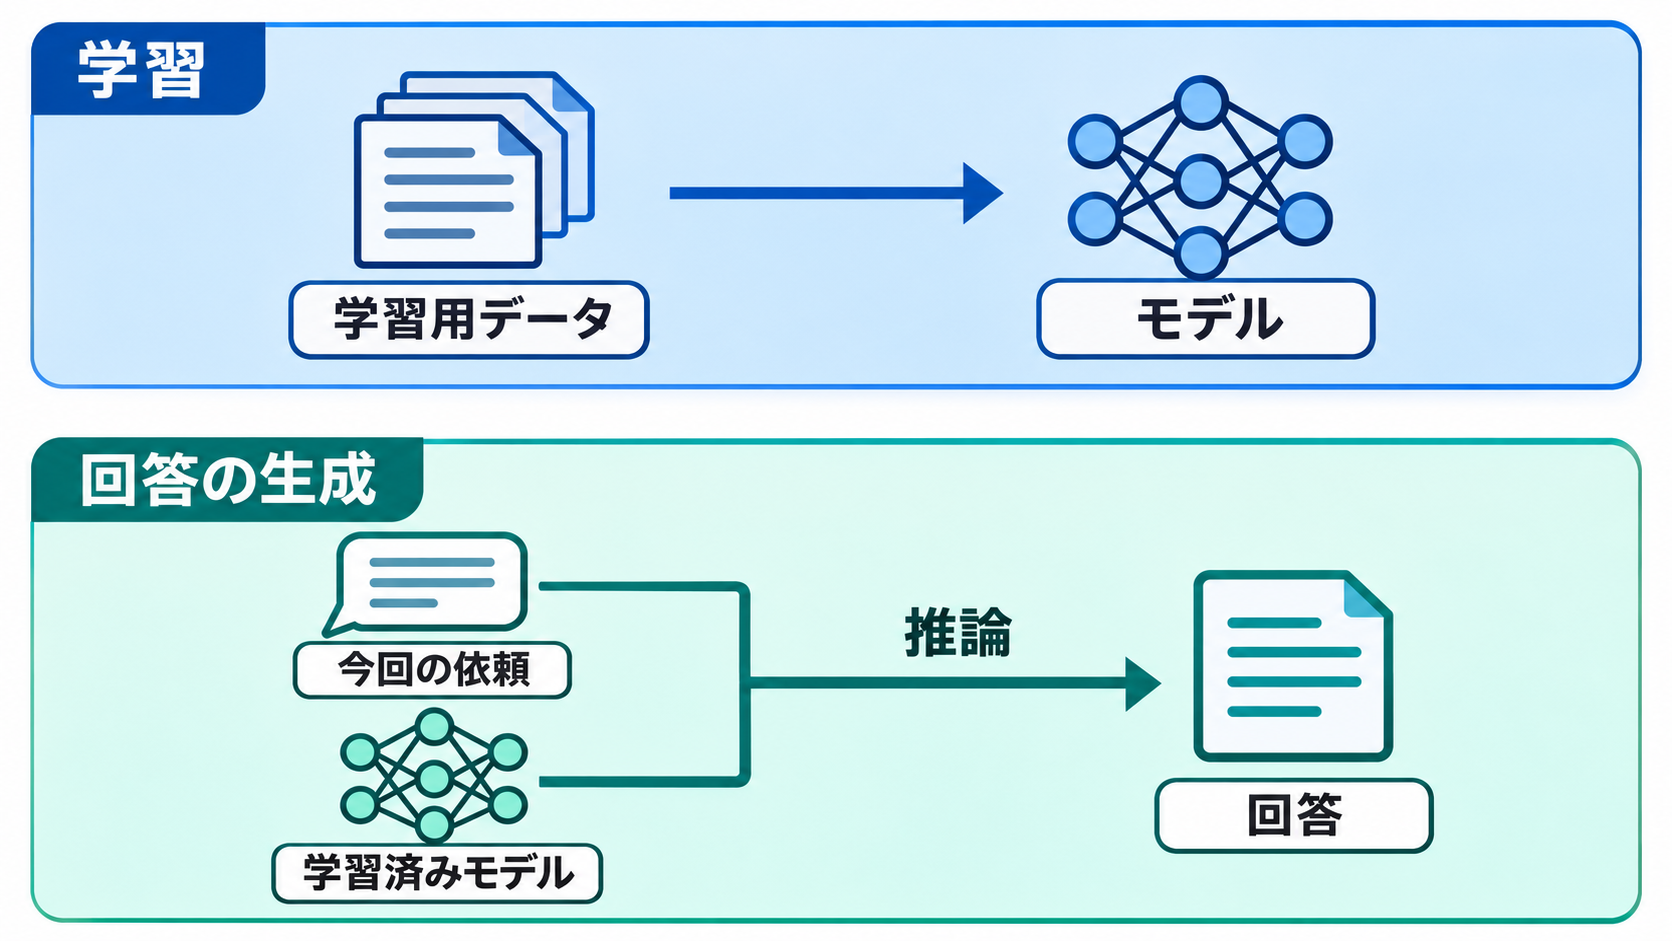
「データから学ぶ仕組み」と聞くと、入力するたびに、その場でモデルが作り替えられているように感じるかもしれません。しかし、モデルを作るための学習と、学習済みのモデルで回答を生成する処理は、区別して説明されます。Google Cloudは、学習用データからモデルが得られると説明し、Googleの用語集は、その学習済みモデルを入力に適用する処理を推論としています。(出典: Google Cloud、Google Developers)
学習は、データに含まれるパターンをモデルに反映させる段階です。文章生成の場面では、その学習を経たモデルを使い、今回の依頼に応じた文章を作ります。初心者のうちは、細かな計算方法よりも「モデルが形作られる段階」と「そのモデルを使う段階」の二つがある、と押さえるところから始めてよいでしょう。
架空の読書会の例に戻ります。「親しみやすい文面」を「少し改まった文面」に変更して、もう一度依頼するとします。このとき、利用者が渡す条件は変わります。ただし、文章が変わったという観察だけで、「モデルそのものが再学習された」と判断することはできません。今回の入力に別の条件を含めたことと、モデルを更新する学習は、同じ説明ではないためです。
Googleの用語集では、チャットの過去のやり取りは、その後の会話の文脈になると説明されています。つまり、会話中に前の依頼を踏まえた回答が出ることも、モデルの学習とは分けて捉えられます。(出典: Google Developers)たとえば「先ほどの案内を短くしてください」という依頼は、前の文章を今回の作業につなげる例と考えられるでしょう。
ここから、入力した情報の保存方法や、サービス側が学習に利用する条件まで推測することはできません。それらを知りたい場合は、使っているサービスの説明を別に確認する必要があります。「会話を踏まえて回答した」「モデルが学習した」「情報が保存された」を一つの出来事として扱わず、何を確かめたいのかを分けることが、説明を読み違えないための手掛かりになります。
モデル名だけで検索機能や正しさを判断しない
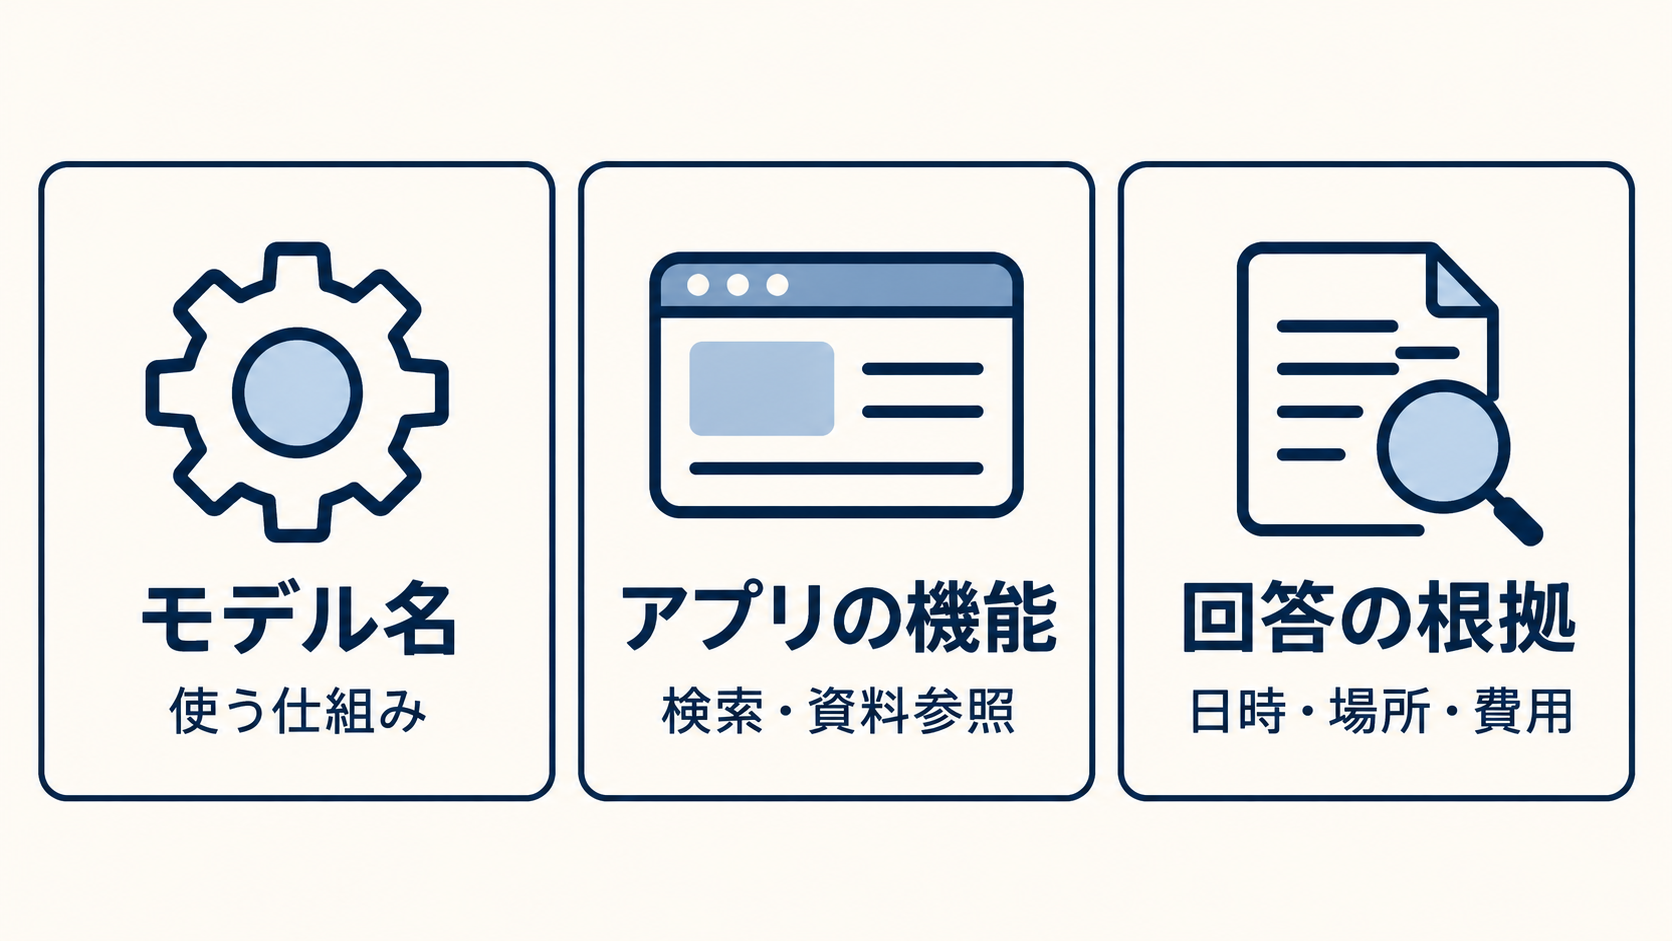
モデルの名前が分かると、アプリ全体の能力まで分かったように感じるかもしれません。けれども、「どのモデルを使っているか」と「どの情報を参照できるか」は、分けて確かめたい項目です。IBMの解説では、生成AIアプリの出力を改善する方法として、学習データの外にある関連資料を利用する仕組みも紹介されています。モデルの学習内容に加えて外部の資料を使う、という区別があることを押さえられます。(出典: IBM)
したがって、モデル名が書かれているだけでは、そのアプリでインターネット検索ができるのか、手元の資料を参照できるのかまでは確定しません。検索や資料参照を必要とするなら、利用する製品の機能説明で確認するのが筋道でしょう。「文章を生成できる」という説明から、情報を調べる機能まで補って読まないことが大切です。
回答の正しさにも、別の確認が必要です。Googleの用語集では、生成AIモデルが現実について述べているように見えながら、実際には誤った内容を出力することを、ハルシネーションと説明しています。日本語では「幻覚」と訳されることもありますが、人の体験をそのまま表す言葉として捉える必要はありません。ここでは、事実に見える誤った出力という意味です。(出典: Google Developers)
架空の読書会の案内なら、文章が丁寧でも、指定していない参加費や申込期限が書かれていれば確認対象になります。これは起き得る問題を考えるための仮定で、特定のモデルを試した結果ではありません。「文章として読みやすいか」と「事実として根拠があるか」を分けると、どこを見直せばよいかが具体的になります。
モデルを選ぶことは、回答の確認を終えることではありません。案内文のような身近な用途でも、日時、場所、費用、連絡先を元の情報と見比べる方法が考えられます。モデルの名前への印象より、今回の文章が必要な条件を満たしているかを確かめる姿勢が、実際の判断につながるでしょう。
製品紹介を読むときは「何の説明か」を確かめる
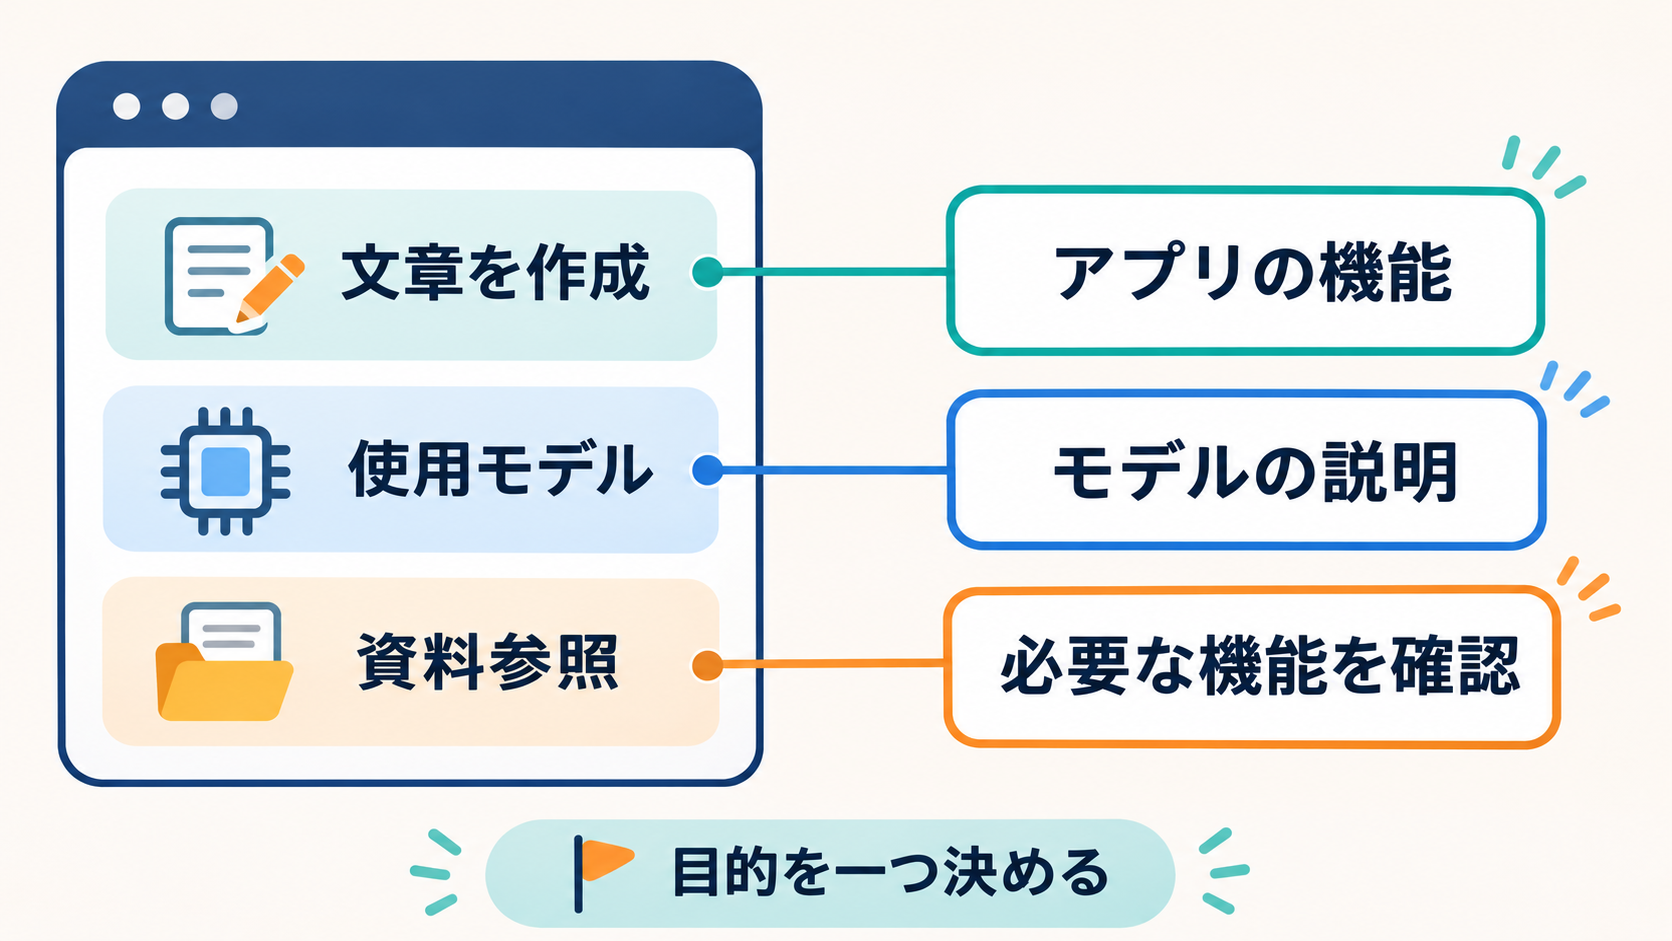
明日から試せる一歩は、いつも使うアプリの紹介ページを開き、「アプリ全体の説明」と「モデルの説明」を読み分けてみることです。製品名とモデル名を暗記する必要はありません。気になる一文について、利用できる機能を述べているのか、内部で使うモデルを述べているのかを考えるだけでも、調べる対象がはっきりするでしょう。
Googleの用語集は、Geminiという名称について、モデル、対話用のインターフェース、関連する製品などを含むエコシステムとして説明しています。インターフェースとは、利用者が入力や操作をするための接点です。この例からも、同じ名称を見かけたときに、文章のどの部分を指しているかを読む必要があることが分かります。(出典: Google Developers)
確認項目を絞るなら、次の三つが使えます。いずれも、製品を比較するときの見方としての提案です。
- 今読んでいる名前は、アプリ全体とモデルのどちらを指していますか。
- 自分に必要な検索や資料参照などの機能は、製品の説明に明記されていますか。
- 出力された内容のうち、自分で元の情報と照合する箇所はどこですか。
たとえば、読書会の案内を整えることが目的なら、文章を依頼する方法と、生成結果を確認する方法を知ることが出発点になります。会場の最新の利用条件を調べることが目的なら、文章を作れるかだけでは判断材料が足りません。必要な情報をどのように参照できるのかまで、説明を探すことになるでしょう。目的を一つ決めると、長い製品紹介の中でも読むべき箇所を絞れます。
本稿は、2026年11月18日に取得された公式資料に基づく基礎の整理です。IBMの記事は2024年8月9日公開、2026年10月2日更新と記載されており、資料の取得日を新機能の発表日として扱ってはいません。アプリとモデルの違いを確かめる際も、名前に加えて、説明の対象と時点を見る習慣が役立ちます。手元の製品紹介から一文を選び、「これは何の役割を説明しているのか」と読み直すところから始めてみてください。