

2026/11/22
AIニュース
GPUのテストで見逃した競合を検出、TensorLeanが示すAI計算基盤の検証手法
この記事の要点
コロンビア大学とCertiKのTensorLeanは、GPUカーネルの動作を数学的仕様と照合する形式検証基盤です。149構成のうち83構成の正しさを証明し、38件の不具合を発見しました。多数のテストで現れなかった競合も検出しており、企業には性能と併せて検証範囲や前提条件を確認する視点が求められます。
目次
1万7,760回のテストで現れなかった不具合
GPU上の計算が繰り返し正しい結果を返しても、実行のタイミングが変われば不具合が表面化することがあります。コロンビア大学と、セキュリティー企業CertiKの研究チームが紹介した「TensorLean」は、この問題に形式検証で取り組むフレームワークです。注目したいのは、FlashAttention-4で、1万7,760回のテストでは現れなかったデータ競合を見つけた点です。テストの回数を増やすだけでは確認しきれない、並列処理の実行順序に踏み込んでいます。
FlashAttentionは、生成AIにも使われる注意機構の計算を効率化する実装です。その内部では、GPUで動く計算プログラムである「カーネル」が、データの読み書きと演算を細かく制御します。高速化のために複数の処理を重ね合わせるほど、どの処理が先に完了するか、別の処理がいつデータを参照するかという関係が複雑になります。データ競合とは、こうした並列処理の間で、必要な順序や同期が保たれないまま同じメモリー領域にアクセスしてしまう問題です。
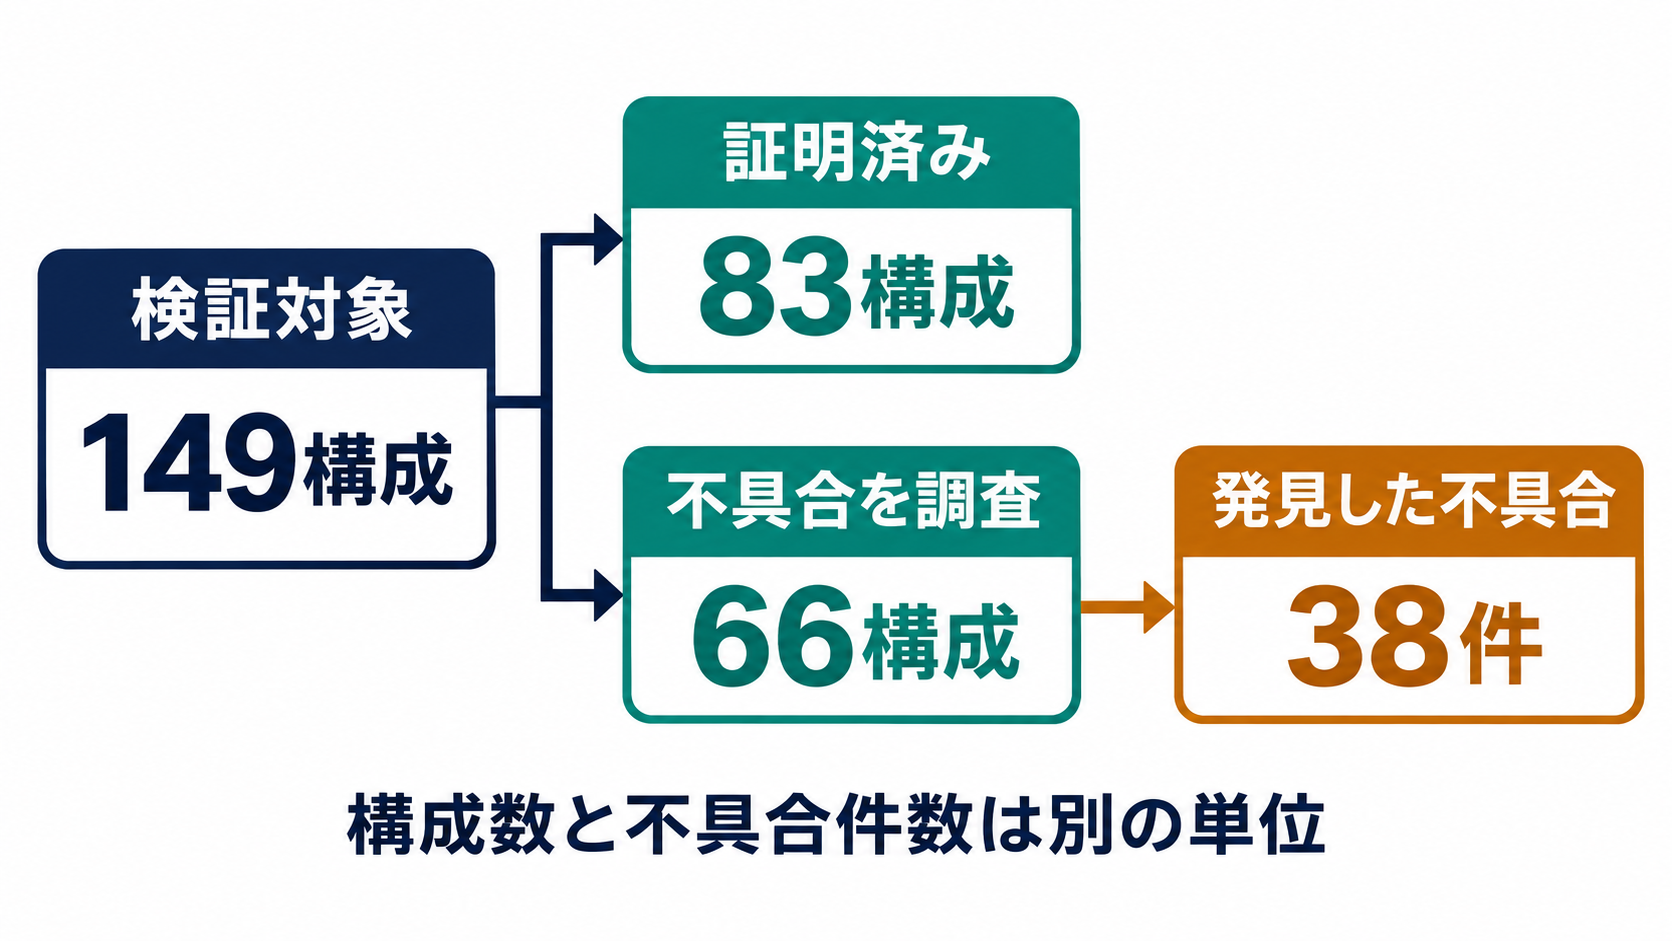
研究チームは149のカーネル構成を調べ、83構成の正しさを証明し、残る66構成の調査から38件の不具合を発見したと報告しています。ここで中心となる論点は、証明できた割合の高さだけではありません。実際に動かして結果を確かめる方法に加え、実行順序や計算条件を数学的に扱うことで、別の角度から品質を確かめられる点です。AI基盤を運用する企業にとっては、処理速度と同時に、計算結果を信頼できる根拠にも目を向ける材料になります。
計算式とコンパイル後の処理を照合する仕組み
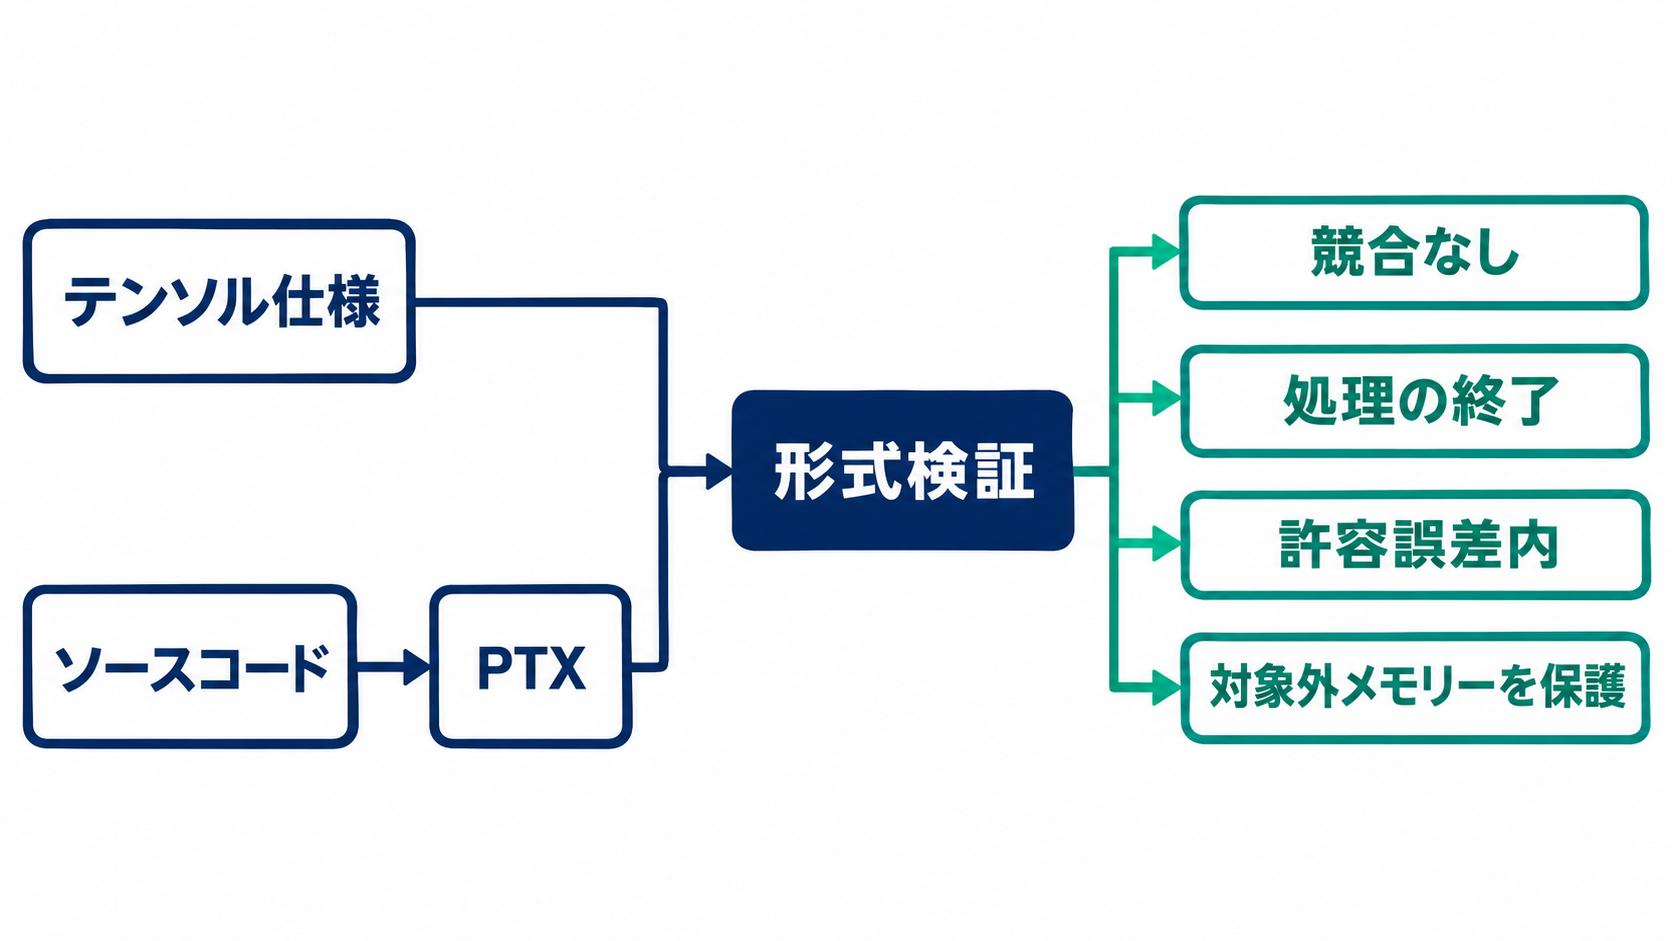
TensorLeanが確認するのは、開発者の意図を記したテンソル単位の数学的仕様と、コンパイル後のGPUカーネルの動作が一致するかどうかです。テンソルは、多次元の数値配列を扱うための表現です。検証対象となるPTXは、NVIDIAのGPU向けコンパイル過程で使われる中間表現に当たります。人が読みやすい計算式と、メモリーへの読み書きを含む低水準の処理を結び付けることが、この仕組みの土台です。
仕様の記述には、定理証明支援系のLeanを使います。Leanは、数学的な主張と、その主張が成り立つ根拠を機械で確認するための仕組みです。TensorLeanは数学ライブラリーのMathlibを土台とし、テンソル演算には機械学習ライブラリーPyTorchに沿った名前を採用しています。仕様はspec_math、spec_mut、spec_layout、spec_tol、requiresの五つの部分で構成され、計算内容とメモリー配置を分けて扱います。これにより、同じ計算を実現するための配置上の工夫を、計算の定義そのものから切り離して考えられます。
検証する性質は、データ競合がないこと、処理が終了すること、許容誤差の範囲で正しい出力が得られること、変更対象外のメモリーが保たれることの四つです。出力値だけが合っていても、別の領域を壊していれば安全な実装とは判断できません。また、処理が終わらない可能性も、出力値の比較だけでは捉えにくい問題です。ただし、形式検証の結論は記述した仕様や前提条件に依存します。証明済みという表示を見る際には、何を正しいと定義し、どの条件で確かめたのかを併せて確認する必要があるでしょう。
並列処理の実行順序と数値誤差を分けて検証
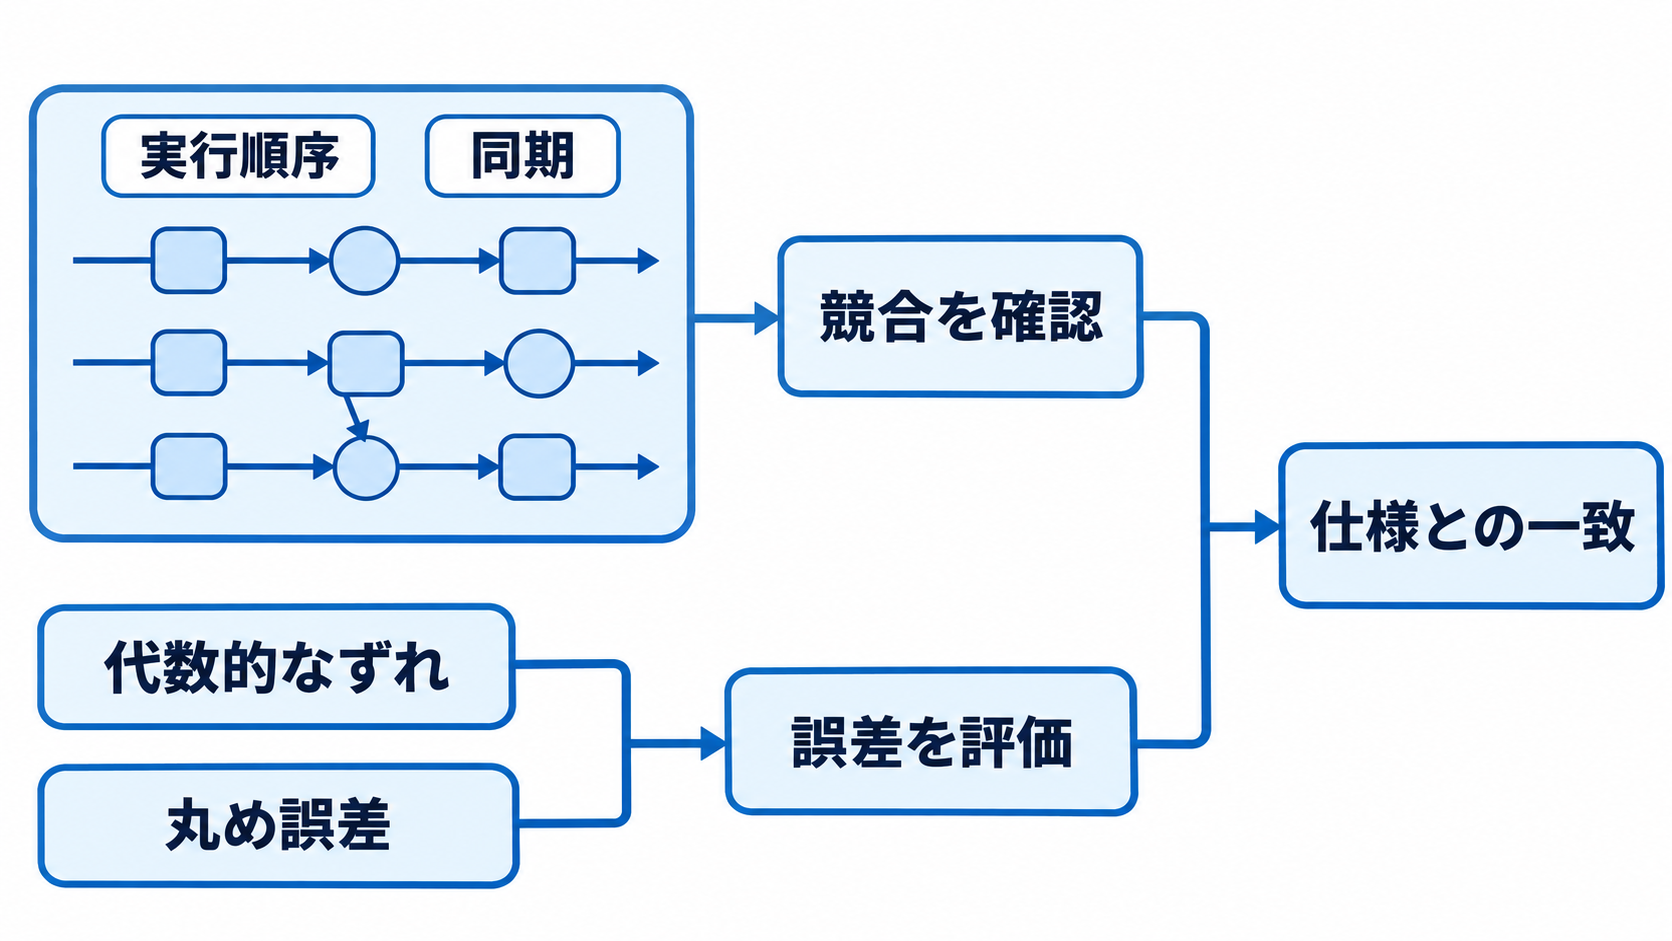
GPUカーネルの検証が難しい理由の一つは、大量のスレッドが並列に動くことです。実行順序を一つずつ試そうとすると、考慮すべき組み合わせが膨らみます。TensorLeanは、処理間の先行関係を表す「happens-beforeグラフ」を構築し、競合の有無や終了性を調べます。個別の実行結果を集めるだけでなく、どの処理がどの処理より先に起きる必要があるかを、検証の対象に据える方法です。
処理の流れは、既存のソースコードを出発点に、テンソル仕様を用意し、PTXへコンパイルするところから始まります。PTXの命令の意味を表すモデルを読み込み、先行関係を確認した後、記号実行によって最終的なメモリーの状態を求めます。記号実行は、具体的な入力値だけを使う代わりに、変数や条件を式として追う手法です。仕様側もPTXのメモリー表現に対応させ、Leanの検証カーネルと、論理式を解くZ3、cvc5を用いて証明を進めます。
規模に対応する工夫として、スレッドのまとまりやループの反復を記号的に扱い、蓄積型のループ計算を数式でまとめています。数値の正しさでは、代数的な計算のずれと、浮動小数点演算による丸め誤差を分離します。前者がゼロであることを示し、後者の上限を別に評価して組み合わせる設計です。実数の計算として式が一致しても、有限の精度で計算するGPU上では結果が完全一致しない場合があります。その違いを整理して扱うことで、高速化した実装がどこまで誤差を許容できるかを確認しやすくなります。
38件の不具合を読む際に押さえたい数え方
報告された38件の不具合は、六つのプロジェクトにまたがります。FlashAttentionが23件、Liger Kernelが7件、TileOPsが3件、TileLangとDeepGEMMがそれぞれ2件、Tritonが1件です。研究チームによると、すべて開発側へ報告されています。ただし、報告済みであることと、利用中のバージョンで修正が反映されていることは別の確認事項です。ここで挙がった件数だけから、現在の導入環境への影響までは判断できません。
不具合の種類には、メモリーアクセスの誤り19件、数値計算の問題13件、データ競合7件、未初期化メモリーの読み取り5件、未定義動作5件が含まれます。アルゴリズムの誤りは3件、コンパイルの誤りは2件、デッドロックは1件でした。これらは相互に排他的な分類ではなく、一つの不具合が複数の分類に入るため、足し合わせても38件にはなりません。デッドロックは、処理同士が相手の進行を待ち続け、先へ進めなくなる状態を指します。
同じ注意が、149構成という検証対象数にも必要です。83構成の証明と38件の不具合は、異なる単位の数字です。残る66構成を、そのまま66件の独立した不具合と読み替えることはできません。FlashAttentionについては102構成のうち56構成が四つの性質すべてを満たし、残る46構成はそれぞれソースコードの不具合によって証明目標を満たせなかったとされています。企業が評価に使うなら、全体の件数に加えて、自社が使う計算条件や実装に関係する問題が含まれるかを調べる必要があります。
検証対象の広さと導入負担の両方を見る
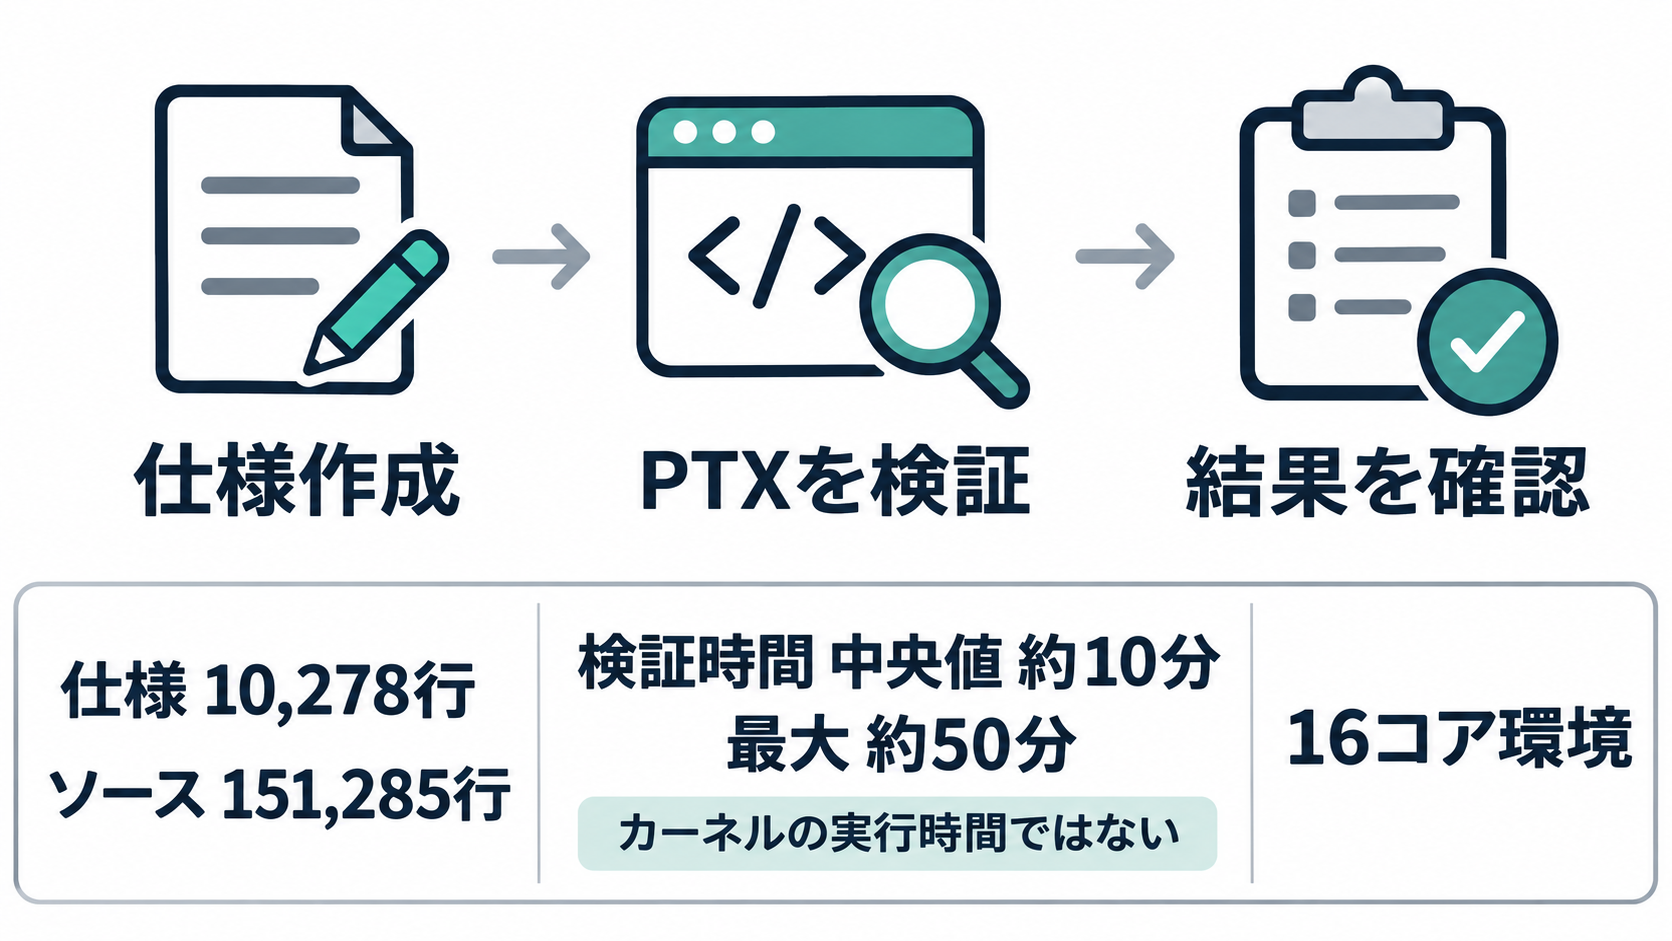
TensorLeanの評価対象には、FlashAttention-2、FlashAttention-3、FlashAttention-4の各カーネルとDeepGEMMなどが含まれます。A100、H100、B200向けにコンパイルされたPTXを、16コアのワークステーションで検証したとされています。確認にかかった時間は中央値で約10分、最大で約50分です。これは、実際のカーネルがGPU上で計算を終える時間ではなく、正しさを検証するための時間です。性能測定の数字と混同しないことが大切です。
仕様は合計1万278行で、対象のカーネルソースコードは15万1,285行でした。行数では約15対1の関係ですが、これをそのまま開発工数が15分の1になるという意味にはできません。数学的な仕様を作る作業、前提条件を整理する作業、証明が進まない理由を調べる作業が必要になるためです。開発者はtensorlean_assertという表明をソースコードに追加して証明の手掛かりを与えることもできます。この表明自体も一度証明したうえで再利用する設計になっています。
他の検証手法との比較で研究チームが強調するのは、設定の扱いです。具体的な一つの設定についてループを展開する同値性検証に対し、TensorLeanは記号的なパラメーターを利用します。実装が扱う条件を広く表現できれば、条件ごとに確認を積み重ねる負担を減らせる可能性があります。ただし、検証時間や対象カーネルの難しさが異なるため、異なるツールの所要時間だけで優劣を決めるのは適切ではありません。自社に必要な性質、対象命令への対応、仕様を保守する負担を含めた評価が求められます。
日本企業は重要なカーネルから確認範囲を定める
日本企業にとっての示唆は、生成AI基盤の品質を、回答内容の評価だけに限定しないことです。モデルが使う計算処理にも、メモリーアクセス、同期、数値誤差という別の確認層があります。特に、独自の高速化を加える企業や、GPU向けライブラリーの更新を自ら判断する企業では、性能向上の効果と併せて、計算の前提が維持されるかを考える必要があるでしょう。TensorLeanの成果は、その確認に形式検証という選択肢を加えるものと捉えられます。
導入を検討する際は、すべての処理を一度に証明する計画より、結果への影響が大きいカーネルを一つ選ぶ方が、評価項目を具体化しやすくなります。そのカーネルが実現すべき計算式、入力の条件、書き換えてよいメモリー領域、許容できる誤差を整理します。これはTensorLean固有の導入手順として示されたものではなく、今回の仕組みを企業の評価に結び付けるための考え方です。仕様を明文化すると、テストで何を確認すべきかも見直しやすくなると考えられます。
既存のテストには、実際の環境で処理を動かし、性能や周辺システムとの接続を確かめる役割があります。形式検証にも、仕様や実行モデルの範囲内で性質を示すという役割があります。両者が答える問いを整理すれば、証明済みという理由だけで運用上の確認を省く判断も避けやすくなるでしょう。自社でFlashAttentionなどを利用しているなら、最初の一歩は、利用バージョンと実行条件を把握し、報告された不具合と修正状況を照合することです。そのうえで、変更頻度や障害時の影響に応じて、形式検証を試す対象を絞り込めます。