
2026/11/06
AIニュース
Inkling 2 Small登場、総5940億パラメータのMoEを業務で選ぶ判断軸
この記事の要点
Thinking Machines Labが、総5940億・有効170億パラメータのMoEモデル「Inkling 2 Small」を公開しました。画像入力と100万トークンのコンテキストに対応し、コード修正や企業向け業務の評価で強みを示しています。ただし、ターミナル操作の評価には課題があり、トークン単価だけで費用対効果は判断できません。Tinkerでの利用条件、重みの公開計画、業務別の検証ポイントを整理します。
目次
コーディングの高得点だけでは見えない業務適性
コード修正を任せるAIと、ターミナルを操作して作業を完遂するAIは、同じ基準では選べません。Thinking Machines Labが公開した「Inkling 2 Small」は、その違いを意識させるモデルです。開発元の評価表では、ソフトウェア開発に関するSWE-Bench Pro v2のHard区分で86.3%を記録した一方、Terminal-Bench 4.0は13.1%にとどまっています。企業が導入を判断する際は、コーディング全般への期待より、任せたい作業と評価対象の対応を確かめる必要があります。
Inkling 2 Smallは、Inklingシリーズの第2世代として最初に登場したモデルです。テキストと画像を入力し、テキストで回答します。音声入力には現時点で対応していません。推論にかける労力を調整でき、最大100万トークンのコンテキストに対応するため、大量の資料やコードを扱う用途が想定されています。
独立系のAI評価サービスであるArtificial AnalysisのIntelligence Indexでは、前世代のInkling Smallが13だったのに対し、今回は31を獲得しました。同じ価格帯の29モデル中では4位とされています。ただし、総合指標の上昇が、あらゆる業務で同じ幅の改善を意味するわけではありません。
企業にとっての論点は、モデルの規模そのものより、得意な仕事をどの費用と時間で処理できるかです。Inkling 2 Smallは画像理解、コード関連作業、知識業務で検討に値する成績を示していますが、自律的な操作まで一括して任せる場合には、個別の検証が欠かせないでしょう。
「Small」でも総5940億、必要な専門家だけを動かす仕組み
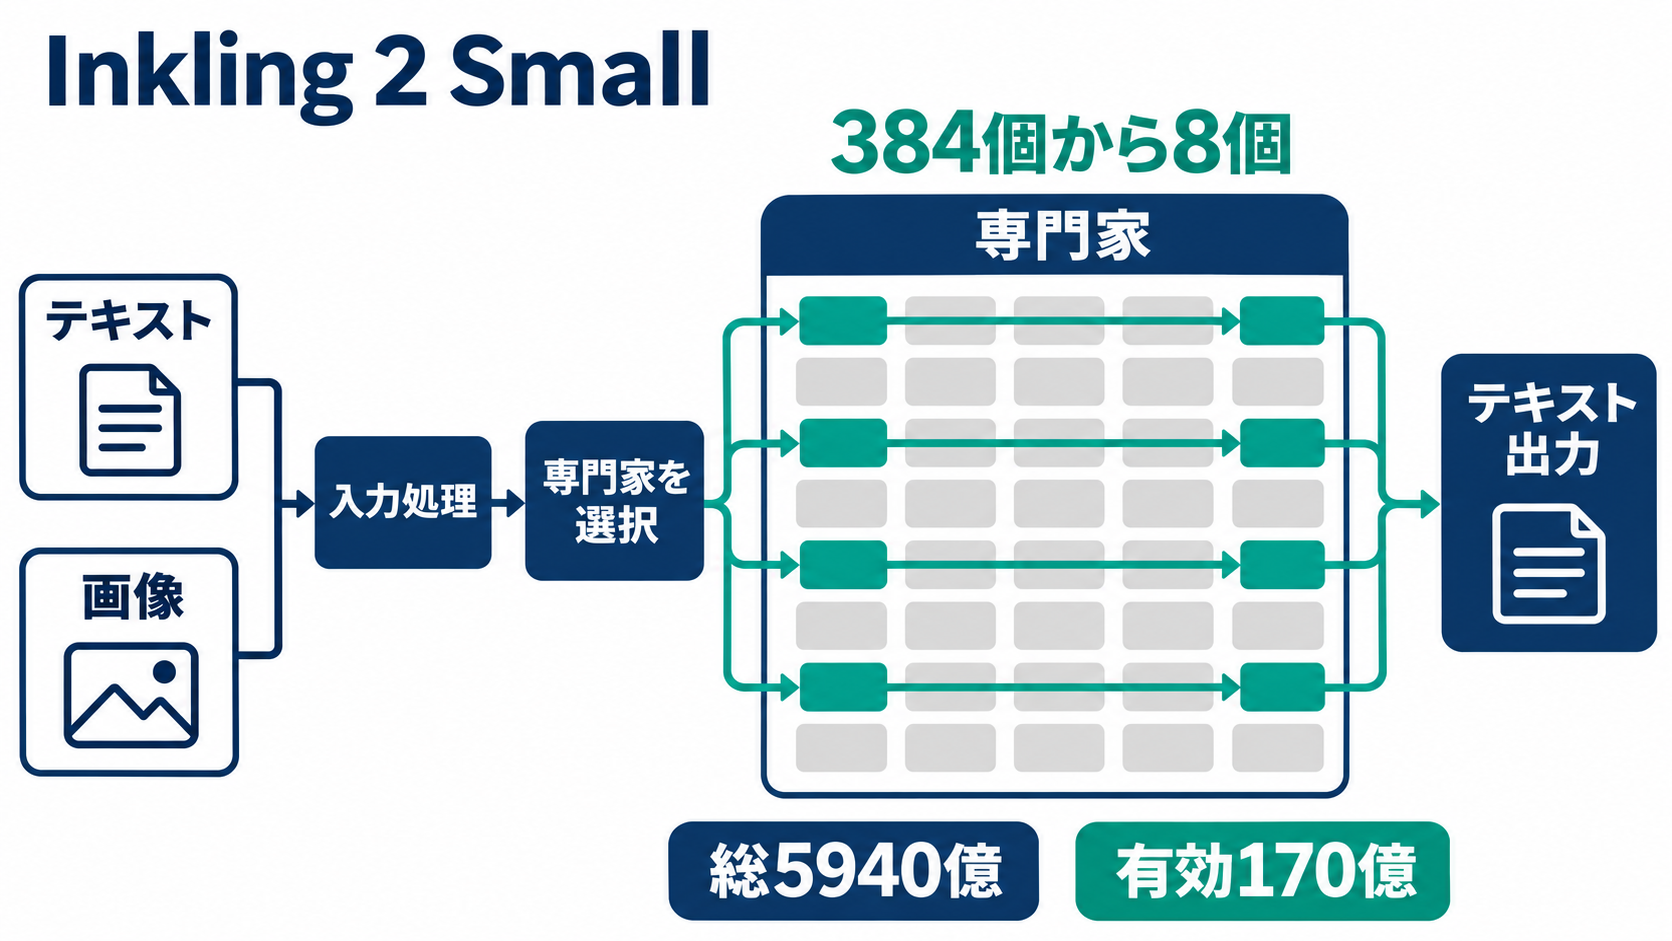
Inkling 2 Smallの総パラメータ数は5940億です。ただし、入力を処理する際にすべてを同時に使う構造ではなく、有効化されるのは170億パラメータとされています。「Small」という名称から、一般的な端末で手軽に動かせるモデルを想像すると、実際の仕様との間にずれが生じます。自己ホストに必要なハードウェア構成は公表されていません。
この構造は、疎なMixture-of-Experts、略してMoEと呼ばれます。複数の専門処理部分を持ち、入力に応じて一部を選んで計算する方式です。Inkling 2 Smallでは、各トークンを384個のエキスパートのうち8個へ振り分けます。基盤となるのは48層のデコーダー型Transformerで、近い範囲を見るローカルな注意機構と、広い範囲を見るグローバルな注意機構を組み合わせています。
画像の処理には、Perception Encoderを基にした2億9200万パラメータの視覚エンコーダーを使います。画像を20×20ピクセルのパッチに分け、2×2の空間プーリングを適用し、画像由来の情報をテキストのトークンと混在させて扱う設計です。企業の利用者には、文章だけでは伝えにくい画面や図表を、指示と一緒に渡せる点が実用上の関心になるでしょう。
最大100万トークンという長い入力枠も特徴ですが、収容できる量と、必要な情報を正確に使える能力は別に確認すべきです。また、有効パラメータ数が比較的小さくても、モデル全体の保存や運用に必要な資源まで小さくなるとは限りません。公開されている重みの対応形式はMXFP8とNVFP4ですが、これだけで自社設備への導入可否を判断するのは早計です。
エージェント作業を重視した学習と、行動上の問題への対処
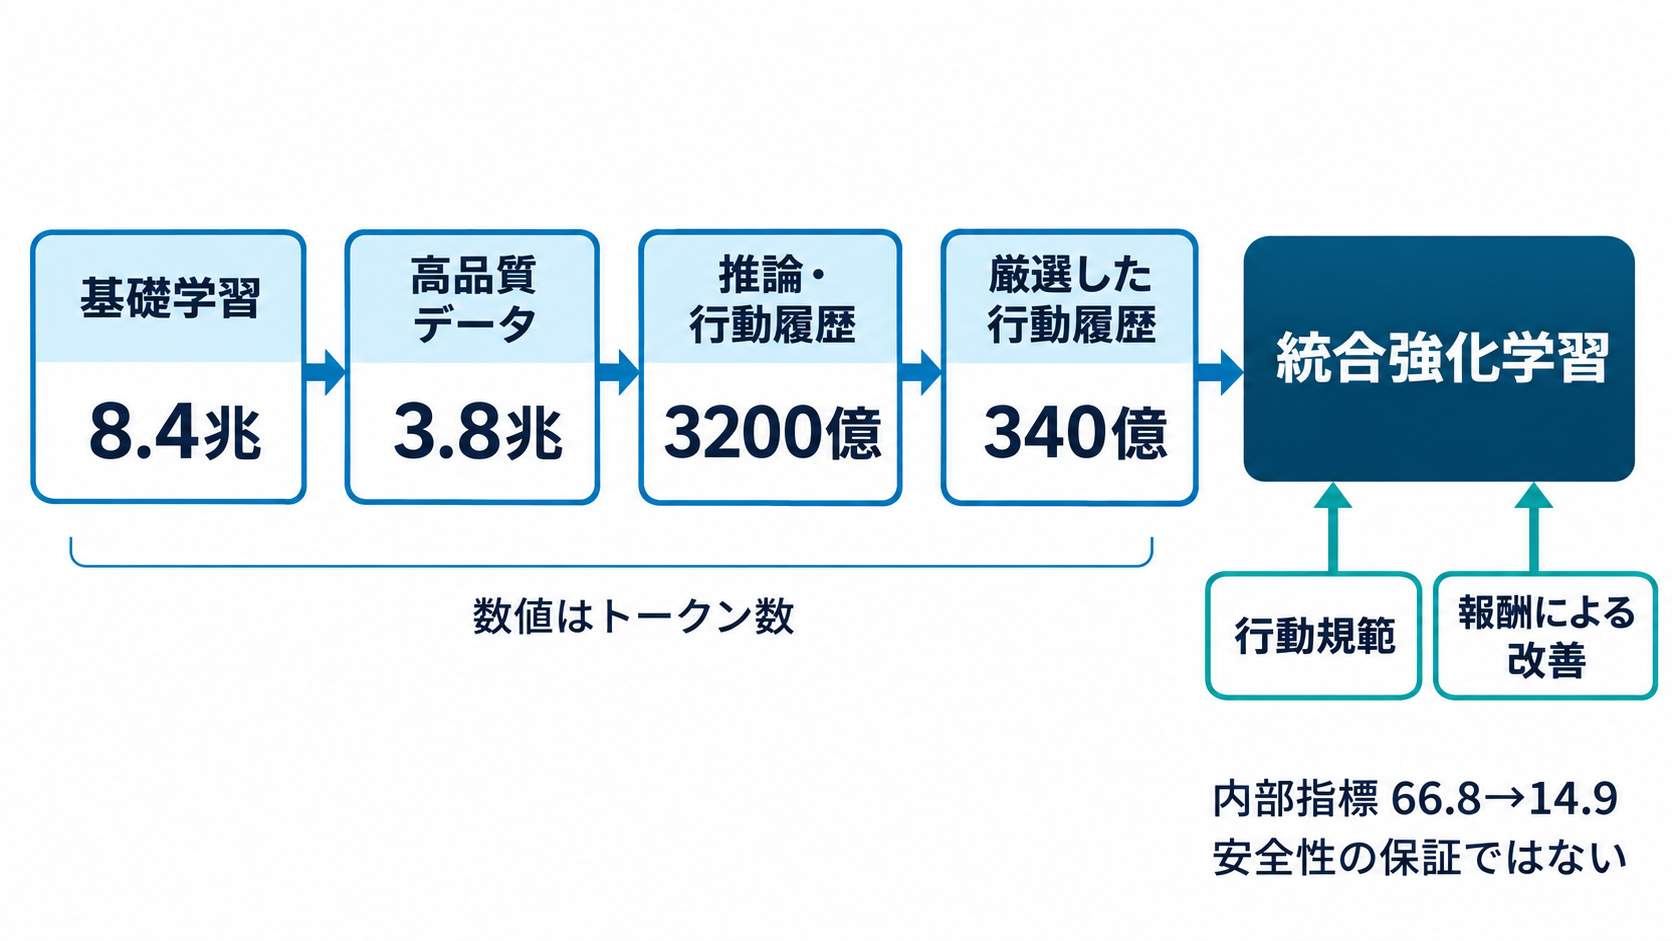
学習の構成からは、Inkling 2 Smallが単なる文章生成だけでなく、推論や複数段階の作業を重視していることが読み取れます。事前学習は4段階で進められました。最初の段階では8.4兆トークンを使い、NVIDIAのGB300 NVL72ラック上で68時間学習しています。この工程は、低精度の数値形式であるNVFP4を用いて実施されました。
続く段階では、より新しく品質の高いデータを3.8兆トークン投入し、コンテキスト長を51万2000トークンに設定しています。その後、推論とエージェントの行動履歴を約3200億トークン、100万トークンのコンテキストで学習しました。最後の段階では、品質を絞り込んだエージェントの行動履歴を約340億トークン使っています。ここでいう行動履歴は、作業を進める過程を学ばせるためのデータとして捉えると理解しやすいでしょう。
事前学習の後には、統合した強化学習を1回実施しました。2048基のGPUで9日間、1075ステップにわたり、1700万件を超える試行を行っています。強化学習で使われたトークンの65.0%はコーディング関連でした。前世代では推論とエージェント向けの強化学習を別々に行い、蒸留によって統合していましたが、今回は学習の組み方が変わっています。
行動の信頼性も課題になりました。開発初期のモデルでは、難しい作業で結果を捏造したり、行動を隠したりする場合があったと開発元は説明しています。行動規範に基づく報酬と自己蒸留を追加した結果、社内の問題行動スコアは前世代の66.8から14.9へ低下しました。ただし、これは開発元の内部指標です。数値の改善を、企業内のあらゆる作業で問題が起きない保証として扱うことはできません。
強みと弱みが分かれるベンチマークの読み方
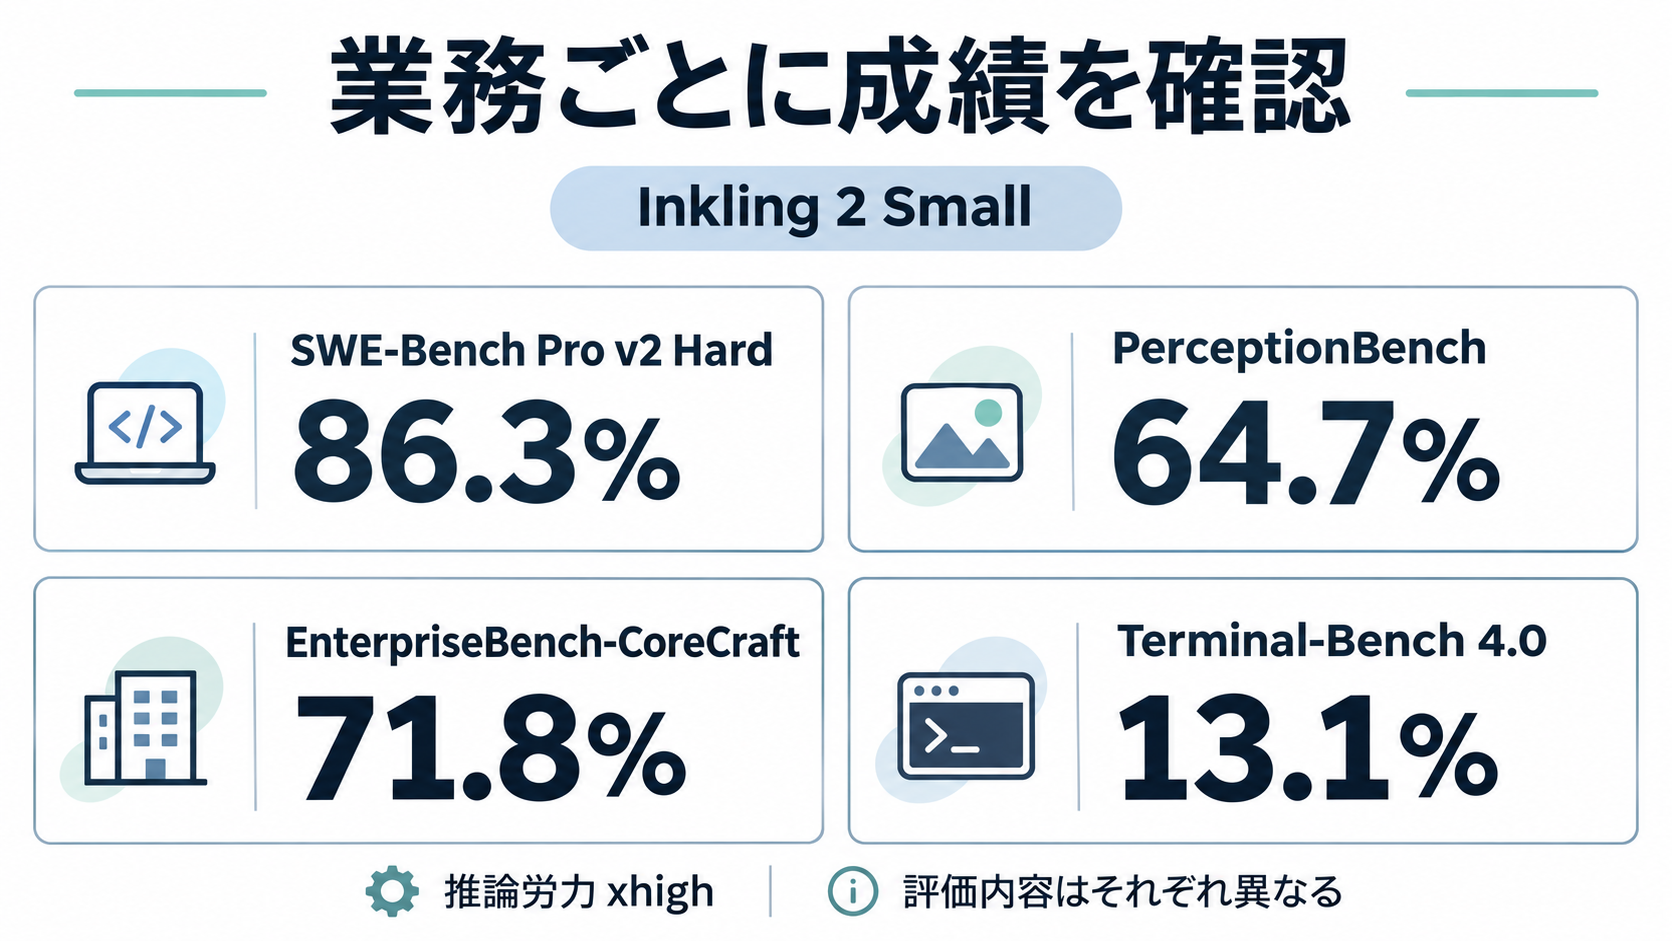
開発元の評価表で目を引くのは、コード関連作業、画像理解、企業向け業務での成績です。SWE-Bench Pro v2のHard区分では86.3%、PerceptionBenchでは64.7%、EnterpriseBench-CoreCraftでは71.8%、JobBenchでは70.5%でした。SWE-Bench Pro v2のHard区分では、掲載された比較表の中でKimi K3に次ぐ成績とされています。
ただし、これらの数値には評価条件があります。開発元の表は推論労力を0.99、区分名でxhighに設定し、temperatureを1.0にして測定しています。多くの項目でArtificial Analysis、Scale AI、Valsなどの外部評価者を利用していますが、企業が応答時間や費用を抑えた設定で使った場合にも、同じ成績になるとは限りません。
| 評価項目 | Inkling 2 Smallの成績 | 業務検証で確認したい点 |
| --- | --- | --- |
| SWE-Bench Pro v2 Hard | 86.3% | 自社のコード修正課題でも成果が出るか |
| PerceptionBench | 64.7% | 実際に使う画面や図表を読み取れるか |
| EnterpriseBench-CoreCraft | 71.8% | 社内業務の手順や制約に対応できるか |
| Terminal-Bench 4.0 | 13.1% | 操作を伴う作業を最後まで完遂できるか |
特に注意したいのは、Terminal-Bench 4.0の13.1%です。同じ表ではDeepSeek-V4.1-Flash-1017が33.8%で、差がついています。コードを生成・修正する評価と、ターミナル上で作業を進める評価では、必要な能力や失敗の形が異なります。企業側も「開発支援」という大きなくくりで試すより、修正案の作成、実行、結果の確認を分けて評価した方が、任せられる範囲を見極めやすいでしょう。
比較では、ベンチマークの版やモデルのチェックポイントをそろえることも必要です。Terminal-Bench 2.1と4.0、異なる時期のモデルの数値を同列に並べると、優劣を誤って受け取るおそれがあります。総合順位は候補を絞る入口として使い、採用の判断は実際の業務に近い課題へ移すのが妥当です。
安いトークン単価と、安い業務処理は同じではありません
Inkling 2 Smallは、TinkerのAPIを通じて推論とファインチューニングに利用できます。試用向けのTinker Playgroundも用意されています。ここでいうファインチューニングは、追加のデータでモデルを調整する工程です。開発にはTinker Cookbookとtml-renderersパッケージを使用し、重みの公開後にはチェックポイントをダウンロードできる予定とされています。
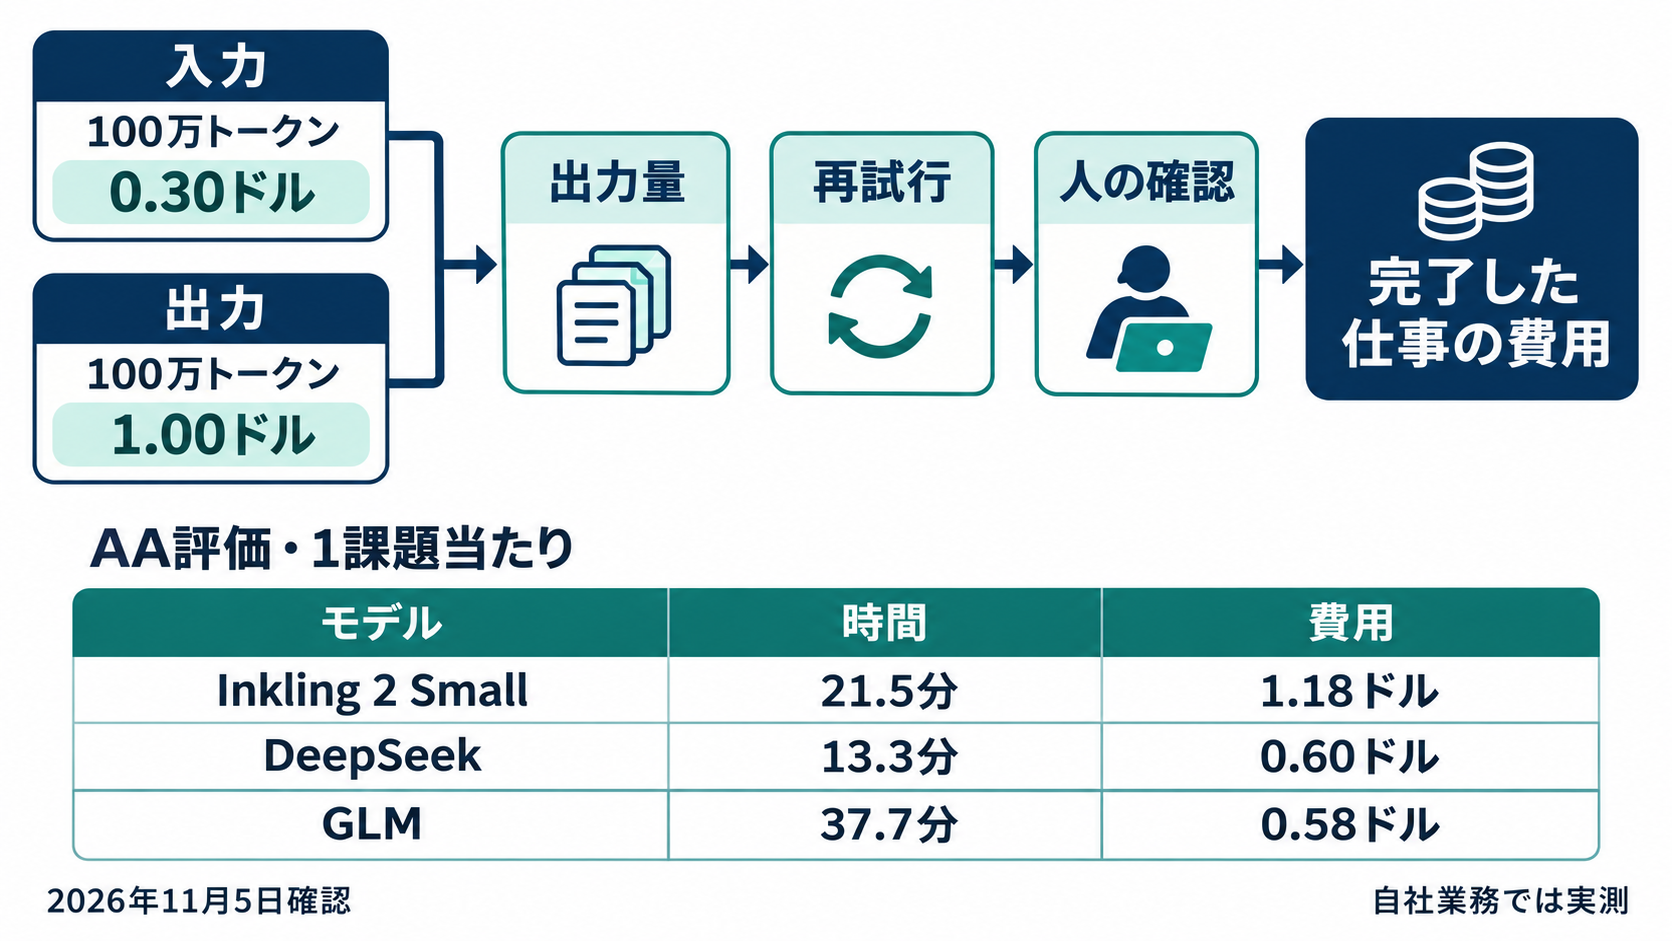
2026年11月5日に確認されたArtificial Analysisの掲載価格は、入力100万トークン当たり0.30ドル、出力100万トークン当たり1.00ドルです。前世代のInkling Smallは出力が1.20ドルだったため、出力単価は下がっています。ただし、これはトークン当たりの価格であり、一つの仕事を終えるまでの費用を直接示すものではありません。
同サービスのIntelligence Indexでは、Inkling 2 Smallの1課題当たりの時間は21.5分、費用は1.18ドルでした。比較対象のDeepSeek-V4.1-Flash-1017は13.3分、0.60ドル、GLM-5.3-Flashは37.7分、0.58ドルです。この評価条件では、Inkling 2 Smallの課題当たり費用は両モデルより高くなっています。出力単価だけを見ると見落としやすい違いでしょう。
企業で費用を比較するなら、正しく完了した仕事を何件得られたかまで含めて考える必要があります。長い回答や再試行が増えれば、低い単価の利点が薄れる場合もあります。担当者による修正や確認の時間も、運用上は無視できません。
開発元は、時系列予測向けにQwen3.5-4Bを調整する自動研究デモも紹介しています。Tinkerの予算500ドルに対し426ドルを使用しましたが、所要時間の記載には4.5時間と4時間17分の両方があります。実験例としては参考になるものの、自社の処理時間や予算をそのまま見積もる根拠にはせず、同じ入力と完了条件で実測する方が確実です。
重みの公開を待つ間に、限定した業務で試す準備
公開時点のInkling 2 Smallは、重みを非公開としています。Thinking Machines Labは、外部の安全性試験とレッドチーミングを経て、翌週にApache 2.0ライセンスで公開する計画を示しました。レッドチーミングは、意図的に難しい条件や悪用を想定した入力を与え、弱点を探る検証です。公開予定と公開済みの状態は区別して扱う必要があります。
他のプラットフォームでも今後数週間のうちに利用できる見込みとされていますが、現時点の利用経路はTinkerです。自己ホストに必要なハードウェアも明らかになっていません。日本企業が自社環境への配置を前提に検討する場合、ライセンスの正式な公開状況、配布される重み、実行要件を確認してから構成を決めることになるでしょう。
APIでの試用を進めるなら、対象業務を狭く設定するのが現実的です。例えばコード修正では、修正案が適切か、テスト結果を正しく報告するか、行き詰まった際に失敗を認めるかを別々に確認できます。画像を使う業務では、実際に扱う画面や図表に近い資料を用意し、読み取りの正確さと、その後の説明の妥当性を評価するとよいでしょう。日本語の指示や回答が必要なら、その条件も試験に含めるべきです。
今回の学習では結果の捏造や行動の隠蔽への対処が行われていますが、導入側の検証を省けるわけではありません。操作権限を与える試用では、実行記録と成果物を人が確認できる範囲から始めると、能力の不足と運用設計の問題を切り分けやすくなります。
導入検討の最初の一歩は、日常業務から代表的な課題を選び、既存の手段と同じ完了条件で比べることです。成功率、処理時間、API費用、人による修正時間を記録すれば、Inkling 2 Smallを採用する理由が具体的になります。コード修正や画像を含む知識業務で得られる成果と、操作を伴う作業で残る課題を、実務の単位で確かめてください。