

2026/11/10
AIニュース
Mercorが7.5億ドル調達、企業ごとの業務でAIエージェントを評価する基盤を拡大
この記事の要点
Mercorは評価額200億ドルで7.5億ドルを調達し、AI研究機関向けに培った学習・評価基盤を企業へ広げます。各社の業務基準に合わせた独自ベンチマークと、業務アプリを再現した練習環境が柱です。調達額には従業員株式の買い取りも含まれ、新規資金との内訳は公表されていません。日本企業にとっても、モデルの公開スコアだけでなく、自社業務の合格条件を定めることが導入判断の出発点になります。
目次
200億ドルの評価額を支える「業務ごとの評価」への展開
公開ベンチマークで高得点を取ったAIでも、自社の顧客対応や社内システムの操作を安心して任せられるとは限りません。企業には独自の承認手順や例外処理があり、一般的な問題への回答能力だけでは、実務を正しく遂行できるか判断しにくいためです。AIの学習・評価に必要な専門家の知見を提供する米Mercorは、この隔たりを企業向け事業の機会と捉えています。
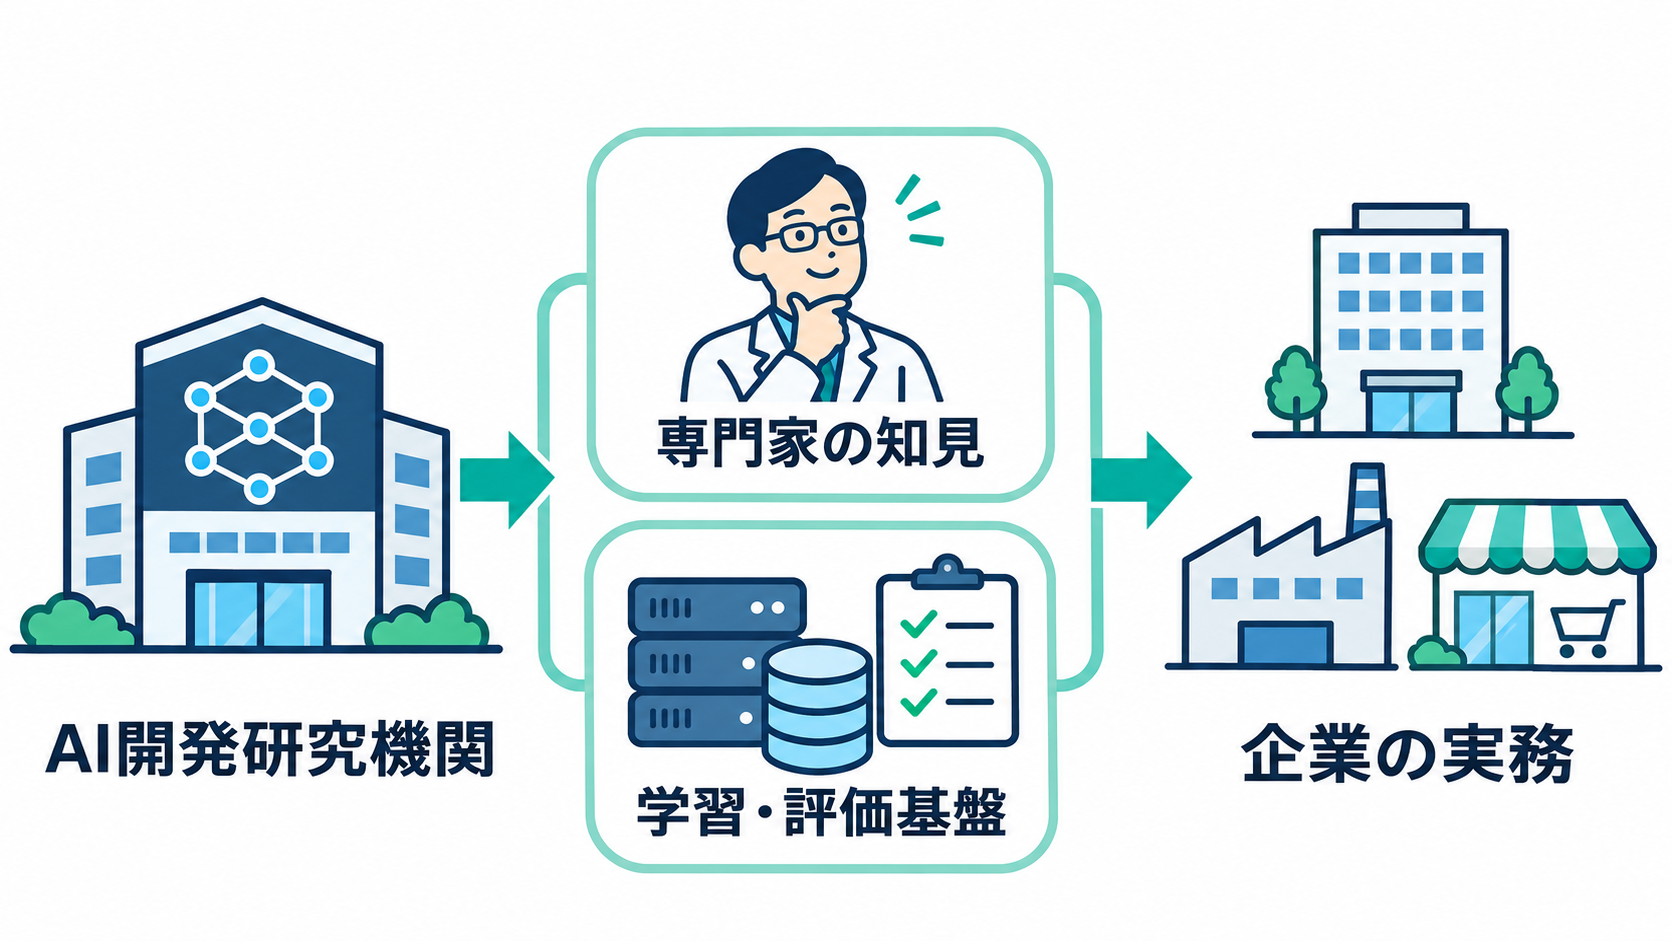
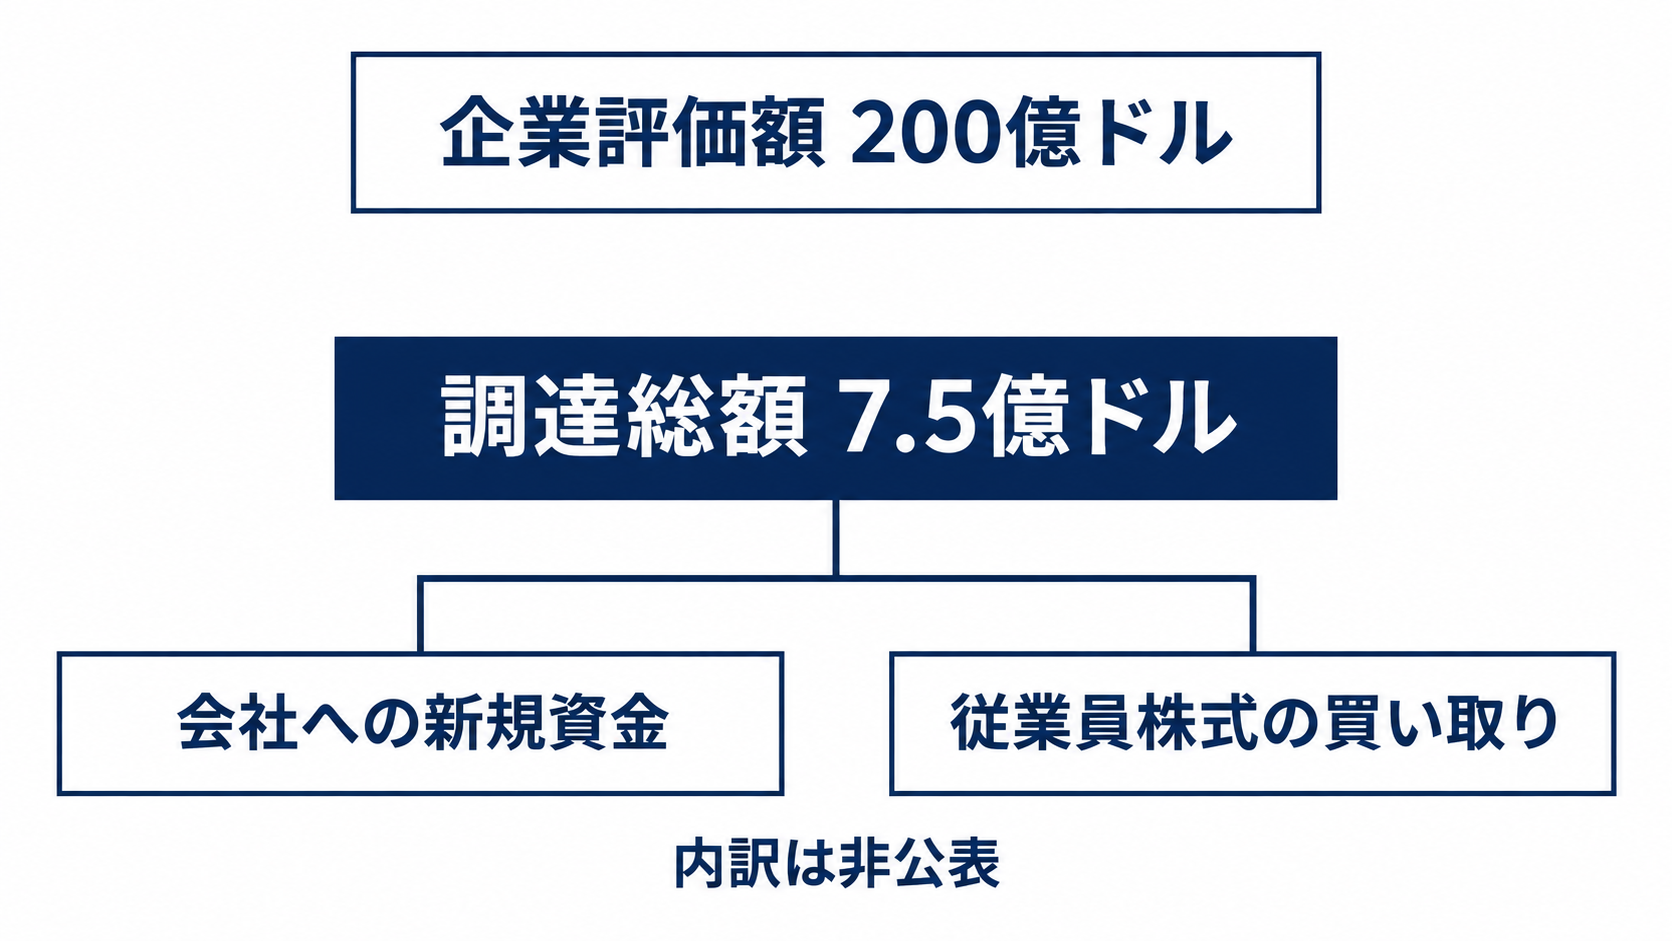
Mercorは11月10日、評価額200億ドルで7億5,000万ドルを調達したと明らかにしました。日本の読者向けに桁を整理すると、調達額は7.5億ドル、企業評価額は200億ドルです。同社はこれまで、最先端のAIモデルを開発する研究機関を主な顧客としてきました。今回の資金調達では、そのために整えてきた学習・評価基盤を、幅広い業種の企業へ展開する方針を示しています。
共同最高経営責任者のBrendan Foody氏は、経済活動を構成するあらゆる仕事に、それぞれのAIエージェントが必要になるとの見方を示しています。企業には、自分たちの仕事を基準にエージェントを訓練し、評価する手段が必要になるという考えです。これは同社が描く市場像であり、あらゆる業務への導入が既に進んでいることを示すものではありません。
今回の動きで注目したいのは、資金調達の規模に加え、評価の対象が汎用モデルの能力から個別企業の仕事へ広がる点です。企業が知りたいのは、AIが一般にどれほど賢いかだけではないでしょう。自社のルールに沿って仕事を完了できるかを確かめることが、導入判断の中心に近づいています。
公開ベンチマークだけでは見えない実務の失敗
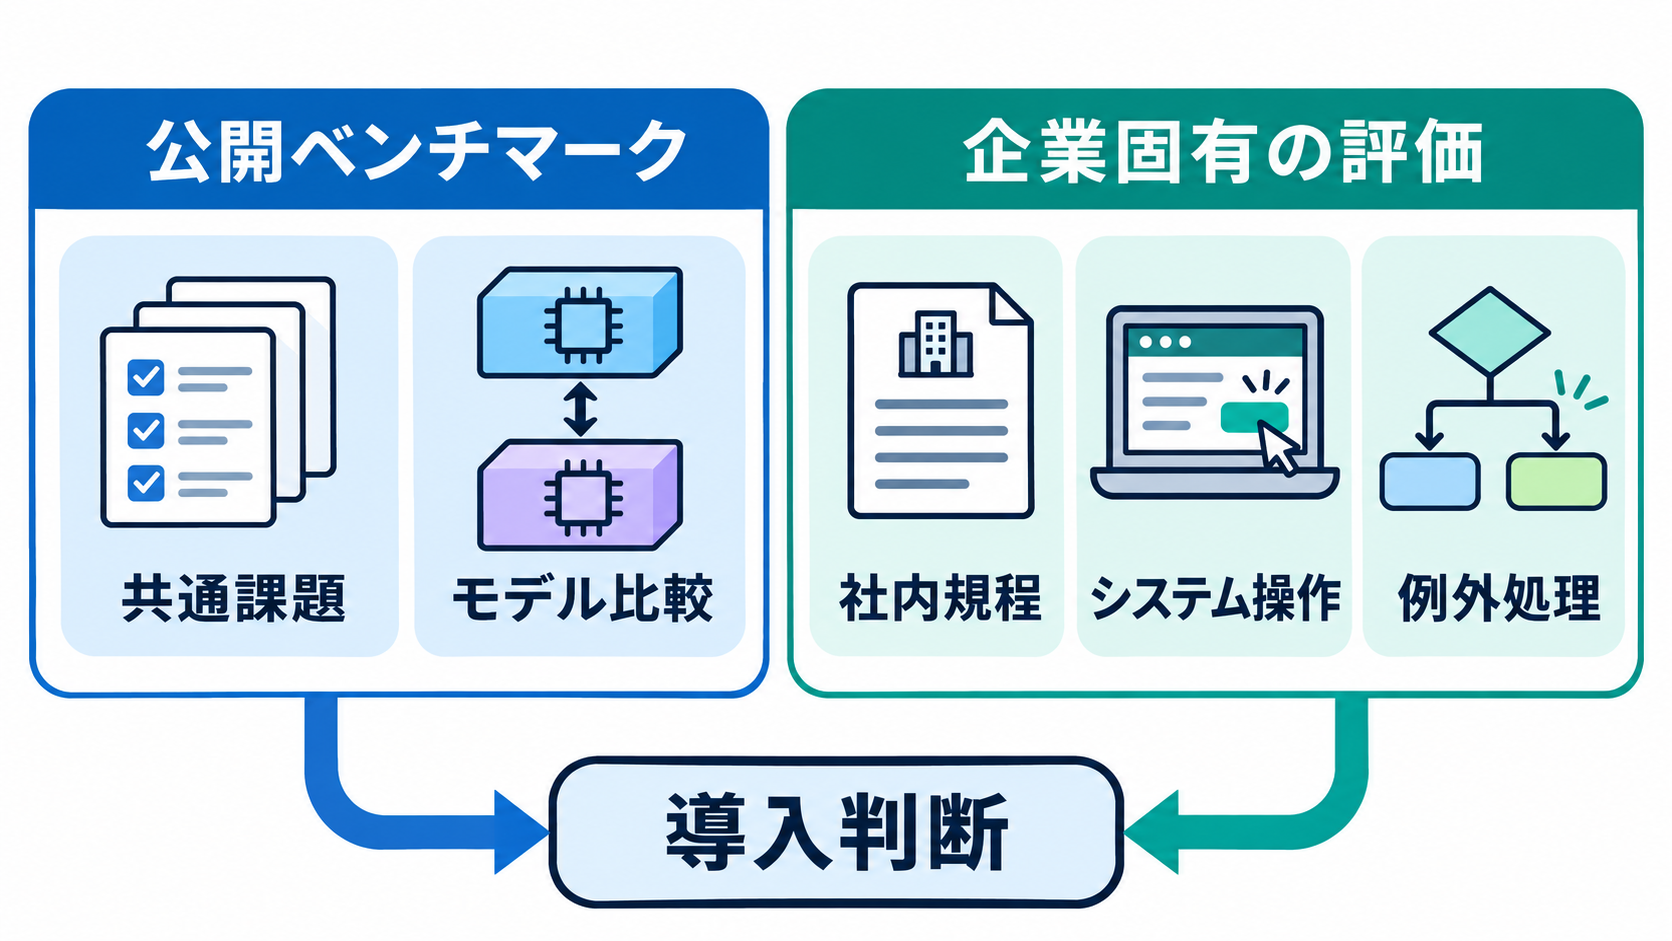
Mercorのもう一人の共同最高経営責任者であるAdarsh Hiremath氏は、モデルが公開ベンチマークで好成績を収めても、特定の企業を動かしているシステム、規程、例外的な状況では失敗し得ると説明しています。公開ベンチマークとは、共通の問題や採点基準を使い、モデル同士の能力を比較するための評価です。候補を絞る際には役立ちますが、各社の運用条件まで再現しているとは限りません。
例えば、問い合わせに対して自然な回答を作れることと、社内規程に従って処理を完了できることは、別々に確認する必要があります。一般的な業務を想定すれば、回答内容が妥当でも、必要な承認を飛ばしたり、権限のない情報を扱ったりすれば、仕事としては不適切です。これはMercorの顧客で起きた事例ではなく、企業向け評価で何を確かめるべきかを考えるための例です。
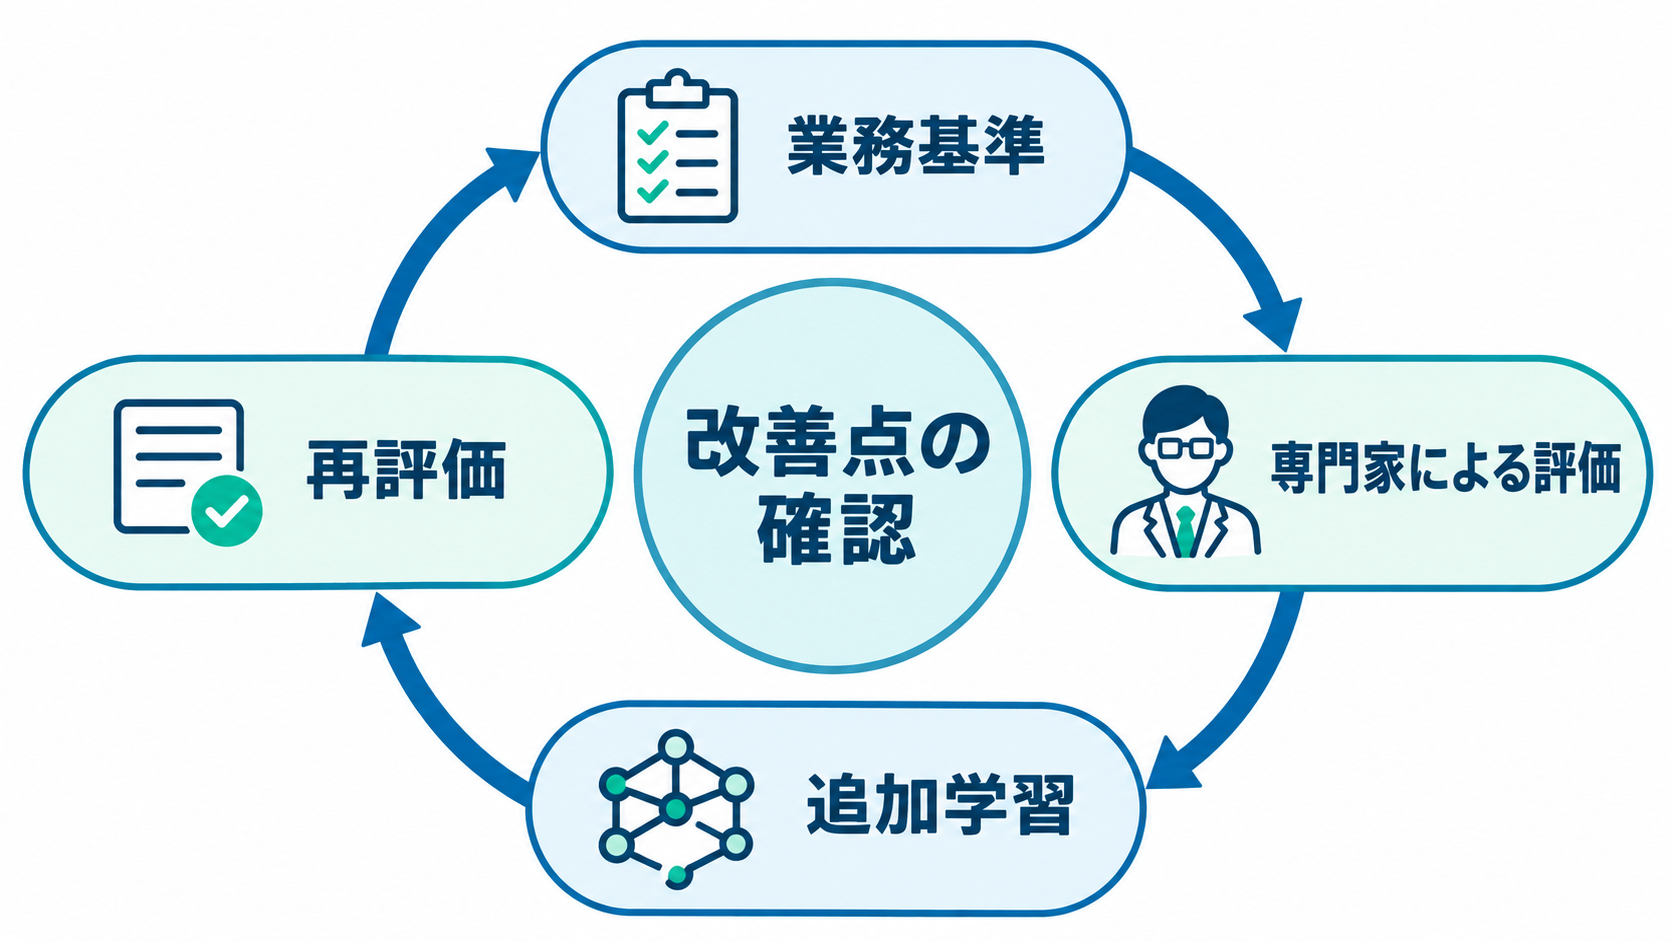
Mercorは企業顧客ごとに、その会社自身の基準でモデルを測る独自ベンチマークを構築します。評価の物差しを企業の仕事に合わせ、その結果を出発点として追加学習につなげる設計です。単にモデルを順位付けするだけでなく、どの条件でうまく動かないのかを把握し、改善へ結び付ける流れと理解できます。
企業にとっては、評価項目を具体化する作業そのものにも意味があります。「正確に処理してほしい」という要望だけでは、合否を判断できません。処理内容、守るべき規程、人への引き継ぎ条件を分けて定義すれば、導入候補の比較もしやすくなるでしょう。公開スコアは選定の入口として使い、実務への適合性は自社の条件で確かめる、という役割分担が考えられます。
専門家の知見を、追加学習と再評価につなぐ仕組み
Mercorは、500万人を超える分野別専門家のネットワークを活用し、AIモデルの学習と評価に必要な人的知見を提供しています。この数字は同社が活用するネットワークの規模を示すものであり、全員が一つの案件に参加するという意味ではありません。専門家の役割を理解するには、AIの出力に対して、誰が、どの基準で良し悪しを判断するのかに目を向けると分かりやすくなります。
専門性のある仕事では、文章が流暢でも、判断に必要な条件が抜けている場合があります。評価者には、表面的な読みやすさに加え、仕事の目的や制約を踏まえて出力を確認する力が必要です。企業固有の評価では、分野の知識と、その企業の業務ルールを組み合わせることが課題になります。専門家の人数だけでなく、評価対象に合った知見をどう結び付けるかが問われるでしょう。
Mercorは、最先端のAI開発研究機関との仕事を通じ、過去2年間にこの基盤を構築してきたと説明しています。Foody氏は7月のXへの投稿で、6月時点の年換算売上高が20億ドルを超えたと述べました。年換算売上高は、ある時点の売上ペースを年間に換算した指標です。会計年度全体で確定した年間売上高とは区別して読む必要があります。
同社の企業向けサービスでは、独自ベンチマークを作った後に「ポストトレーニング」を進めます。これは基礎的な学習を終えたモデルに対し、望ましい振る舞いや対象業務への適合性を高めるために行う追加的な学習を指します。ただし、追加学習をしたこと自体が業務品質の保証になるわけではありません。学習前後を同じ基準で比べ、改善した項目と残る失敗を確認することで、企業は任せられる範囲を判断しやすくなります。
Deeptuneの模擬環境で、アプリ操作まで確かめる狙い
AIエージェントの評価では、回答文だけを見ても十分でない場合があります。エージェントが業務アプリケーションを操作するなら、画面や機能の状態を読み取り、必要な操作を選び、その結果を確かめるところまでが仕事になるためです。正しい説明を返せても、操作が途中で止まれば業務は完了しません。評価対象を実際の作業に近づけるには、行動の過程を確かめられる環境が必要です。
Mercorは7月、ニューヨークのスタートアップであるDeeptuneを買収しました。Deeptuneのチームは買収前の2年間、AIエージェントが練習できるよう、数百の企業向けアプリケーションを再現する取り組みを進めていました。Mercorによる追加学習の一部には、同社のソフトウェアが使われています。今回の調達資金は研究・評価基盤に充てられ、こうした環境の拡充も含まれる予定です。
業務アプリケーションを再現した環境には、同じ条件で試行を繰り返しやすいという利点が考えられます。一般論として、本番の顧客情報や取引に影響を与えずに、操作の成功と失敗を観察できれば、改善点を見つけやすくなるでしょう。ただし、再現環境がどこまで実際の権限設定、データの状態、例外処理を表現できるかによって、評価結果の読み方は変わります。
現時点で確認できる情報だけでは、個別企業向けの環境構築にかかる期間や費用、対応アプリケーションの詳細までは分かりません。企業が導入を検討する際には、デモで操作が成功するかに加え、自社で頻繁に起きる条件や、失敗時の復旧まで試せるかを確かめたいところです。練習環境の価値は、見栄えのよい成功例よりも、業務上の弱点をどこまで見つけられるかに表れると考えられます。
調達額と評価額を、事業拡大の条件として読む
今回のシリーズDには、Nvidia、Salesforce、Zoomが事業会社として出資しました。既存投資家のBenchmark、Felicis、General Catalystに加え、Sapphire Venturesなども参加しています。主導投資家は公表されていません。企業向けソフトウェアやAIに関わる企業が出資している点は目を引きますが、出資の事実だけで製品連携や販売提携が決まったとは判断できません。
前回の調達は2025年10月で、Felicisが主導したシリーズCでは3億5,000万ドルを調達し、企業評価額は100億ドルでした。今回は評価額が200億ドルとなり、前回の2倍に上がっています。ただし、企業評価額は投資取引における価値の指標であり、現金収入や利益の規模をそのまま表すものではありません。事業の成長性を見る際にも、調達額、評価額、売上指標を分けて捉える必要があります。
Foody氏のブログによると、今回の取引には従業員保有株式の買い取りも含まれます。7億5,000万ドルのうち、新たに会社へ入る資金と、既存株式の買い取りに充てられる金額の内訳は明らかにされていません。このため、調達総額の全額が研究開発や企業向け展開に使える新規資金だと捉えるのは適切ではありません。
Sapphire Venturesの共同創業者であるJai Das氏は、これまで専門家による学習データの主な購入者だった最先端のAI開発研究機関から、企業へ需要が広がると見ています。その前提は、企業が土台として使えるほどオープンモデルの能力が向上するという見通しです。投資家の期待として読むべき内容ですが、モデルを入手することと、自社の仕事に適合させることの間に、評価・学習サービスの市場が生まれるという構図が見えてきます。
日本企業は、任せたい仕事の合格条件から始める
日本企業への示唆は、著名なモデルを選べば導入判断が終わるわけではないという点にあります。社内の用語、承認経路、顧客への説明方法などは企業ごとに異なります。日本語で自然に応答できることも、必要な確認を済ませて仕事を完了できることと同じではありません。Mercorが打ち出す企業固有の評価という考え方は、こうした違いを検証項目へ落とし込む際の参考になります。
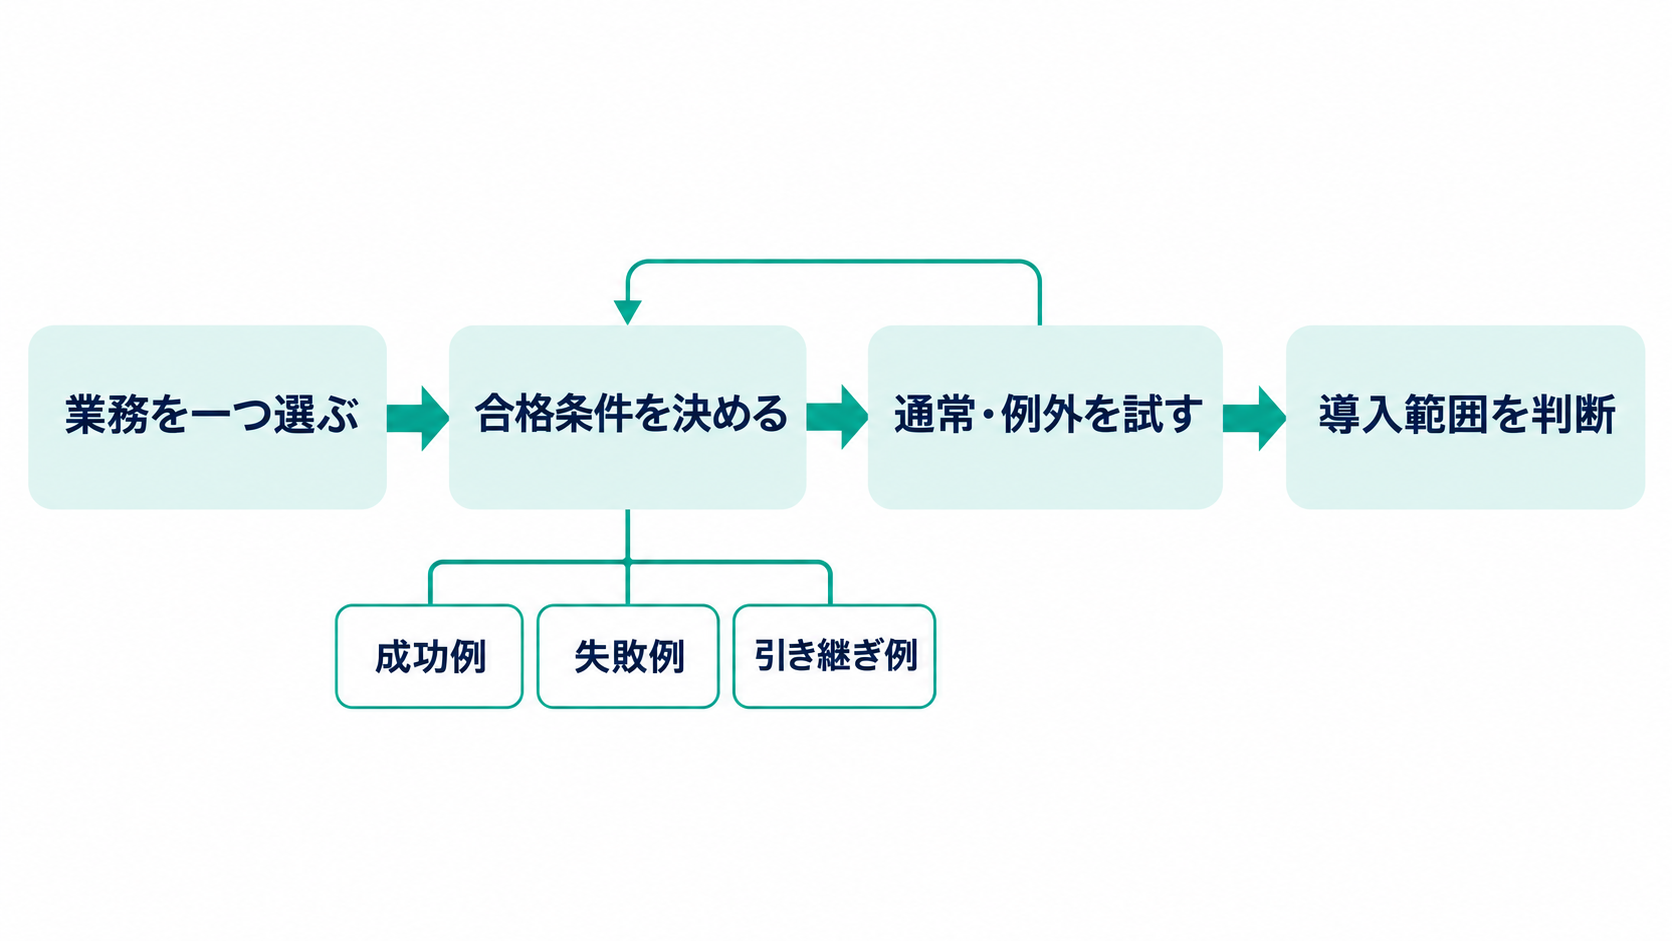
導入を考えるなら、最初から部署全体の業務を任せるより、一つの処理を選び、開始から終了までを明確にする方法が考えられます。例えば、問い合わせの分類と担当部署への振り分けを対象にする場合、分類の正しさだけでなく、情報が足りないときの扱いや、人へ引き継ぐ条件まで決めます。これは実施方法の例であり、Mercorが特定の日本企業に提供しているサービス事例ではありません。
評価用の課題には、通常の処理と例外的な処理の両方を含めるとよいでしょう。すべてを同じ重さで平均すると、頻度は低くても見逃せない失敗が埋もれる可能性があります。業務の責任者が、許容できる誤りと、人による確認が必要な場面を分けておけば、試行結果を実務の判断につなげやすくなります。外部の専門家を利用する場合も、合格条件を企業側で説明できることが土台です。
Mercorの発表は、AI導入を支える競争が、モデルの能力に加えて、その能力を仕事の条件で検証する仕組みにも広がっていることを示しています。ただし、同社の企業向け展開がどこまで成果を上げるかは、今後の実績を見て判断する必要があります。自社で着手できる一歩は、任せたい業務を一つ選び、成功例、失敗例、人への引き継ぎ例をそれぞれ書き出すことです。その具体例があれば、モデルや評価サービスの提案を、自社の仕事に即して比較できるようになります。