
2026/10/29
AIニュース
企業AIエージェントの「良し悪し」を人の判断で学ばせる――Crux Labsが600万ドル超を調達
企業AI運用で残された「判断基準」の空白
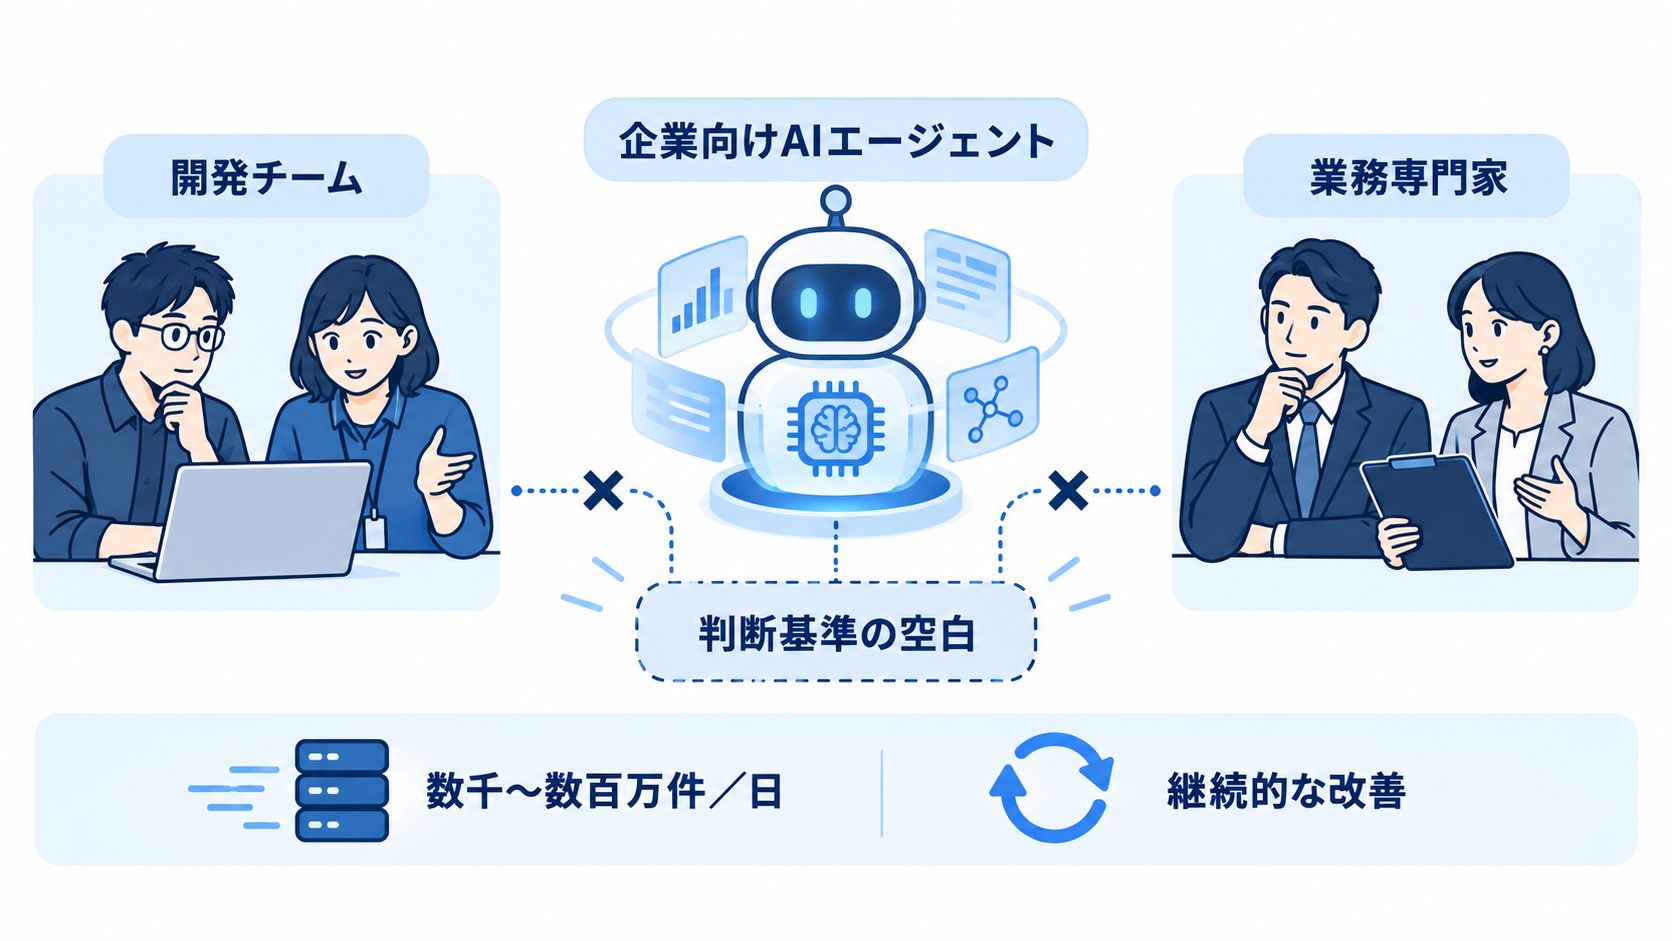
企業向けAIエージェントを開発するCrux Labsは、600万ドルを超える資金を調達し、事業を正式に始動しました。今回のラウンドはBenchstrengthとMisneachが主導し、Analog VenturesとPareto Holdingsも参加しています。同社が狙うのは、AIエージェントを作る技術そのものではありません。現場の専門家が持つ「どの応答なら合格なのか」「どこに違和感があるのか」という判断を、継続的な改善に結び付ける仕組みです。企業で稼働するAIエージェントは、1日に数千件から数百万件のユーザー対応を処理する場合があります。処理件数が増えるほど、人が一つひとつ内容を確認する方法は成り立ちません。ログや処理経路を記録する観測ツールがあっても、問題を発見した後に「何を良い状態とみなし、どのように直すのか」まで自動的に決まるわけではないからです。
Crux Labsが中心課題としているのは、この判断基準の空白です。共同創業者兼最高経営責任者のJulie Kheyfets氏は、AIエージェントは目標達成を得意とする反面、人間が長年にわたって蓄積してきた経験則へ十分にアクセスできないと説明しています。企業にとって必要なのは、単にモデルの精度を測ることではなく、営業、医療、金融、セキュリティーなど、それぞれの業務で培われた判断を日々の評価へ反映することです。Crux Labsの資金調達は、AI導入の競争軸が「作れるか」から「現場の基準に沿って改善し続けられるか」へ移りつつあることを示す動きと考えられます。
1%以下の確認では見逃される失敗
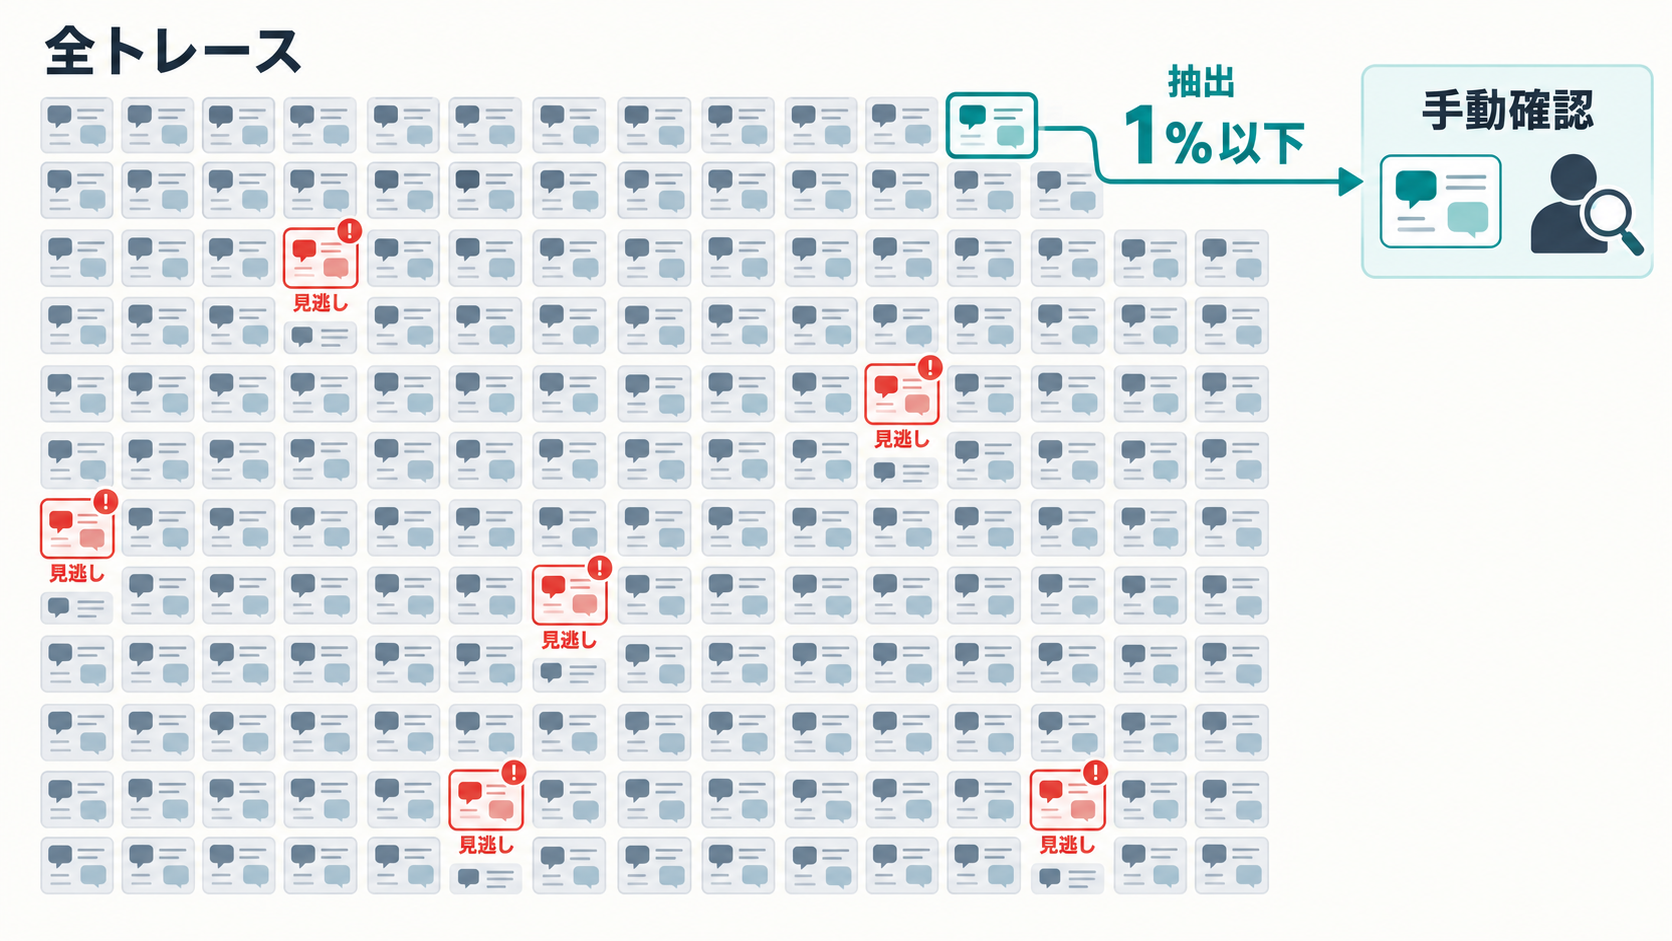
現在のAIエージェント運用では、処理内容を記録した「トレース」が問題分析に使われます。トレースとは、入力された質問、AIによる判断、外部ツールの呼び出し、生成された回答など、一連の処理経路を追跡できる記録です。観測ツールを使えば、担当者はエラーや遅延、特定条件での異常を調べられます。ただし、膨大な記録のすべてを人が読むことは現実的ではありません。Crux Labsによると、多くのチームは特定の指標やしきい値、無作為抽出などを使い、全トレースの上位1%以下だけを手作業で確認しています。この方法では、明確なシステムエラーは拾えても、文脈に依存する微妙な失敗が残りやすくなります。たとえば、回答の形式は正しくても顧客の意図を外している場合や、社内ルールには反していないものの熟練担当者なら避ける表現を選んでいる場合です。数値だけでは見えにくい問題ほど、確認対象から外れるおそれがあります。
見逃された不具合は、最初から重大な事故として現れるとは限りません。小さな違和感として発生し、同じ状況が繰り返された後に問い合わせや苦情となり、ようやくチケットが登録されることもあります。その後、原因調査、修正、検証を経て反映されるため、問題の発生から改善までに数週間かかる可能性があると同社は指摘しています。処理量が増えれば、サンプル件数だけを増やす対応にも限界が来るでしょう。必要なのは、人の確認作業を単純に拡大することではなく、専門家の判断をより広い範囲へ適用できる評価方式です。
専門家の経験則を評価エージェントへ移す仕組み
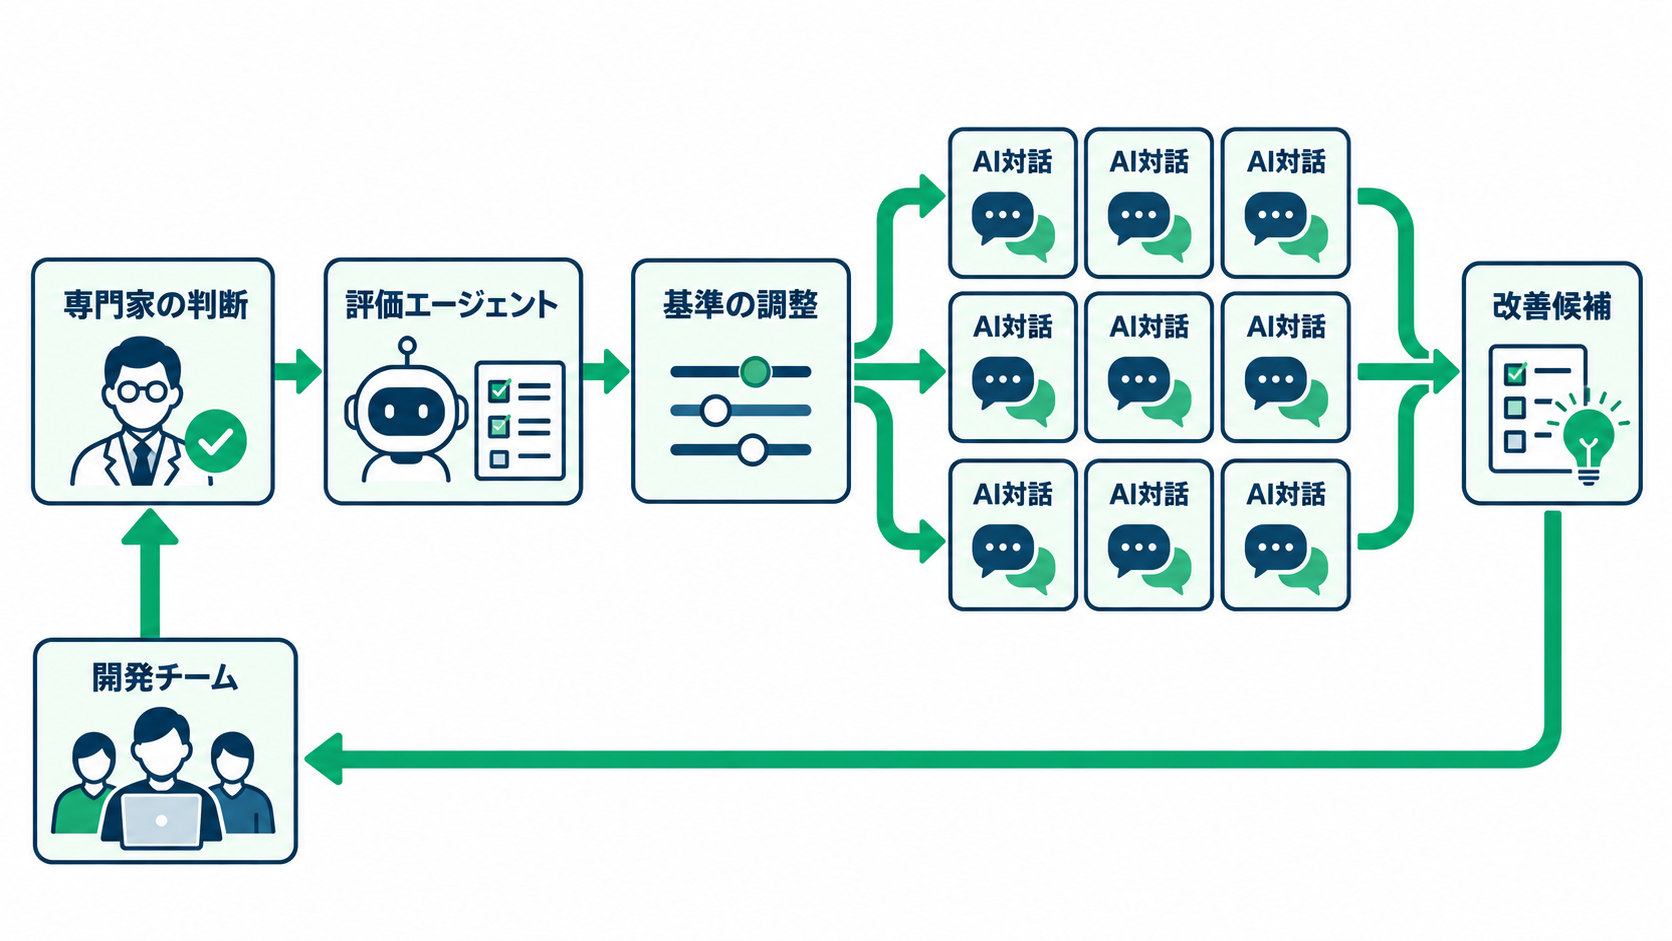
Crux Labsは、自社のAIエージェントを評価者兼改善チームとして働かせます。従業員や業務専門家が示す判断を取り込み、その基準を大量のインタラクションへ適用する構想です。これにより、担当者がごく少数のサンプルだけを見て全体の状態を推測するのではなく、自らの判断をより広い処理範囲へ増幅できるとしています。ここで扱われる「人間の判断」は、単純な正解ラベルだけではありません。企業の実務では、同じ質問に事実上正しい回答を返していても、説明の順序、慎重さ、顧客への配慮、リスクの示し方によって評価が変わります。明文化されたマニュアルだけでなく、経験豊富な担当者が状況に応じて使い分ける経験則も品質を左右します。Crux Labsは、こうした「良い対応がどのようなものか」という知識を評価へ組み込み、数百万件規模のやり取りにわたって基準を調整することを目指しています。
この方式で重要なのは、AIが人間を置き換えて最終判断を独占することではなく、人間が示した基準をAIによって広く適用する点です。評価エージェントが候補となる問題を抽出できれば、専門家は全件確認から離れ、判断基準の設定や難しい事例の検討に時間を使いやすくなります。ただし、判断の取得方法、評価結果から修正へつなぐ具体的な手順、誤った基準を訂正する統制など、詳細な製品仕様は現時点では明らかにされていません。企業が採用を検討する際は、評価範囲の広さだけでなく、人による再確認や基準更新の仕組みも確かめる必要があります。
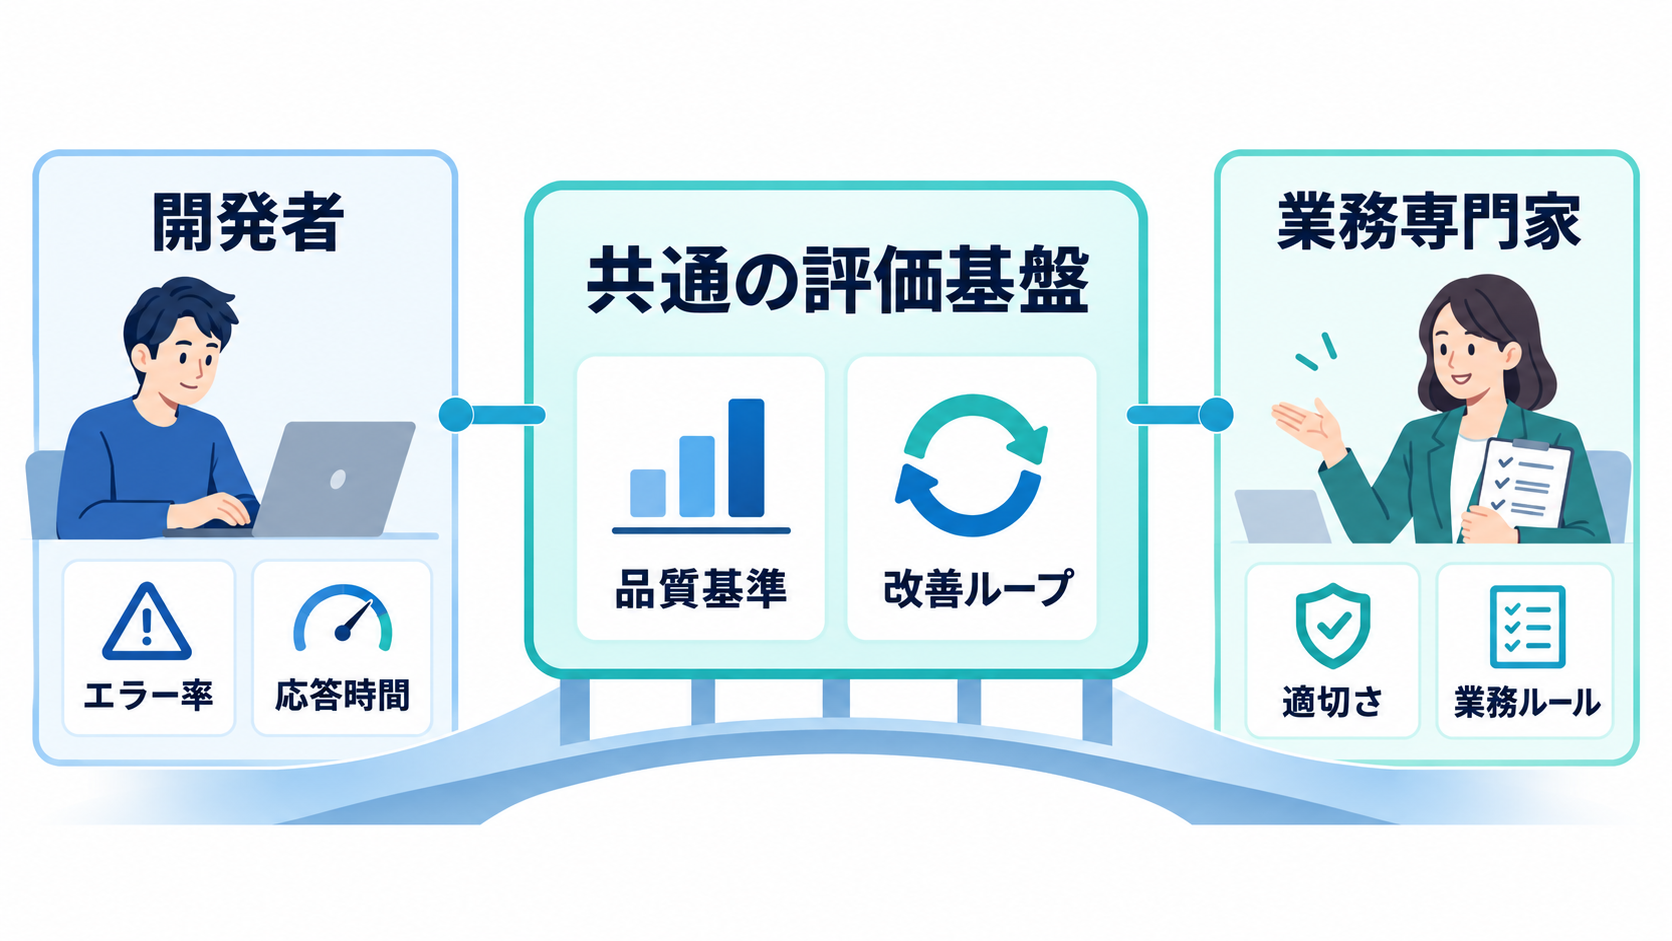
開発者と業務専門家を隔てる組織上の壁
共同創業者兼最高技術責任者のKrishna Kulkarni氏は、エンジニアリングチームはAIエージェントを構築でき、業務専門家は成功の状態を理解しているものの、企業には両者を結ぶ橋が不足していると説明しています。この分断は技術上の問題だけではありません。開発者が確認する指標と、現場担当者が感じる品質の間で、共通の言葉や改善手順が定義されていないことが背景にあります。開発側は、応答時間、エラー率、ツール呼び出しの成否といった測定しやすい項目を扱えます。業務側は、顧客との関係を損ねない説明、規制や社内方針に沿った判断、例外案件での慎重な対応などを重視するでしょう。どちらも必要ですが、業務側の知識が会議や個別のチケットだけで伝えられる状態では、改善の速度と再現性が上がりません。担当者の頭の中にある基準を継続的な評価へ変換できれば、両チームは個別事例ではなく、共通の品質基準を基に対話できます。
企業がこうした基盤を導入する場合、評価結果を開発へ渡すだけでは不十分です。どの部署が合格基準を決めるのか、意見が割れた事例を誰が裁定するのか、基準変更をいつ反映するのかといった運用設計が欠かせません。AIエージェントの出力は、モデル、指示文、接続データ、利用する外部ツールなど複数の要素に左右されます。問題の検出と修正責任を結び付けておかなければ、評価が増えても改善が滞る可能性があります。Crux Labsの提案は、評価技術の導入と同時に、開発部門と事業部門の協働方法を見直す必要性も浮かび上がらせています。
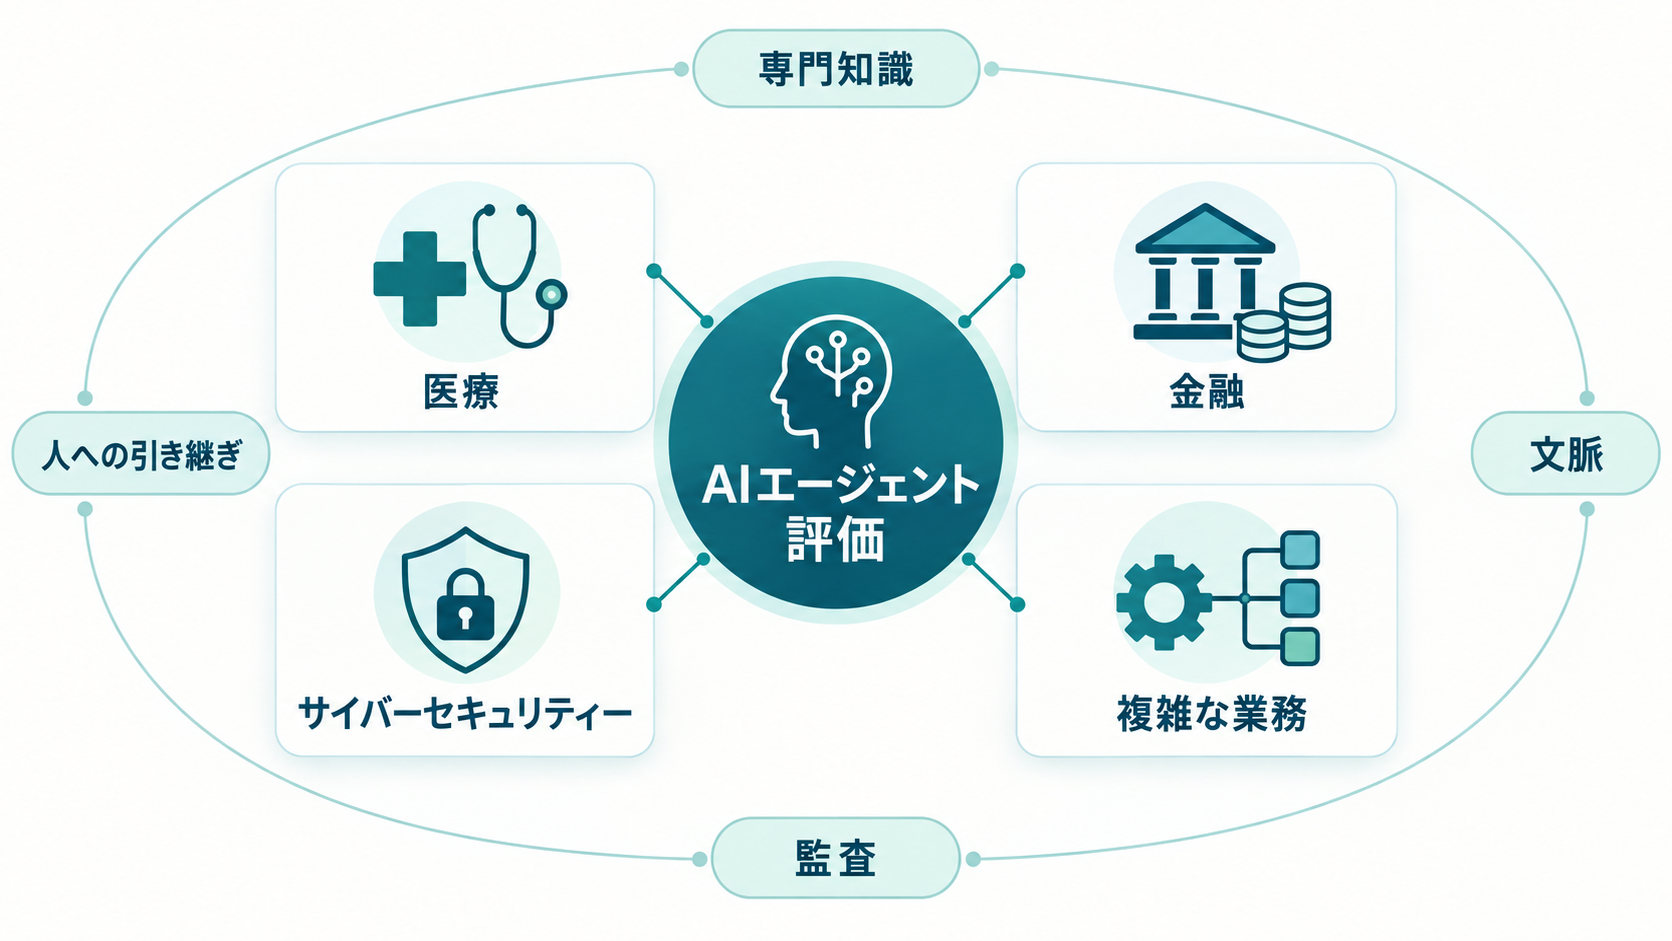
医療・金融・サイバーセキュリティーで問われる文脈
Crux Labsは、医療、サイバーセキュリティー、金融サービスを含む複雑な業界で、高成長スタートアップからFortune 500企業まで利用が広がっていると説明しています。Fortune 500は、米経済誌Fortuneが売上高を基準に選ぶ米国企業500社のリストです。ただし、顧客企業名、導入件数、契約規模、個別の成果指標は公表されていません。現段階では、具体的な効果を一律に判断するより、どのような業務課題と適合するかを見極めるべきでしょう。これらの業界では、単に文章が自然であることと、業務上適切であることが一致しません。医療では状況に応じた慎重な情報提示が求められ、金融では手続きや方針との整合性が重視されます。サイバーセキュリティーでは、似た兆候でも環境や脅威の文脈によって対応が変わり得ます。ここで挙げた特徴は各分野を理解するための一般的な整理であり、Crux Labsが特定の診断、取引判断、脅威対応を自動化していると示すものではありません。
複雑な業務ほど、専門家の判断を拡張する仕組みには価値がある反面、誤った判断基準を大規模に適用するリスクもあります。少人数の専門家が示した好みを組織全体の正式な基準として扱ってよいのか、地域や顧客層による違いをどう管理するのかも検討が必要です。評価エージェントの判定精度だけでなく、根拠を追跡できること、異議申し立てができること、重要案件を人へ戻せることが法人利用では欠かせません。人間の判断を増幅する製品だからこそ、誰の判断を、どの範囲で、どの期間有効とするかが導入成否を左右すると考えられます。
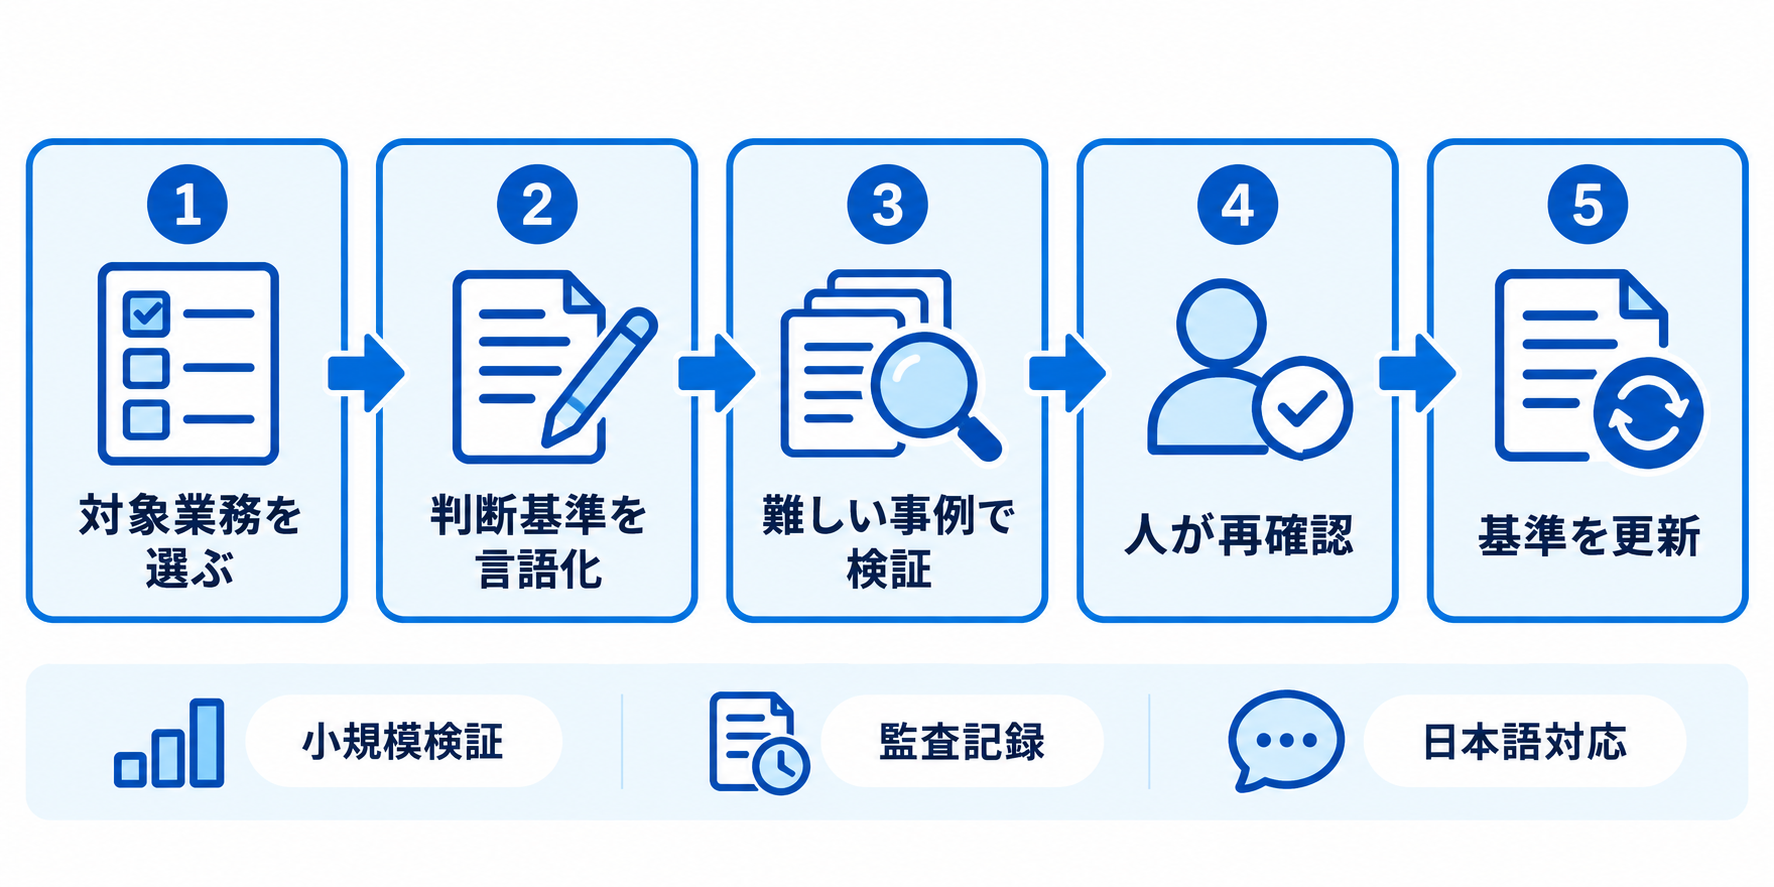
日本企業が小規模検証で確かめるべき条件
日本企業が同種の評価基盤を検討するなら、最初から全社のAIエージェントを対象にするより、品質基準が比較的明確な一業務から始める方法が現実的です。問い合わせ分類、社内ナレッジ検索、定型的な一次回答など、専門家が良否を説明でき、誤りを人へ戻せる範囲が候補になります。目的は評価件数を増やすことではなく、現場の判断を再現可能な基準へ変換できるか確かめることです。検証では、正常例だけでなく、判断が割れる例、入力情報が不足した例、例外処理が必要な例も用意します。専門家同士の評価が一致しない場合、AIへ教える以前に社内基準が定まっていない可能性があります。その差を可視化できること自体が、評価基盤を導入する利点になり得ます。合格率のような単一指標だけに頼らず、見逃した重大事例、誤って問題扱いした事例、人による再確認が必要だった割合なども確認したいところです。
運用開始前には、評価基準の責任者、更新手続き、監査記録、個人情報や機密情報の扱いを定める必要があります。日本語特有の敬語、主語の省略、遠回しな表現が品質判定へ与える影響も検証対象になるでしょう。海外で得られた評価方法をそのまま持ち込むのではなく、日本語の顧客対応や社内慣行に合う例を専門家と共同で整えることが求められます。
Crux Labsが提示した方向性を評価する際は、「何件を自動評価できるか」だけで判断してはいけません。問題発見から基準の見直し、修正、再評価までの時間が短くなったか、専門家が全件確認から解放されたか、開発者との認識差が減ったかを小規模な検証で測るべきです。最初の一歩として、現在人が確認しているAI対話を一つ選び、熟練担当者が良否を判断するときの観点を言語化するとよいでしょう。その基準を複数人で照合すれば、自動化へ進む前に整えるべき組織上の課題も見えてきます。