

2026/11/14
AIニュース
Mirendilが10億ドルを調達、数百のAIエージェントでモデル開発の試行錯誤を自動化
この記事の要点
米MirendilがシリーズAで10億ドルを調達しました。同社のLorは数百のAIエージェントでモデル開発の実験や評価を自動化し、研究者1人による開発事例も示しています。企業が注目したいのは自動化率だけでなく、性能、計算費用、人による確認を含めた開発全体の効率です。
目次
10億ドルが向かう先は、AIを開発する工程の自動化
AIモデルの開発では、学習を一度実行すれば仕事が終わるわけではありません。条件を変えて学習し、結果を比べ、失敗の原因を調べる作業が続きます。この試行錯誤を数百のAIエージェントに分担させる仕組みを提供しているのが、米新興企業のMirendilです。同社はシリーズAで10億ドルを調達しました。今回のニュースの焦点は、資金の大きさに加え、研究者が担ってきた開発工程をどこまで自動化できるかにあります。
投資ラウンドは、米投資会社のKleiner PerkinsとClearlake Capitalが共同で主導し、Googleを含む複数の投資家が参加しました。シリーズAは一般に、事業の立ち上げ段階を経た企業が製品開発や事業拡大に向けて資金を集めるラウンドです。ただし、調達額そのものが、製品の性能や顧客企業での成果を保証するわけではありません。
Mirendilの取り組みを企業の視点から見ると、問われているのは「高性能なモデルを使えるか」だけではありません。「必要なモデルを開発し、改善する作業を、限られた研究人員でどこまで進められるか」という課題にも関わります。自動化が機能すれば、専門家が個別の実行作業に費やす時間を減らし、研究方針や評価基準の検討に振り向けられる可能性があります。
もっとも、研究者の作業時間が減ることと、開発費全体が下がることは別の問題です。自動で実験を増やせば、その分だけ計算資源を使う場合もあります。今回の資金調達は開発の自動化に対する投資として捉えつつ、事業上の価値は、成果の質と必要な費用を併せて判断する必要があるでしょう。
創業者の研究経験を、実験を回す仕組みに変えるLor
Mirendilは、Google DeepMindやAnthropicで研究経験を持つ2人が2025年に設立しました。Google DeepMindはGoogleのAI研究組織で、Anthropicは生成AIを開発する企業です。最高経営責任者のBehnam Neyshabur氏は、学習した条件以外でもモデルが能力を発揮しやすくするためのアルゴリズム「SAM」の共同考案者です。最高技術責任者のHarsh Mehta氏は、両組織で事前学習に関するプロジェクトに携わっていました。
事前学習とは、AIモデルが大量のデータから基本的な能力を獲得する、開発初期の工程を指します。完成したモデルに指示を出す利用段階とは異なり、データや学習方法、モデルの構造をどう組み合わせるかが結果を左右します。創業者の経歴は、Mirendilがこうした研究現場の作業を製品化の対象にしていることを理解する手掛かりになります。
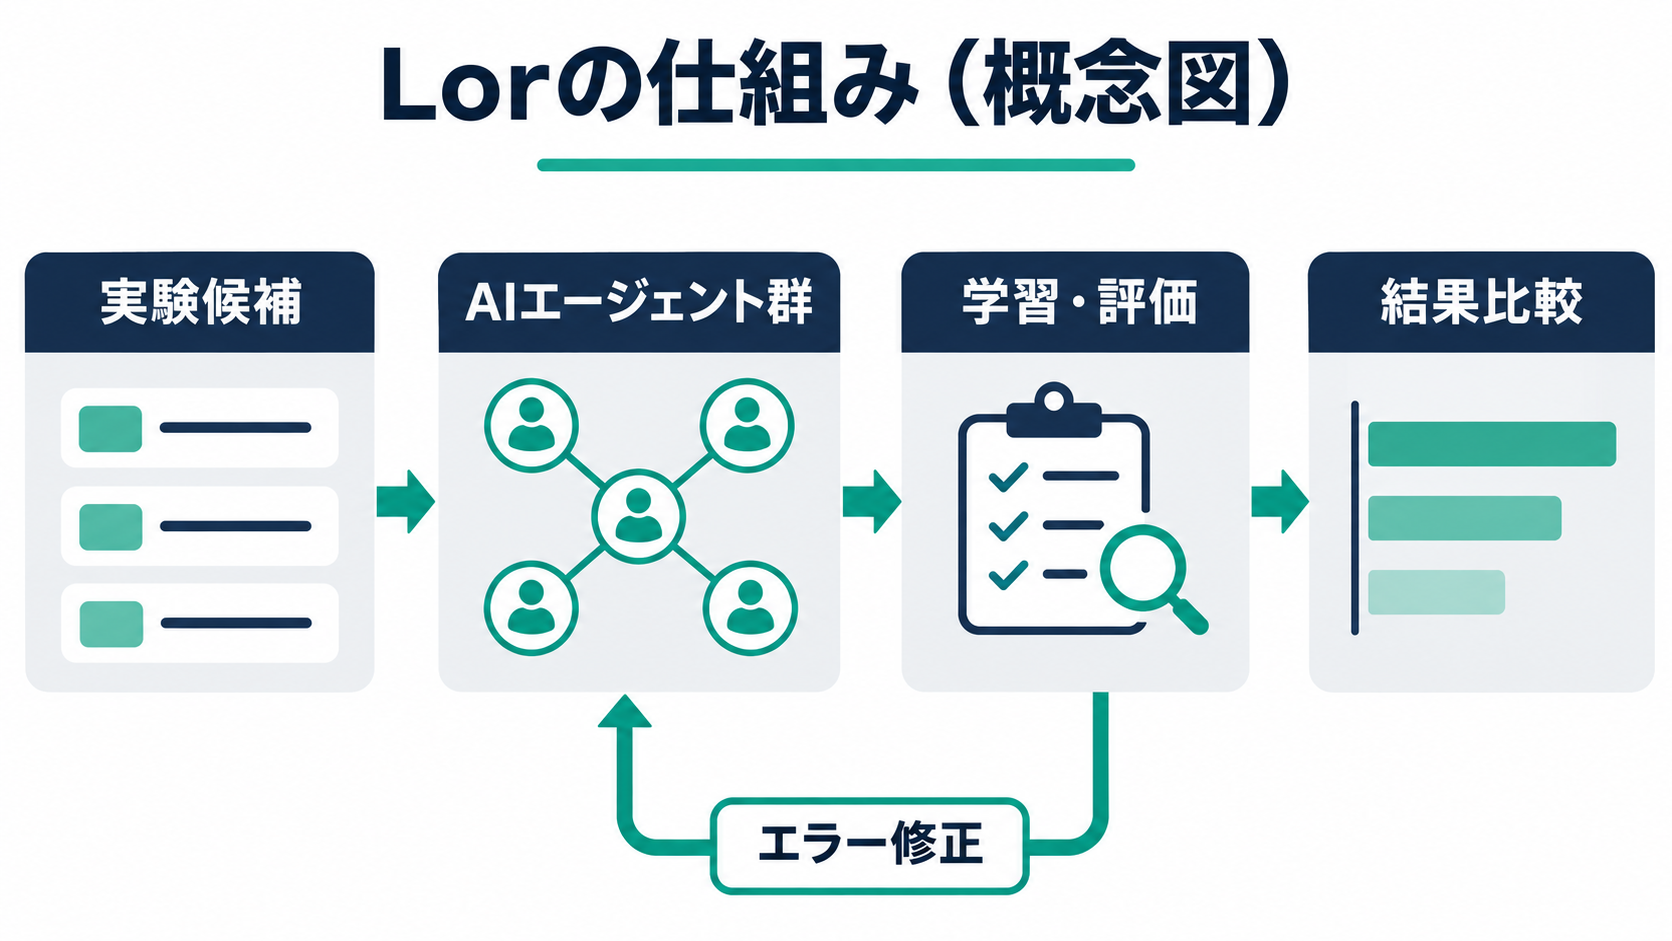
最初の製品であるLorは、モデルの学習実行に関わる多くの作業を自動化するプラットフォームです。同社によると、数百のAIエージェントに仕事を分担させます。ここでいうエージェントは、担当する作業を与えられ、処理を進めるソフトウェア上の実行主体として捉えると分かりやすいでしょう。
大規模言語モデル、いわゆるLLMの開発では、アルゴリズムを少しずつ変えた複数の候補を作り、性能を比較します。Mirendilは、Lorがこの流れを自動化し、評価中にエラーが起きた場合には修正も行うと説明しています。注目点は、コードの一部を生成するだけでなく、実験を実行して結果を確かめる工程まで対象にしている点です。ただし、エラーを修正できることと、研究上の仮説や評価方法が適切であることは同じではありません。人が判断すべき範囲を見極める必要は残ります。
研究者1人、約3.5カ月の開発事例をどう読むか
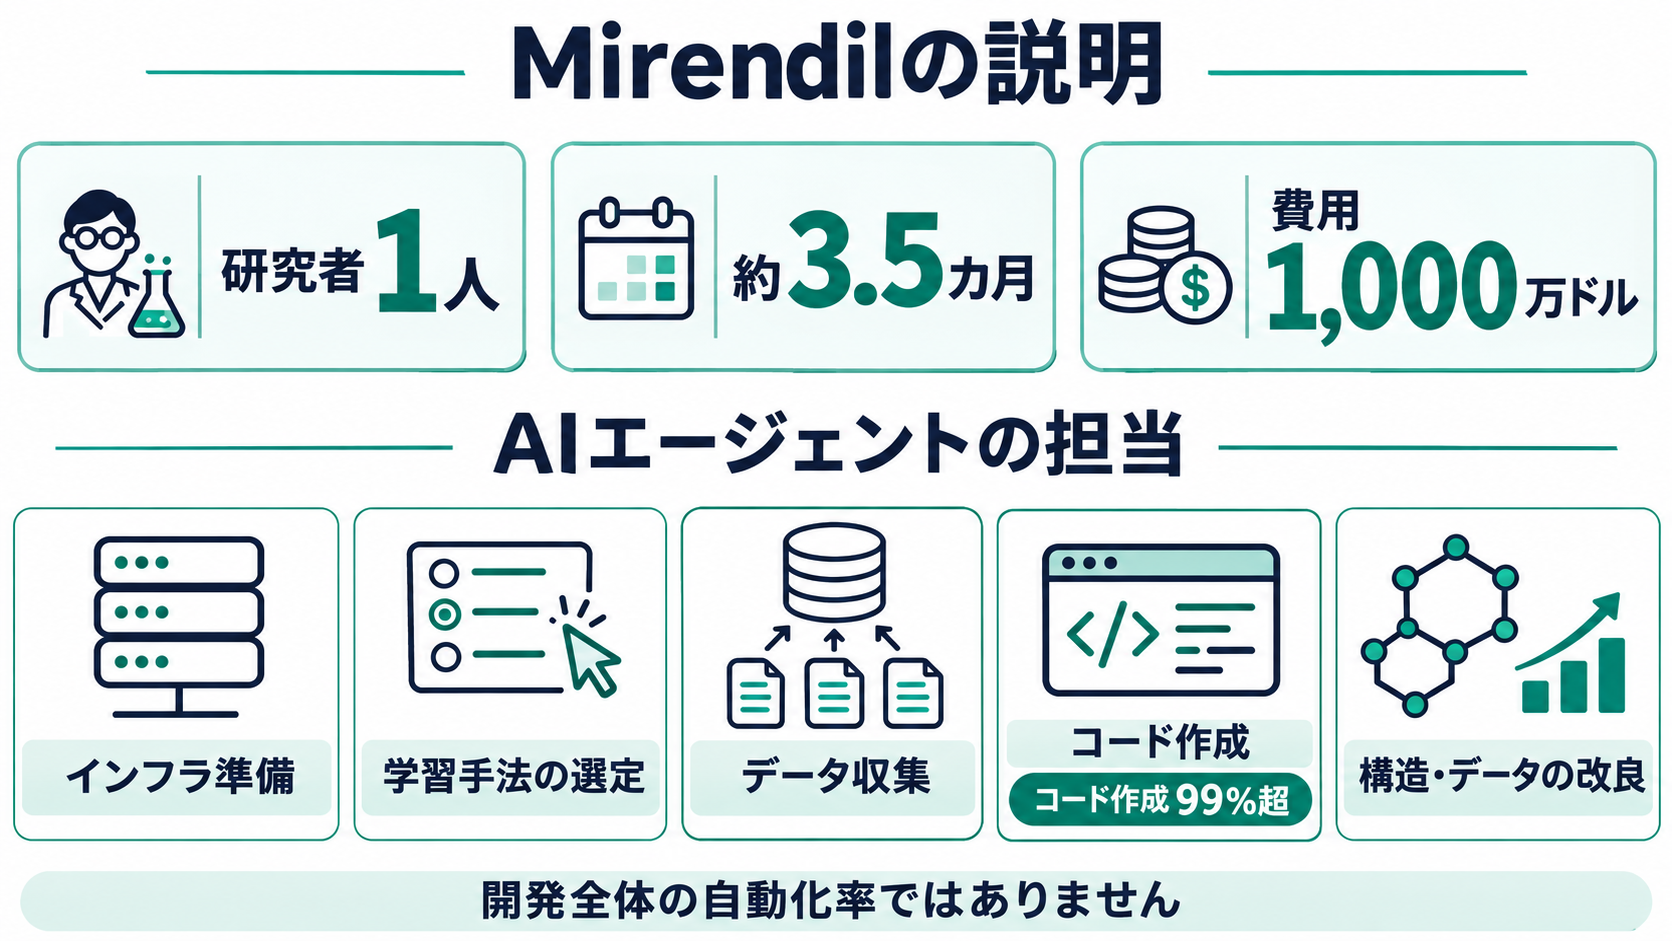
Mirendilは2026年、主要なオープンソースLLMと競合できるコード生成モデルの開発を、研究者1人に任せました。同社の説明では、自動化技術によって、その研究者は同僚の支援を受けずにモデルを構築できたとしています。開発したモデルの名称はMirendil-Baseです。プロジェクトには約3.5カ月を要し、費用は1,000万ドルでした。
AIエージェントが担当した範囲も広く、同社によると、モデルを支えるコードの99%超を作成しました。インフラの準備、適切な学習アルゴリズムの選定、ウェブからの学習データ収集も担ったとしています。その後、出力品質を高めるため、学習データセットとモデルの構造の双方に改良を加えました。
この事例で読み違えたくないのは、「研究者1人」という人数の意味です。人の担当者が1人でも、計算資源やソフトウェア基盤が不要になるわけではありません。実際に1,000万ドルの費用がかかっており、個人が手軽に再現できる開発だったとは受け取れません。また、コードの99%超を生成したという数字は、研究上の意思決定や開発責任の99%超を自動化したことまで示してはいません。
企業が参考にするなら、人員数だけでなく、同じ目標を従来の体制で達成する場合との違いを確認したいところです。比較対象には、開発期間、総費用、達成した性能、研究者による監督の負担が含まれます。Mirendilの説明は少人数で開発を進められる可能性を示しますが、主要モデルとの競争力を判断するには、共通条件での性能評価も必要でしょう。自社の投資判断では、華やかな自動化率よりも、一定の品質に到達するまでに必要な資源を重視するのが実務的です。
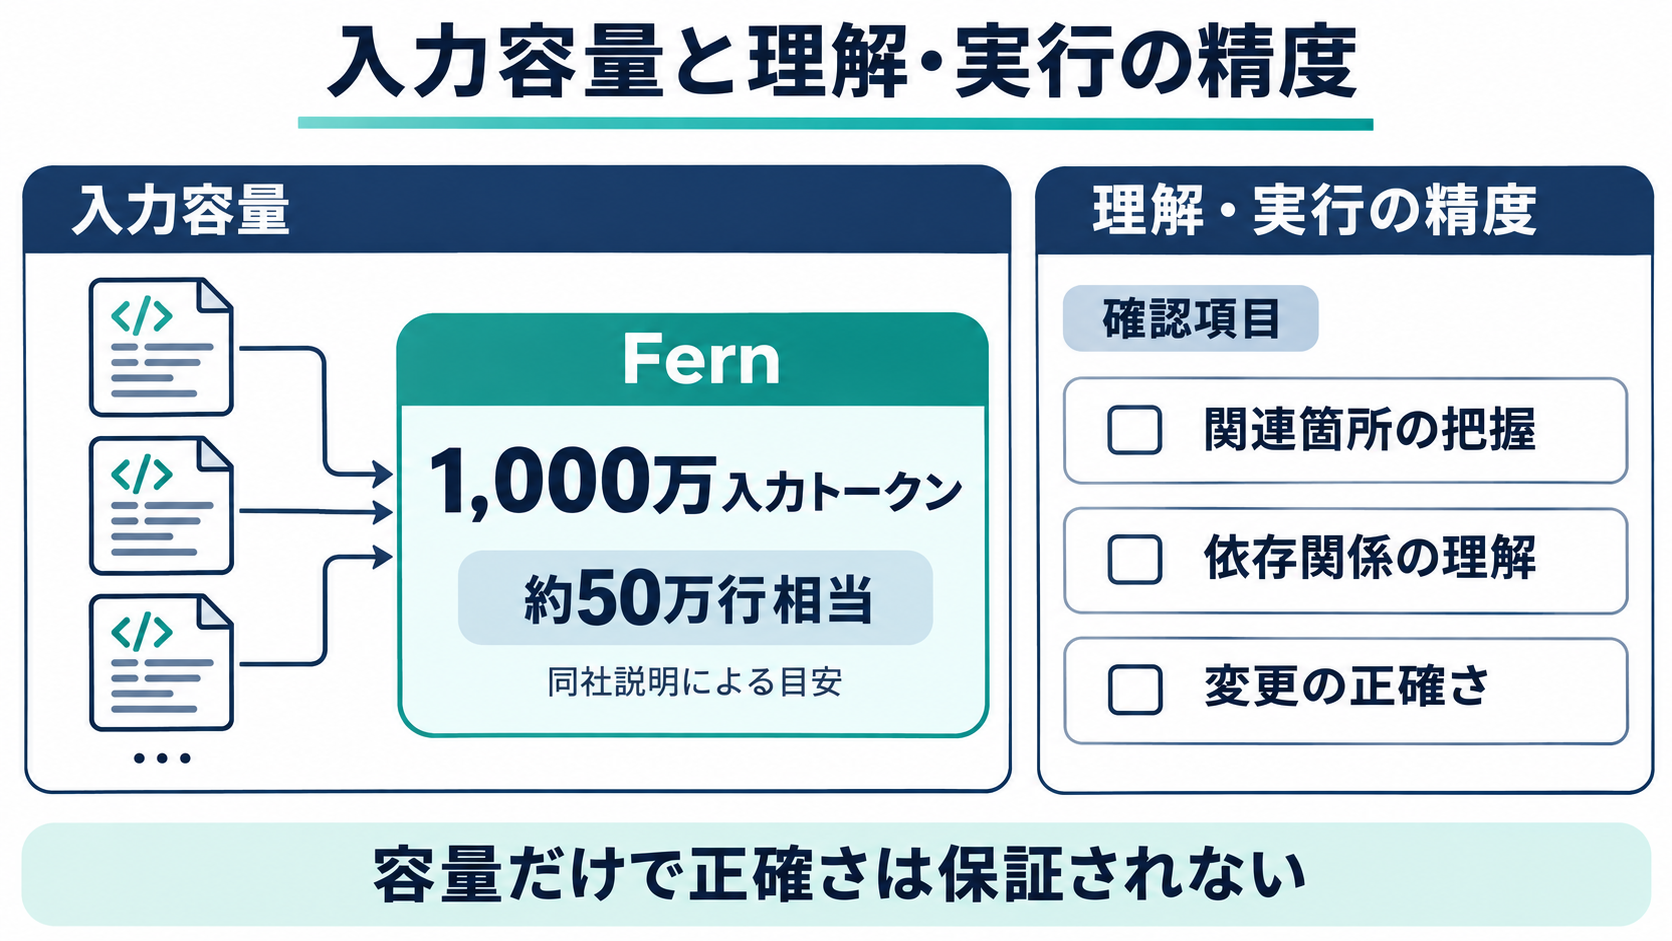
Fernの1,000万トークンは、コードを広く見渡すための容量
Mirendilは2026年10月、Mirendil-Baseを基盤とするコード生成特化モデル「Fern」を公開しました。想定しているのは、AI研究所で日常的に発生するプログラミング上の課題の自動化です。一般的な業務文書の作成よりも、AI開発そのものを支える作業に焦点を当てた製品と理解できます。
同社によると、Fernは1回のプロンプトで1,000万入力トークンを処理でき、コード約50万行に相当します。トークンは、モデルが文章やコードを処理するときに用いる単位です。単語や文字、コードの行と一対一に対応するものではないため、約50万行という換算は規模感をつかむための目安として読む必要があります。
入力できる量が多ければ、関連するコードや設定情報をまとめてモデルに渡しやすくなります。例えば、複数のファイルにまたがる変更を検討する場面では、対象の関数だけでなく、その呼び出し元やテストも参照する必要があります。こうした情報を一度に扱えることには、開発支援の使い方を広げる余地があるでしょう。
ただし、受け付けられる情報量と、その情報を正確に使える能力は分けて評価しなければなりません。入力が大きくても、必要な箇所を見落としたり、コード同士の依存関係を誤って解釈したりすれば、期待した成果にはつながりません。Fernを検討する企業には、最大入力容量の確認に加え、自社の実際のコードで変更案が正しいか、検証にどれだけ時間がかかるかを測る視点が求められます。入力上限は扱える仕事の範囲を考える材料になりますが、仕事を完了できるかどうかは別途確かめる必要があります。
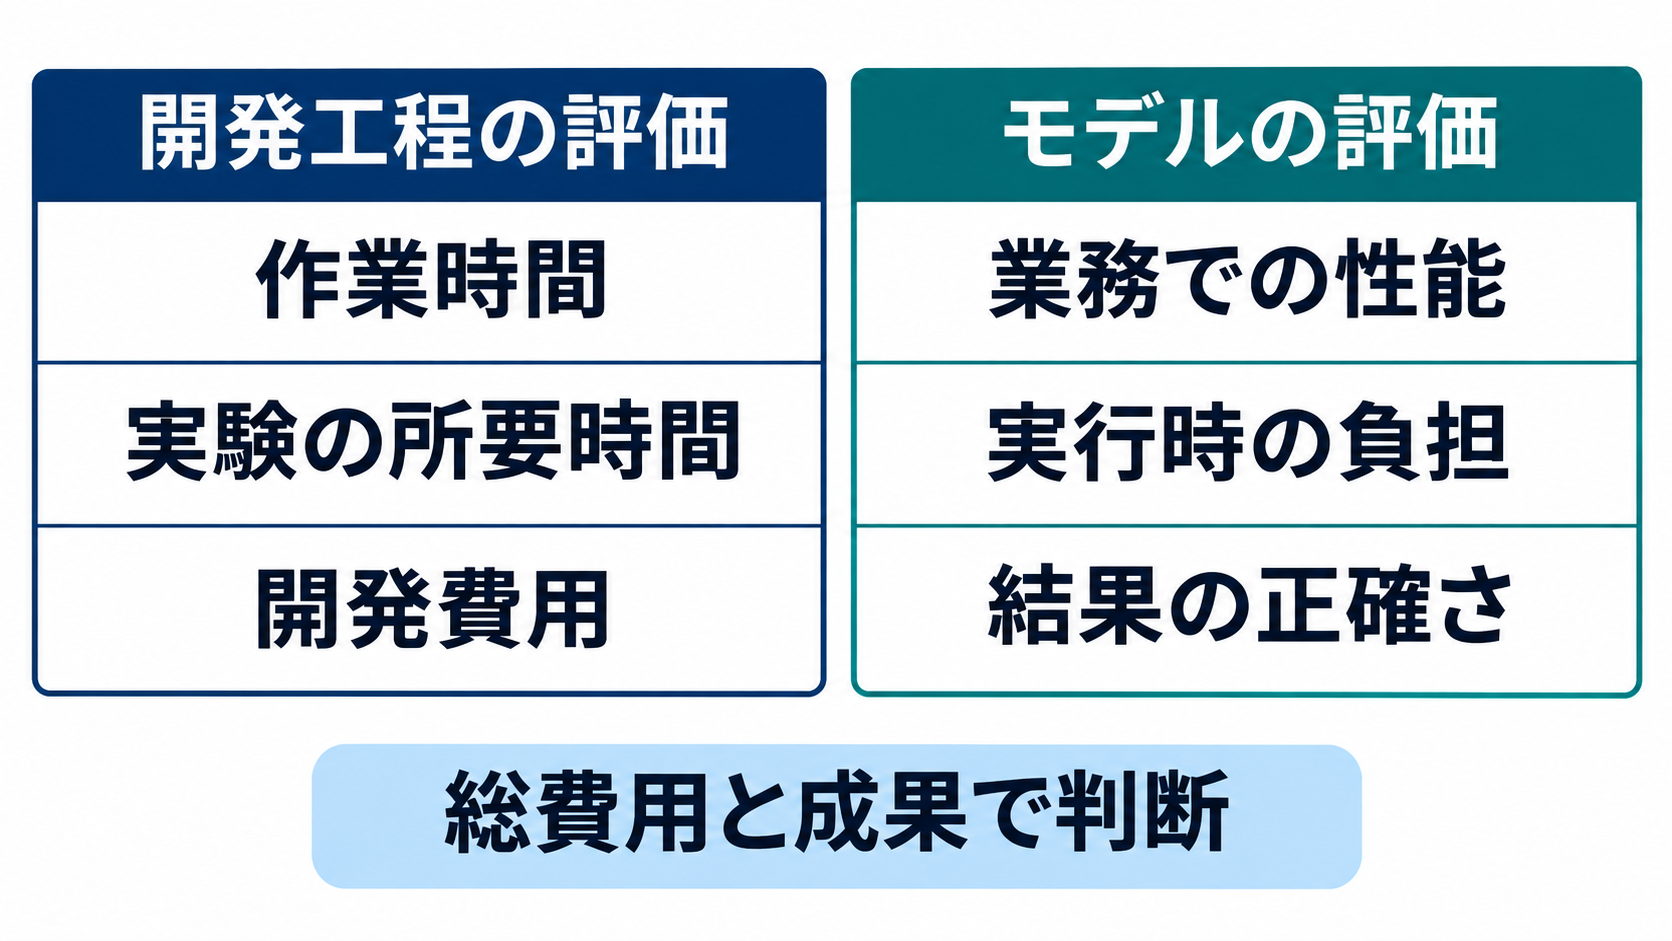
モデルの大型化と開発自動化は、別々に評価する
Fernの基盤には、パラメータ数が1,000億から5,000億の範囲にあるMirendil-Baseの一バージョンが使われています。パラメータとは、モデルが学習によって調整する内部の値です。モデルの規模を表す代表的な指標ですが、その数だけで実用上の優劣を決めることはできません。データの質や学習方法、対象とする課題も結果に影響します。
Mirendilは2026年10月下旬、Mirendil-Baseの改良版2種類を予告しました。これらのパラメータ数は5,000億から10兆の範囲にあり、同社は、より高性能なLLMの開発に活用する計画です。現在示されている範囲には幅があり、単一の規模のモデルとして理解すると、製品構成を取り違えるおそれがあります。
ここでは、モデルを大きくする取り組みと、モデルを開発する作業を自動化する取り組みを分けて見ると整理しやすくなります。前者で確認したいのは、対象業務での性能や実行時の負担です。後者では、同じ研究目標に向けて、人の作業時間や実験の所要時間をどこまで減らせるかが評価の中心になります。
事業への影響を考えると、開発自動化が進んでも、計算資源への依存が同じ割合で小さくなるとは限りません。短時間で多くの候補を試せるようになれば、実験の総数が増える可能性もあるためです。これはMirendilの費用が増えると断定するものではなく、自動化技術を評価する際の一般的な論点です。企業には、実験を速く回す能力と、限られた予算内で有効な結果を得る能力の両方を見る姿勢が必要でしょう。処理した実験の数だけを成果にすると、自動化の価値を過大に評価しかねません。
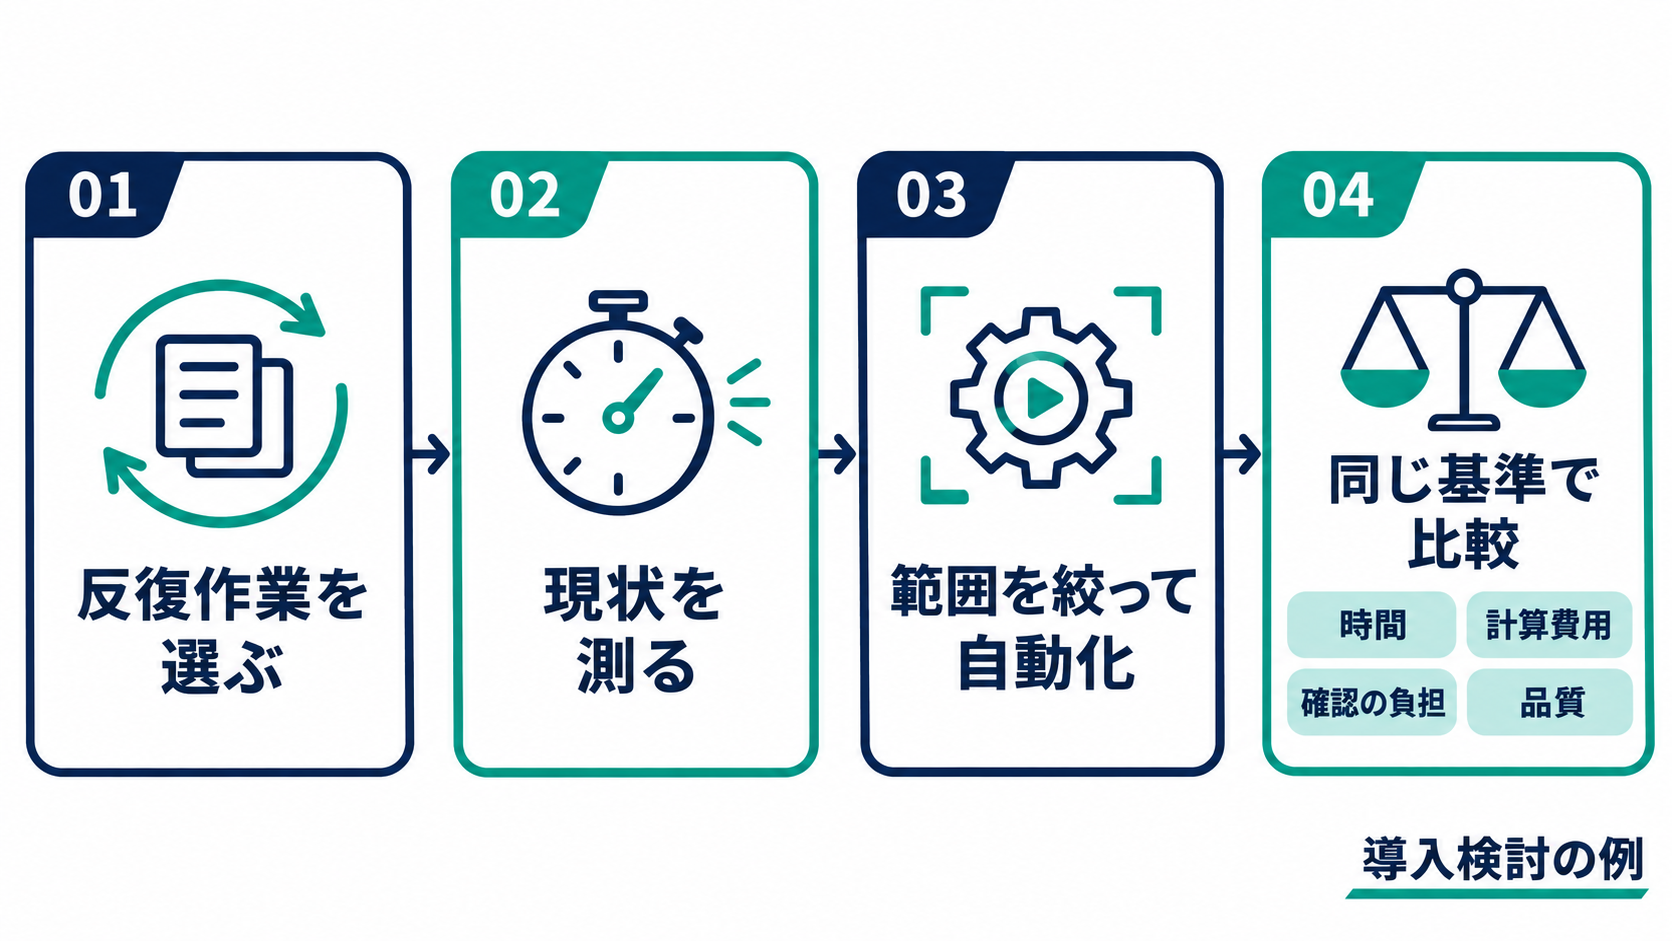
日本企業は、研究工程のどこを任せるかから考える
日本企業にとって、Mirendilのニュースが直ちに大規模な基盤モデルの独自開発を勧める材料になるわけではありません。むしろ参考になるのは、モデル開発を細かな作業に分け、繰り返しが多い工程を自動化の対象にする考え方です。モデルの改良に取り組む組織であれば、学習条件の比較、評価の実行、失敗した処理の調査など、研究者の時間を使っている箇所を洗い出すところから始められます。
導入を検討する場合、研究方針の決定から実行までを一度に任せるよりも、結果を確かめやすい工程を選ぶ方が評価しやすいでしょう。例えば、既に使っている評価手順の実行と結果の整理を対象にすれば、人が行った場合と比べる基準を用意できます。これはLorに特定の機能があると示すものではなく、開発自動化を検証する際の進め方です。
検証時には、作業時間だけでなく、計算費用と人による確認の負担も記録したいところです。自動生成した修正が多くても、その確認に長時間を要するなら、工程全体の短縮効果は小さくなります。また、学習データを収集する工程を任せる場合には、利用条件や機密情報の扱いを確認する必要があります。自動化によって作業の実行者が変わっても、企業側の管理責任がなくなるわけではありません。
今回の発表から読み取れるのは、AIエージェントの活用対象が、完成したモデルを使う業務に加え、モデルを作る作業にも広がっていることです。ただし、自社に適した自動化の範囲は、研究目標や予算、扱うデータによって異なります。検討を始める企業は、直近の開発案件で手作業を繰り返した工程を一つ選び、所要時間、費用、合格条件を記録してみてください。その基準があれば、自動化によって何が改善したかを具体的に判断できます。