
2026/11/03
AIニュース
Gitはそのまま、サーバーを作り替える――OpenAI「Pando」がAI開発の並列化を支える仕組み
目次
開発者の操作を変えずに入れ替えたGit基盤
開発者が普段どおりにgit pushを実行すると、その裏側ではOpenAIが新たに構築したGitバックエンド「Pando」が処理を引き受けます。git fetchを使う場面も変わりません。Pandoが置き換えたのはクライアントや通信プロトコルではなく、OpenAIのモノレポを支えるサーバー部分です。エンジニアだけでなく、コード生成や修正を行うCodexエージェントも、従来と同じGitの操作を続けられます。
OpenAIによると、Pandoの導入後はpushの中央値が約80%短縮されました。単純計算では従来のおよそ5分の1に相当します。現在は1日当たり約1PBのGitデータを配信し、OpenAIのモノレポにおけるすべての開発を支える基盤になっています。大規模な性能改善でありながら、利用者が新しいバージョン管理システムや独自コマンドを覚える必要はありません。
企業の開発基盤という観点では、この互換性がPandoの重要な特徴です。処理能力を高めるために開発者の操作や周辺ツールまで変更すると、移行教育やCI設定の修正、障害時の切り分けといった負担が膨らみます。Pandoは使い慣れたGitを境界面として残し、負荷が集中するサーバー内部だけを再設計しました。新しい仕組みを導入する際に、どこを変え、どこを維持するかという判断の好例と考えられます。
名称にあるモノレポとは、多数のサービスやライブラリを一つのリポジトリで管理する方式です。コードの共有や横断的な変更には便利ですが、参加者と自動処理が増えるほど、pushやfetchが同じ基盤へ集中します。Pandoが解決しようとしたのは、Gitという道具そのものの限界ではなく、AIエージェントが並列に働く環境でGitデータをどう配信するかという問題でした。
Codexの並列作業が変えた負荷の形
Pandoが必要になった背景には、Codexによる開発作業の並列化があります。OpenAIが示した集計では、2026年第3四半期にmasterブランチへ取り込まれたコミット数が、2024年第1四半期と比べて1,378%増えました。2026年第4四半期の推計値は2,442%増です。人間の開発者数だけでは説明しにくい速度で変更が積み上がり、Gitサーバーが処理する要求の密度も変わりました。
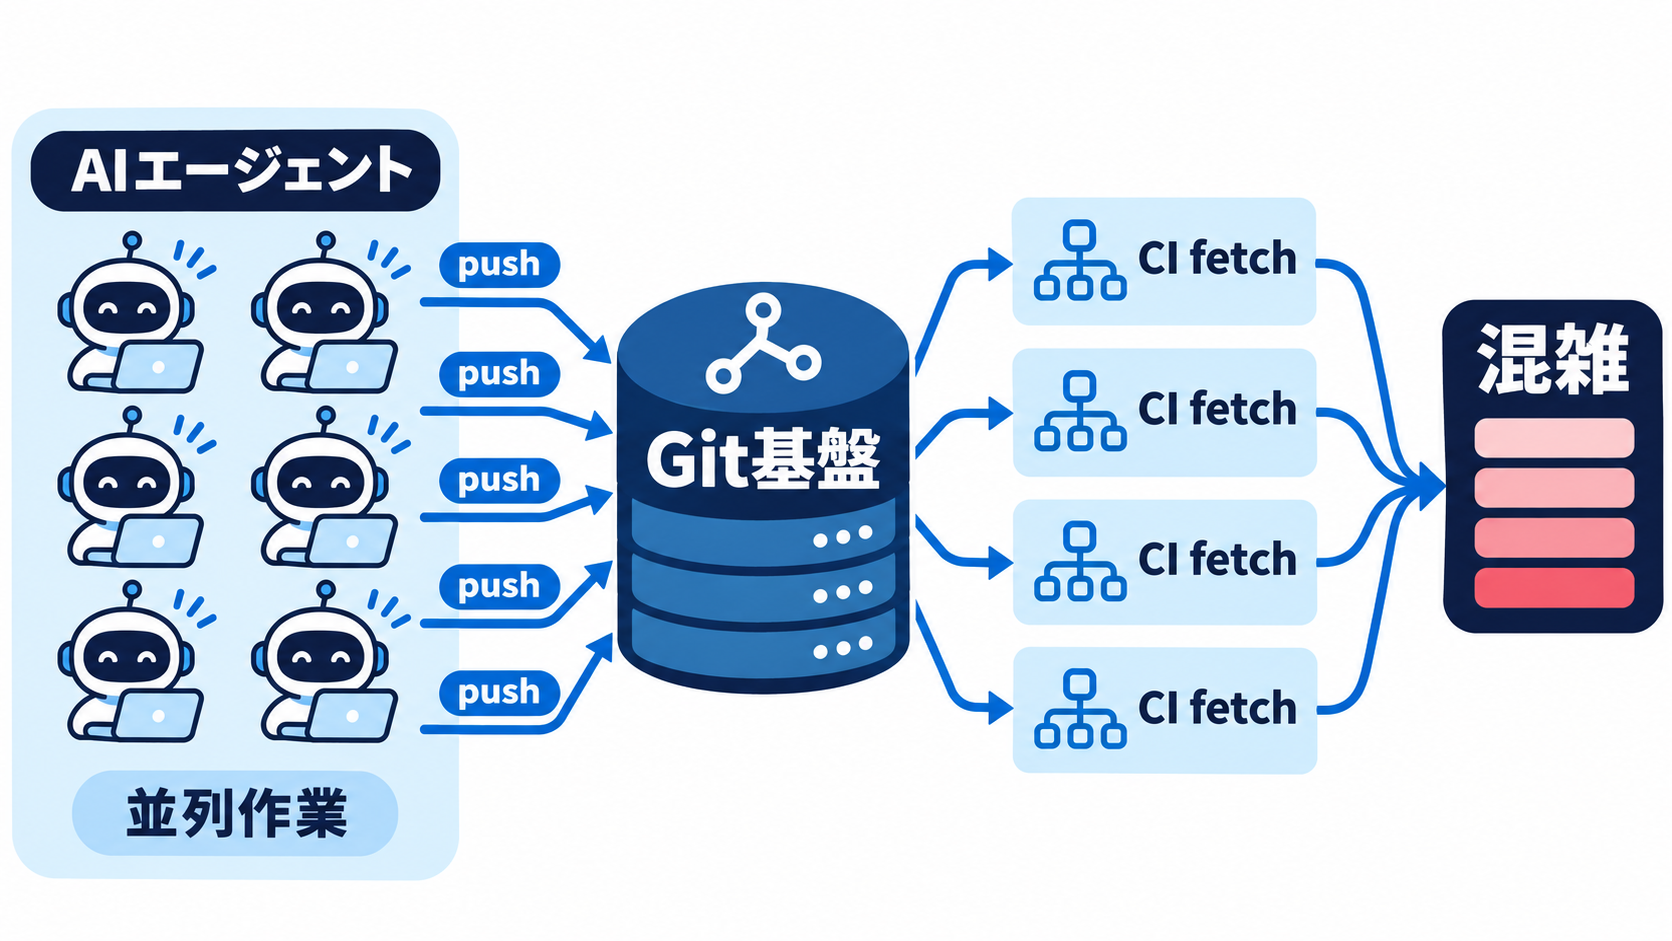
負荷を押し上げるのはコミット数だけではありません。一度のpushをきっかけに、継続的インテグレーション、いわゆるCIを担う多数の実行環境が新しいコードをfetchします。作業主体が並列化すると、書き込みと読み出しが短時間に集中しやすくなります。2025年後半にはfetchとpushが遅くなり、マージが失敗する事象も発生しました。信頼性が一時90%を下回ったこともあったとOpenAIは説明しています。
ここで注目したいのは、同社がGitの廃止ではなく、Gitを提供する仕組みをボトルネックと判断した点です。AIエージェントが生成する変更も、最終的にはブランチ、コミット、参照情報という既存のGitモデルで表現できます。問題は、多数の独立した作業が同時に進むのに、サーバー側がリポジトリ全体を一つの順序で処理しようとしていたことでした。
従来の開発基盤では、平均的な負荷に耐えられるだけでは足りない場面があります。多くのエージェントが同時に仕事を終えれば、pushがまとまって到着し、その直後にCIのfetchが広がるからです。Pandoは、AIでコードを速く作ることだけでなく、その成果を受け止めるバージョン管理、テスト、配信の各層も並列化に合わせて見直す必要があると示しています。
リポジトリ全体ではなくブランチ単位で守る整合性
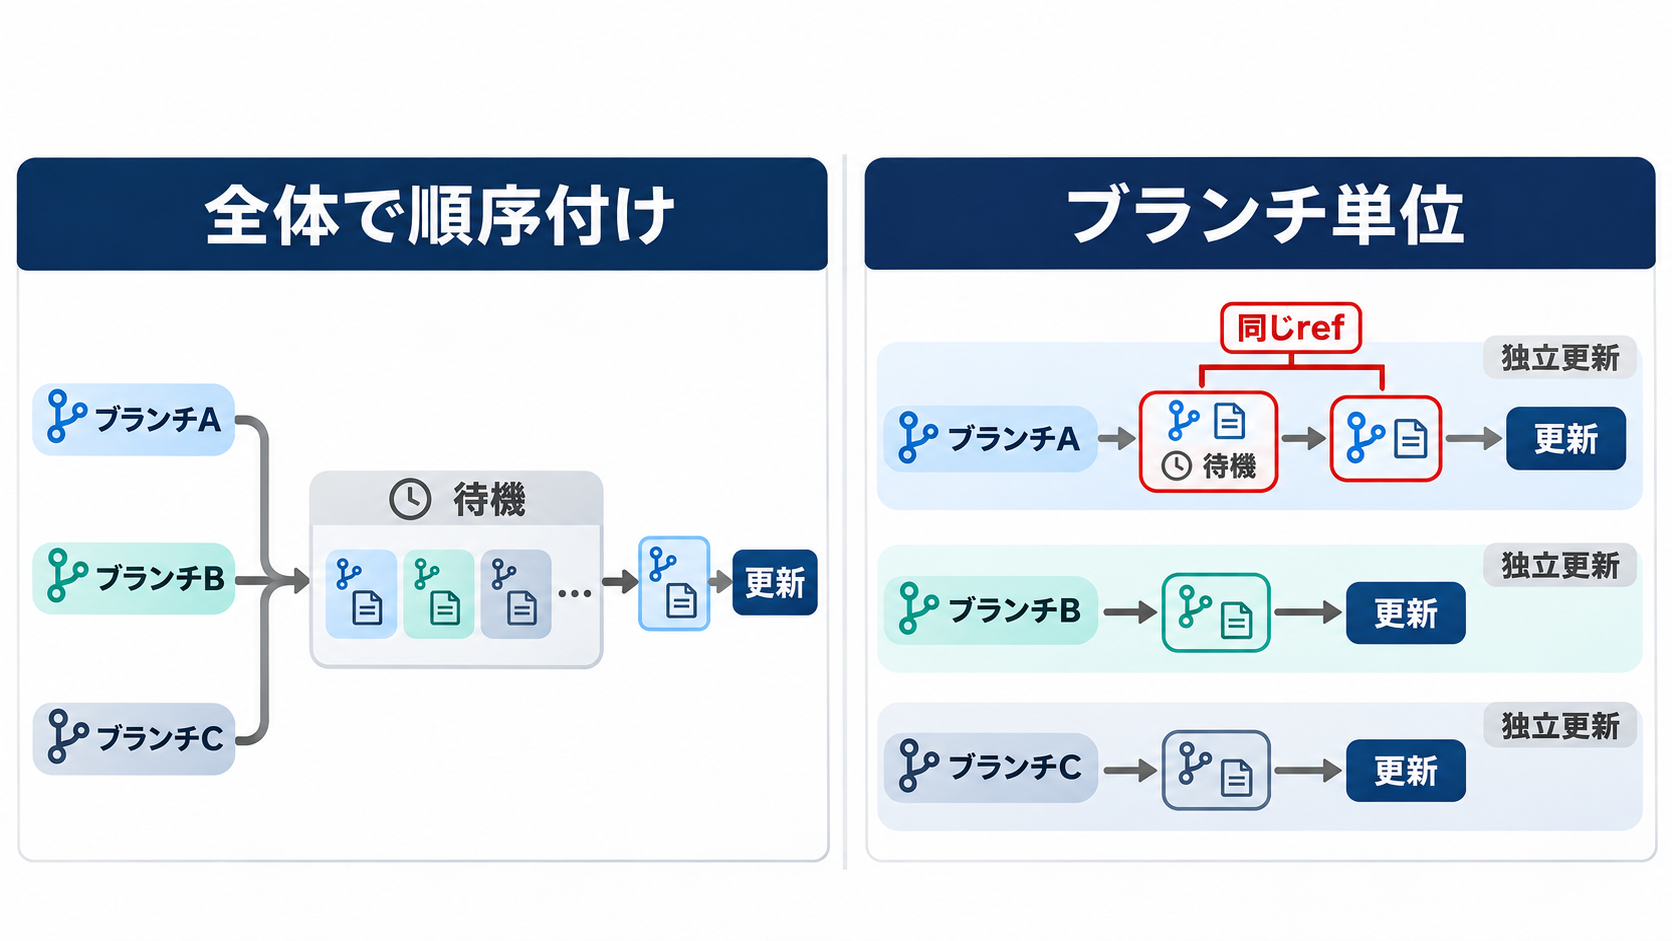
一般的なGitサーバーは、参照情報であるrefの更新をリポジトリ全体で順序付けます。refはブランチ名がどのコミットを指しているかを示す情報です。この方式は全体の状態を理解しやすい反面、互いに無関係なブランチへのpushまで同じ調整処理を待つことがあります。多数のエージェントが別々の機能ブランチを更新する環境では、その待ち時間が書き込み性能を制限しかねません。
Pandoはリポジトリ全体の一貫した順序を必須とせず、因果整合性を採用しました。それぞれのブランチは個別に直列化され、同じrefへpushするクライアント同士だけが競合します。ブランチAへの更新が、関係のないブランチBへの更新を止めない設計です。OpenAIのテストでは、数千の書き込み主体が同時にpushしても性能低下が生じなかったと報告されています。
性能と引き換えになる点もあります。複数のブランチを同時に読み取った利用者は、それぞれを異なる時点の状態として目にする可能性があります。リポジトリ全体を単一時点で切り取ったスナップショットは提供されません。同じブランチ内の更新順序は守られても、複数ブランチを横断した見え方までは揃えないという境界です。
この判断が成立するかどうかは、組織のワークフローに左右されます。独立した機能ブランチで変更を進め、統合時に競合を解決する開発では、リポジトリ全体の強い整合性が常に必要とは限りません。反対に、複数ブランチを同一時点の組として扱う処理があるなら注意が必要でしょう。Pandoの設計から得られる要点は、整合性を弱めれば速くなるという単純な話ではなく、業務上守るべき単位をブランチまで狭めたことにあります。
使い捨てのpack生成を再利用可能なデータへ転換
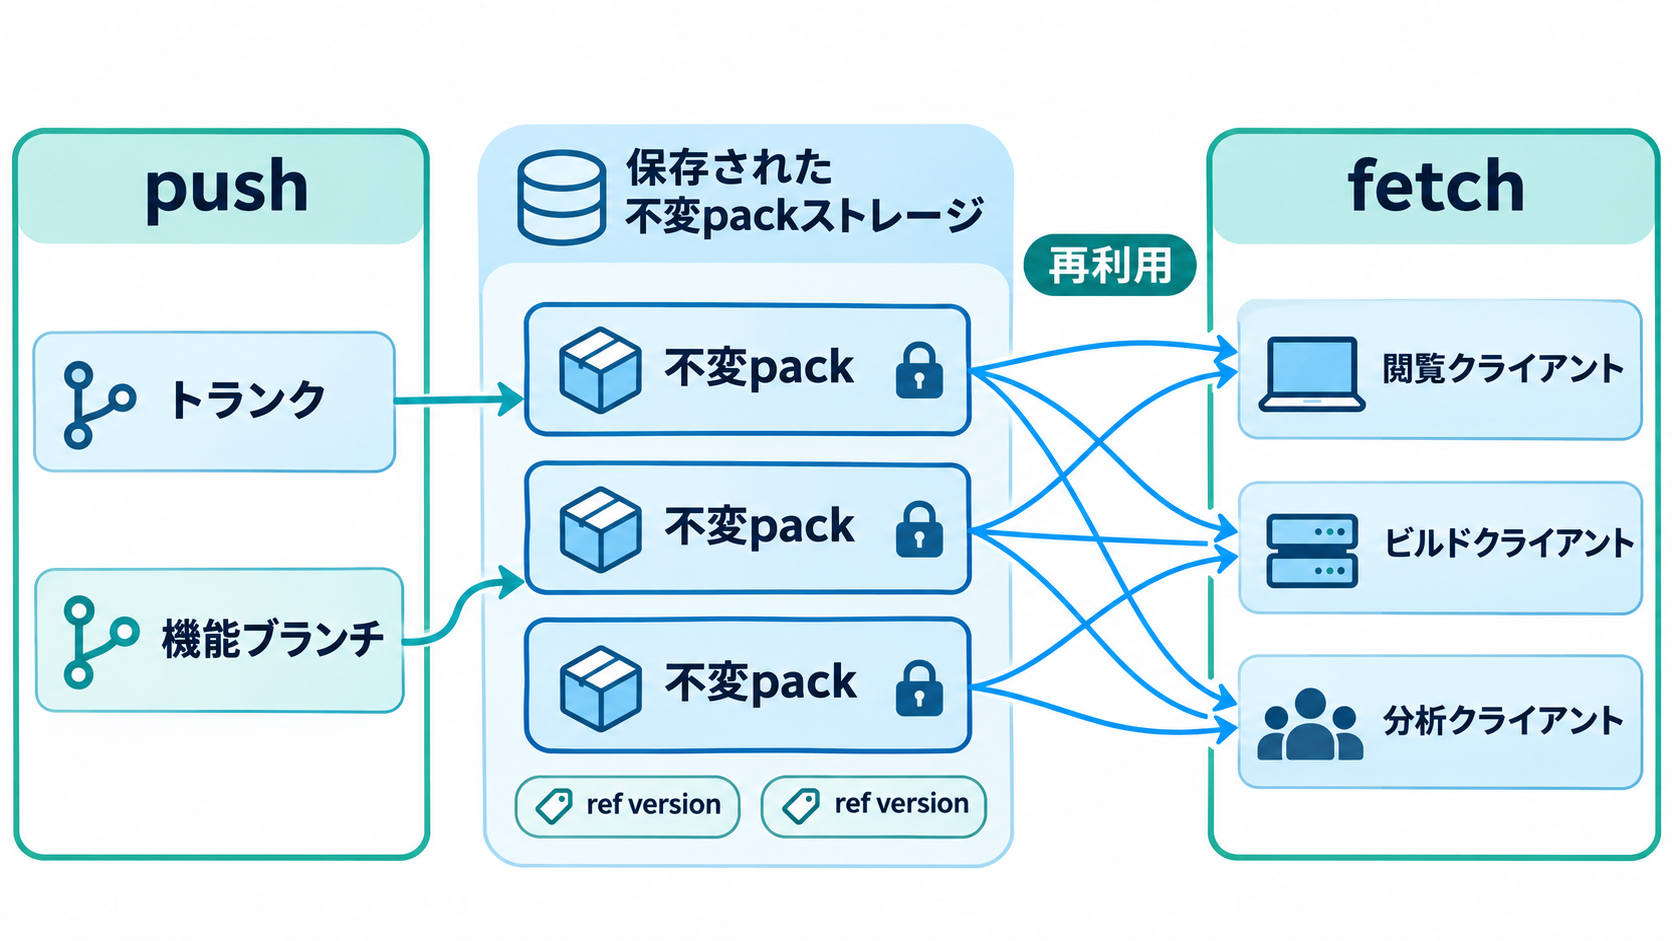
Gitは多数のオブジェクトを効率よく転送するため、圧縮されたpackfileを使います。従来型のサーバーでは、クライアントからfetchを受けるたびに、そのクライアントが不足している履歴に合わせたpackを新しく組み立てることがあります。要求ごとに最適化できる半面、読み出しが集中するとpack生成の計算負荷も繰り返し発生します。
Pandoはpushされたpackを変更されないblobとして保存し、再利用します。ブランチの更新状態は「ref version」としてスケール可能なメタデータストアへ記録されます。OpenAIの説明では、pushに必要なメタデータの読み書きはO(1)、fetchは埋めるべきref versionの差をΔとした場合にO(log Δ)です。データ本体と小さな更新情報を分けることで、要求ごとに大きなpackを作り直す処理を避けています。
数百万のブランチを持つ環境では、サーバーがすべてのrefをクライアントへ通知するだけで100MiBを超える場合があります。Pandoは新しい機能ブランチをpushするとき、基準としてトランクブランチだけを通知します。トランクの履歴を持つ読み手であれば、保存済みの一つのpackから対象ブランチを取得できる設計です。OpenAIのモノレポでは、packサイズの中央値が20KiB未満だったとされています。
ただし、トランクに含まれない履歴を持つ同じブランチを繰り返しpushする場合や、複数のブランチを積み重ねる運用では、トランク外のデータを再送します。OpenAIが示した99パーセンタイルのpackサイズは3MiB未満ですが、転送の重複自体がなくなるわけではありません。Pandoはあらゆる履歴構造を最小化するのではなく、トランクを共有して多数の短い機能ブランチを動かす中心的なパターンへ狙いを定めています。
キャッシュ配信と段階的なpack統合
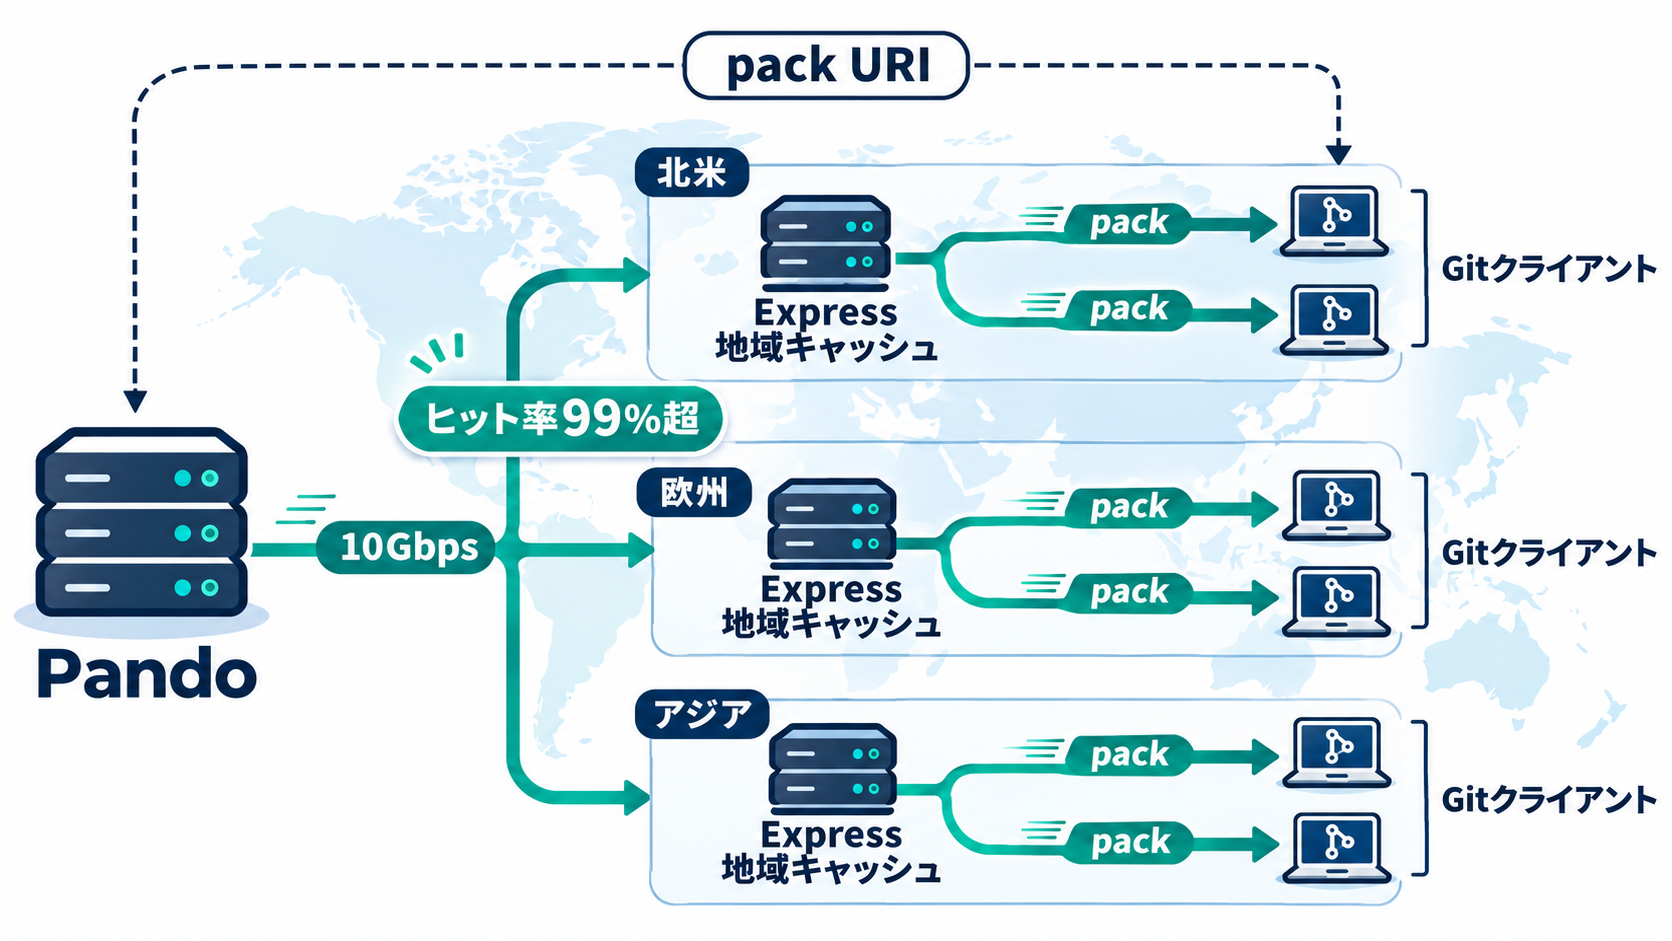
fetchの応答では、Gitにすでに備わるpackfile-uriという機能が使われます。Pandoは通常の応答に空のpackを入れ、実データについてはダウンロード先を返します。クライアントは提示された場所から保存済みpackを取得するため、Gitサーバーが毎回データを中継したり、要求ごとにpackを生成したりする必要がありません。互換プロトコルの拡張点を利用し、重い配信処理を分離した構成です。
実際のpack配信は「Express」と呼ばれるサービスが担います。Expressはコンシステントハッシュを使ってpackを地域ごとにキャッシュし、OpenAIの報告ではキャッシュヒット率が99%を超えています。標準的なクラウドVMでも、cloneやfetchの際に10Gbpsのネットワーク帯域を使い切る速度へ達したといいます。サーバー側の計算処理ではなく、回線速度が上限になり得る状態です。
保存するpackが増え続ければ、fetch時に多数の小さなファイルを選ばなければなりません。Pandoでは各pushのpackをL0として受け取り、バックグラウンド処理が複数のpackを幾何級数的に大きな「cover」へまとめます。これはデータベースで使われるLSM-treeのコンパクションに似た考え方です。現在のモノレポではL4までのcoverが使われ、スキップリストのように必要なpackを対数時間で選べます。
書き込み時には小さく不変なデータを素早く受け入れ、読み出しやすい形への整理を後段へ回す構成だと理解できます。キャッシュしやすい不変データと、更新頻度の高いメタデータを分離した点も効いています。企業システムへ応用するなら、すべての処理を同期的に完了させるのではなく、利用者が待つ経路と後から統合できる処理を切り分けられるかが検討材料になるでしょう。
数字から読む成果と評価時の注意点
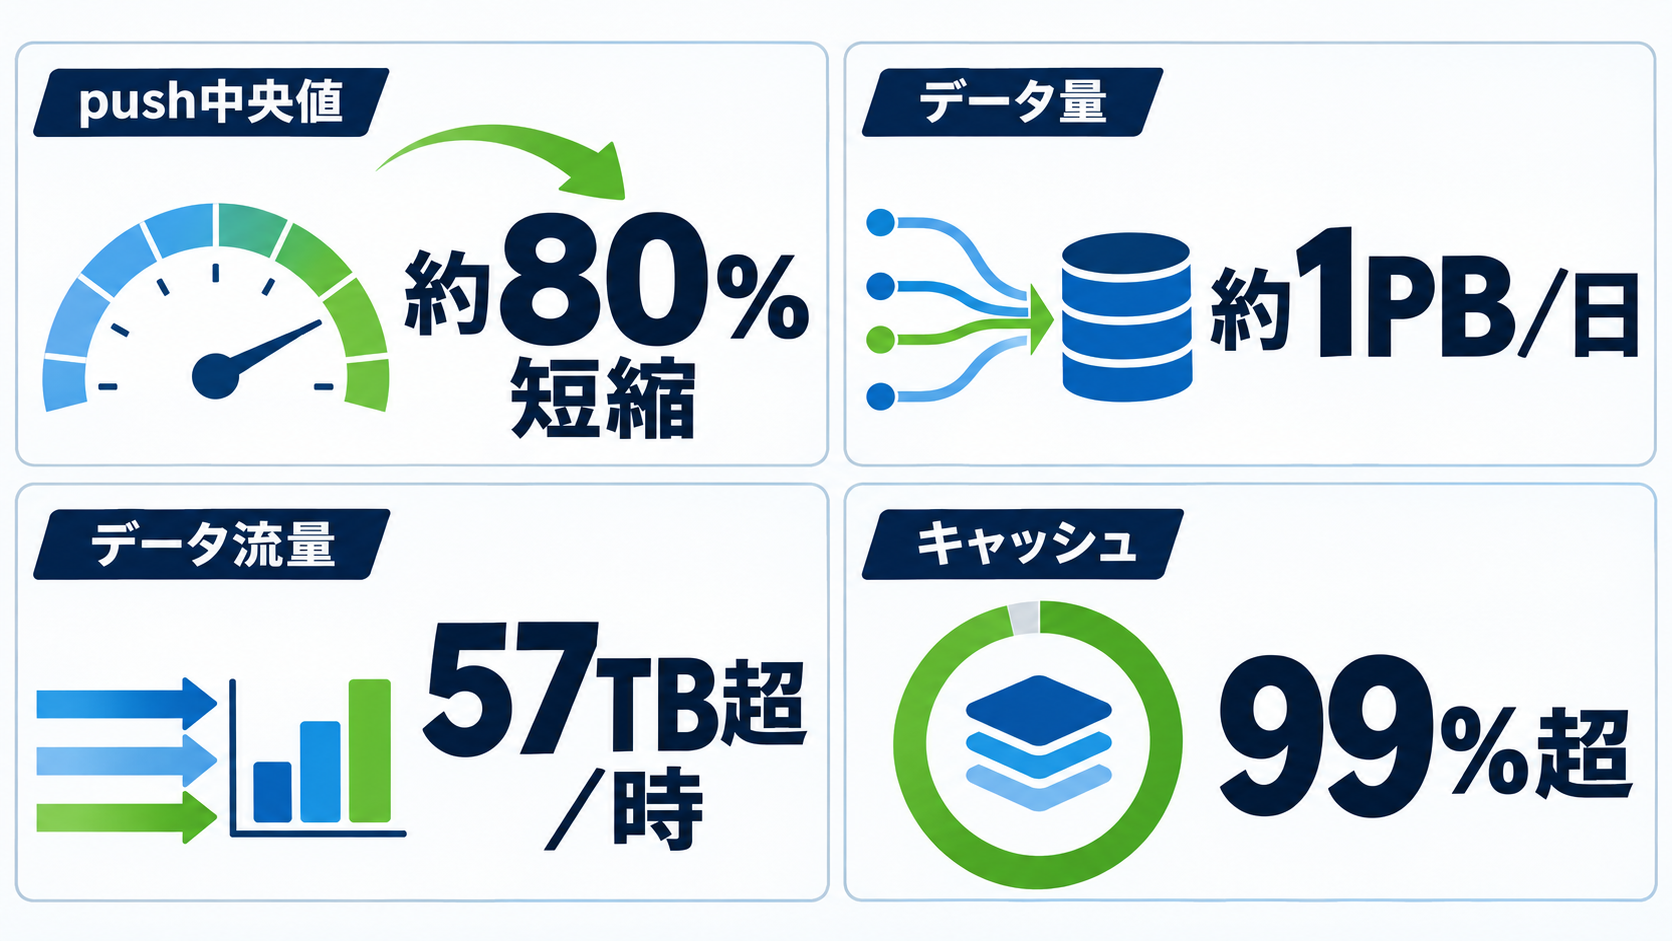
OpenAIが公表した代表的な成果は、push待ち時間の中央値が約80%短くなったことです。Pandoは1日当たり約1PBのGitデータを扱い、1時間では57TBを超えるpackを配信した実績があります。その時間帯に配信されたデータの99%超はローカルディスクキャッシュから提供されました。処理に使うCPUは少数のコアにとどまり、cloneとfetchは標準的なクラウドVMの10Gbps回線を飽和させたと報告されています。
これらの数字は、Pandoが単にpushの受付を高速化しただけではなく、その後に発生する大規模な読み出しまで含めて設計されたことを示します。中央値の改善は日常的な操作感を捉え、ピーク時の配信量やキャッシュヒット率はCIを含む読み出し経路の余力を映します。異なる指標を組み合わせているため、平均値だけでは見えにくい基盤全体の挙動を追いやすくなっています。
評価には留保が必要です。数値はすべてOpenAI自身による測定であり、独立したベンチマークはまだ示されていません。同社は1,000の書き込み主体を使い、三相コミット方式や先行書き込みログ方式とのシミュレーションも実施しましたが、これらを性能比較ではなく学習用モデルと位置付けています。環境やワークロードが異なるシステムへ、改善率をそのまま当てはめることはできません。
GitHubのSpokesはGit互換性を維持しながらクォーラムを伴う三相コミットを使い、AnthropicのScionは独自クライアントとサーバー側コミットを採用しています。Pandoはブランチ単位の因果整合性と既存packの再利用を選びました。どれが普遍的に優れているかではなく、既存クライアントとの互換性、複製方法、整合性、キャッシュの配置を各社の負荷に合わせて組み合わせています。Pando自体は公開されていないため、第三者が同一条件で再現しにくい点も比較時に押さえる必要があります。
10週間の構築を支えたCodexと検証工程
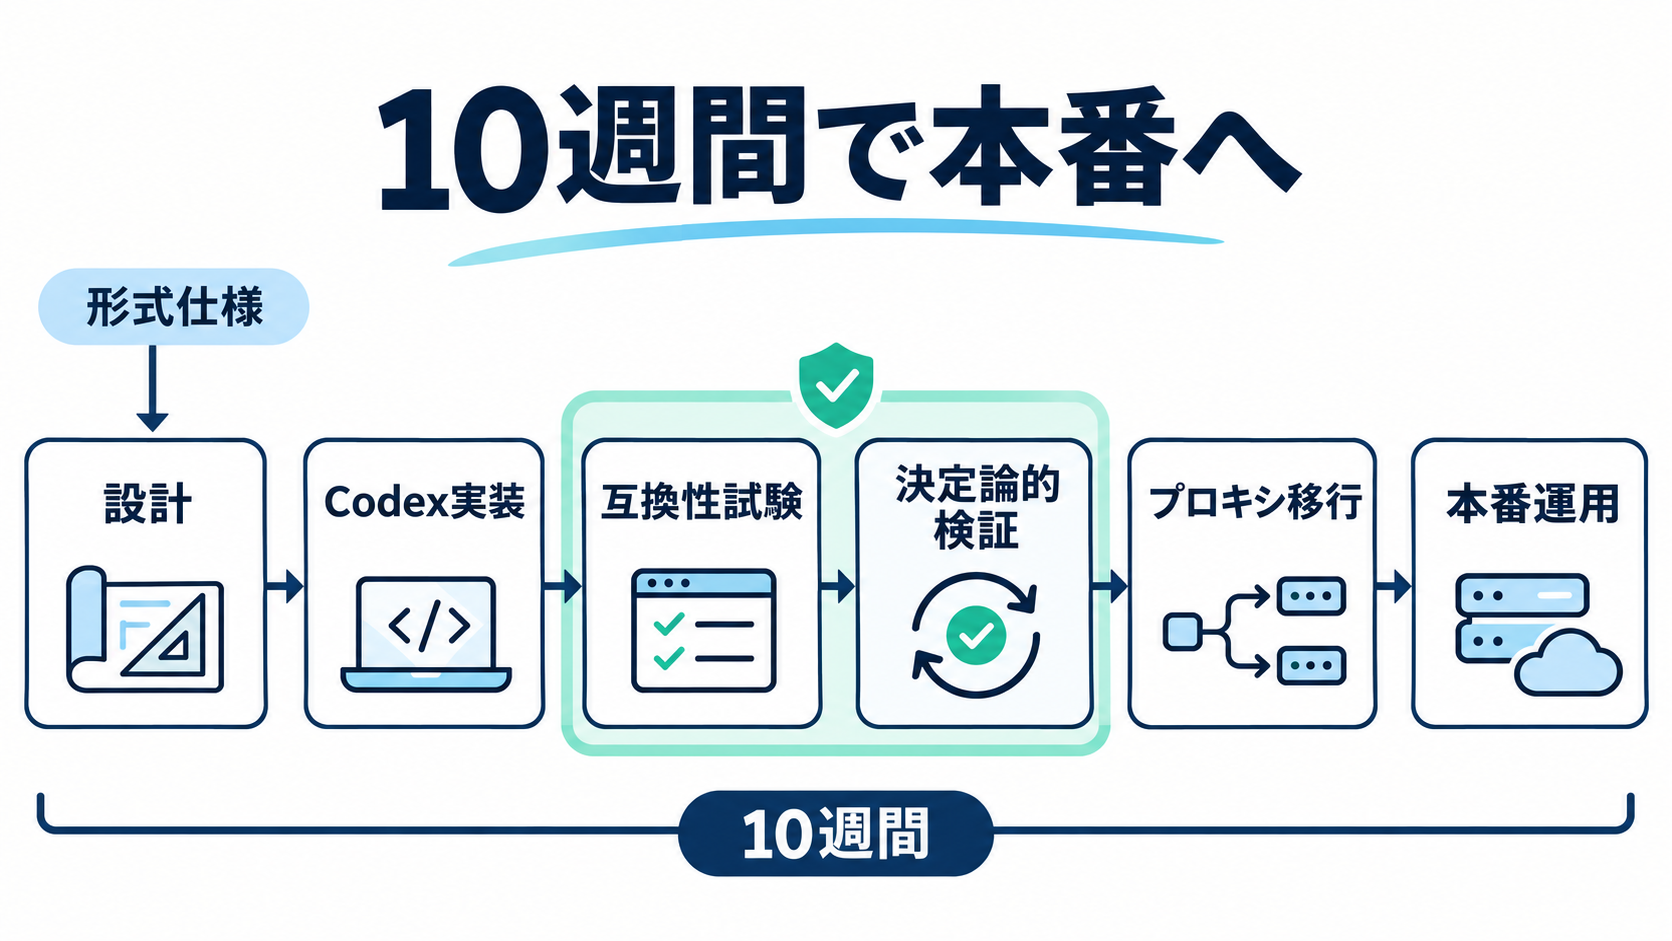
PandoはRustで実装され、10週間で本番環境へ到達しました。中心となる設計を一人のエンジニアが担当し、複数チームのCodexエージェントが実装を進めたとOpenAIは説明しています。2026年4月から本番トラフィックを処理しており、AIエージェントの増加で生じた基盤課題を、AIエージェントも参加する開発体制で解消した事例になりました。
短期間の開発を支えたのはコード生成だけではありません。OpenAIはエージェントが実装の適合性を確認できるGit互換性テストを用意し、同じ条件を再現できる決定論的シミュレーションも加えました。GPT-6 Astraを使うエージェントは、定理証明支援系のLeanや分散システムの仕様記述に使われるTLA+で仕様を作成し、バグの発見に利用したとされています。
本番への切り替えでは、Pandoを読み書きの双方に対応するプロキシとして先に配置しました。既存の経路を保ちながらトラフィックを移せるため、停止を伴わない段階導入が可能になります。OpenAIは独自ビルドのGitを開発者の端末とChatGPTデスクトップアプリへ配布し、サーバー側の変更と必要なクライアント改善を合わせて運用しています。
クライアント側では、packの並列ダウンロードが競合した場合や、中断後に再開する場合の処理を修正し、packfile-uriのトレース機能も加えました。独自ビルドにはpackの並列インデックス作成と、保持済みオブジェクトを明示する「explicit haves」も含まれます。いくつかの修正はGit本体へ取り込まれ、残りは公開パッチトラッカーで管理されています。バックエンドは非公開でも、互換性向上の一部が既存のGitへ還元される構図です。
日本企業が自社の開発基盤で確認したいこと
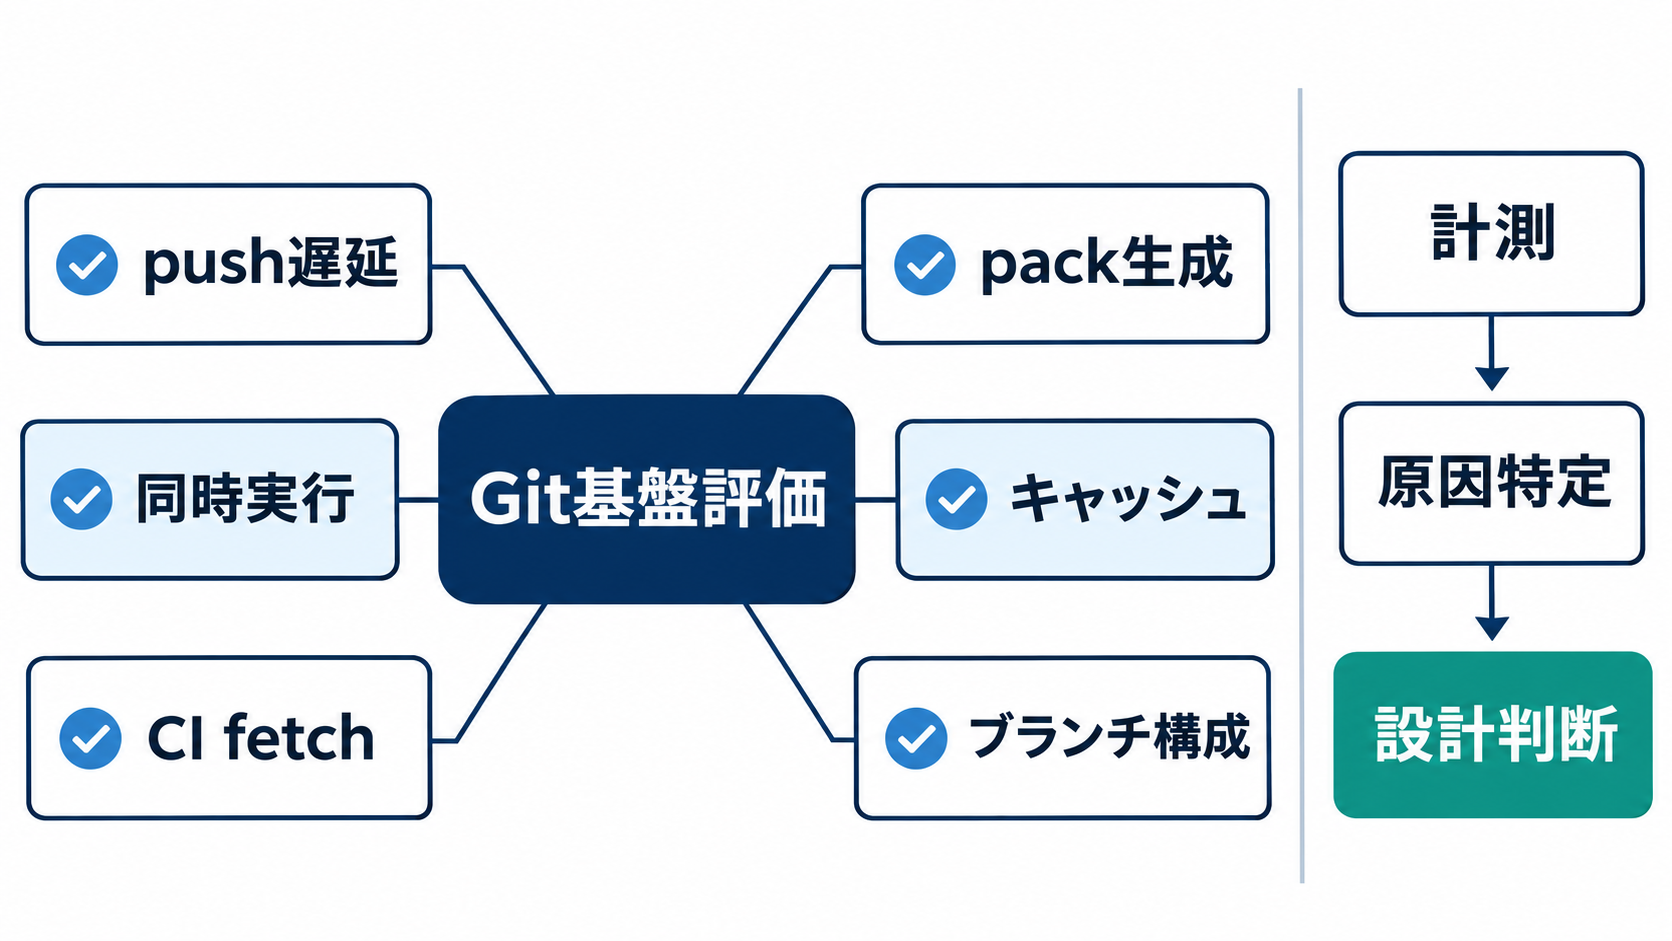
Pandoはオープンソースではなく、OpenAIは技術を共有する方法を検討中としています。そのため、日本企業が直ちにPandoを導入できる状況ではありません。それでも、AIコーディング支援を本格運用する際の観察項目は読み取れます。開発者一人当たりの生産性だけを測っていても、push、CIのfetch、テスト待ち、マージ失敗へ負荷が移れば、組織全体のリードタイムは期待どおりに縮まりません。
確認の出発点は、GitサーバーのCPU使用率だけではなく、pushの中央値と上位パーセンタイル、時間帯ごとの同時実行数、一回のpushから派生するfetch数、pack生成時間、キャッシュヒット率を分けて把握することです。ブランチ数や積み重ね型ブランチの利用状況も見逃せません。Pandoでも、トランク外の履歴を繰り返しpushする場合はデータを再送するため、ワークフローの形が転送効率へ影響します。
設計を見直す場合は、リポジトリ全体で本当に単一時点の整合性が必要なのか、それとも同じブランチ内の順序が守られれば足りるのかを確認します。読み出し経路では、毎回の計算で生成しているデータを不変オブジェクトとして保存できるか、地域キャッシュへ安全に分離できるかが論点になります。既存のGitクライアントやCIとの互換性を残せれば、利用者への影響を抑えた段階移行も検討しやすくなるでしょう。
AIエージェント導入の初期段階では、モデルの性能やライセンス費用が議論の中心になりがちです。Pandoの事例は、エージェント数が増えた後に共有基盤がどのような待ち行列を作るかまで測る必要があると示唆しています。実務で取るべき一歩は、大規模な置き換えを急ぐことではありません。通常時とエージェントが集中稼働する時間帯のGit指標を並べ、遅延が書き込み調整、pack生成、ネットワーク、CIのどこで生じているかを特定することです。その結果を基に、Pandoと同様に変更範囲をサーバー内部へ限定できるかを判断できます。