

2026/11/18
AIニュース
IBMの時系列AIがConfluentに標準搭載、予測を現場の判断につなぐ「Streamhouse」
この記事の要点
IBMの時系列基盤モデルがConfluentに組み込まれ、CPU上で予測や異常検知をストリーミング処理に接続できるようになっています。製造の品質管理や小売の補充計画などを例に、予測を業務判断へ届ける仕組みと、人の承認や既存ルールを組み合わせる際の検討点を整理します。
目次
正確でも遅い予測を、業務に間に合う予測へ
製造ラインの品質低下を、検査結果が届く前に察知できれば、調整できる余地が生まれます。店舗の需要増も、棚が空になってから把握するより、補充に間に合う段階で捉えるほうが役立つはずです。企業にとって予測の価値は、精度だけでは決まりません。その情報が、判断を変えられる時間内に届くかどうかも問われます。
IBMと、データストリーミング基盤を提供するConfluentは、この時間差を縮めるため、IBMの時系列基盤モデルをConfluentに組み込んでいます。設備の測定値、決済、販売、注文、在庫の変化など、時刻に沿って蓄積される数値データを対象に、予測や異常検知をデータの流れの中で実行する仕組みです。IBMは、対象の時系列モデル群が累計5,000万回を超えてダウンロードされたと紹介しています。ただし、この数字は利用企業数や本番導入件数を示すものではありません。
注目したいのは、モデルを呼び出すための機能が基盤側に用意されている点です。Confluent Cloudではマネージド機能として利用でき、利用者がモデルを個別にデプロイする必要はありません。自社設備で運用する場合は、Confluent Platform for Apache Flinkを使う構成が示されています。モデルはCPUで動作し、GPUを必須としません。
もっとも、モデルの配置が簡単になっても、予測を業務に結び付ける設計は残ります。どのデータを渡し、どの頻度で計算し、結果を誰に届けるのかを決める必要があります。今回の動きを企業が評価する際の軸は、AI機能の多さよりも、データの発生から現場の対応までをどこまで短く、扱いやすくできるかに置くとよいでしょう。
時系列基盤モデルとStreamhouseの役割分担
時系列基盤モデルは、多様な過去データから数値の変化に共通するパターンを学び、その知識を別の時系列やタスクにも利用するモデルです。文章や画像を扱う基盤モデルと考え方は似ていますが、主な対象は時間に沿って並ぶ数値です。自然な文章を生成する能力と、需要や設備値を予測する能力は、分けて理解する必要があります。
従来の業務では、商品別、店舗別、設備別にモデルを作成し、保守する負担が課題になります。事前学習済みモデルは、多数の系列に共通の出発点を用意する選択肢です。ただし、どのデータにも同じ精度で適用できるという意味ではありません。用途によっては追加学習を行い、ほかの情報や業務ロジックと組み合わせることになります。
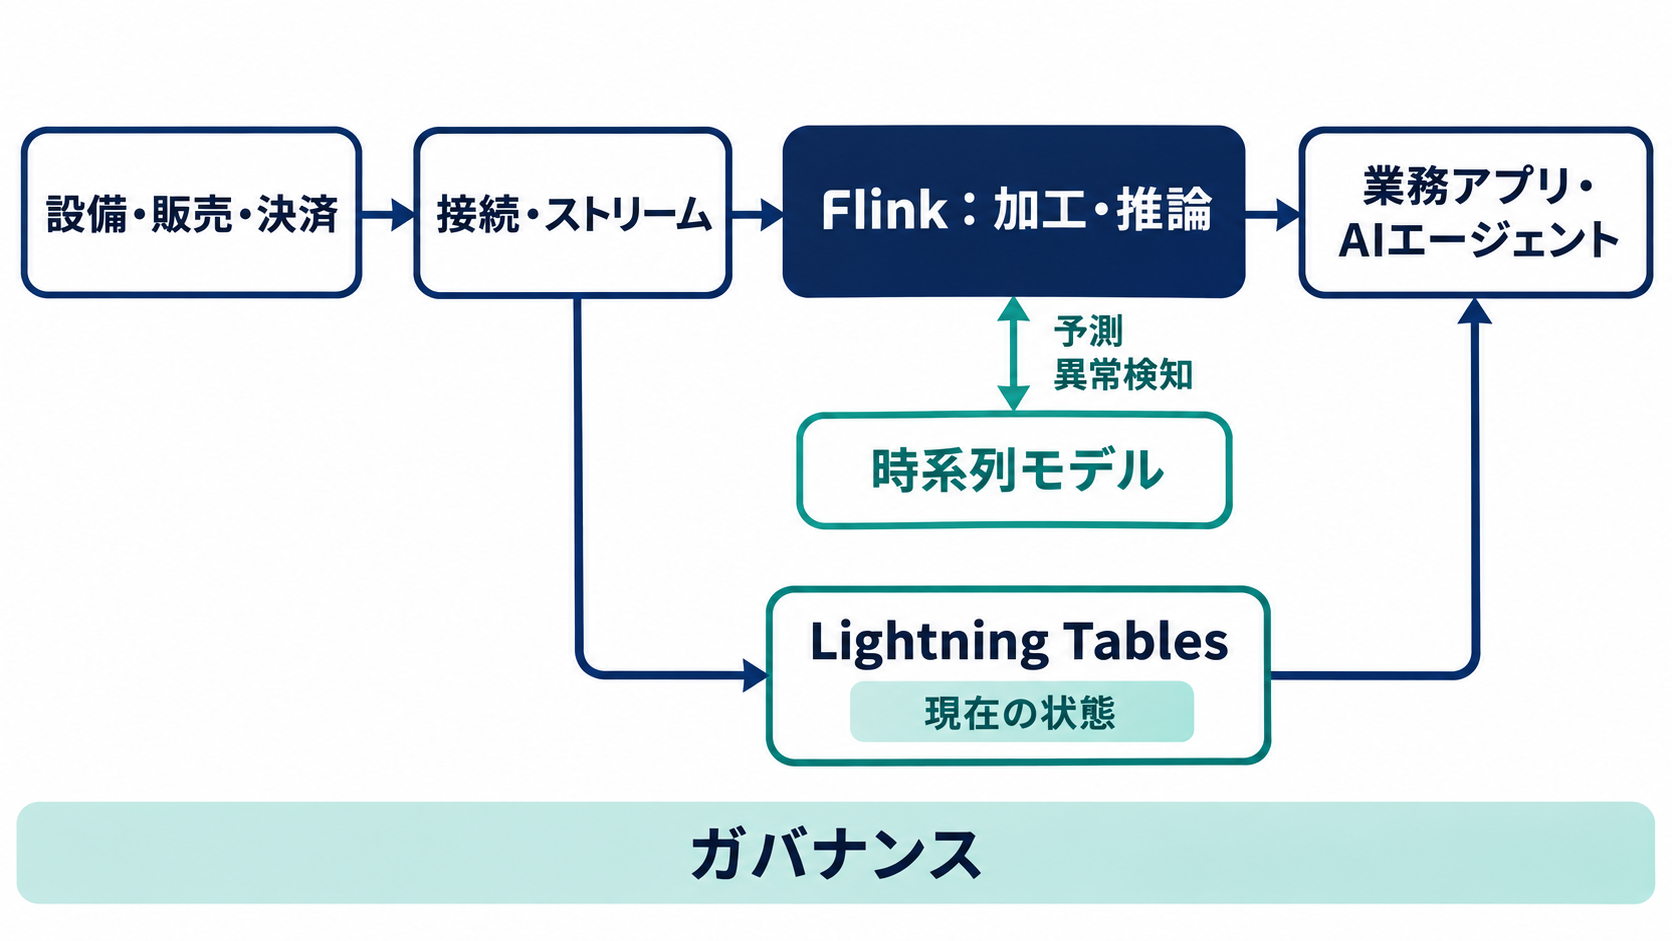
Confluentが示す「Streamhouse」は、現在の業務状況を継続的に取り込み、処理し、管理して、アプリケーションやAIエージェントに提供する構想です。接続、ストリーミング、処理、ガバナンス、クエリという五つの機能を組み合わせます。継続的なデータ処理エンジンであるApache Flinkが、流れてくるデータを加工・補足し、Lightning Tablesが現在の状態への低遅延アクセスを担う構成です。
時系列モデルは、この基盤に「この先どうなるか」「通常の範囲から外れていないか」という情報を加えます。Flinkで入力を整え、モデルを呼び出し、その結果を発生元のイベントとともに業務へ届けます。必要に応じて大規模言語モデルや統計モデル、専用の機械学習システムも組み合わせられます。
ここで、予測の更新とモデルの再学習は区別しておきたいところです。新しい観測値を使って予測を計算し直すことが、モデル自体の継続的な学習を意味するわけではありません。更新のタイミングや扱える入力は、モデルの要件と処理パイプラインの設定に左右されます。
製造ラインでは、予測から設定変更までを設計
IBMとConfluentが紹介する製造のシナリオでは、アイスクリームに混ぜ込む空気の量が品質管理の対象になります。この割合は「オーバーラン」と呼ばれ、充填後の検査で問題を把握する運用では、結果が出るまでに手直しが必要な製品が増えるおそれがあります。原料の状態や気温・湿度の変化を、運転中にどう捉えるかが課題です。
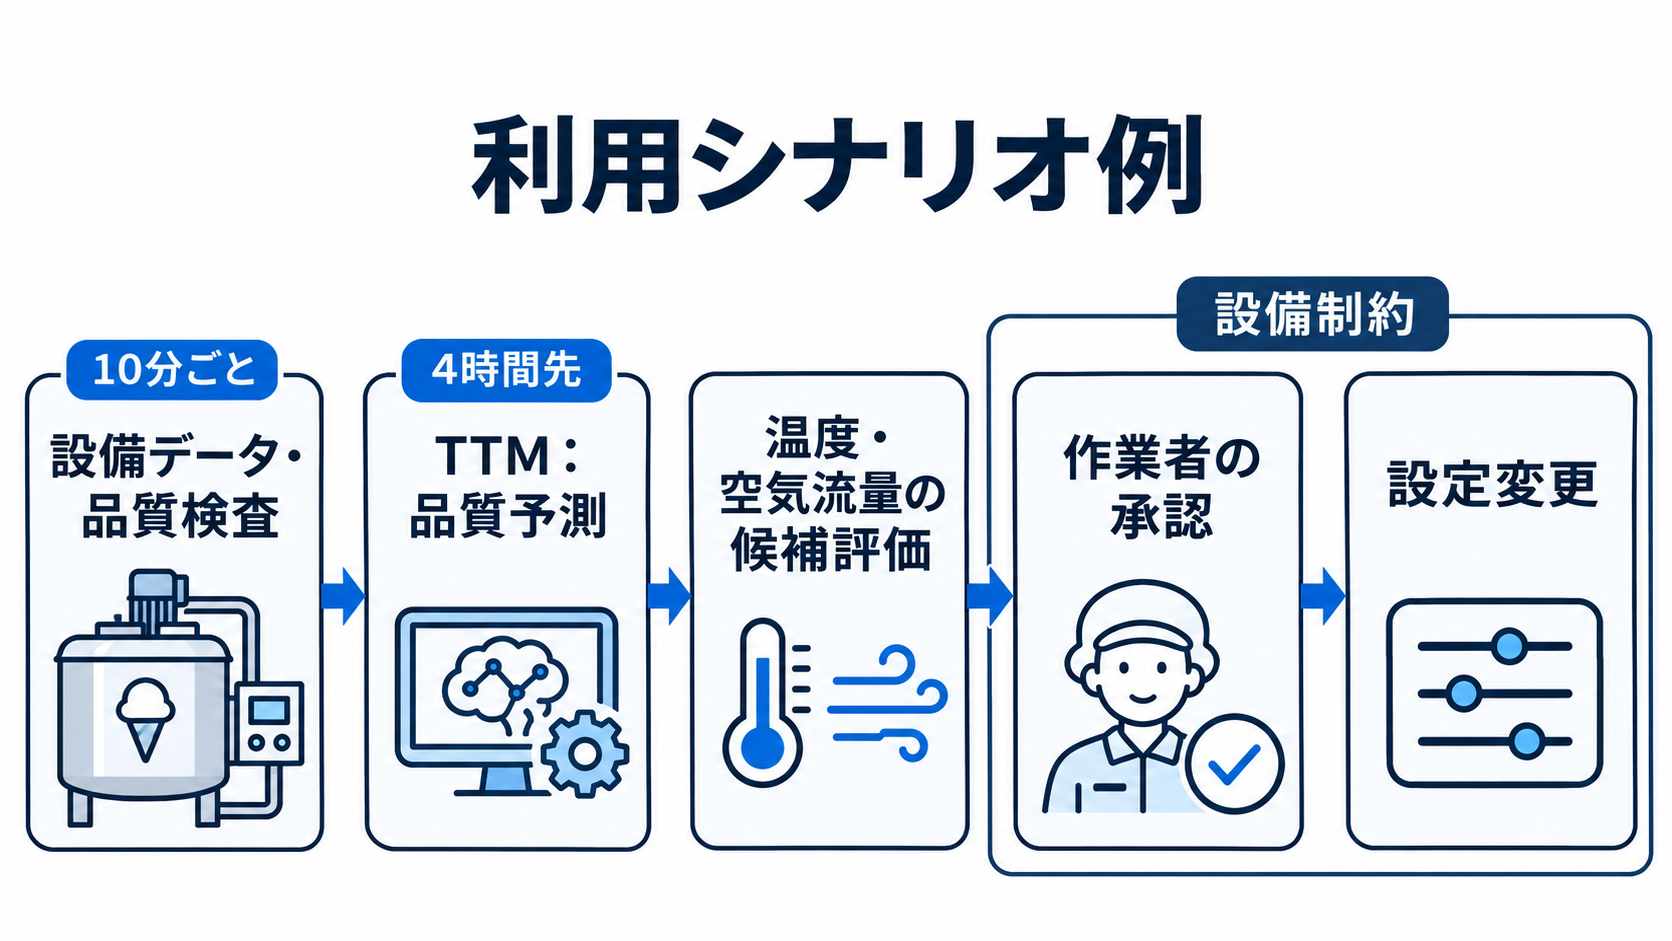
提示された構成では、事前学習済みのTTMモデルが、設備の監視・制御システムであるSCADAのデータと品質検査値を10分ごとに読み込みます。予測するのは、4時間先に規格を満たす製品の割合と、その見込みの幅です。これらの時間設定は利用シナリオの例であり、すべての製造工程に共通する推奨値ではありません。
予測が工場の目標を下回る場合、別の最適化処理が、フリーザー出口温度と空気流量の組み合わせを評価します。モデルがこれらの制御変数を入力として扱うため、実際にラインの設定を変える前に、候補条件に対する予測を比較できる仕組みです。推奨された設定値は作業者が承認し、定型的な調整は事前に定めた制約の範囲内で自動化する構成が想定されています。
この例が示すのは、予測モデル単体で設備の最適運転が完成するわけではない、という点です。予測、条件の比較、承認、実際の操作をつなぐ必要があります。また、モデル上でよい結果が出ることと、現場で安全に変更できることは同一ではありません。設備の制約や運転手順と照らし合わせる設計が欠かせないでしょう。
手直しの削減、製品量当たりのエネルギー使用量の低減、品質の安定は、この構成で目指す効果として挙げられています。実証済みの改善率は示されていません。日本の製造企業が検討する場合も、提示された効果を前提に投資を決めるのではなく、対象工程の過去データで、調整に必要な時間より早く変化を捉えられるかを確かめることが出発点になります。
小売では、異常検知と発注判断を分けて接続
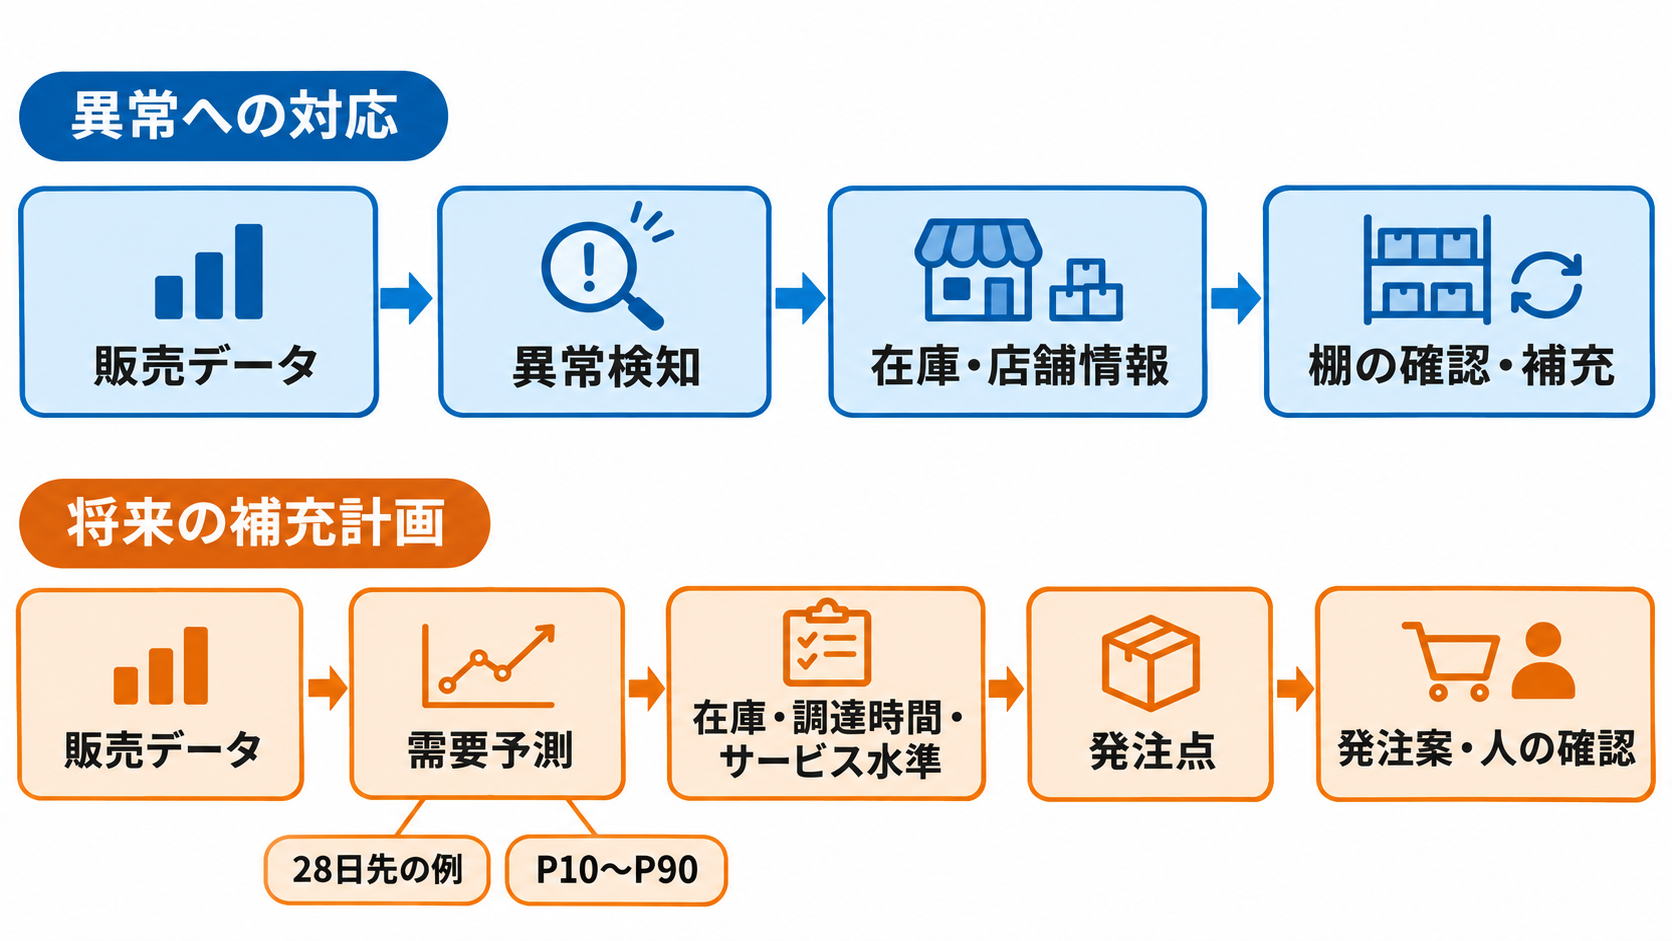
小売業で固定の売上基準を使うと、週末に繰り返される販売増まで警告する一方、普段より少し売れていない商品の変化を見逃すことがあります。商品と店舗の組み合わせが増えるほど、すべての警告を人が確認する運用は難しくなります。求められるのは、単純な増減ではなく、その系列の通常の動きから外れているかを見分ける仕組みです。
Confluentの「AI_DETECT_ANOMALIES」は、直近の履歴に基づいて各売上系列の想定範囲を求め、新しい値と比較する用途が示されています。判定に用いる信頼水準は利用側で選択します。商品と店舗の組み合わせごとに、別々のモデルを学習する負担を抑えられる点が特徴です。
ただし、想定範囲を外れた売上だけで、原因まで確定するわけではありません。在庫や店舗の情報と組み合わせて、棚の確認や補充といった対応候補を絞ります。警告を増やすことより、担当者が何を確認すればよいかまで結び付けるほうが、運用上の価値を評価しやすいでしょう。
需要計画には「AI_FORECAST」を使う例が示されています。商品・店舗別に28日先までの需要とP10〜P90の予測範囲を算出し、新しい販売データに応じて更新する構成です。P10とP90は予測分布の10パーセンタイルと90パーセンタイルを指します。将来の需要を一点で扱わず、幅を持つ見通しとして計画に渡せますが、実際の値が必ずその範囲に収まる保証ではありません。
発注点は、この予測だけで決まりません。計画アプリケーションが在庫、調達までの時間、欠品をどこまで避けたいかというサービス水準を組み合わせて計算します。在庫が発注点を下回る見込みなら、エージェントが発注書案を作り、人が確認する流れです。需要の推定と発注の判断を分けることで、予測が変わった理由と、実際に注文する理由をそれぞれ検証しやすくなります。
金融と設備検索に共通する、モデル出力の限界
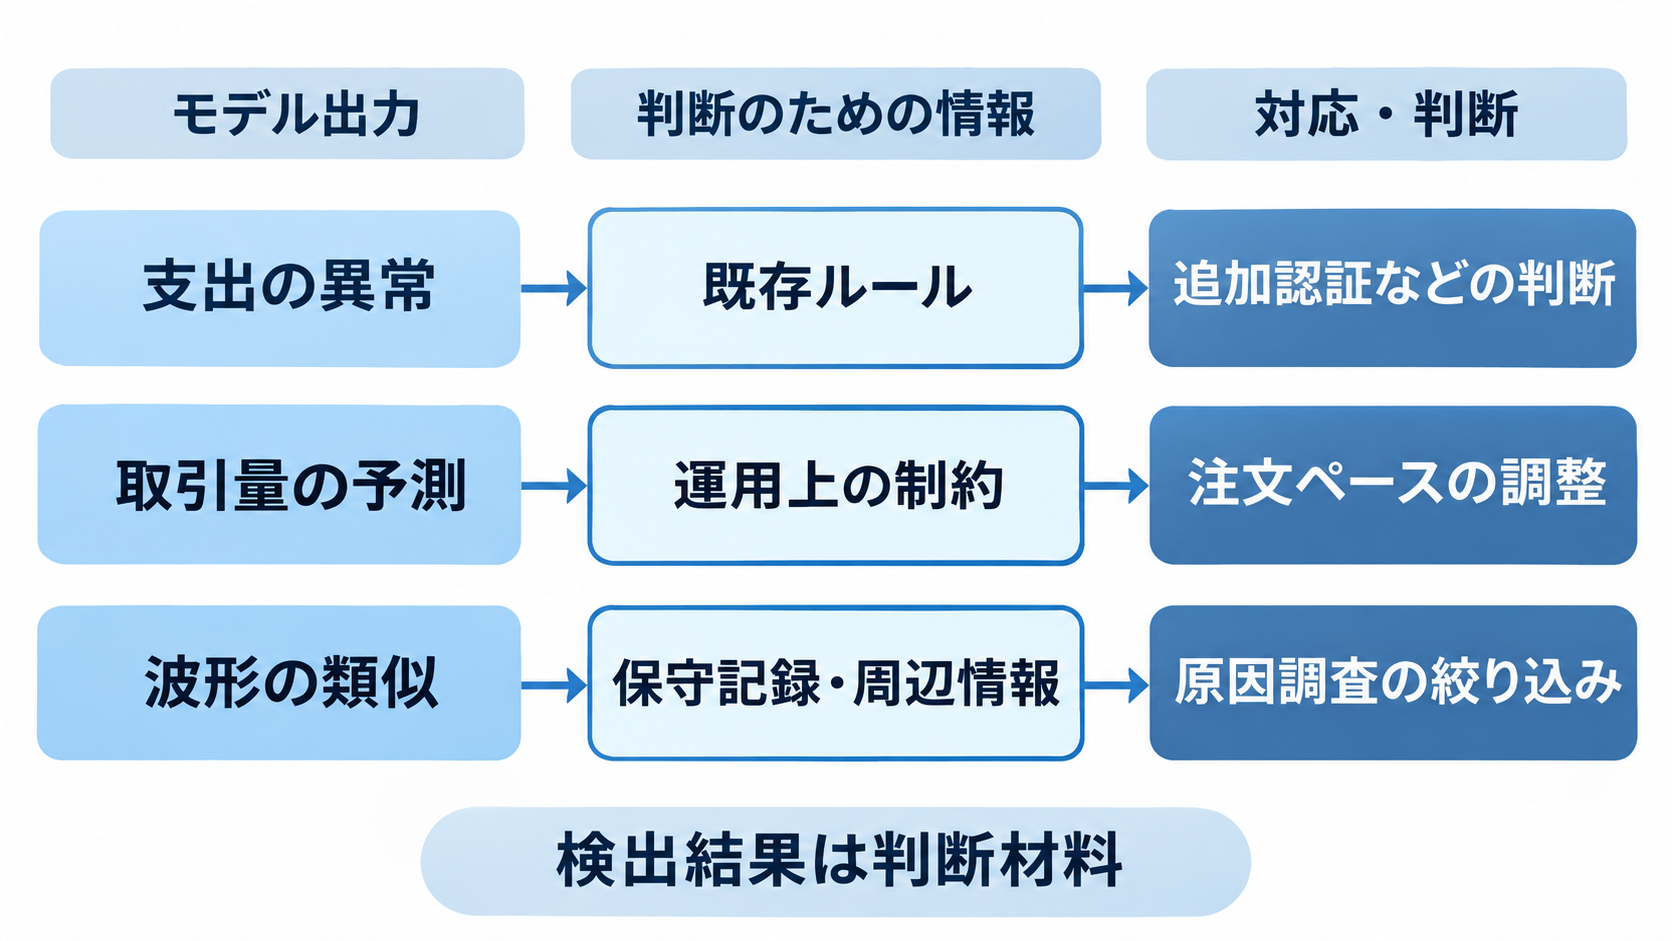
カード決済では、利用者全体に一律の基準を当てはめても、個人ごとの普段の支出を十分に表せない場合があります。紹介されたシナリオでは、カードの直近の履歴から支出の想定範囲を求め、新しい決済がその範囲を外れているかを確認します。その結果は、既存の不正検知システムへ渡す追加の判断材料になります。
支出が通常の範囲を外れたからといって、不正と断定する構成ではありません。銀行がほかのシグナルや業務ルールと合わせ、承認、追加認証、調査などを判断します。異常検知が表す「普段と違う」と、業務上の「不正である」を混同しないことが重要です。判断とその根拠を保存すれば、後から確認できる運用にもつながります。
売買執行の例では、PatchTST-FMが1分足ごとに、その先30分間の取引量とP10〜P90の範囲を予測します。執行アルゴリズムは、その見通しと担当部門が設定した市場参加率の上限を使い、大口注文を小分けにするペースを調整します。これは市場の取引量を注文の進め方に利用する例であり、価格の上昇や利益を予測する機能としては説明されていません。
設備調査には、TSPulseで時系列の一定区間を数値表現に変換し、似た波形を探す用途もあります。急上昇後に戻る形や、緩やかに上がる形を検索し、関連する保守記録や運転条件を確認する使い方です。ただし、この用途には別途、埋め込み処理、検索用インデックス、関連情報へアクセスする仕組みが必要になります。
これらに共通するのは、モデル出力を判断の一部として位置付けていることです。似た波形が見つかっても、故障原因まで確定するわけではありません。異常や類似性、将来の取引量をどの判断に使えるのかを限定してこそ、担当者は出力の意味を理解し、追加の確認を進められます。
日本企業は「予測を受けて変えられる業務」から選定
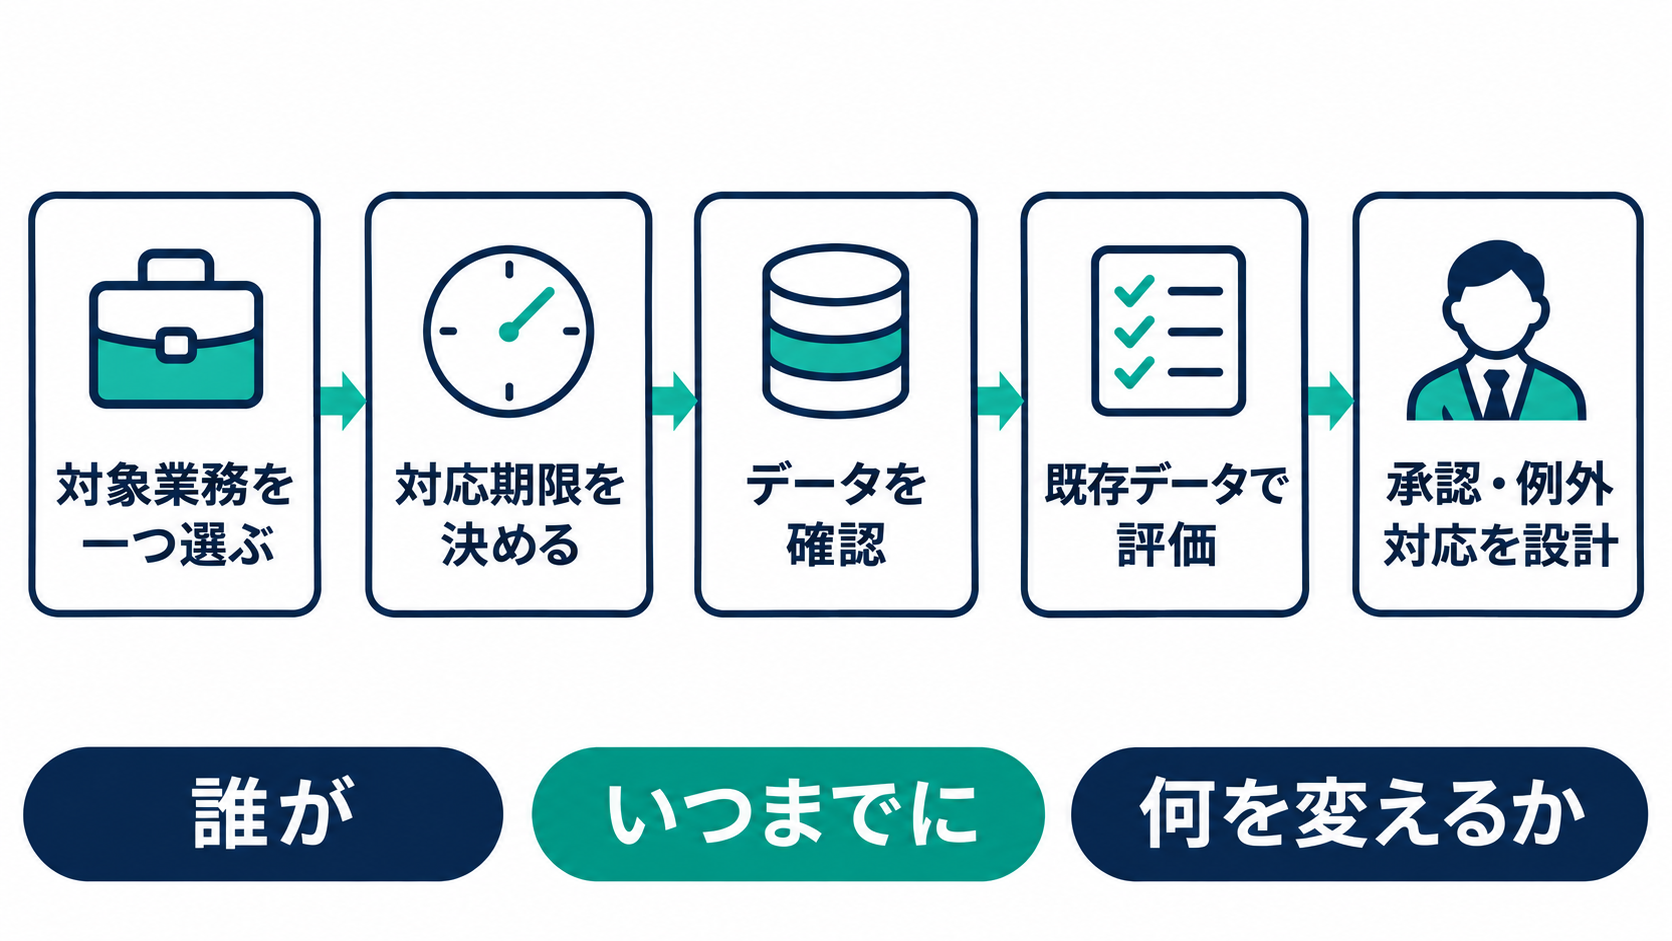
日本企業がこの構成を検討する際、最初に選びたいのはモデルではなく、予測を受けて行動を変えられる業務です。需要予測であれば発注や補充、製造であれば運転条件の確認など、出力を受け取った後の対応を具体化します。予測精度が改善しても、担当者に届く時点で変更できる余地がなければ、業務効果は限られるためです。
対象を絞ったら、判断に間に合う条件を確認します。何時間先を知る必要があるか、データがどの間隔で届くか、承認や実行にどの程度の時間が必要かを並べると、求める処理の速さが見えてきます。「リアルタイム」という言葉だけで要件を決めず、現場で対応できる時間幅に合わせることが実務的でしょう。
CPUで動作し、クラウドと自社基盤の両方に配置できることは、導入構成の選択肢を広げます。ただし、GPUが不要という説明から、システム全体の費用が必ず下がると判断することはできません。処理する系列数、予測の更新頻度、データの加工、保存や監視なども運用負荷に関わります。実際の構成で確認する必要があります。
評価では、予測誤差に加えて業務側の指標を置くと判断しやすくなります。たとえば、小売なら警告を確認する負担や補充判断への有用性、製造なら品質変化を調整可能な時点で捉えられるか、といった観点です。自動処理の範囲、人が承認する条件、入力データが欠けた際の対応も、試行の段階で明確にしておきたいところです。
IBMとConfluentが示す各シナリオは、時系列モデル、ストリーミングデータ、業務ロジックを組み合わせた利用例です。掲載された製造・小売の図にはシミュレーションデータも使われており、個別企業での導入実績や効果を一律に示すものではありません。自社での検討は、予測の遅れが支障になっている業務を一つ選び、「誰が、いつまでに、何を変えるか」を書き出すところから始められます。その条件を満たせるかを既存データで確かめると、導入の可否を具体的に判断できるでしょう。