

2026/11/09
AIニュース
AIエージェントの同時プッシュを支える「Aspen」公開、Gitの処理単位をブランチへ
この記事の要点
Reason Machinesが、AIエージェントによる大量の同時プッシュに対応するGitサーバー「Aspen」を公開しました。ブランチ単位の更新と保存済みパックの再利用が特徴で、開発側は毎秒567回のプッシュを報告しています。ただし、共有ブランチへの取り込みには別の制約があり、製品もプレアルファ段階です。企業での評価では、並列書き込みの性能と継続運用の信頼性を分けて確認する必要があります。
目次
AIがコードを書くほど、Gitへの書き込みが詰まる理由
AIエージェントを増やせば、開発の作業量も増やせそうです。しかし、数百のエージェントが同じリポジトリへ変更を送り続けると、その変更を受け止めるGitサーバーがボトルネックになります。Reason Machinesが公開したオープンソースのGitサーバー「Aspen」は、この問題に対して、書き込みを処理する単位をリポジトリ全体からブランチへ変える設計を採用しています。
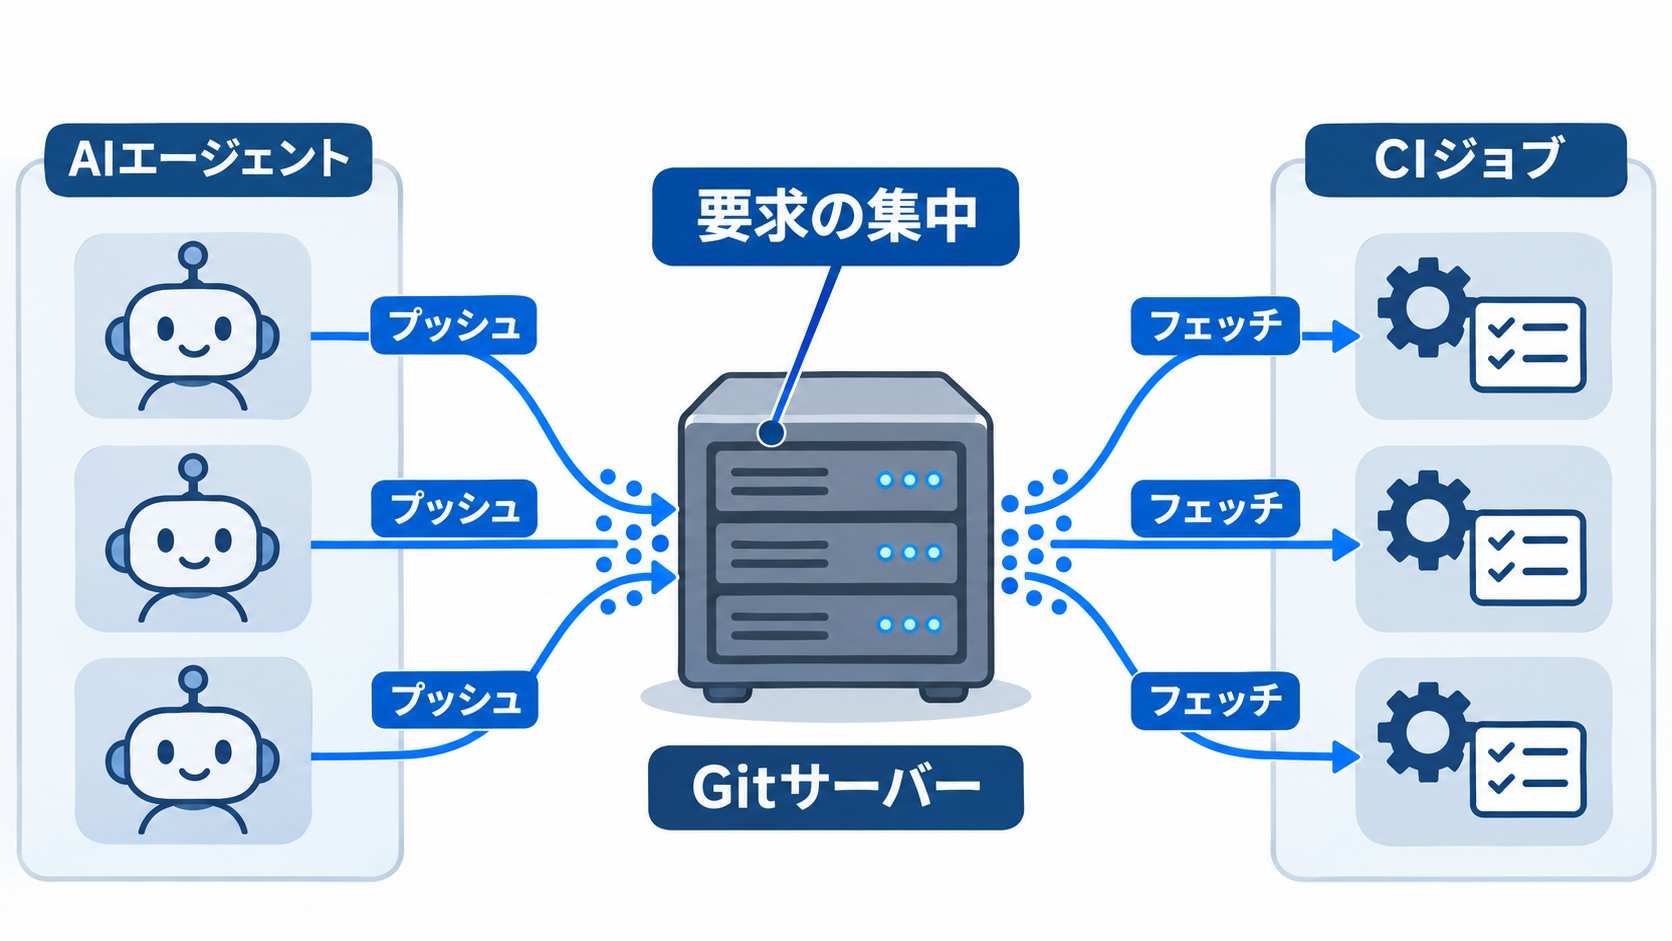
Gitは、ソースコードの変更履歴を管理する仕組みです。開発者やエージェントが手元の変更をサーバーへ送る操作を「プッシュ」、サーバーから必要なデータを取得する操作を「フェッチ」と呼びます。エージェントが数分おきにプッシュし、そのたびにCIと呼ばれる自動テストなどの仕組みがフェッチすると、変更の規模が小さくてもサーバーへの要求は積み重なります。
Reason Machinesの説明では、従来型のGitサーバーは同じリポジトリへのプッシュをまとめて待ち行列に入れ、フェッチのたびに配信用データを組み立てます。この構造では、新しく増えたコードの量だけでなく、接続するクライアントの数に応じて処理が膨らみます。ただし、個々のGitホスティングサービスの内部実装まで、すべて同じと捉えるべきではありません。
Aspenの狙いは、互いに独立したブランチへの変更を同じ列に並ばせず、取得用のデータも再利用することです。OpenAIが社内向けに構築したGit基盤「Pando」の設計を、Reason Machinesが独立して実装したものと位置づけられています。日本企業が注目すべき点も、単なる高速化の数値より、エージェントの並列作業をどこまで開発基盤側で受け止められるかという設計上の違いでしょう。
ブランチごとの更新で、独立した作業を待たせない設計
Aspenでは、ブランチの履歴をPostgreSQLというリレーショナルデータベースで管理し、各ブランチを一つの行に対応づけます。コードや履歴の実体をまとめたデータは別のストレージへ保存するため、ブランチが現在どの変更を指しているかという情報と、変更内容そのものを分けて扱う構造です。
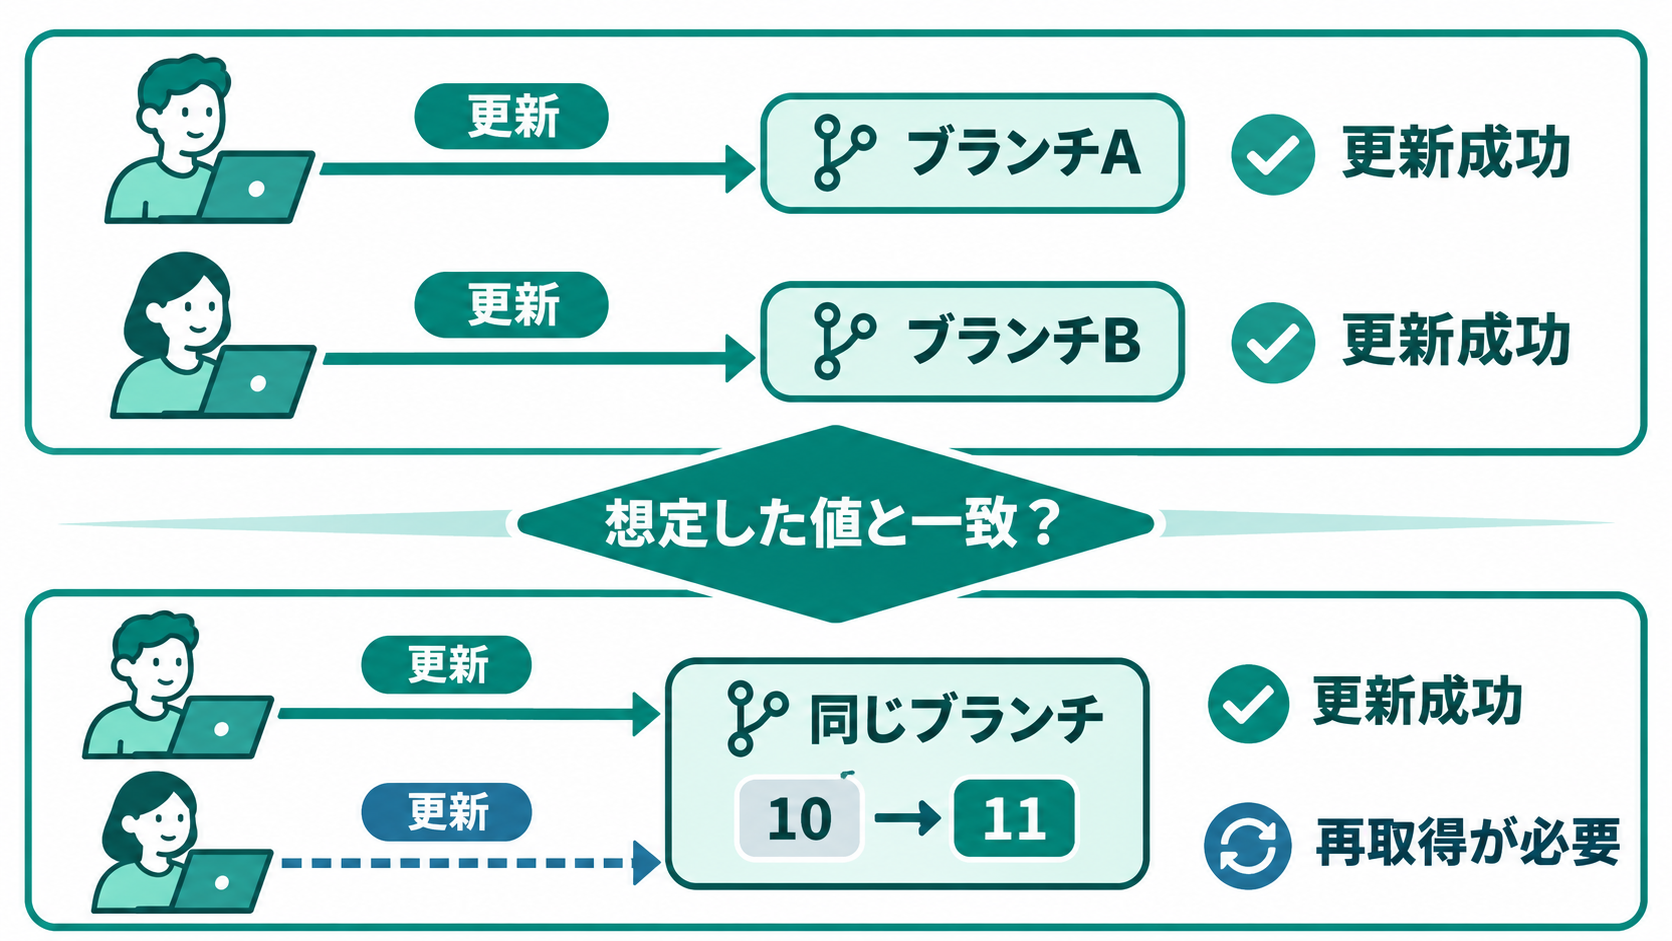
プッシュでは、必要なデータをアップロードしてから、ブランチの参照先を「compare-and-swap」で更新します。これは、更新前の値が想定どおりである場合にだけ、新しい値へ置き換える方法です。別の処理が先に変更していれば、そのまま上書きすることはありません。複数の書き込みが競合した際の整合性を、ブランチ単位で制御します。
異なるブランチへのプッシュは、互いの完了を待つ必要がありません。同じブランチへ二つのプッシュが競合した場合は、一方が成功し、もう一方には通常のGitと同様に、先にフェッチするよう求めるエラーが返ります。利用者が新しい競合解決手順を覚えるというより、サーバー内部で待ち合わせる範囲が狭くなると理解すると分かりやすいでしょう。
この設計にも交換条件があります。複数のブランチを読み取る際、それぞれがわずかに異なる時点の状態になる可能性があります。リポジトリ内の全ブランチを、厳密に同じ瞬間の一覧として扱えることとは別の性質です。複数ブランチを横断して状態を判定する独自ツールがある企業では、その前提を確認する必要があると考えられます。
また、書き込みを分散できる効果は、作業もブランチへ分散している場合に得られます。多数のエージェントが別々の作業を進める段階と、その成果をmainなどの共通ブランチへ集める段階は区別しなければなりません。Aspenの構造は前者の待ち時間を減らしますが、同じブランチへの更新競合までなくすものではありません。
フェッチのたびに作り直さず、保存済みデータを再利用
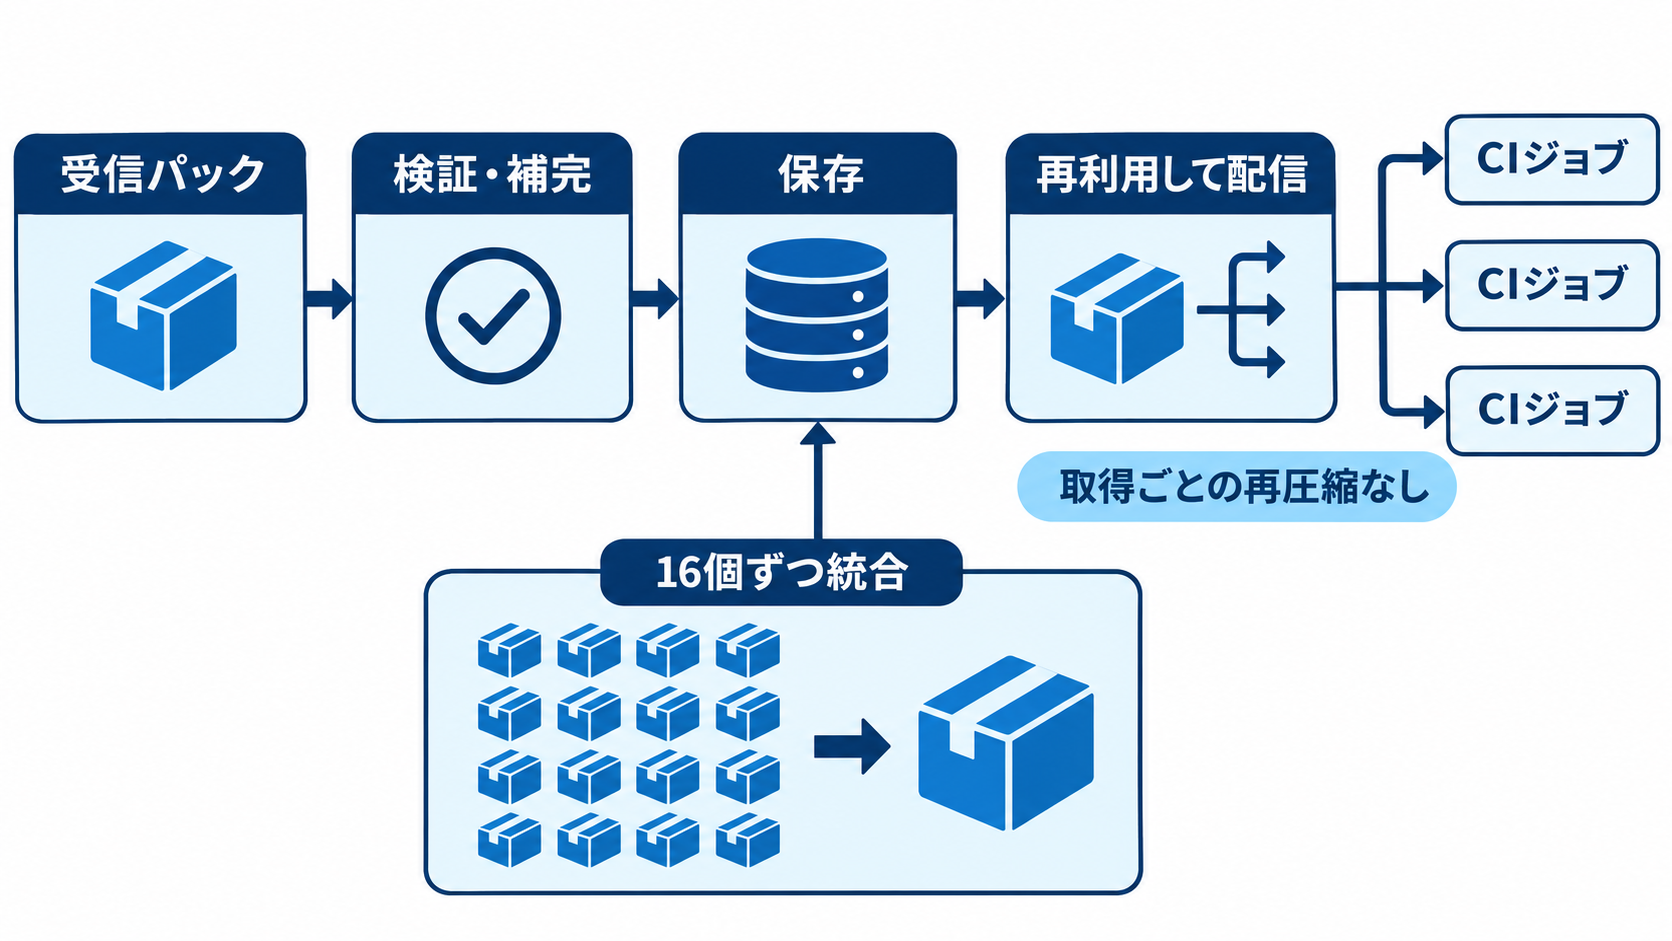
Gitは、コードや履歴を効率よく転送するために「パック」と呼ばれるデータのまとまりを利用します。Aspenは、プッシュで受け取ったパックを展開せず、検証と不足している差分の基底データの補完を行い、その形を保って保存します。保存先には、Amazon S3と互換性のあるオブジェクトストレージを使います。
フェッチ時には、クライアントがまだ持っていない保存済みパックを送信します。取得要求ごとにデータを再圧縮しないことが特徴です。同じ変更を多くのCIジョブが取得する場面では、要求のたびに似たデータを組み立てる処理を避けられます。署名付きURLを利用し、コンテンツ配信網であるCDNからパックを配信する構成も可能です。
保存済みデータを再利用するだけでは、小さなパックが増え続け、取得側の負担が膨らむおそれがあります。Aspenはバックグラウンドで16個ずつパックを統合し、段階的に整理します。これは、データを階層ごとにまとめるLSMツリーに似た考え方です。更新に大きく遅れたクライアントでも、何千ものパックではなく、数十個程度を受け取れるようにする狙いがあります。
CIで使われる、履歴を浅く取得する「depth-1」のフェッチにも専用の工夫があります。先端の状態を取得するためのパックを一度作り、複数のジョブへ配信します。プッシュ時に相手へ知らせるブランチ情報も主要ブランチに絞り、多数のブランチがあっても、転送内容を決めるやり取りが膨らまない設計です。
企業がこの方式を評価する際は、サーバーのCPU使用率だけでなく、転送量やストレージ側の処理も併せて見る必要があるでしょう。計算処理を減らす設計が、自社の履歴構造やCIの取得方法でも有効かどうかは、実際のアクセスパターンに左右されると考えられます。
毎秒567回のプッシュは、どの条件で得られた数字か
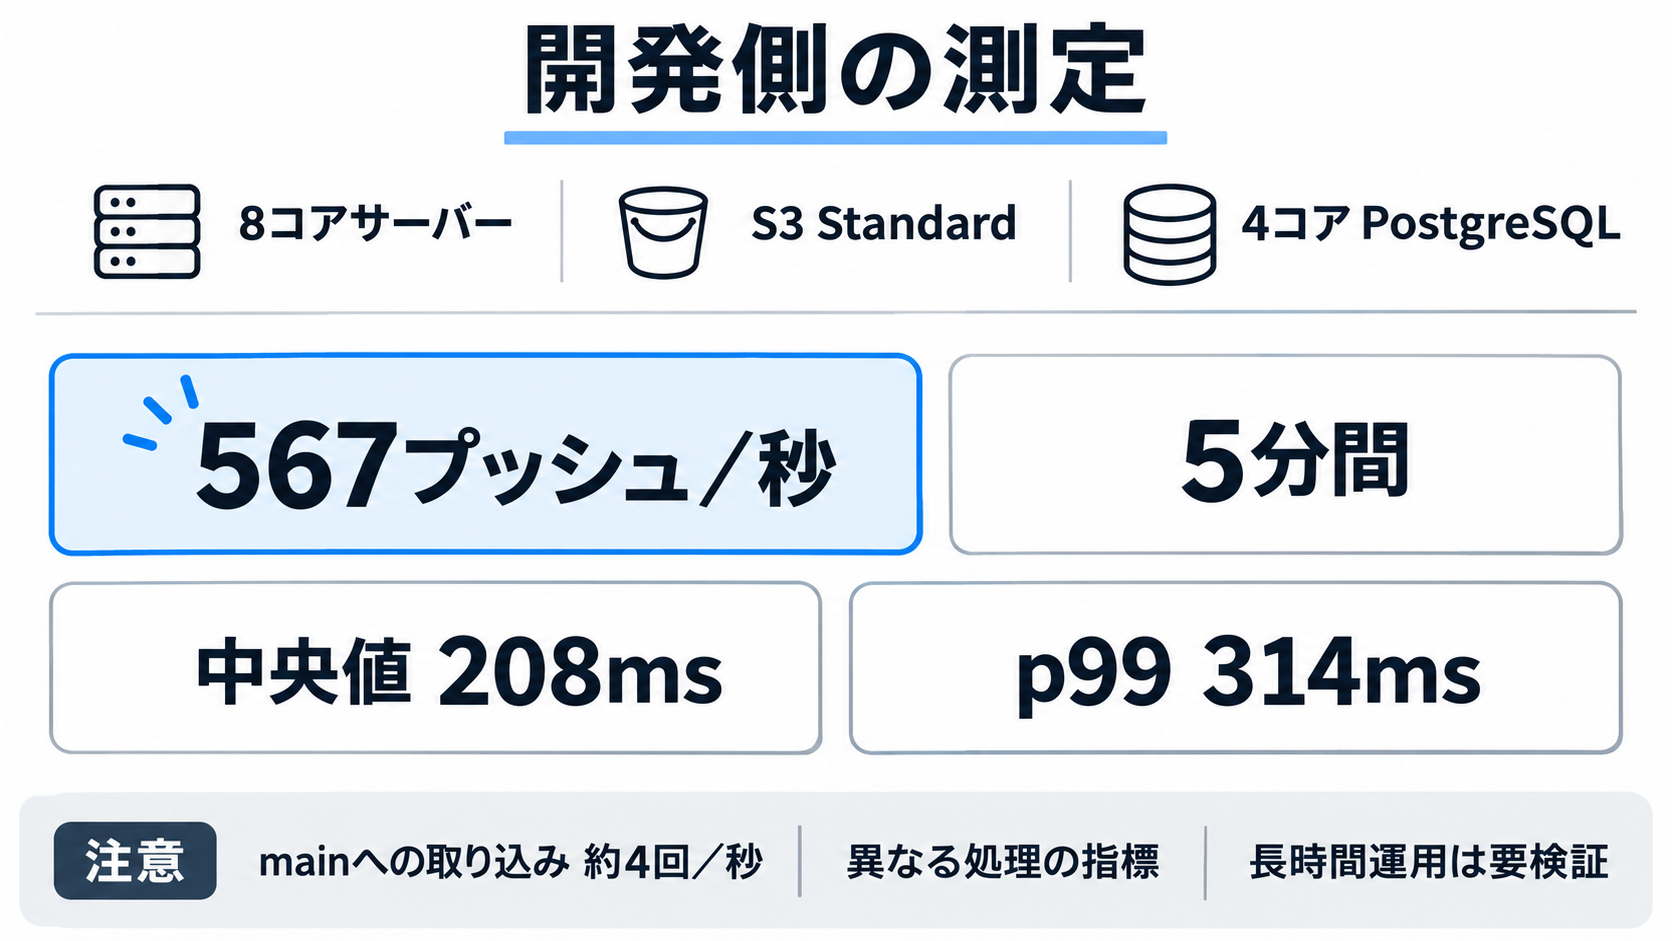
Reason Machinesは、Aspenが5分間にわたり、毎秒567回のプッシュをエラーなく処理したと報告しています。構成は8コアのサーバー1台、S3 Standard、4コアのPostgreSQLです。対象には、約4,500ファイルと約75,000コミットを持つ、Git自体の開発リポジトリ「git.git」の複製を使っています。
プッシュの遅延は中央値が208ミリ秒、99パーセンタイルが314ミリ秒でした。99パーセンタイルは、観測した処理の99%が収まる時間を示す指標で、遅い側の応答を見る際に役立ちます。また、Gitが成功を示す「ok」を表示する前に、各プッシュのデータはS3とPostgreSQLへ到達したと説明されています。
別のクライアントが更新を確認できるまでの時間は、プッシュの応答後、中央値で30ミリ秒でした。depth-1のフェッチが集中する試験では、転送量は標準Gitの配信処理に対して1.029倍と報告されています。これらは、書き込みの処理能力に加えて、取得時の効率や更新の見え方を判断する材料になります。
ただし、いずれも開発側による測定です。READMEでも、数値は参考値であり、性能を保証する主張ではないとされています。特に、mainへの変更の取り込みは毎秒約4回とされており、毎秒567回という値を、そのまま共有ブランチへの統合能力として読むことはできません。個別ブランチへの書き込みと、成果の集約では処理の条件が異なります。
5分間の試験から、長時間運転時の信頼性まで判断することも避けるべきでしょう。公開情報では24時間の耐久性基準を満たしていないとされており、長時間の運用に対する検証は残っています。導入候補として評価するなら、最大処理件数だけでなく、通常時の遅延、更新の可視化、共有ブランチへの取り込み、継続運転を分けて測る必要があります。
PandoやCursor Originとの違いは、公開形態と更新の単位
AIエージェント向けのGit基盤は、Aspenだけではありません。OpenAIのPando、AI開発環境を提供するCursorの「Origin」、GitHub内部の「Spokes」などが比較対象として挙げられています。ただし、利用できる範囲も内部構造も異なるため、処理件数の順位だけで選べる関係ではありません。
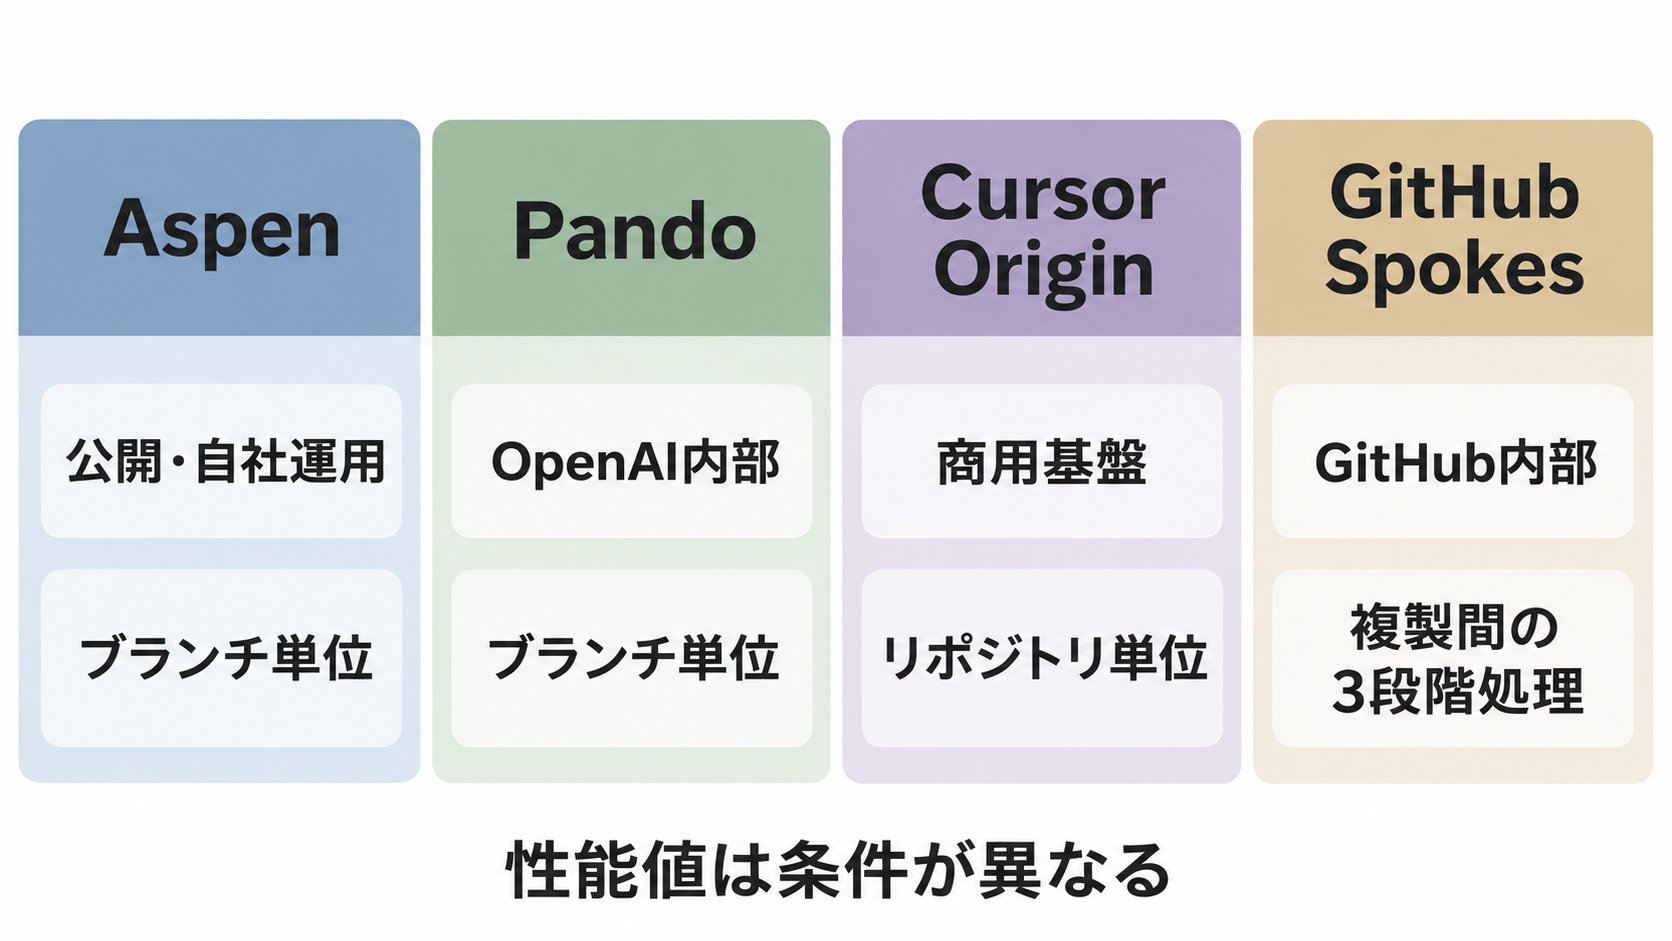
AspenはApache 2.0ライセンスで公開され、自社管理の環境へ導入できます。PandoはOpenAI内部、SpokesはGitHub内部の基盤で、OriginはCursorの商用プラットフォームに属します。企業の検討では、自社で構成や運用を管理したいのか、利用中の開発サービスの一部として性能を得たいのかによって、比較の出発点が変わります。
更新方式にも違いがあります。AspenとPandoはブランチ単位で更新を扱います。OriginはS3上の先行書き込みログを使ってリポジトリ単位で順序を管理し、Spokesは複製先の間で3段階のコミット処理を行うと紹介されています。保存先だけが違うのではなく、変更の順序や複製の整合性をどこで管理するかが異なる設計です。
CursorはOriginについて、S3 Standardで毎秒最大120回、S3 Express One Zoneでは毎秒300回超のプッシュを報告しています。しかし、こちらはCursorのモノレポを対象とする複製クラスターであり、Aspenの単一サーバー試験とは条件がそろっていません。Pandoにはプッシュ遅延の中央値を約5分の1に短縮したという説明がありますが、同じ条件での毎秒処理件数は示されていません。
日本企業への示唆は、各社の数値を横並びにするより、自社の混雑がどこで起きているかを把握することにあります。別ブランチへのプッシュ待ち、CIの取得負荷、共有ブランチへの統合待ちでは、必要な改善が変わります。Aspenの設計は、特に独立したブランチで多数のエージェントを動かす場合の検討材料になるでしょう。
導入判断は、ミラーモードで実際の負荷を確かめるところから
AspenはRustで実装された単一の実行ファイルで、ソースコードからビルドして使います。手元で試す「aspen dev」は、軽量なデータベースのSQLiteとローカルディレクトリで動作します。大きなクラウド構成を用意する前に、基本的な動作や既存ツールとの接続を確認できる構成です。
チーム向けにはPostgreSQLと、S3互換ストレージのMinIOを組み合わせるDocker Compose構成が用意されています。Kubernetes向けのHelmチャートや、AWS、Google Cloud、Azure、Hetznerを対象とするTerraform構成もあります。クライアント側は通常のGitをHTTPSまたはSSHで使えるため、独自クライアントへの置き換えは必要ありません。
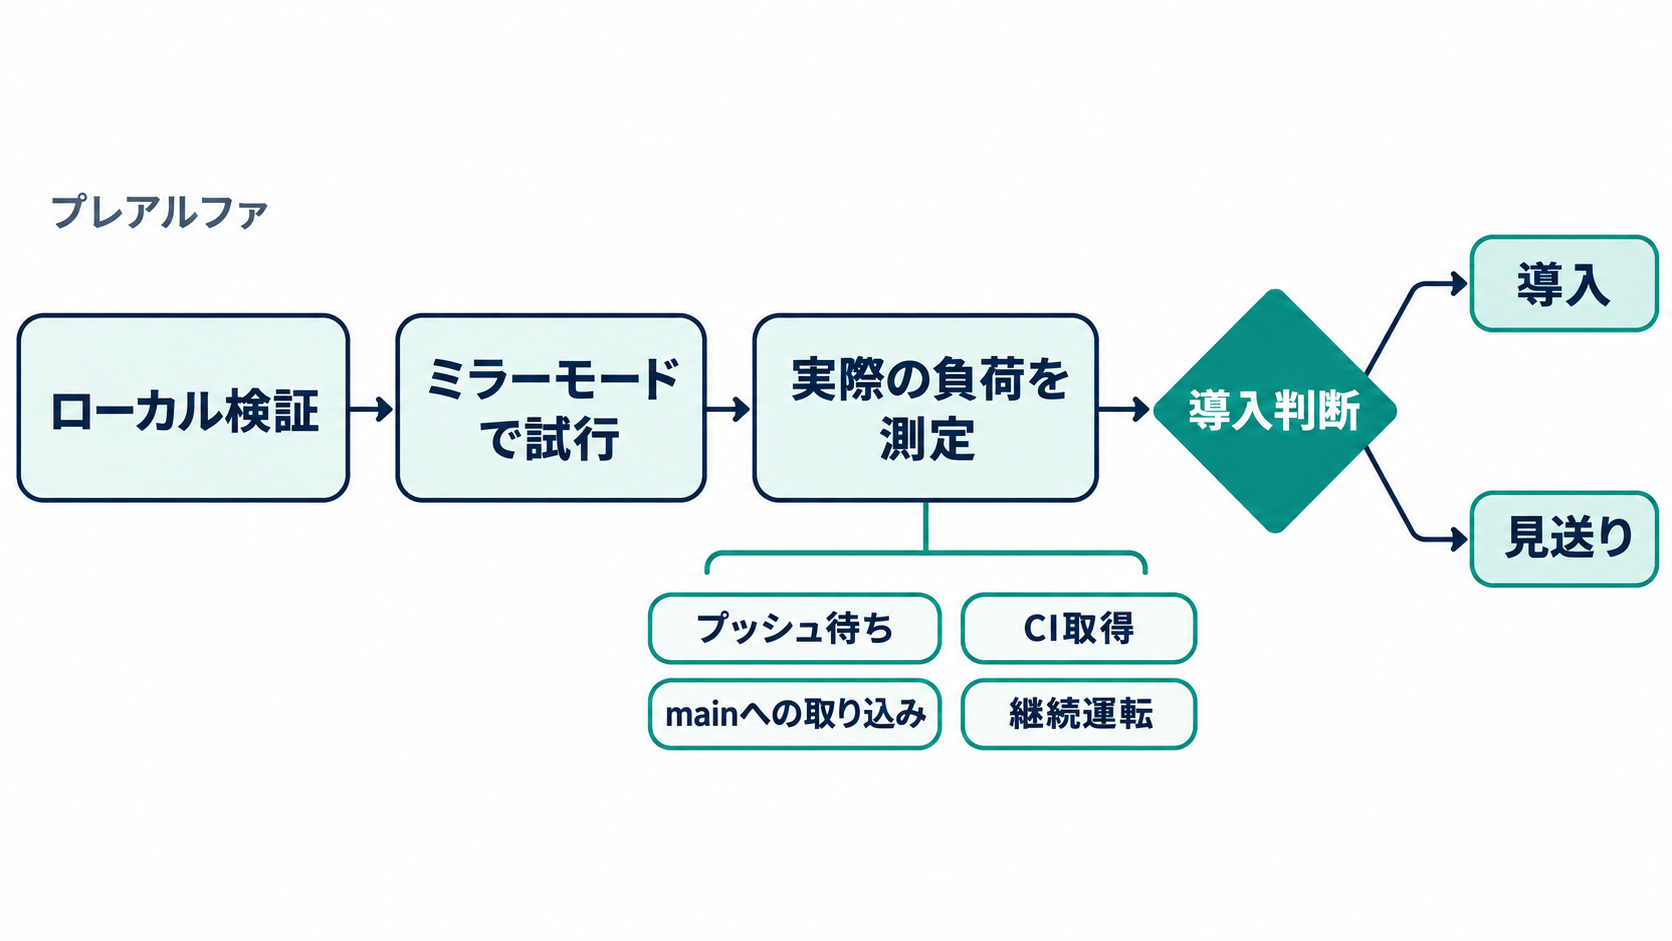
試行の入り口として注目したいのが、GitHubやGitLabの前段に配置できるミラーモードです。全面的な移行をせずに試せるため、既存の開発フローに近い条件で評価を進められます。ただし、通常のGitが接続できることと、企業が必要とする運用機能がそろっていることは別に確認する必要があります。
Aspenはまだプレアルファ段階です。公開情報ではリリース版やWeb UIがなく、24時間の耐久性基準も未達とされています。セルフホストできる選択肢が増えたことには意味がありますが、現時点で既存のGit基盤をそのまま置き換えられると判断する材料は十分ではありません。障害時の復旧やアクセス管理など、自社で必要とする運用要件への対応も確認対象になるでしょう。
評価を始めるなら、エージェントがそれぞれのブランチへ書き込み、その後にCIが取得する小規模な検証環境を用意する方法が考えられます。そこで、プッシュの待ち時間、CIの取得時間、共有ブランチへの取り込み速度を別々に記録します。Aspenが解決しようとする並列書き込みの問題が、自社でも実際に起きているかを確かめることが、導入判断の具体的な第一歩です。