

2026/11/19
AIニュース
Gemini 4 Neon、長文処理とエージェント業務を強化――企業が見極めたい「1タスク当たりの費用」
この記事の要点
Google DeepMindのGemini 4 Neonは、100万トークンの文脈とエージェント向け機能を備え、推論の深さと効率の両立を狙います。料金は100万トークン当たり入力3ドル・出力15ドルです。企業の導入判断では、Googleが提示する評価値を踏まえつつ、実際の業務で品質、完了までの総費用、運用条件を確かめる必要があります。
目次
最上位モデルとの使い分けを狙うGemini 4 Neon
大量の設計書を読み込み、コードを修正し、実行結果を確かめる。こうした仕事をAIに任せる場合、回答の賢さだけでは導入効果を判断できません。途中で情報を見失わないか、同じ作業を繰り返さないか、完了までにいくらかかるかが問われます。Google DeepMindが公開したと報じられているGemini 4 Neonは、このような複数工程にまたがる業務を想定した推論モデルです。
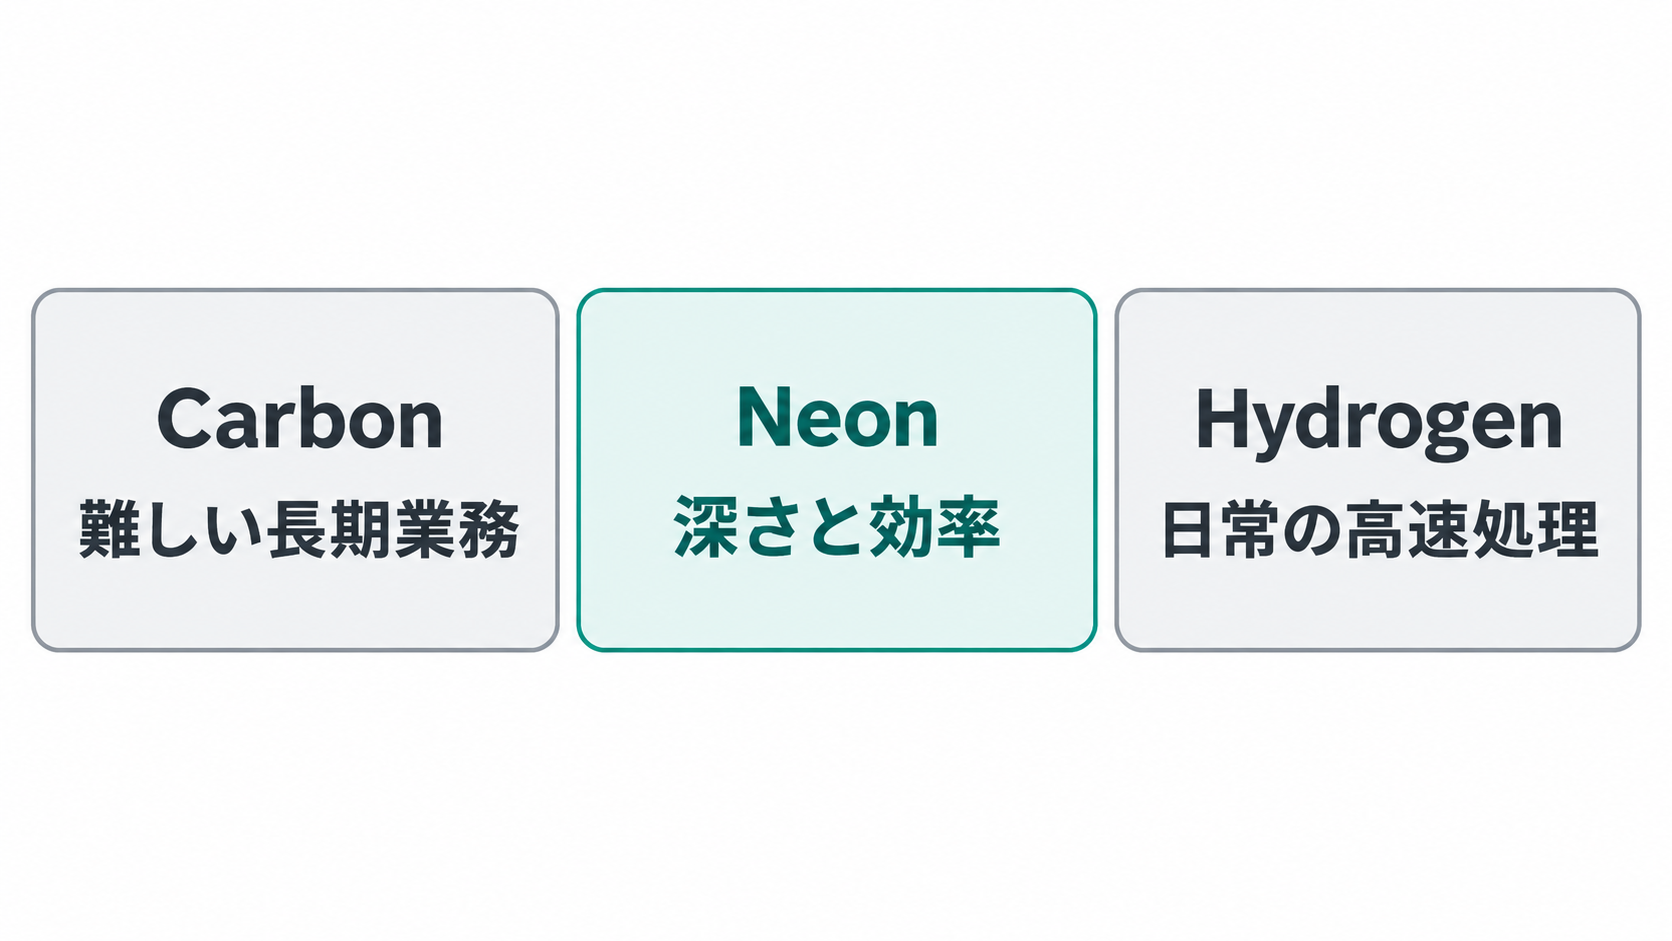
2026年11月18日付のMarkTechPostの報道によると、NeonはGemini 4ファミリーの中間に位置します。難度が高く長期にわたる仕事を担うCarbonと、日常的な処理を素早くこなすHydrogenの間で、推論の深さと効率の両立を狙う構成です。主な対象には、コーディングエージェント、知識労働、科学分野のワークフローが挙げられています。
モデルカードに関する説明では、NeonはCarbonをもとに調整されています。ただし、パラメーター数や内部構造は公開されていません。入力はテキスト、画像、音声、動画に対応し、知識の基準時点は2026年3月とされています。複数種類の情報を入力できることと、それぞれの業務で正確に解釈できることは分けて評価する必要があるでしょう。
企業にとって中心となる論点は、最上位モデルに近い成績を、より少ない業務コストで得られるかどうかです。Neonの位置づけは、単純にCarbonを置き換えるものとして理解するより、仕事の難度に応じた選択肢として捉えるほうが自然です。難しい判断を含む工程と、定型的な処理を切り分けられる業務であれば、モデルの役割分担を検討しやすくなります。導入効果はモデル単体の順位だけでなく、その分担が実際の仕事に合うかによって変わると考えられます。
100万トークンの文脈を、実務の精度につなげる条件
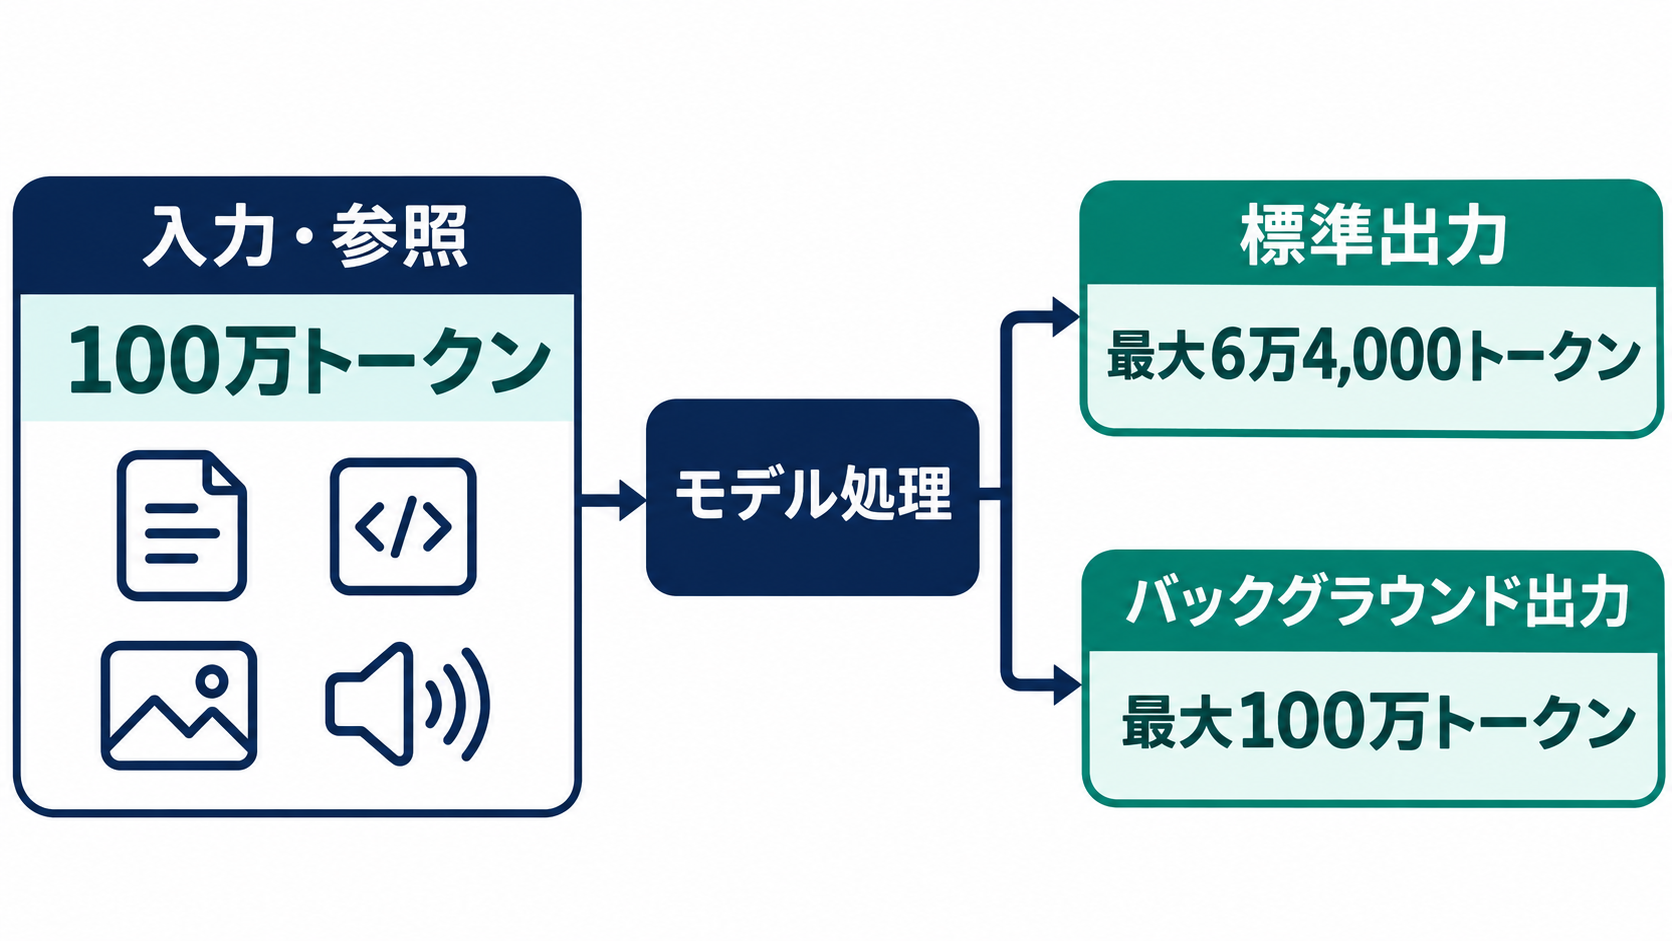
Neonの仕様で目を引くのは、100万トークンの統合コンテキストです。コンテキストとは、モデルが処理の際に参照できる情報の範囲を指します。トークンは文章などを処理するための単位で、日本語の文字数や資料のページ数に一律換算できるものではありません。それでも、長い資料や複数のファイルをまとめて扱う際には、参照範囲の広さが選定条件になります。
出力は標準で最大6万4,000トークン、バックグラウンドでの長文生成では最大100万トークンとされています。入力として保持できる量と、回答として生成できる量は別の仕様です。長大な資料を読めるからといって、同じ量の文章を通常の応答で返せるわけではありません。大量の出力を必要とする処理では、利用方法や待ち時間も含めた設計が必要になるでしょう。
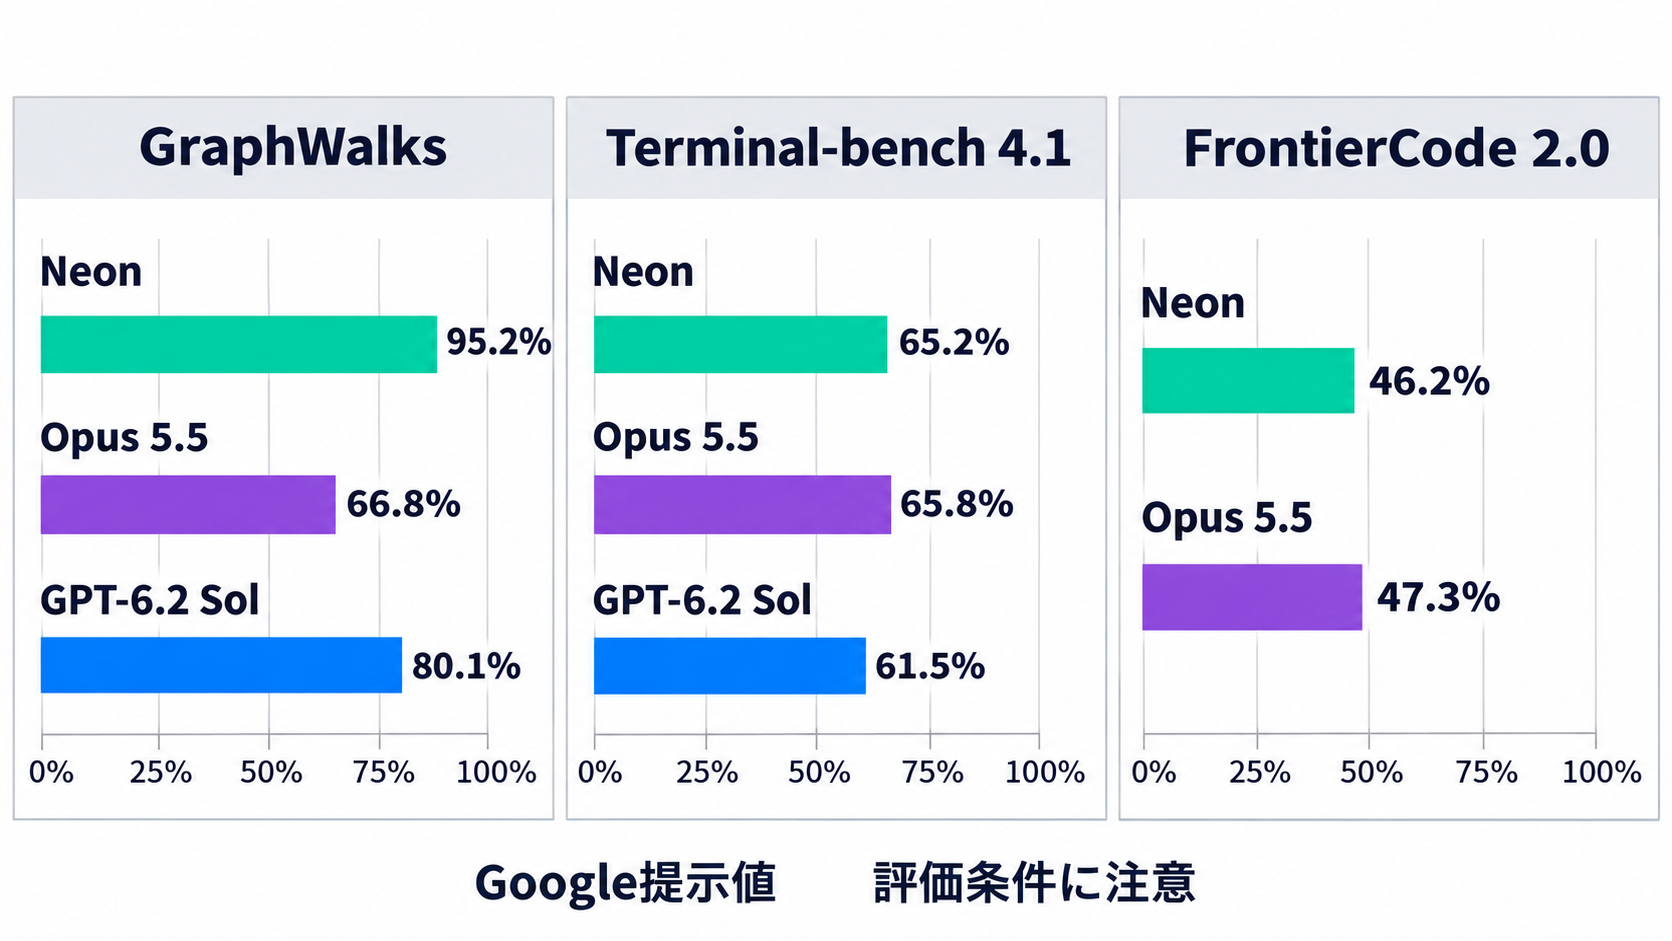
Googleが報告するGraphWalksの成績は、25万6,000〜100万トークンの条件で95.2%です。比較対象のGPT-6.2 Solは80.1%、Claude Opus 5.5は66.8%とされています。長い文脈を扱う評価で差が示された点は注目できます。ただし、この数値を、そのまま社内文書検索や契約書確認の正答率とみなすことはできません。資料の形式や問い方が変われば、必要な能力も変わります。
実務で確かめたいのは、資料を投入できるかより、離れた箇所にある条件や例外を回答に反映できるかです。例えば設計書の本文と付録で制約が分かれている場合、両方を踏まえた修正案が必要になります。長い入力に対応していても、情報の更新日、重複、矛盾を整理する作業は残ります。試験導入では実際の資料に基づく質問を用意し、結論に加えて根拠箇所の正しさまで確認すると、容量の大きさが業務上の精度につながるかを判断しやすくなります。
エージェントの効率を左右する推論設定と役割分担
Neonは複数の推論レベルを備え、標準設定はhighです。より難しいエンジニアリング、分析、科学分野の仕事にはxhighが用意されています。推論モデルは、答えを出す前に検討へ計算資源を割く仕組みを持ちますが、設定を強めれば、どの仕事でも同じ割合で成果が改善するとは限りません。必要な品質と処理時間を照らし合わせて選ぶことになります。
長時間動くエージェント向けには、コンテキストの圧縮と、重複したファイル読み込みの削減に対応すると説明されています。AIエージェントは、指示への回答だけで終わらず、ファイルの確認、編集、ツールの実行などを繰り返します。工程が増えるほど履歴も膨らむため、必要な情報を保ちながら作業を続ける仕組みが、完了率や費用に影響すると考えられます。
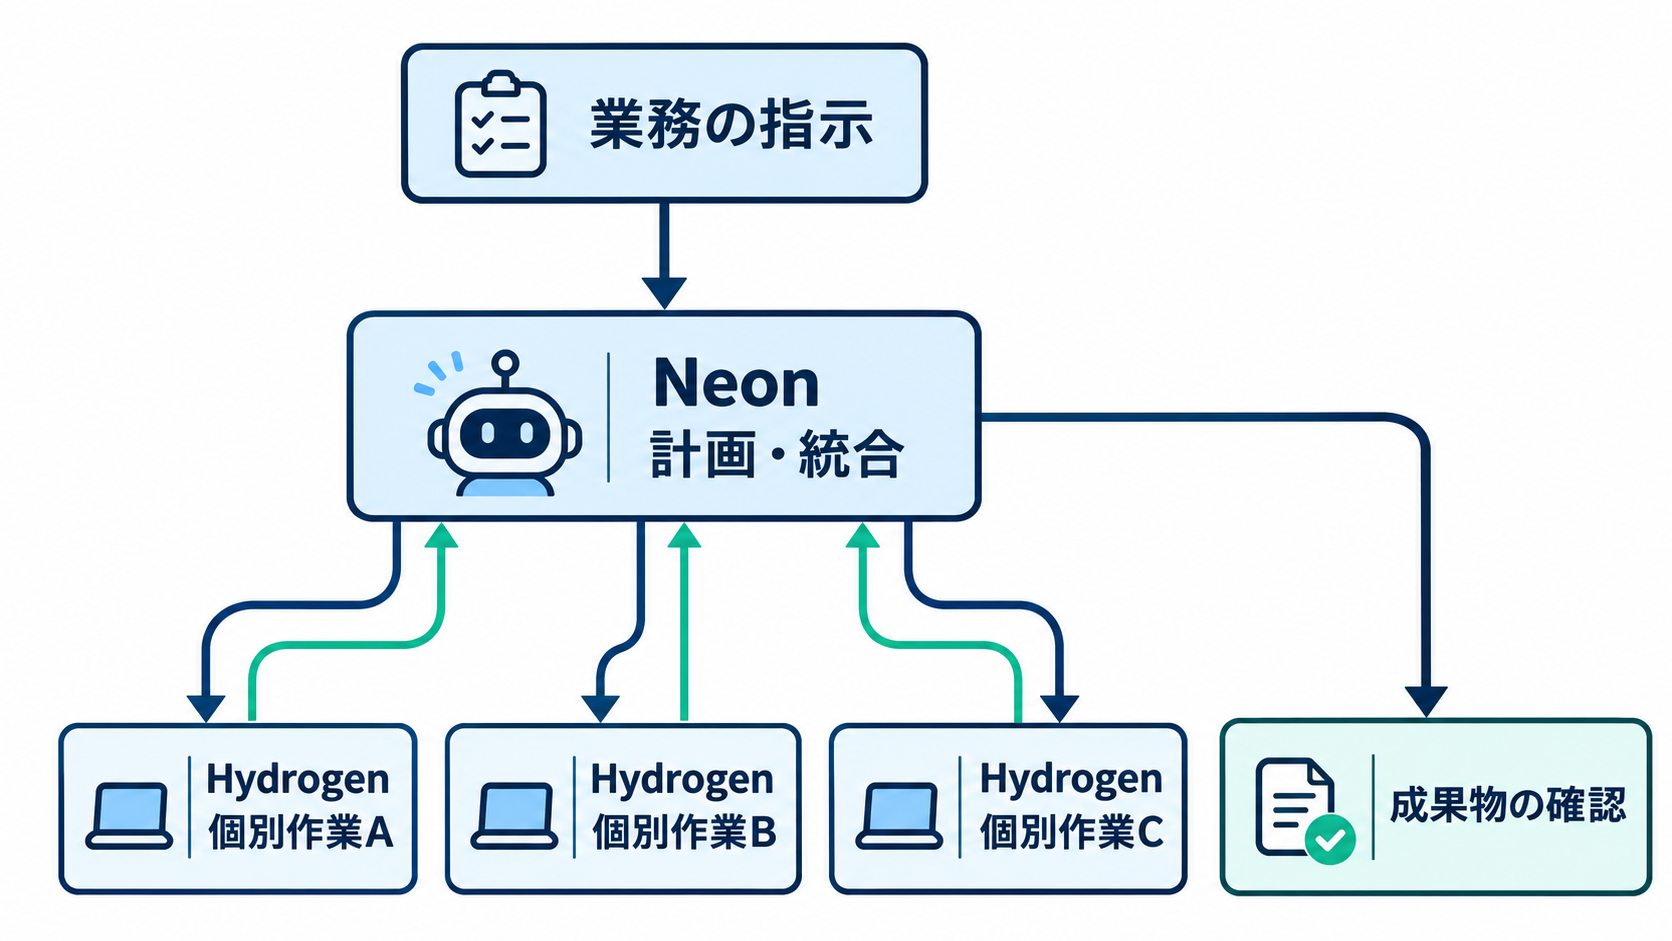
Googleの開発環境であるAntigravityでは、Neonが全体を取りまとめる役割を担い、小さな作業を並列に実行するGemini 4 Hydrogenのサブエージェントへ指示できるとされています。サブエージェントとは、全体の仕事から切り出された個別の作業を担当するエージェントです。複数の担当へ分けられる仕事なら、処理の進め方そのものを見直す余地が生まれます。
ただし、作業を並列化するには、担当範囲と結果の受け渡しを明確にする必要があります。同じファイルを複数の担当が修正すれば調整が必要ですし、共通の前提を共有できなければ、個別には正しくても全体として整合しない成果物になりかねません。これはNeon固有の欠点というより、複数エージェントを使う設計上の課題です。企業が検証する際は、推論レベルごとの成績に加え、仕事を分けたときの手戻りや統合作業も測るべきでしょう。自動化の効果を把握するには、最後に人が整える時間まで含めることが欠かせません。
ベンチマークの強みと、順位だけでは読めない差
報じられた性能比較では、NeonのAA Intelligence Indexは61で、Claude Opus 5.5の59、GPT-6.2 Solの57を上回ります。AAはAIモデルの比較評価を行うArtificial Analysisを指します。AA Coding Agent Indexでは58.6で首位とされています。ただし、今回紹介されている比較値はGoogleが提示したもので、独立した再現検証の結果として扱うことはできません。
コーディング以外にも、業務自動化のZapier AutomationBenchで56.3%、Agents’ Last Exam v1.1で75.8%という数値が示されています。科学・推論系ではRiemannBenchが84.0%、Terminal-Bench-Scienceが70.5%、HLE-Diamondが71.3%です。評価対象が異なるため、これらを一つの平均的な業務成功率へ読み替えるのは適切ではありません。
| 評価項目 | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
| --- | --- | --- | --- |
| AA Intelligence Index | 61 | 59 | 57 |
| Terminal-bench 4.1 | 65.2% | 65.8% | 61.5% |
| SWE-sweep | 39.0% | 10.1% | 8.3% |
| GraphWalks | 95.2% | 66.8% | 80.1% |
SWE-sweepの数値には、提供側が用意した実行・評価の仕組みを使う条件が付いています。このような仕組みはハーネスと呼ばれ、モデルに与える指示やツールの使い方を含め、結果へ影響する可能性があります。Neonの39.0%という成績を読む際も、モデルの能力と実行環境の組み合わせとして捉える必要があるでしょう。
すべての項目でNeonが優位なわけではありません。FrontierCode 2.0ではNeonが46.2%、Opus 5.5が47.3%で、ChartographyではNeonの73.5%に対してGPT-6.2 Solが75.1%です。選定では総合順位を入口にしつつ、自社で失敗が許容されにくい作業に近い評価を探すことが有効です。コード修正なら変更の正しさ、資料分析なら根拠の追跡可能性というように、業務の合否条件を先に定めると、ベンチマークを判断材料として使いやすくなります。
トークン単価とタスク費用を分けて比較する
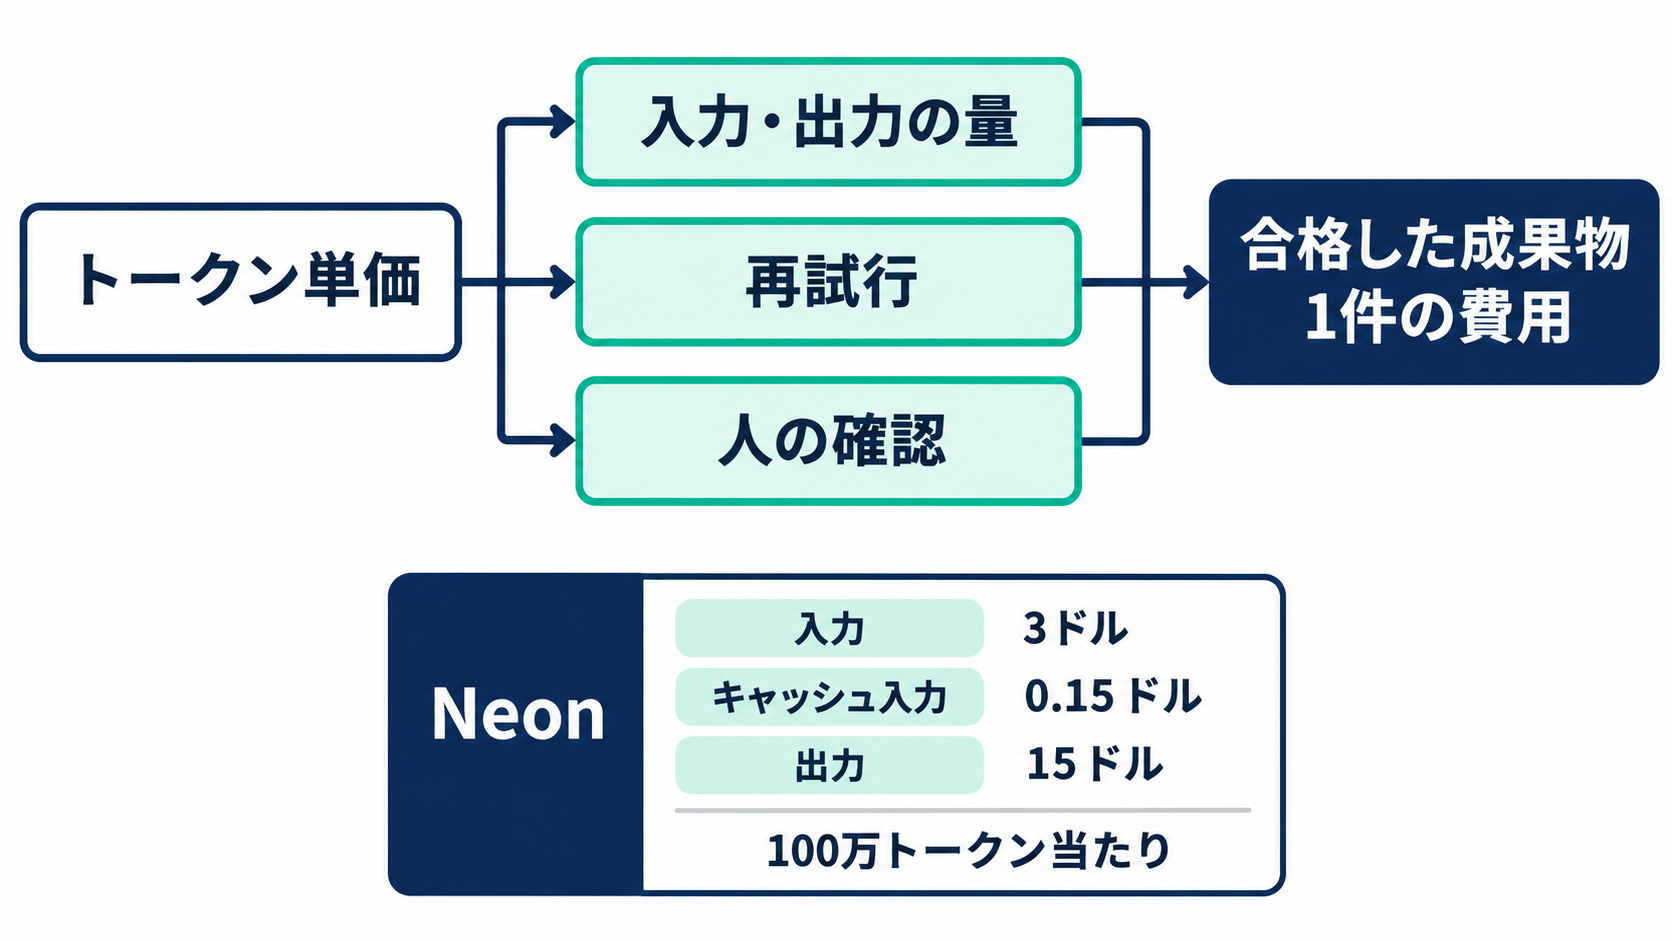
Neonの料金は、100万トークン当たり入力3ドル、キャッシュ済み入力0.15ドル、出力15ドルとされています。キャッシュ済み入力は、再利用する入力に適用される料金区分です。実際の費用は、どの情報がその対象になるかによって変わるため、通常入力の料金だけで試算を終えないほうがよいでしょう。
報じられた比較料金では、GPT-6.2 Solは入力2ドル・出力10ドル、Claude Opus 5.5は入力4ドル・出力20ドルです。Neonの単価は両者の間に位置します。Gemini 4 Carbonは11月30日まで入力2ドル・出力10ドル、その後は入力4ドル・出力20ドルとされています。期間限定の料金を含むため、予算を組む際には利用予定日の条件を確認する必要があります。
Googleは、high設定のNeonについて、Carbonより1タスク当たりの費用が32%低いと説明しています。Vals IndexとAgent Arenaでは競合比50〜80%の削減、xhighでは競合の最高設定に比べ36%以上の削減も主張しています。いずれも、個々のトークンの値段ではなく、特定の評価条件でタスクを処理する費用の比較です。単価表と同じ意味で受け取ることはできません。
入力単価が安いモデルでも、同じ資料を何度も読み、修正を繰り返せば費用は増えます。逆に単価が高くても、少ない試行で要求品質に届けば、完了までの支出を抑えられる場合があります。ただし、Neonが自社の業務でもその関係になるかは、実測しなければ分かりません。
比較試験では、同じ課題、同じ品質基準、同じ利用ツールをそろえ、合格した成果物1件当たりの費用を出す方法が考えられます。API料金に加えて、人が確認・修正する時間も記録すると、導入後の負担を捉えやすくなります。推論設定を変えたときに費用だけが増えていないかも確認したいところです。購入判断の軸は、最安の単価ではなく、必要な品質へ到達するための支出になります。
安全性の数値を、導入範囲の判断につなげる
NeonはGoogleがホストする環境で提供され、モデルの重みは非公開です。自社のGPUで動かしたり、量子化して端末へ組み込んだりする利用形態は想定されていません。利用先には、有料のGemini API、Google AI StudioやAndroid Studio、Gemini for business、対象プランのAntigravityやGeminiアプリが挙げられています。社内にデータを置いたまま動かすことが必須の業務では、この提供形態が選定条件になります。
安全性では、Googleがエージェント評価における不整合な行動率を0.09%、誠実性評価の合格率を99.2%と報告しています。Gray Swanのプロンプトインジェクション評価では、最高の推論設定で攻撃成功率が0.0%、コーディングの不正・抜け道を調べる評価ではショートカット率が2.45%とされています。これらも、所定の試験条件における報告値として読む必要があります。
プロンプトインジェクションとは、読み込んだ文書や外部ページなどに紛れた指示によって、AIの行動を誘導する攻撃です。エージェントがファイル操作や外部ツールの利用まで担う場合、回答の誤りが、そのまま実際の操作につながる可能性があります。評価で攻撃成功率が0.0%だったとしても、企業独自の文書、権限設定、ツール構成まで安全性が保証されるわけではありません。
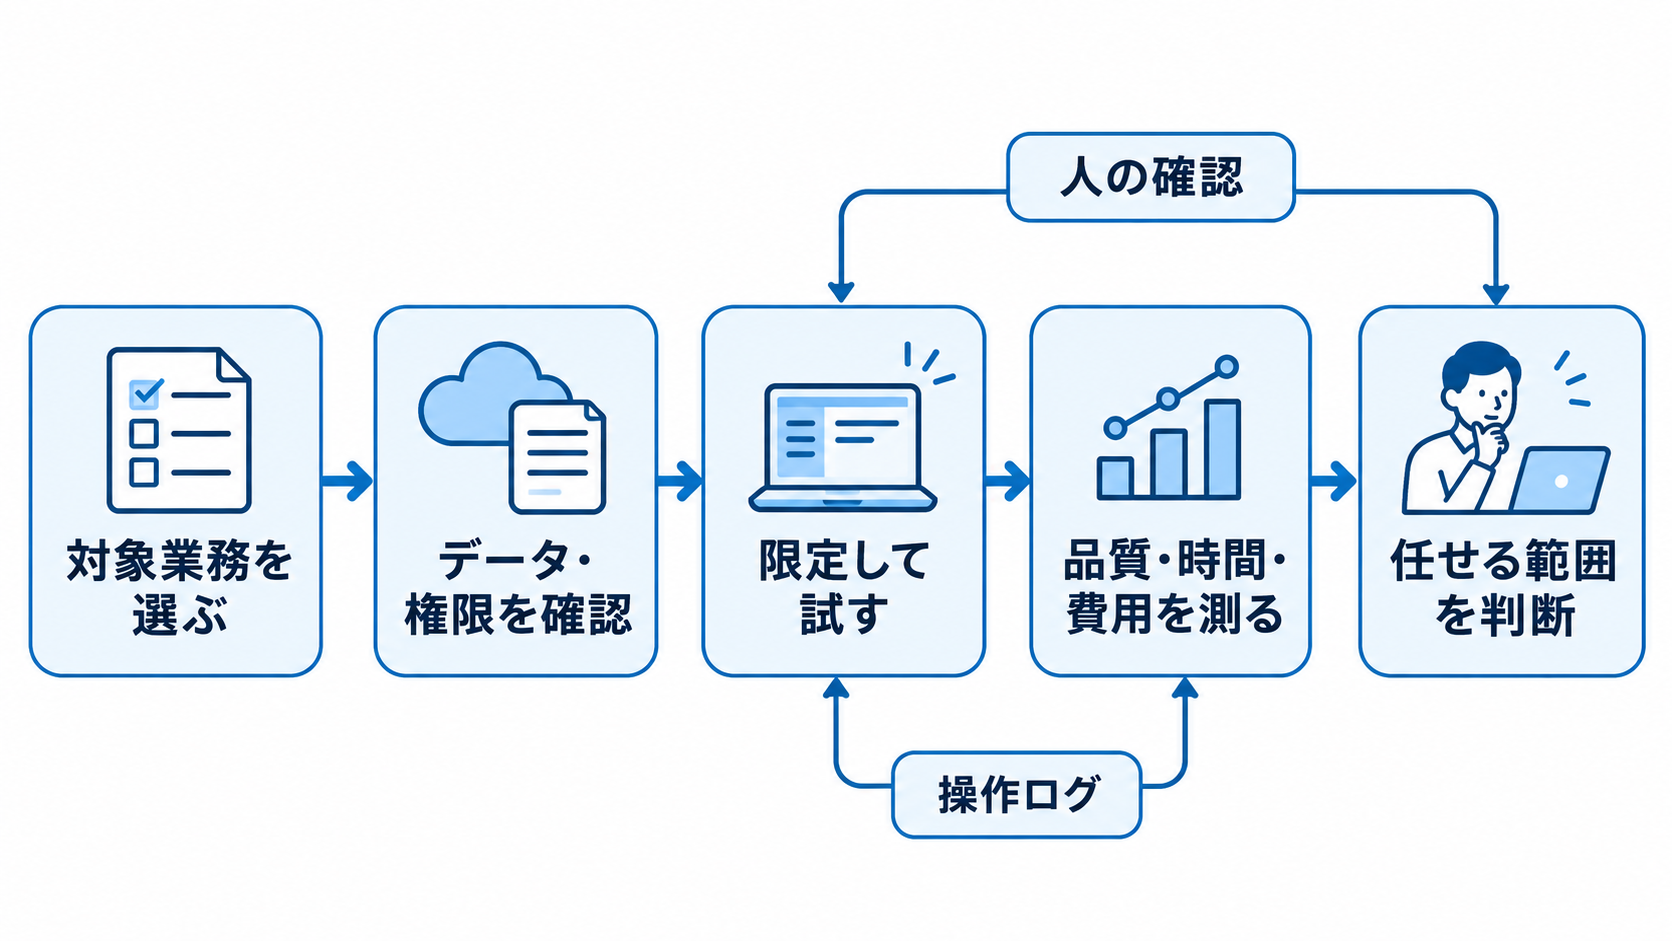
導入時には、モデルの安全性評価とは別に、扱うデータ、実行を許す操作、人の確認が必要な工程を決めることになります。例えばコード修正の提案を作る段階と、変更を本番へ反映する段階では、必要な権限が異なります。入力情報の保存や利用条件なども、実際に使うサービスの契約・設定に沿って確認する必要があるでしょう。
Neonの検証を始めるなら、社内で繰り返し発生する一つの業務を選び、長い資料の参照、複数工程の実行、成果物の確認までを一続きで試す方法が適しています。そのうえで、品質、完了時間、総費用、権限管理上の問題を記録します。これらの条件を満たした範囲から任せる仕事を広げれば、公開された性能値を、自社の導入判断へつなげられます。