

2026/11/20
AIニュース
Claudeでリーマン予想を証明と研究者が主張、焦点は25万ページ超の論証の検証へ
この記事の要点
Anthropicの研究者Levent Alpöge氏は、Claudeと共同でリーマン予想とその一般化された形の証明を発見したと主張しています。報道によると論証は25万ページ超で、Leanによるコードも公開されていますが、独立した検証の完了は確認できません。企業が注目すべき点は、AIの回答を第三者が検査できる仕組みです。
目次
Anthropic研究者が個人サイトで発表、解決の確定とは区別
生成AIが数学の難問を解いたという知らせを受けたとき、企業の技術担当者が確かめたいのは、何を根拠に成果を評価できるかでしょう。Anthropicの研究者Levent Alpöge氏は2026年11月20日、同社の生成AI「Claude」と共同でリーマン予想の証明を発見したと考えていることを、個人サイトで明らかにしました。数学の長年の未解決問題に関する発表ですが、この段階では研究者による証明の主張として受け止める必要があります。
Alpöge氏が公表した声明は4ページです。SiliconANGLEの報道によると、同氏はClaudeとの研究過程に強い驚きを示し、科学研究の変化を予感する見方を述べています。ただし、同報道の時点でAnthropicによる公式発表はありません。所属研究者の発言と、企業が正式に確認した研究成果は、情報の位置づけが異なります。
同氏は、通常のリーマン予想だけでなく、その一般化された形も証明の対象に含まれると説明しています。論証の規模は25万ページを超え、数学の証明をコンピューターで検査するための言語「Lean」で記述したコードも公開したと報じられました。人が読むための論文は、報道時点では未公開です。
企業にとっての関心は、AIがどれほど難しい問題に挑めるかに加え、その答えを第三者が点検できるかにあります。今回確認できた情報だけでは、独立した検証の完了までは確認できません。発表の規模感に目を奪われず、公開物、検証の方法、専門家による評価を分けて追うことが、このニュースを理解する出発点になります。
リーマン予想が問うのは、素数の分布とゼータ関数の関係
リーマン予想は、ドイツの数学者ベルンハルト・リーマンが1859年に提示した問題です。直接の対象は「リーマンゼータ関数」という関数ですが、その重要性は素数の分布との関係にあります。素数とは、2、3、5、7のように、1と自分自身以外の正の整数では割り切れない整数です。数直線上で素数が現れる間隔は一定ではなく、その現れ方をどこまで正確に捉えられるかが研究の焦点になります。
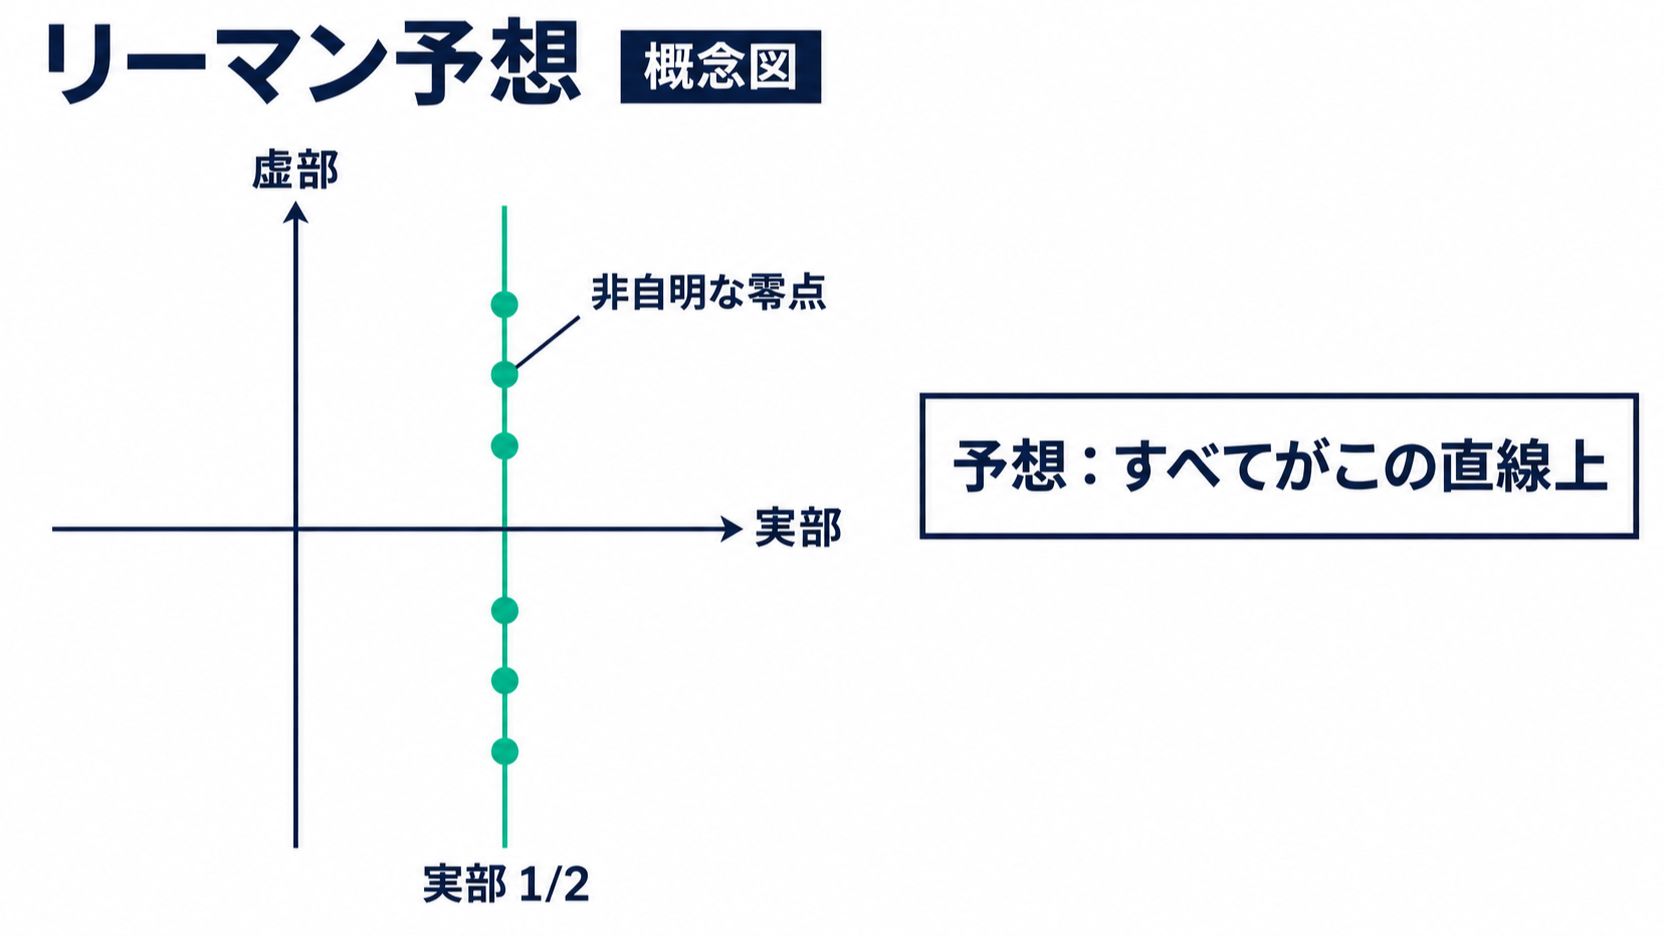
関数は、入力に応じて出力を返す数学的な規則と考えると理解しやすいでしょう。リーマンゼータ関数では複素数を扱います。複素数には実部と虚部があり、平面上の点として表せます。その関数の出力がゼロになる入力を「零点」と呼び、リーマン予想は、そのうち「非自明な零点」と呼ばれるものが、すべて実部2分の1の直線上にあると主張します。あらゆる零点を無条件に対象とするわけではありません。
この直線が素数と結びつく理由は、ゼータ関数の性質が素数の分布に関する情報を持つためです。米国のクレイ数学研究所は、素数の平均的な分布を示す素数定理に対し、リーマン予想は平均からのずれに関わる問題だと説明しています。単純な等間隔の規則が見つかるという意味ではなく、分布のばらつきを数学的にどこまで抑えられるかが論点です。クレイ数学研究所の解説
ここでは、数多くの例を計算して確かめることと、証明することの違いも欠かせません。有限個の零点が直線上に見つかっても、その先に例外がないとは限りません。求められるのは、対象となるすべての零点について成立する論理です。この厳しさを踏まえると、AIがもっともらしい数式や大量の計算結果を生成することだけでは、解決を判断できないと分かります。
一般化された予想への主張は、対象範囲の確認が必要
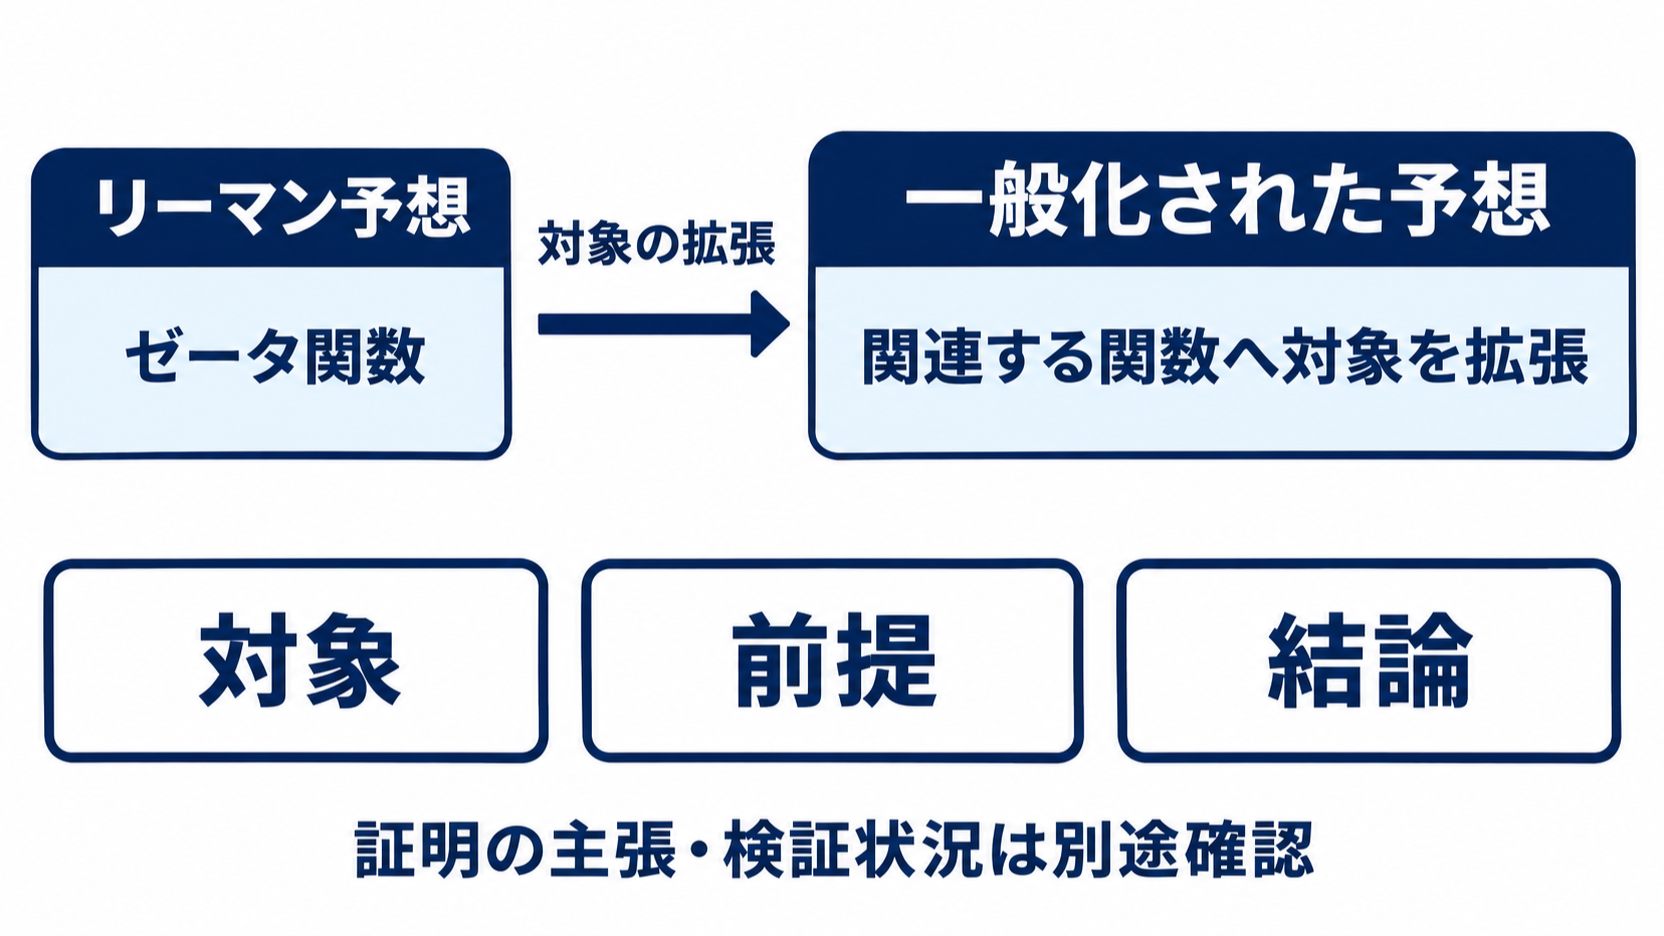
Alpöge氏の主張には、通常のリーマン予想に加えて、一般化されたリーマン予想も含まれています。通常の予想がリーマンゼータ関数を対象にするのに対し、一般化された予想は、関連する別の関数にも同様の性質を考えます。対象が広がるため、通常の予想と一般化された予想では、証明したとする内容の範囲が異なります。
この違いは、企業の研究開発でもなじみのある問題に置き換えられるでしょう。ある条件の下で成立する手法が、条件を広げても成立するとは限りません。対象を拡張するほど、追加の条件や例外の扱いを確かめる必要があります。数学でも、何を定義し、どの範囲の対象について結論を導いたかが、成果の意味を決めます。
SiliconANGLEによると、Alpöge氏は将来、Claudeがさらに広い形の予想も証明できるとの期待を示しています。ただし、現在の証明に関する主張と、今後の能力への見通しは切り分けて読むべきです。将来への期待によって、今回公表した論証の正しさが補強されるわけではありません。検証の際には、実際に形式化された命題と、発表で説明された対象範囲が一致するかが問われます。
リーマン予想が成立するという仮定の下で導かれている数学的な結果にも、影響が及びます。その仮定自体が証明されれば、該当する結果を条件なしで扱う道が開けるためです。ただし、これを数学のあらゆる未解決問題が一度に解消される話と捉えるのは適切ではありません。どの成果が、どの予想を前提としているかによって、影響の範囲は変わります。
企業が研究成果を社内で紹介する際も、「一般化」という言葉だけで広く使える技術だと判断することは避けたいところです。対象、前提、結論を一組で確認すれば、数学上の成果の大きさと、自社の課題への適用可能性を混同せずに評価できます。
Leanは論理を検査する仕組み、正常終了だけでは判断できません
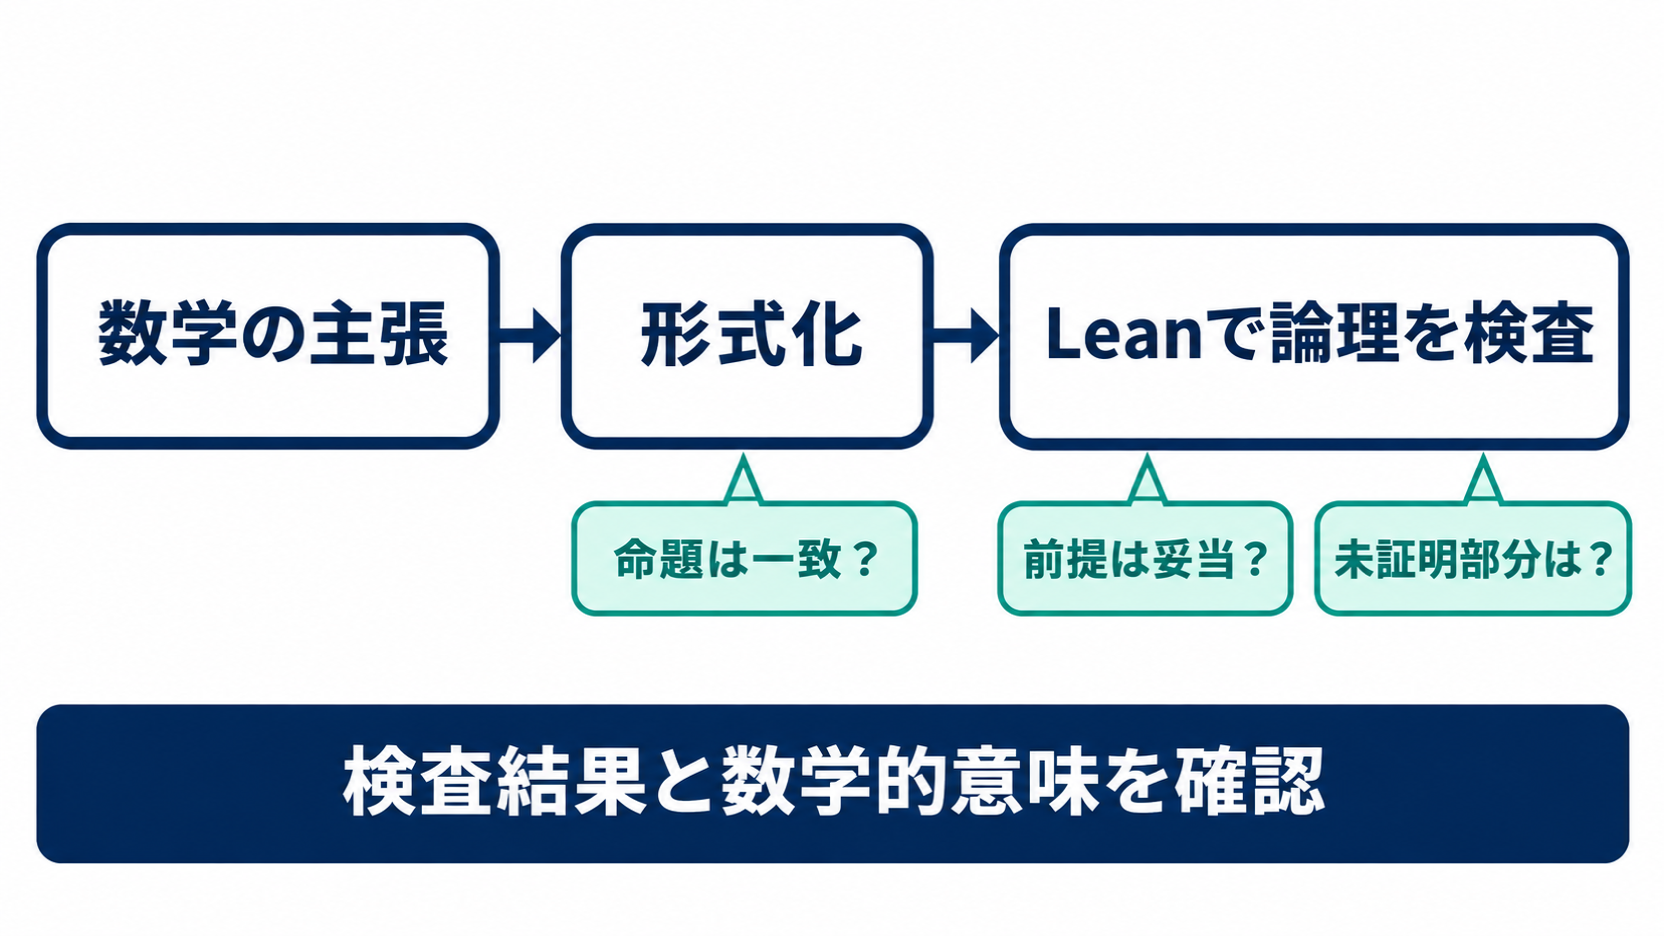
今回の発表で実務的にも関心を引くのは、Leanによる記述が公開されたと報じられている点です。Leanは数学の命題や証明を形式的な言語で表し、論理のつながりをコンピューターで検査するために使われます。自然言語の説明では省略されがちな手順まで明示し、定義や前提から結論が導けるかを確認する仕組みです。
ただし、「プログラムが異常終了しなければ、目的の数学的主張が証明された」と理解すると、確認すべき点を取りこぼします。形式化した命題が、本来証明したい内容を正確に表しているかという問題があるためです。コンピューターが検査するのは記述された命題であり、発表文の意図まで自動的に保証するわけではありません。
前提の監査も必要です。Leanの公式資料は、証明が依存する公理を追跡できることや、未完成の証明を一時的に置くための「sorry」が存在することを説明しています。完成した証明に、そのような未証明の部分が残っていないか、結論を事実上仮定していないかを確かめる必要があります。公理を使うこと自体が直ちに問題なのではなく、どの前提に依存しているかが判断の対象です。Lean公式資料「Axioms」
これは今回公開されたコードに欠陥があるという指摘ではありません。形式的な証明を評価する際の一般的な確認事項です。公開されたファイルがあること、適切な条件で検査が通ること、その結果が目的の予想を証明していることは、それぞれ別の確認になります。
企業の生成AI活用にも同じ考え方を応用できるでしょう。AIに回答を作らせる工程と、その回答を定めた規則で点検する工程を設計上分けると、何を保証できるかが明確になります。ただし、数学のように命題を厳密に表せる領域と、解釈や判断を含む業務では条件が違います。Leanの存在を、生成AI全般の正確性を保証する根拠に広げることはできません。
25万ページ超という規模が示す、検証と理解の別々の負担
SiliconANGLEは、Alpöge氏が説明した証明の規模を25万ページ超、Leanのコードを数百万行と報じています。これほどの分量になると、研究者が全体を順番に読み、個々の推論を確認する作業には大きな負担が生じるでしょう。形式的な検査への関心が高まる理由も、そこにあります。
もっとも、ページ数やコード行数は、そのまま成果の信頼性を示す指標にはなりません。長さだけでは、論証が妥当か、既存の知識をどれだけ含むか、独自の発見がどこにあるかを読み取れないためです。同じ結論でも、記述の仕方や手順の細かさによって分量は変わり得ます。数字は検証作業の規模を考える材料にはなっても、証明の評価そのものには代えられません。
検査が成功することと、研究者が仕組みを理解することにも違いがあります。形式的な検査は論理のつながりを確かめる役割を担いますが、なぜその発想が有効なのか、どの部分を別の問題に応用できるのかといった理解には、整理された説明が役立ちます。数学的な成果を後続の研究に結びつけるには、正しさと見通しのよさの両方が関わるでしょう。
今回、Claudeがどの工程でどれだけ貢献し、人がどこを修正したかという詳細は、提供された情報からは把握できません。使われたモデルや計算資源など、企業が再現性や費用を見積もるための条件も、現時点では詳細が明らかにされていません。共同研究の成果に関する主張から、一般的な業務で同じ能力を再現できると判断するには、情報が足りません。
研究開発部門が今後の公開物を見る際には、証明の中心となる考え方の説明、実行環境や依存関係、独立した検査の記録が評価材料になります。巨大な成果物を生成できることに加え、第三者が確かめ、理解し、再利用できる形で渡せるかが、研究支援AIの実用性を左右すると考えられます。
日本企業が試すなら、AIの提案と検査結果を一組に
日本企業が今回のニュースから引き出せる実務上の論点は、「AIが難問を解いたらしい」という期待だけではありません。生成した答えに対して、どのような検査を付けられるかという設計の問題です。証明の主張が最終的にどう評価されるかを待つ間にも、自社の業務で何を検証可能にできるかは検討できるでしょう。
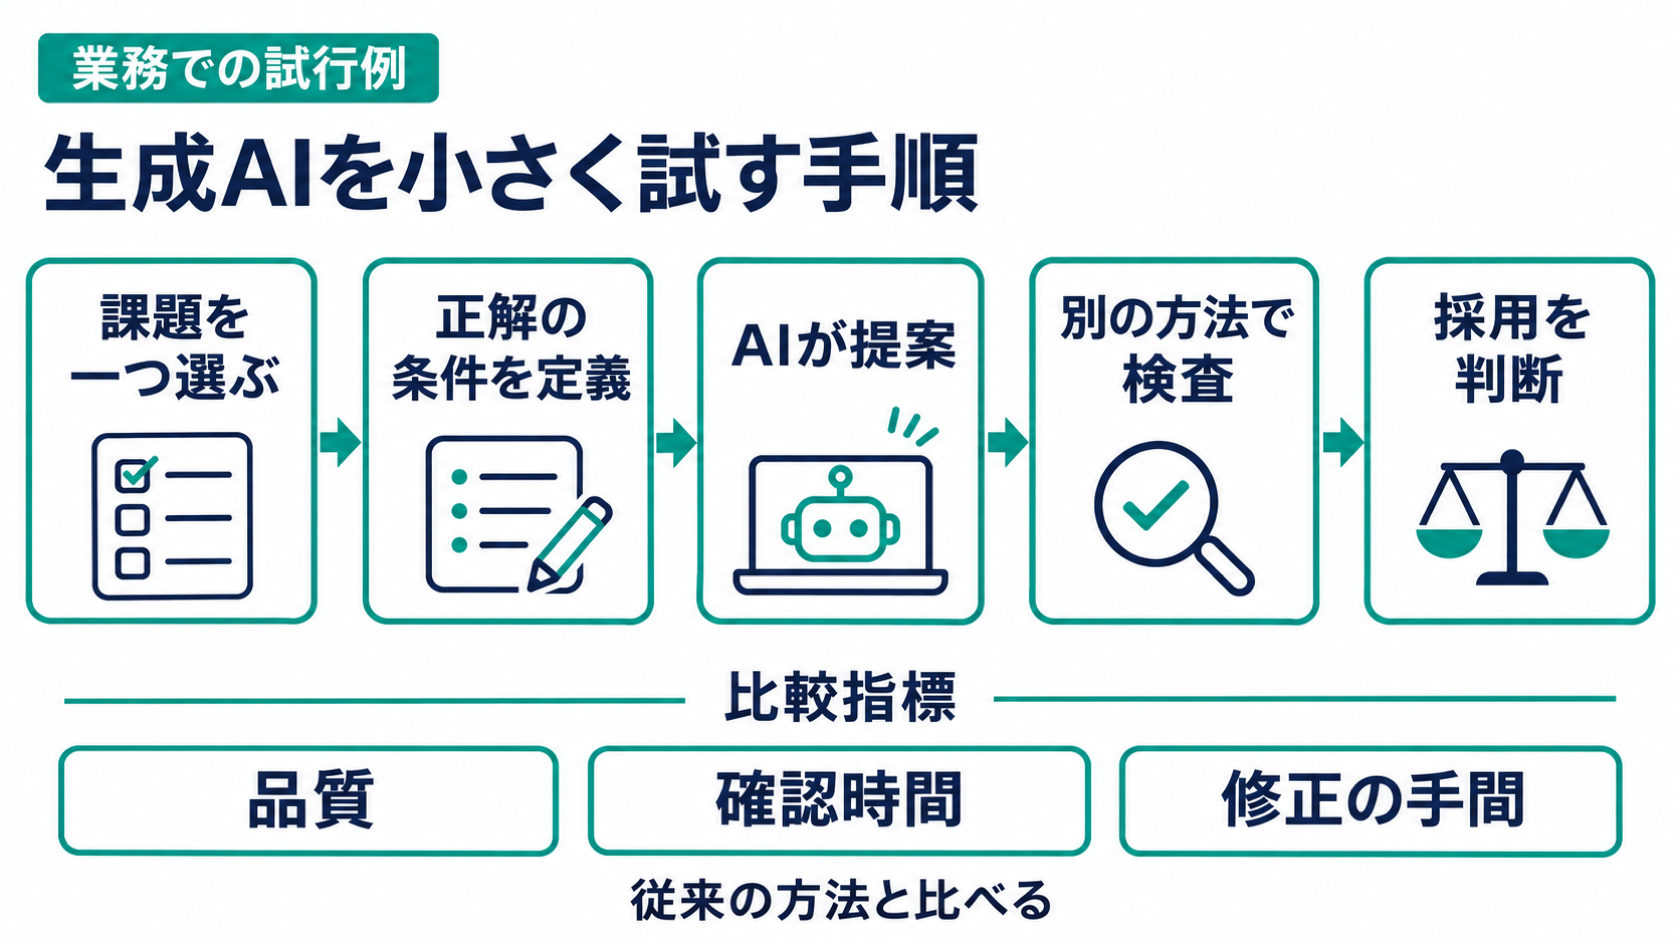
試行するなら、正解の条件を比較的明確にできる小さな課題が適しています。例えば、仕様が決まっている処理のコード作成や、制約が明示された計算問題では、AIの提案をテストや別の計算で確かめる設計が考えられます。これは今回の成果から効果が実証された活用法ではなく、生成と検証を組み合わせるという観点からの実務上の提案です。
評価時には、見栄えのよい回答が得られたかだけでなく、定めた条件を満たすか、確認にどれだけ時間がかかるか、修正を含めた作業量が減るかを見ます。AIの出力が増えても、人の点検負担がそれ以上に増えれば、業務全体の改善にはつながりません。検査の条件や記録を残すことで、担当者が替わっても判断の根拠を追いやすくなります。
専門家の役割も、最後に承認するだけでは足りない場合があります。何を満たせば正解かを定義し、検査から漏れる条件を見つけ、結果の意味を解釈する仕事があるためです。数学では命題の定義や前提が問われるように、業務では仕様や評価基準の置き方が結果を左右します。人による判断が必要な箇所を、導入前に明確にしておくべきでしょう。
着手するなら、現在人が確認に時間を使っている作業を一つ選び、入力、正解の条件、検査方法を短く書き出してみてください。そのうえで、AIを使った場合の成果と確認時間を、従来の方法と比べます。リーマン予想の証明に関する評価は追い続けつつ、自社では答えを確かめられる課題から試すことが、次の判断につながります。