

2026/11/17
AIニュース
NvidiaがRubin HPCを発表、科学研究AIの焦点は「仮説を検証する計算」へ
この記事の要点
NvidiaはSC26で、2028年出荷予定のRubin HPCと科学研究向けソフトウェア群を発表しました。焦点は、AIが提案する仮説をシミュレーションや解析で検証する工程の高速化です。宇宙物理、生物学、研究向けモデル、量子計算の発表を整理し、日本企業が自社の研究工程で導入効果を評価する視点を紹介します。
目次
AIの提案を検証するシミュレーションが研究の焦点に
AIが研究上の仮説を提案しても、その妥当性を確かめる計算に時間がかかれば、研究全体の速度は上がりません。Nvidiaが高性能計算・スーパーコンピューター分野の会議「SC26」で発表した製品群は、この検証の工程を加速する取り組みです。米シカゴで披露した新GPU「Rubin HPC」に加え、宇宙物理、生物学、核融合、量子計算を支援するソフトウェアをそろえています。
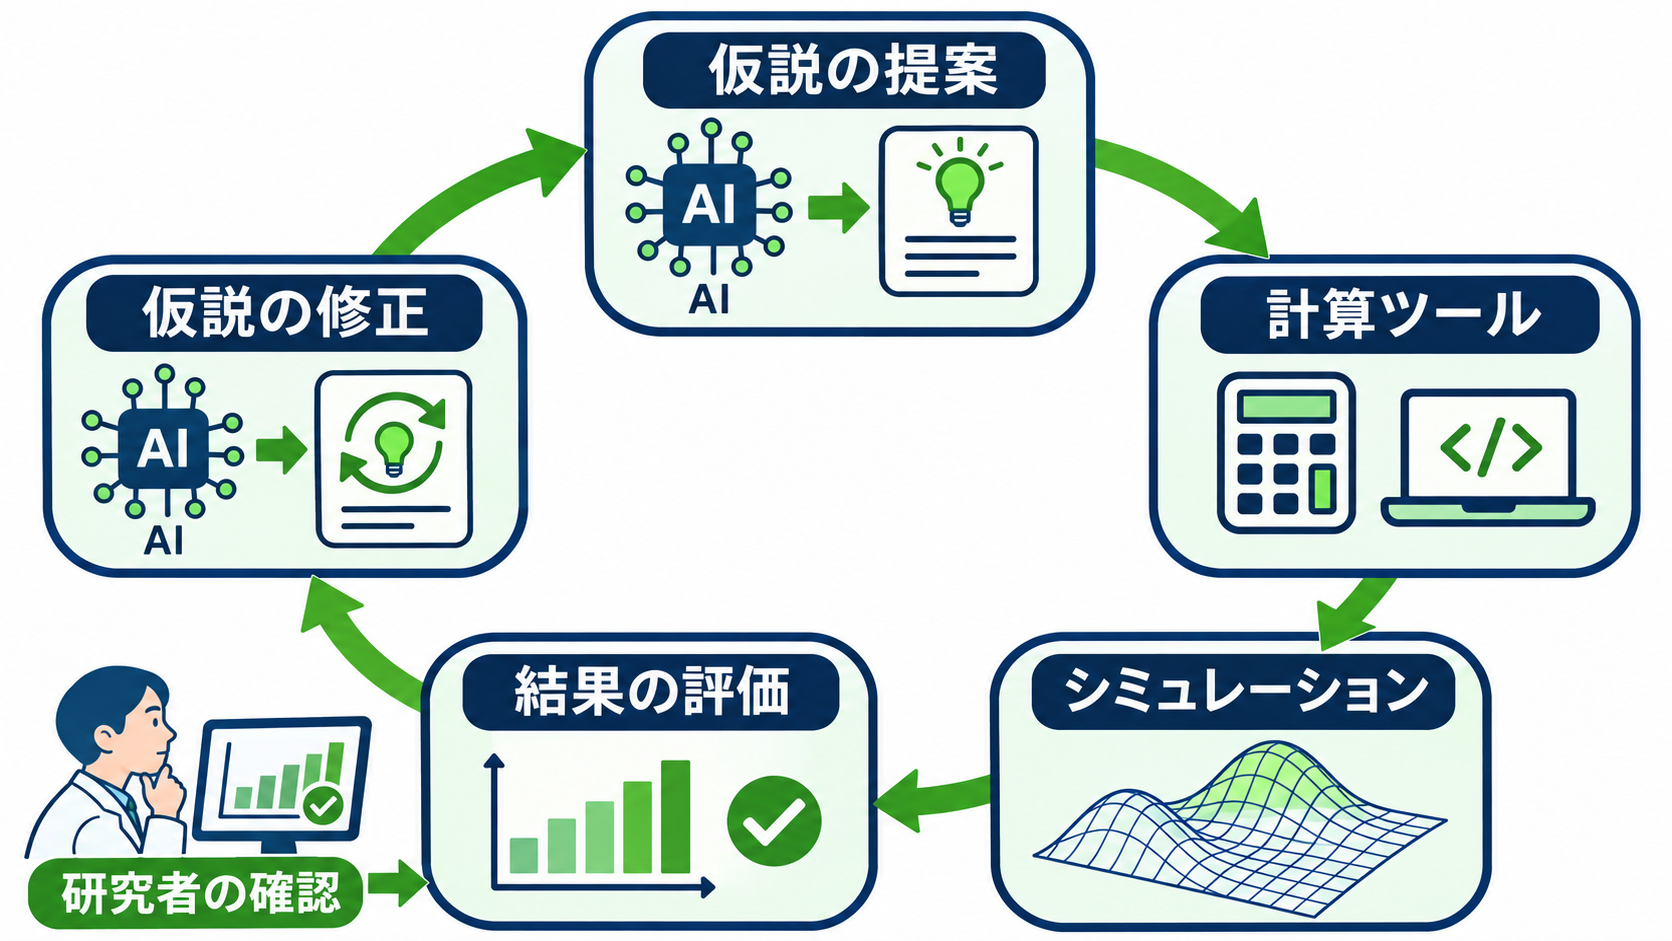
生成AIの企業活用では、文章の作成や情報の検索がわかりやすい用途です。しかし、科学研究では説明が自然であることと、仮説が物理的・生物学的に成立することは別の問題です。モデルが考えた案をシミュレーションやデータ解析に渡し、その結果を受けて次の案を考える仕組みが必要になります。今回の発表は、その一連の工程をGPUと専用ソフトウェアで支える構成として読み解けます。
Nvidiaでハイパースケールおよび高性能計算部門を担当する副社長のイアン・バック氏も、科学・工学に取り組むエージェントにとって、シミュレーションの高速化が発見の加速につながると説明しています。ここでいうエージェントは、目的に応じて外部ツールを使いながら処理を進めるAIを指します。
企業の研究開発部門にとっての論点は、AIモデル単体の賢さだけではありません。検証用の計算をどこまで短時間で実行できるか、結果を次の判断につなげられるかが、実務での価値を左右するでしょう。ただし、今回の発表だけで研究全体の自動化が実現したとは判断できません。計算の高速化と、研究成果の妥当性の確認は、分けて評価する必要があります。
Rubin HPCはCUDAコアを増強、出荷予定は2028年
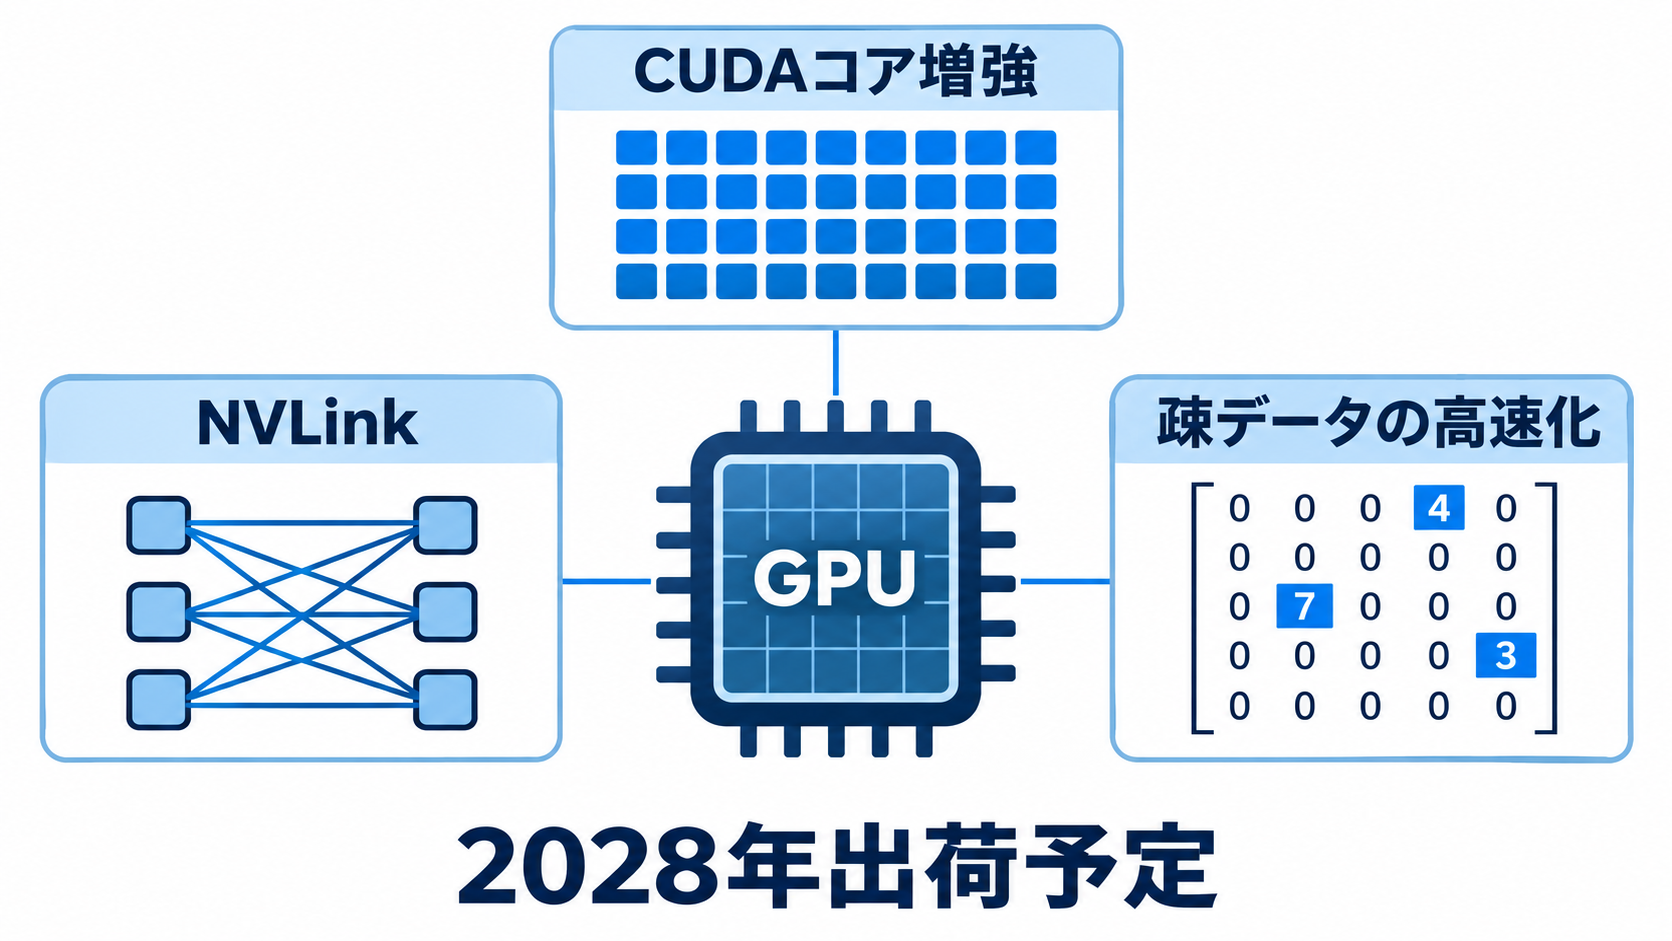
Rubin HPCは、科学技術計算を対象とする今後のGPUです。Nvidiaは5万基を超えるCUDAコアを搭載すると説明しており、比較対象として示されたRubin GPUの2万8,000基超から増強されます。CUDAコアはGPU上で並列計算を担う演算回路で、科学シミュレーションなどにも使われます。大規模言語モデルの処理に最適化されたTensorコアとは、役割を区別して捉えると理解しやすいでしょう。
ただし、コア数の増加率を、そのままアプリケーションの高速化率とみなすことはできません。実際の処理時間は、計算の種類に加え、メモリーからデータを読み出す速度や、計算機同士の通信、ソフトウェアの実装にも左右されます。企業が導入効果を試算するには、自社の解析処理に近い条件での評価が欠かせません。
NvidiaはRubin HPCに、新世代の接続技術「NVLink」と「疎データの高速化」機能も搭載する方針です。疎データとは、値の多くがゼロで構成されるデータを指します。科学計算では、このようなデータの性質を利用して、不要な演算やデータ転送を減らせる場合があります。すべての計算が同じ恩恵を受けるわけではなく、対象データと計算手法の適合性が評価のポイントになります。
出荷予定は2028年です。今回の発表は将来の計算基盤を検討する材料になりますが、直近の研究計画で利用できる製品として扱う段階ではありません。ハードウェア更新の検討と、既存環境で利用可能なソフトウェアの評価を並行して進めることが、現実的な進め方と考えられます。
宇宙物理と核融合では、研究分野に特化したライブラリーを拡充
科学研究向けのソフトウェアでは、Nvidiaの「CUDA-X」に複数のライブラリーが加わります。ライブラリーとは、特定の計算や処理に必要な機能をまとめ、別のプログラムから利用できるようにしたソフトウェアです。GPUを研究に使う際、各研究者が高速化の仕組みを一から実装する負担を減らす役割があります。
宇宙物理向けの「cuPhoton.xBeam」は、ブラックホールの研究に使われる観測施設のネットワーク「Event Horizon Telescope」のデータ解析を支援します。Nvidiaによると、従来は1カ月かかっていた解析処理を8分で実行できるとしています。待ち時間を短縮できれば、解析条件を変更して結果を比較する余地も広がるでしょう。
この性能値は、Nvidiaが示した対象処理に関する説明として受け止める必要があります。観測からデータの準備、解析、結果の解釈までを含む研究全体が、同じ割合で短縮されることを意味するものではありません。今回確認できる情報では、入力規模や比較に用いた計算環境などの詳細は明らかではなく、自社用途への適用には追加の確認が必要です。
併せて発表された「cuPhoton.xLens」は、核融合炉で利用するプラズマのシミュレーションを対象とします。プラズマは、原子から電子が離れるなどして電気を帯びた粒子を含む状態で、核融合研究を理解するうえで欠かせない対象です。宇宙観測と核融合では研究内容が異なりますが、分野特有の計算をライブラリーとして提供するという方向性は共通しています。研究現場での導入判断では、製品名よりも、自分たちが使う計算モデルやデータ形式に対応しているかを確かめることが先決です。
生物学向けツールは、解析の高速化と実行環境の整備を支援
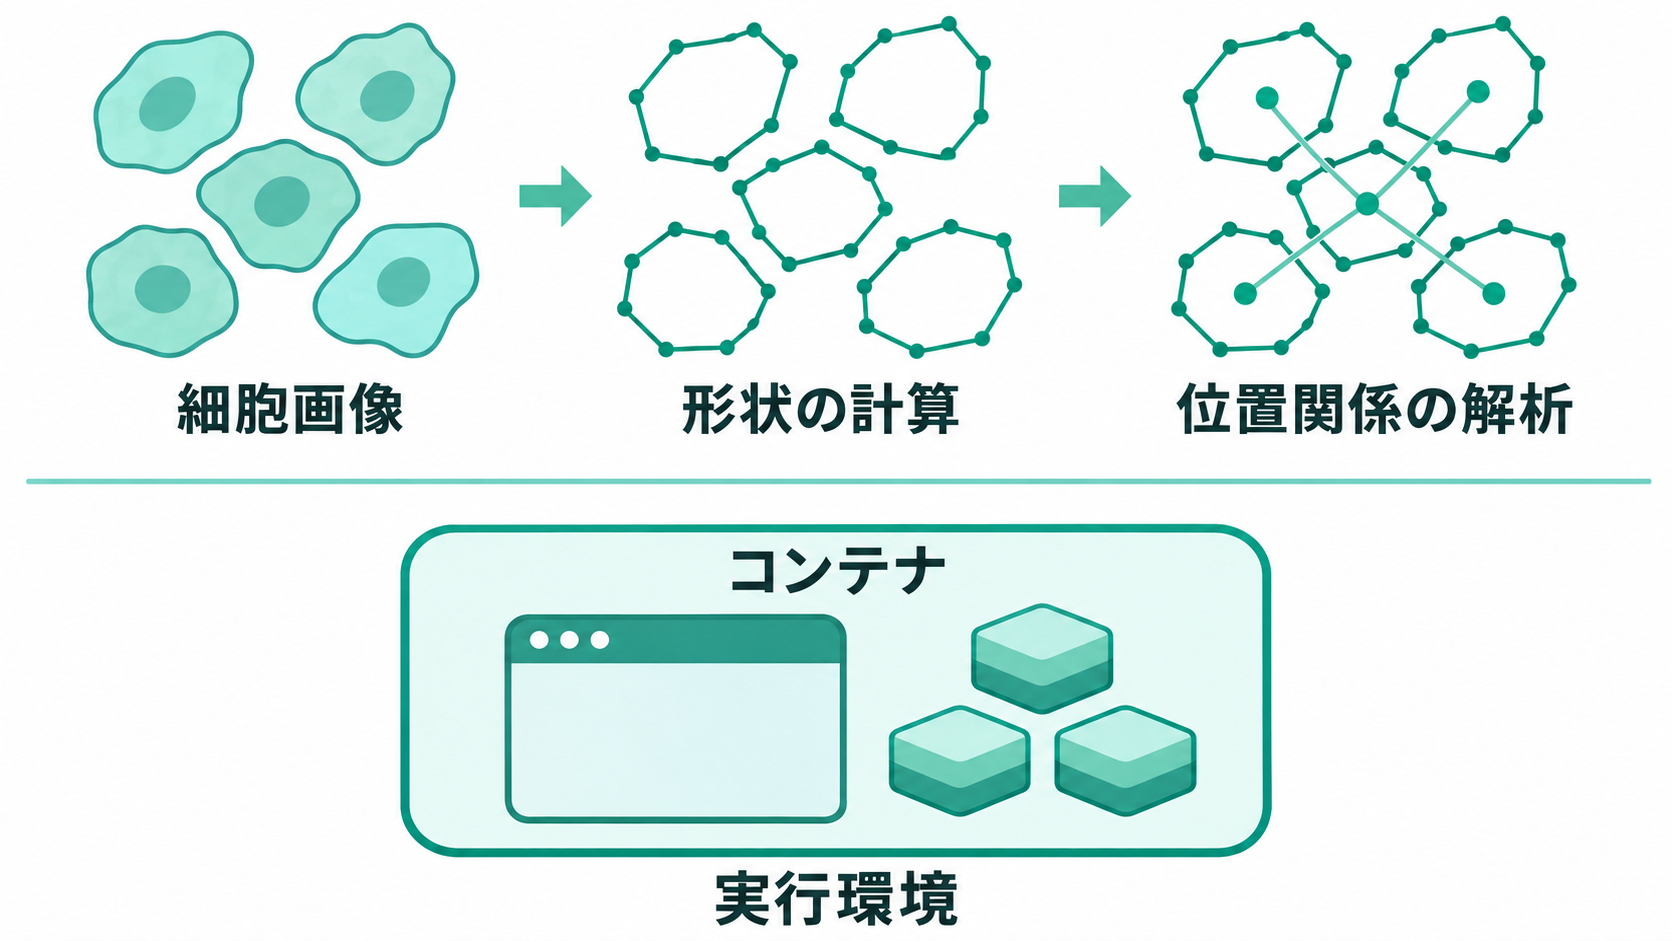
生物学分野では、Nvidiaが「cuSpa」をオープンソース化します。対象となるのは、細胞の形状を多角形として扱う計算の高速化です。細胞の構造や相互作用を調べる際には、形状や位置関係を数値として処理する工程があり、こうした解析を支えるツールとして位置づけられます。
細胞の画像を見て特徴を判断する作業と、細胞の輪郭や隣接関係を大量に計算する作業では、必要な処理が異なります。今回のcuSpaは、後者に関わる計算を支援するものとして捉えるとよいでしょう。生成AIの応答が速くなるという話ではなく、研究データを扱う専門的な工程を短縮する取り組みです。
既存の細胞解析ツール「rapids-singlecell」については、Nvidiaユーザー向けにコンテナ形式で提供されます。コンテナは、アプリケーションと実行に必要なソフトウェアをまとめて配布する方法です。研究用ソフトウェアでは、関連するライブラリーの組み合わせやバージョンによって、環境構築に手間がかかる場合があります。コンテナ化は、その準備を進めやすくする手段になります。
もっとも、コンテナを使えば解析結果の再現性がすべて保証されるわけではありません。入力データ、設定値、前処理の方法なども結果に影響します。企業の研究チームが評価する際は、処理速度に加え、使用した環境と条件を記録できるかまで確認すると有用です。オープンソース化による実装の確認しやすさと、コンテナによる配布のしやすさは、異なる面から導入を支えます。両者を同じ「使いやすさ」としてまとめず、検証と運用のそれぞれにどう役立つかを見極める必要があります。
Nemotron for Scienceは、研究向けAIの追加学習と評価をひとまとめに
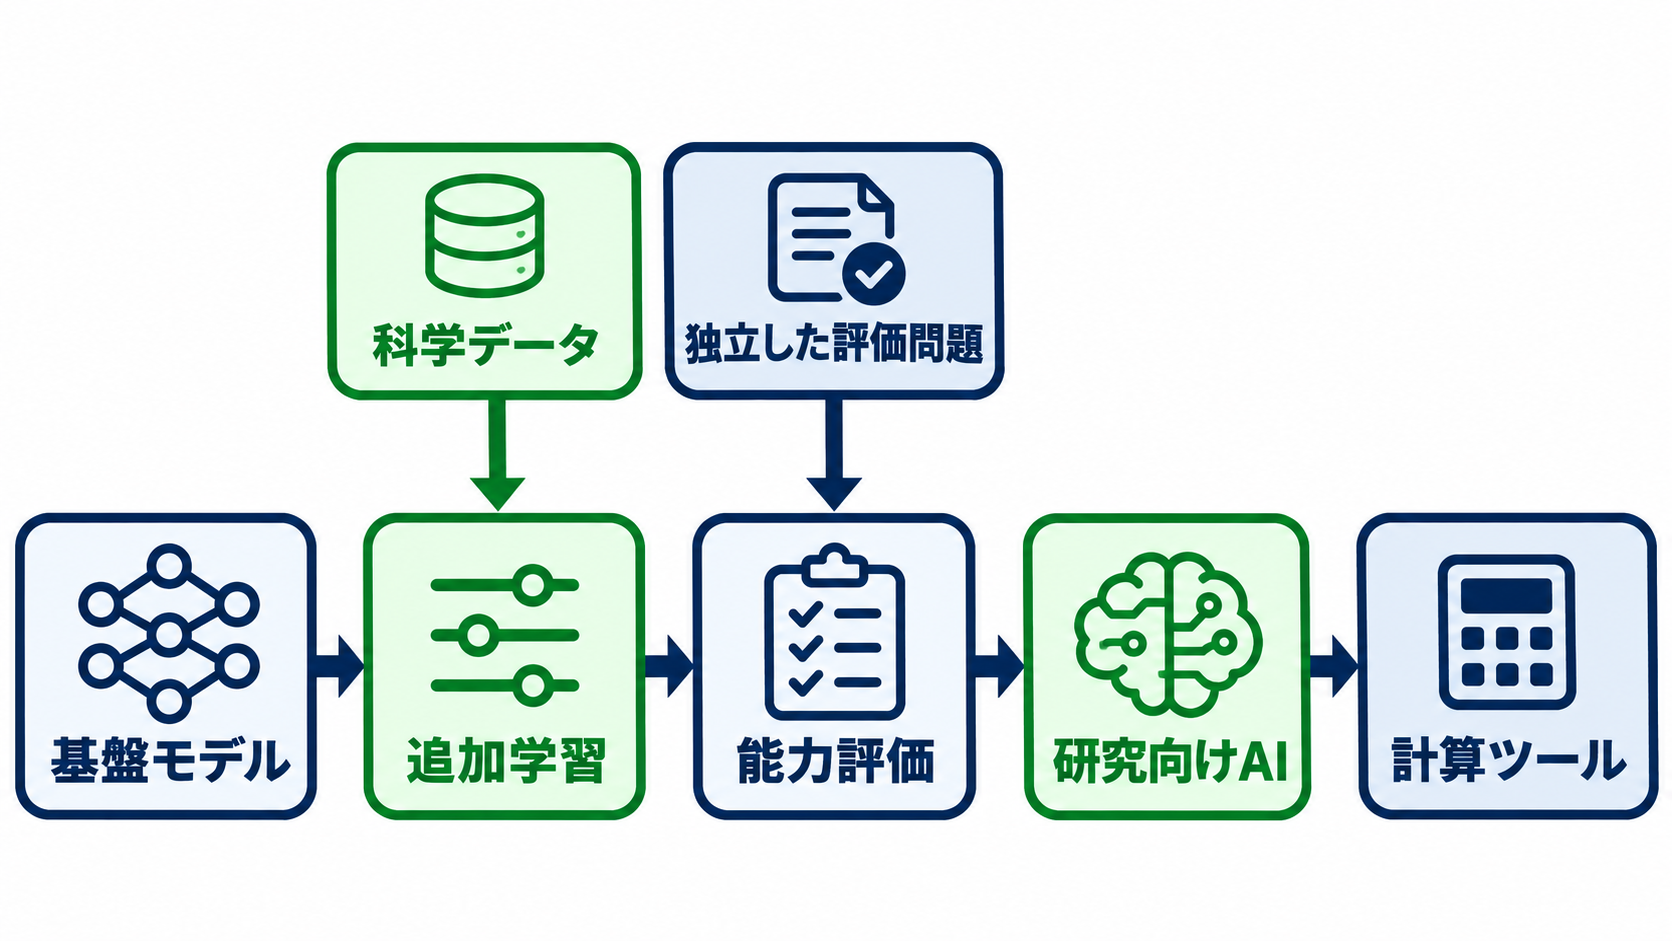
「Nemotron for Science」は、研究用途にAIを適応させるためのモデル、データ、追加学習のワークフローを組み合わせた提供物です。基盤となる「Nemotron 3.5 Super VL」は、Nvidiaが前月に公開したオープンソースの大規模言語モデルで、総パラメーター数は1,240億、処理時に有効になるのはその約1割とされています。総規模と、実行時に使われる部分の規模を区別することが、モデルの構成を理解する手がかりになります。
同モデルは、広く使われるTransformerとは異なる構造で、ハードウェア効率を重視した「Mamba-2」も一部に採用しています。ただし、構造やパラメーター数だけから、個別の科学課題に対する精度を判断することはできません。研究に使うには、専門用語を扱えるかだけでなく、計算ツールの選択や、出力された結果の解釈まで評価する必要があります。
Nemotron for Scienceには、特定の科学タスクにモデルを適応させるための、事前に用意された追加学習の手順が含まれます。Nvidiaは化学分野の質問も約5万件追加しており、モデルの追加学習や、追加学習後の能力評価に利用できるとしています。モデルだけを公開する場合に比べ、研究者が用途に合わせた調整と検証に着手しやすい構成です。
企業側では、学習用データと評価用データの扱いを分けることが欠かせません。学習時に見た問題への正答率だけでは、未知の課題に対応できるかを判断しにくいためです。用意された質問群も、自社の研究領域や求める判断水準を十分にカバーするとは限りません。導入時には、既知の結果を持つ社内課題で試し、誤り方や判断の限界を確かめる工程が必要でしょう。
量子計算への拡張も、自社の検証工程から評価
量子計算分野では、Nvidiaがソフトウェア群「CUDA-Q」を拡張します。量子コンピューターは量子ビットを使って計算しますが、その制御や処理の管理には通常のプロセッサーも必要です。CUDA-Qは、量子ハードウェアとGPU、CPUを連携させるための開発を支援する仕組みです。今回、量子ソフトウェアを開発するための新たな構成要素と、量子ビットの誤りを緩和するアルゴリズムが追加されます。
NvidiaはIBM、米エネルギー省傘下の研究所Fermilabとも協力します。Nvidiaの「DGX B200」システムとIBMの量子ハードウェアを組み合わせ、量子ビットの誤り訂正アルゴリズムなどを研究するための、モジュール型の共同設計基盤を構築する計画です。誤りの緩和と誤り訂正は関連する課題ですが、今回の発表で量子計算の誤りが解決されたと受け止めることはできません。
Rubin HPCから専門ライブラリー、研究向けAI、量子計算までを横断すると、Nvidiaは研究の各工程を自社の計算基盤につなぐ範囲を広げていると考えられます。ただし、日本企業がすべてを同時に検討する必要はありません。自社の時間を消費している工程が、モデルによる推論なのか、シミュレーションなのか、データの前処理なのかによって、評価すべき技術は変わります。
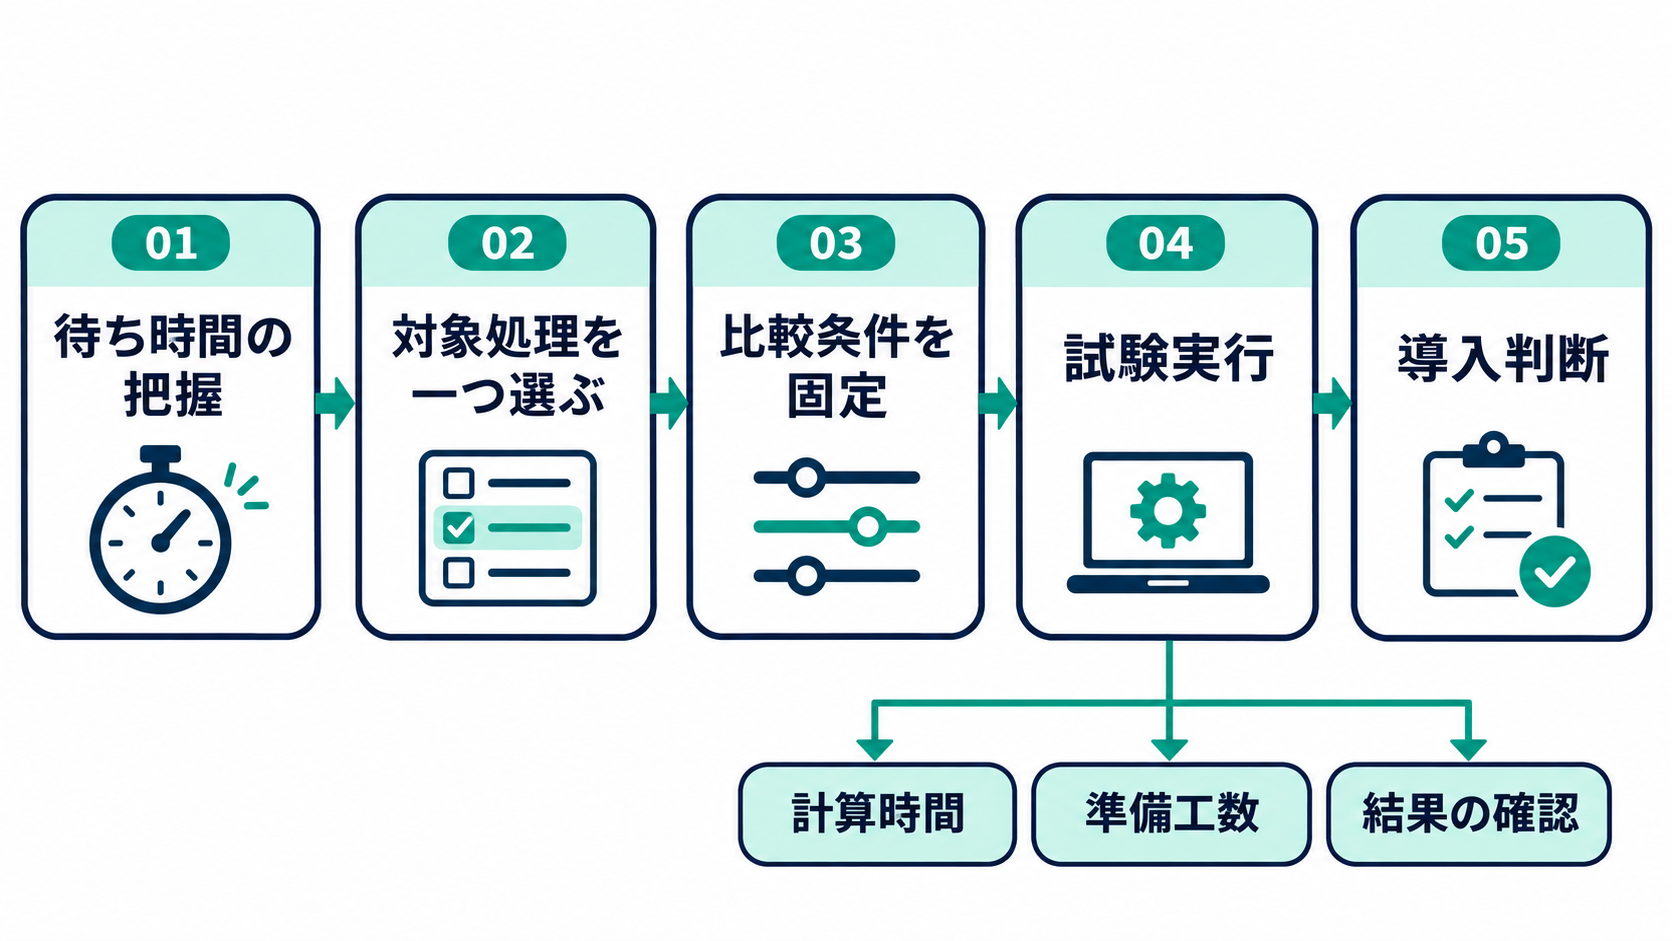
着手点としては、現在の研究工程から待ち時間の長い処理を一つ選び、既知の正解や従来結果を使って比較条件を定める方法が考えられます。計算時間だけでなく、環境構築の工数と、研究者による確認に要する時間も測れば、導入後の効果を判断しやすくなります。2028年のハードウェア計画を検討する前に、既存の処理をどこまで改善できるか、小さな評価対象を具体化することが次の一歩です。