

2026/11/12
AIニュース
AIエージェントが増やす推論呼び出し、Kubernetesに訪れた「第二幕」
この記事の要点
AIエージェントは、一つの依頼から多数の推論処理を発生させます。CNCFのジョナサン・ブライス氏は、変動する分散処理を支えるKubernetesの役割と、既存設備の活用、エージェントの統制に向けた取り組みを紹介しました。日本企業には、業務一件の完了までに必要な処理量、費用、時間、権限をまとめて検証する視点が求められます。
目次
一つの依頼が、膨大な推論処理に変わる時代
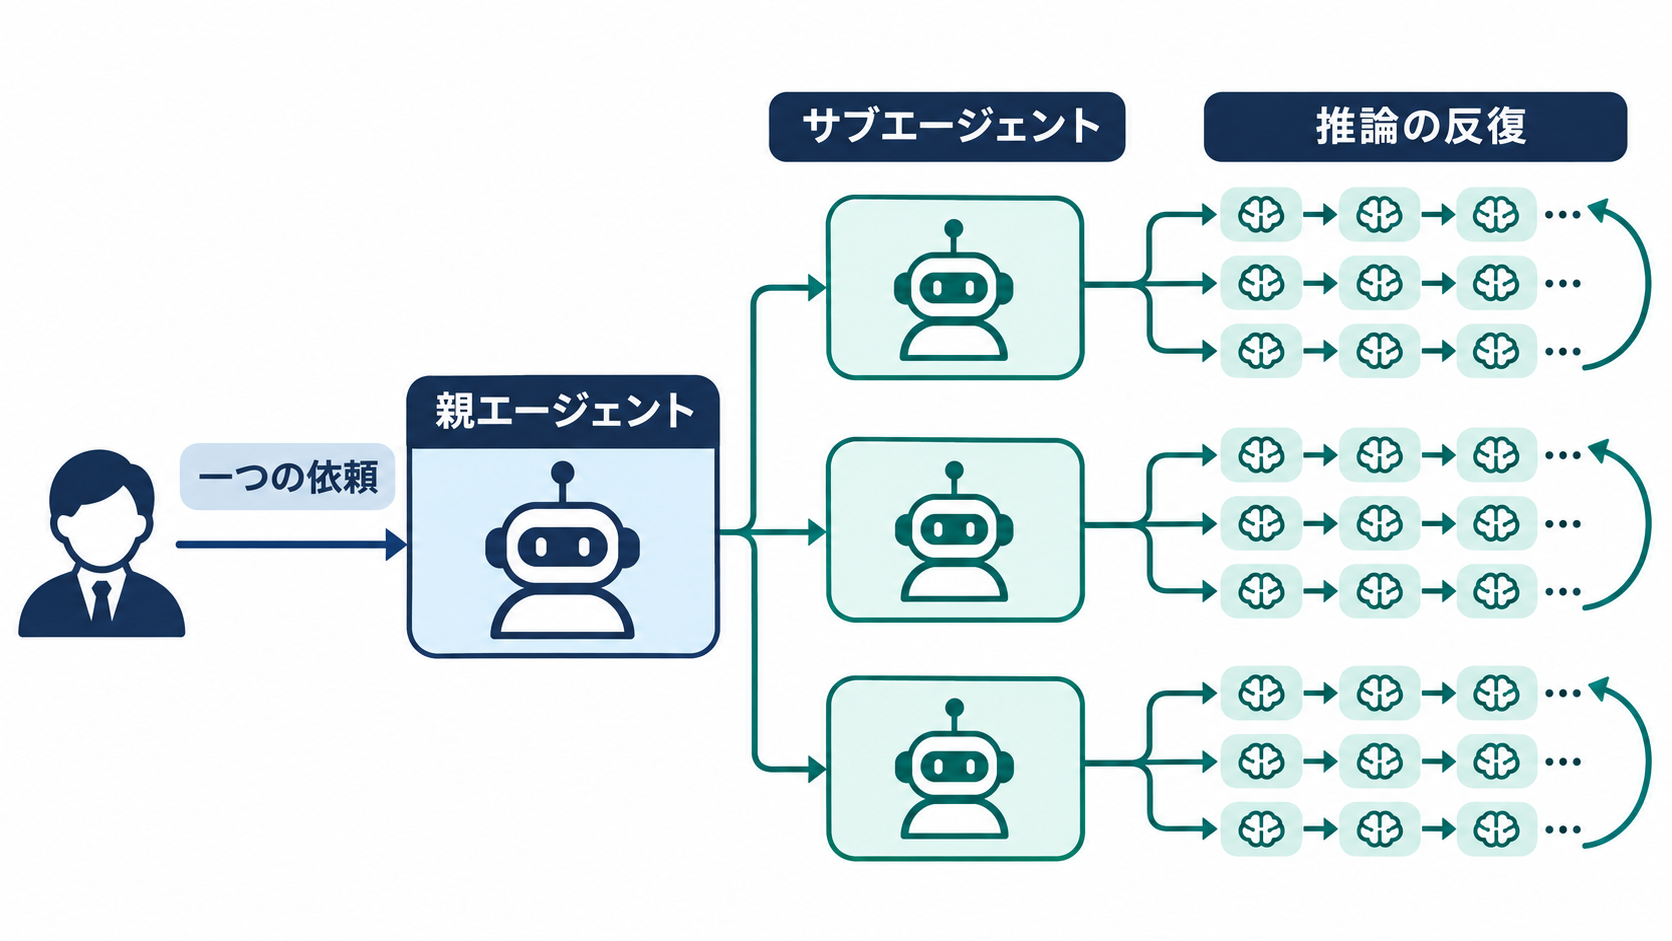
「このようなシステムを作ってほしい」。コーディング用のAIエージェントに投げる短い依頼が、インフラ側では長時間にわたる大量の処理につながります。クラウドネイティブ技術の普及を支える団体、Cloud Native Computing Foundation(CNCF)のエグゼクティブディレクター、ジョナサン・ブライス氏は、エージェントが10個のサブエージェントを起動し、それぞれが数時間にわたって数千回の推論を実行する例を挙げています。利用者が入力した回数だけでは、必要な計算資源を捉えにくくなっているのです。
ブライス氏は、クラウドネイティブ技術の開発者や企業が集まるKubeCon + CloudNativeCon NAで、SiliconANGLE傘下の配信メディア、theCUBEのインタビューに応じました。そこで示した論点は、モデルの性能向上だけではAIの実用化を支えきれないという点です。モデルを継続的に動かし、増減する推論要求を処理する基盤が、エージェントの普及によって改めて問われています。
この変化を背景に、コンテナ化したアプリケーションの配置や稼働を管理するオープンソース基盤、Kubernetesに新たな役割が生まれています。ブライス氏は、動的に変化する分散処理を当初から想定していた設計が、急成長するAI企業の土台になったと説明しました。安定稼働のために使われてきた技術が、予測しにくいAI処理を受け止める基盤として再評価されているわけです。
企業が注目すべきなのは、エージェントの導入数だけではありません。一件の業務依頼が内部でどれほどの処理に展開されるかによって、費用も処理時間も変わります。導入計画には、利用者数に加えて、タスク単位の実行量を把握する視点が必要でしょう。
学習から推論へ、運用の重心が移る背景
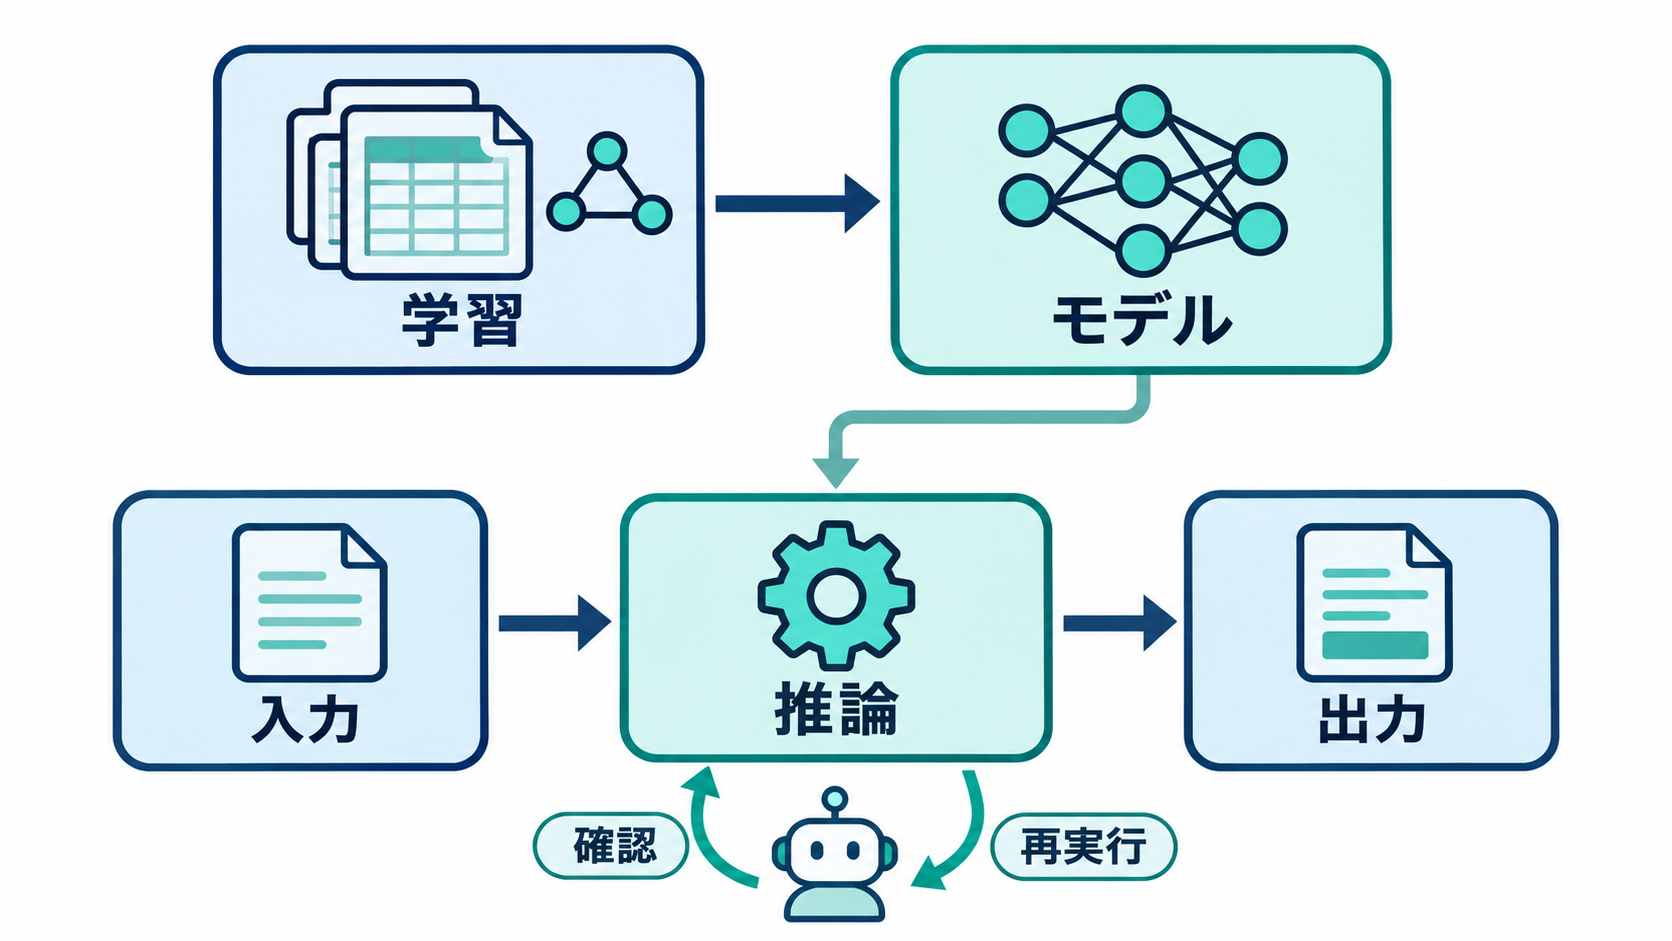
生成AIの計算処理を考える際は、モデルを作るための「学習」と、モデルを使って出力を得る「推論」を分けると理解しやすくなります。学習ではモデルの能力を形成し、推論では入力に応じて文章やコードなどを生成します。利用者がサービスを使うたびに発生するのは、主として後者の処理です。ブライス氏は、AIへの支出がモデルの学習から、モデルの提供やエージェントの実行へと移っていると説明しています。
数学やソフトウェア開発のベンチマークで優れた成績を示しても、それだけで企業の業務に使えるとは限りません。必要なときに応答を返せることや、継続して処理を提供できることが求められます。モデルの能力を評価する作業と、その能力を安定して利用できる環境を整える作業は、関連しながらも異なる課題です。
ブライス氏は、初期のチャットボットを、メッセージごとに一度の推論を呼び出す仕組みとして説明しました。これに対してエージェントは、一つのタスクを終えるまで推論を繰り返す場合があります。例えば、作業方針を考え、実行結果を確認し、その結果に応じて次の処理を選ぶ構成では、利用者とのやり取りが増えなくても内部の呼び出しは積み上がります。これは仕組みを理解するための例であり、すべてのエージェントが同じ手順で動くわけではありません。
この違いは、企業の評価方法にも関わります。一回の応答にかかる費用や時間だけでは、業務全体の負担を判断できなくなるためです。依頼から完了までに何回の推論が必要だったか、途中でどれだけ待ち時間が生じたかを併せて見る必要があるでしょう。AIサービスの比較でも、モデル単体の指標に加え、実際の業務を完了するまでの実測値が判断材料になります。
Kubernetesが担うのは、変動する処理の受け皿
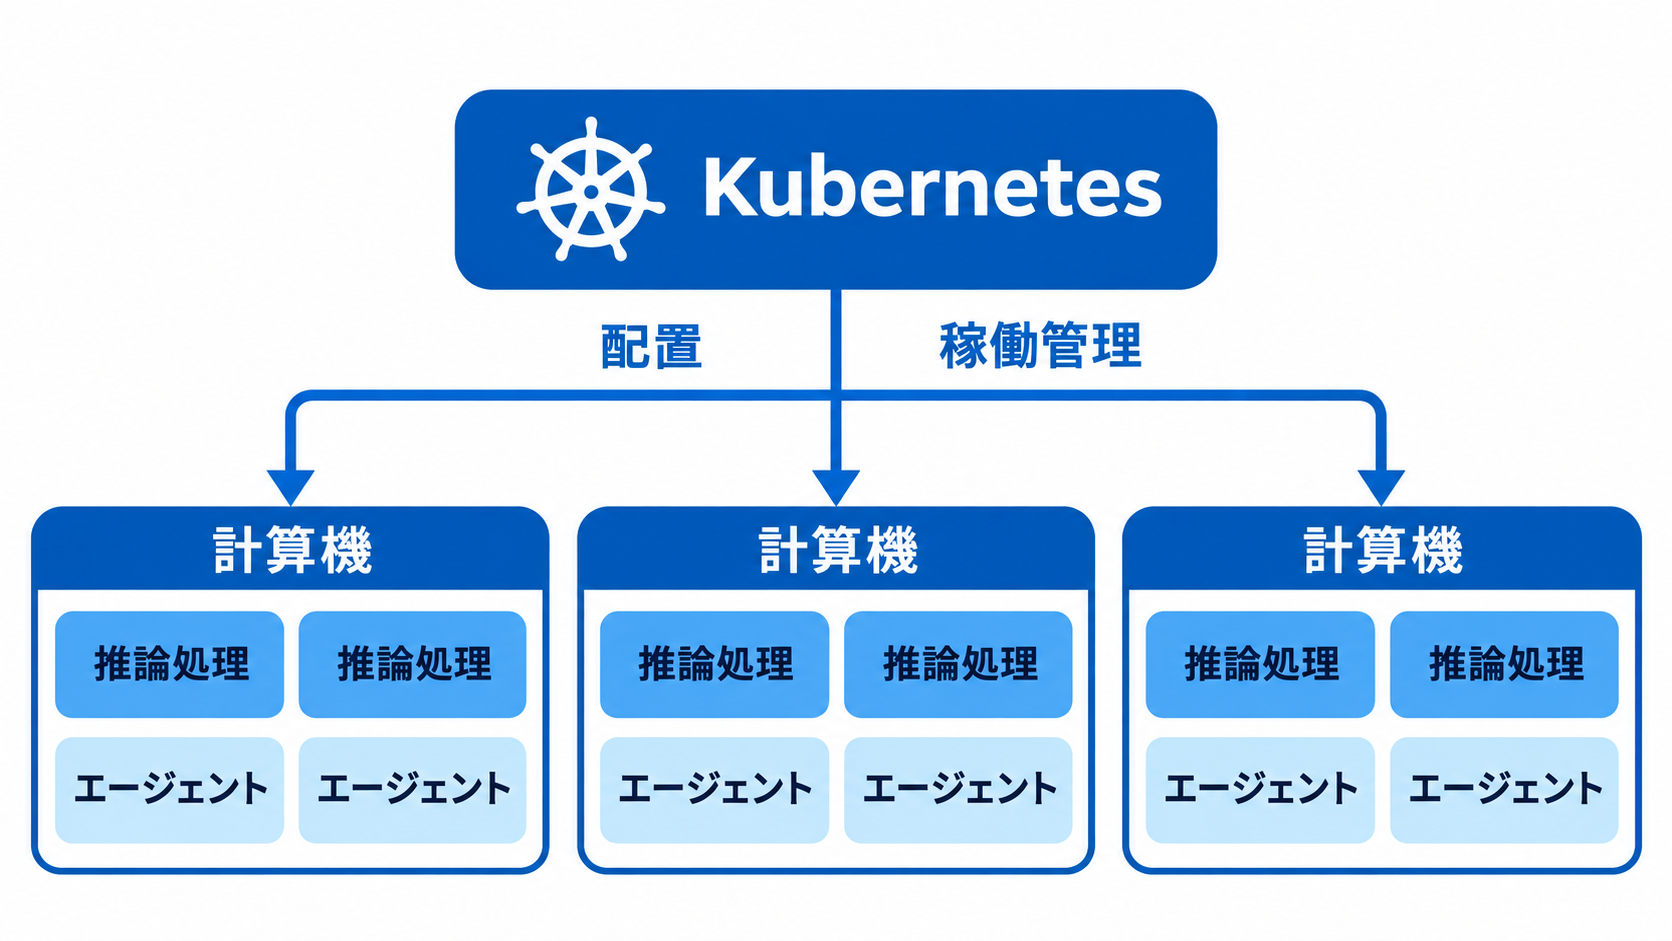
Kubernetesは、複数の計算機にまたがるアプリケーションを運用するための基盤です。アプリケーションを動かす単位であるコンテナの配置や、必要な稼働数の維持などを管理します。処理が集中する場所や必要な資源が変化する環境では、人が個別に配置を調整し続ける方法に限界があります。Kubernetesの役割は、こうした運用を一定のルールに沿って扱えるようにすることです。
ブライス氏は、AIブームが大規模なインフラ投資を促すなかで、Kubernetesが信頼できる基盤を提供してきたと述べました。特に評価しているのは、動的な分散ワークロードに対応する設計です。ここでいうワークロードとは、基盤上で実行するアプリケーションや処理を指します。複数のエージェントが並行して動き、途中で新たな処理が生まれる構成は、固定的な処理量を前提とする運用では扱いにくいでしょう。
ただし、Kubernetesを導入すれば推論の課題がすべて解決するわけではありません。モデルをどう読み込むか、処理要求をどこへ送るか、長時間動くエージェントをどう管理するかは、用途に応じた仕組みが必要です。Kubernetesはそれらを動かす土台として位置づけると、役割を捉えやすくなります。基盤の管理機能と、AI処理に固有の最適化は、分けて検討する必要があります。
日本企業にとっては、既存の運用経験をどこまで活用できるかが検討点になります。すでにKubernetesを使っている組織なら、監視や障害対応の知見を生かせる余地があるでしょう。利用経験がない組織では、AIのためだけに導入する場合の運用負担も考慮すべきです。技術名を先に選ぶより、処理量の変動、継続稼働の要件、担当チームの体制を整理したうえで適合性を判断するほうが現実的です。
計算資源の増設だけに頼らない推論基盤
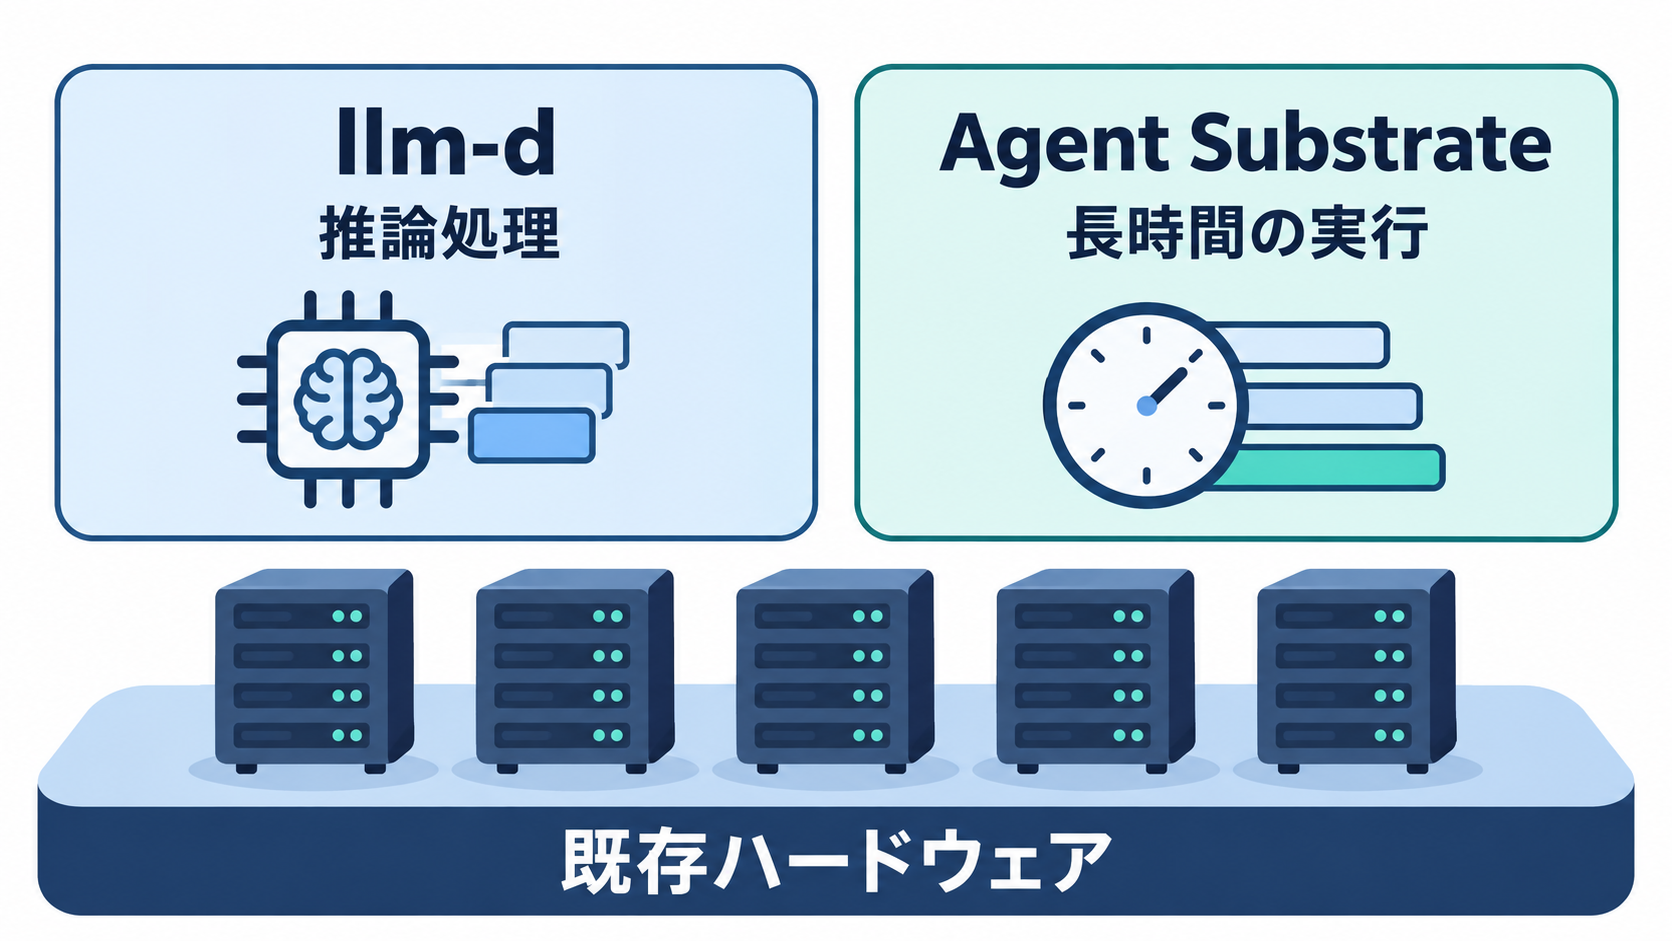
推論需要が増えれば、計算資源を追加する対応が考えられます。しかし、設備を増やすことと、既存設備から十分な処理能力を引き出すことは別の課題です。ブライス氏は、データセンターの建設が進み、地域で資源利用への懸念が生じるなか、現在のハードウェアをより有効に使う取り組みに言及しました。エージェントの普及は、インフラの規模だけでなく、使い方にも目を向ける契機になっています。
そこで挙げられたのが、推論エンジンの「llm-d」と、長時間稼働するエージェントをコンパクトにホスティングするための「Agent Substrate」です。ブライス氏は、これらを既存ハードウェアからより多くの性能を引き出す取り組みとして紹介しています。両者を同じ製品として捉えるのではなく、モデルの推論処理と、エージェントを動かし続ける環境という、異なる運用上の役割から理解する必要があります。
企業がこうした技術を評価する際、単に「効率がよい」という説明だけでは採否を決められません。実際の業務では、短い処理が多数届くのか、長時間の処理が並行して走るのかによって、基盤への要求が変わります。設備全体の稼働状況が改善しても、個々のタスクの完了が遅くなるなら、利用部門にとって望ましい結果とは限らないでしょう。
検証では、一定時間に完了できる業務の件数と、依頼から完了までの時間を組み合わせて見る方法が考えられます。そのうえで、計算資源の使用量や費用との関係を確認します。今回紹介された技術について、具体的な性能改善率や企業ごとの導入効果は明らかにされていません。自社の処理に近い条件で比較し、設備の追加と運用の改善をそれぞれ評価することが、投資判断の出発点になります。
同じ依頼でも動きが変わるエージェントの統制
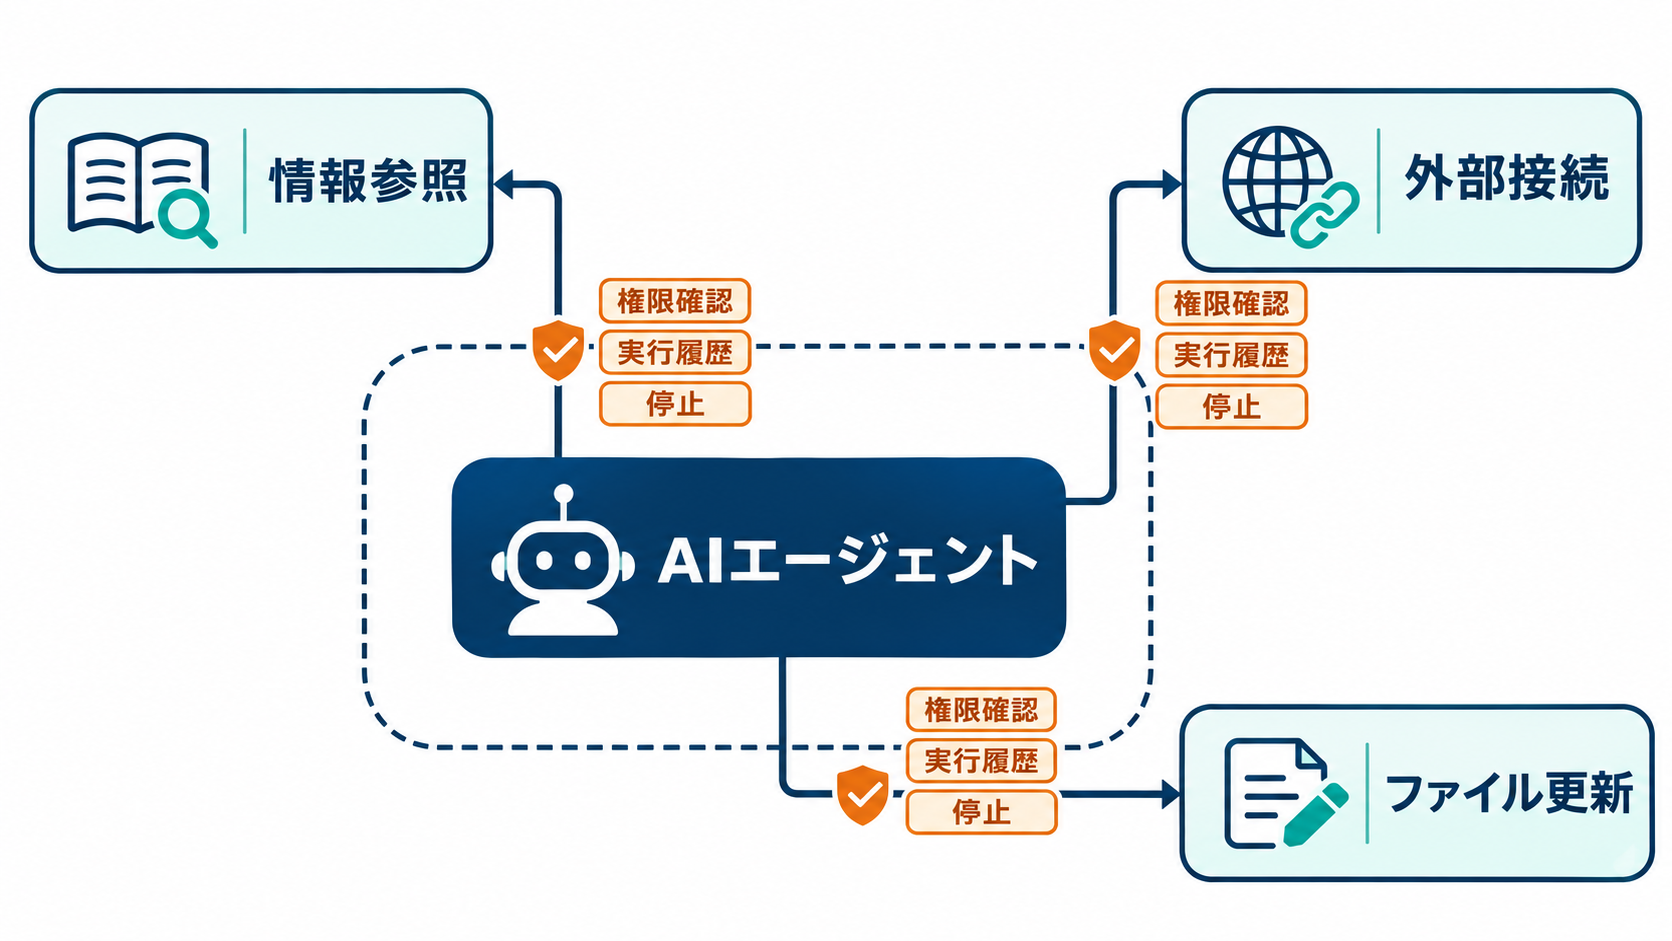
エージェントの運用では、処理量と並んで、実行内容をどう制御するかが課題になります。ブライス氏は、同じタスクを与えてもエージェントが異なる選択をする可能性に触れました。企業システムでは、想定した結果が得られるかだけでなく、結果に至るまでにどの情報へアクセスし、どの操作を実行するかも確認しなければなりません。出力の品質管理と、実行権限の管理には、それぞれの視点が必要です。
例えば、調査を任せたエージェントが外部サービスを呼び出す構成なら、接続先や利用できる情報の範囲を設計する必要があります。ファイルの更新やシステム操作まで任せる場合は、許可する操作の境界も検討対象になるでしょう。これらは企業での運用を考えるための例であり、今回紹介された製品の具体的な機能を示すものではありません。
ブライス氏は、この領域の取り組みとしてセキュリティプロジェクト「OpenShell」を挙げています。同氏の説明によると、NVIDIAの寄贈を受け、CNCFの中立的なガバナンスの下に置かれたプロジェクトです。また、数カ月で300社を超える企業が貢献に参加したと述べ、かつてなら同様の広がりに2年ほどかかった可能性があるとの見方を示しました。この数値は同氏の説明に基づくものであり、導入企業数や安全性の実証を意味するものではありません。
日本企業が導入を検討する際も、コミュニティの規模だけで判断することは避けたいところです。許可していない操作を制限できるか、実行の履歴を確認できるか、問題が起きた際に停止できるかといった要件を、自社の業務に即して確かめる必要があります。エージェントが柔軟に動くほど、任せる範囲を明文化する価値が増すと考えられます。
日本企業は「一件の業務」を単位に導入を評価
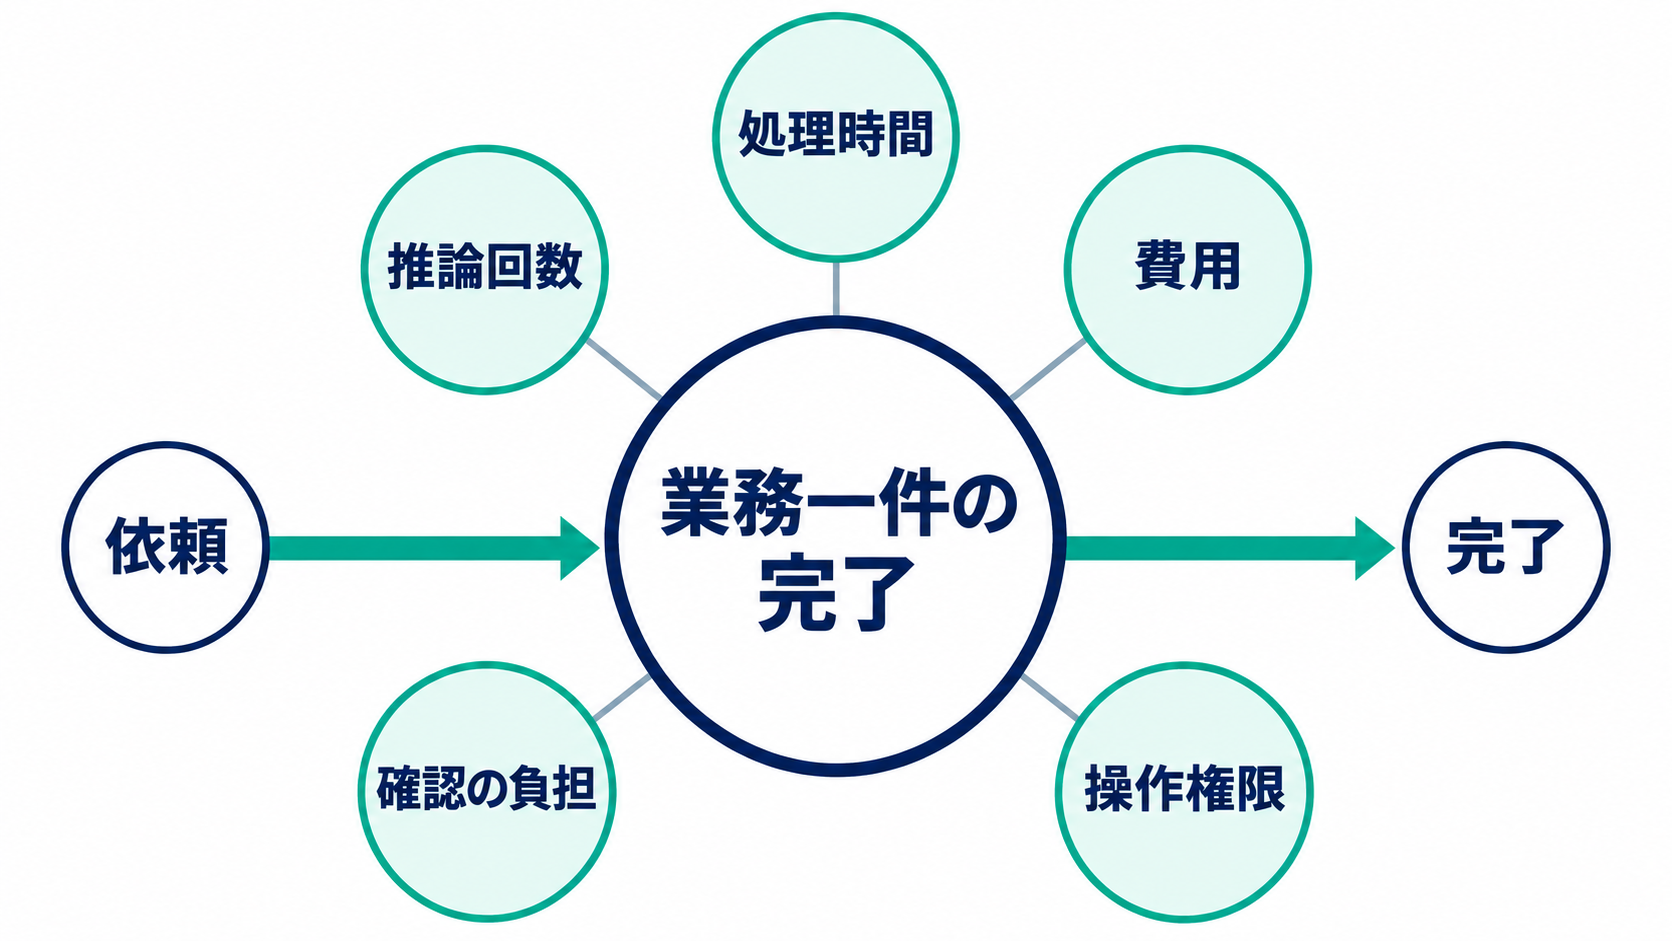
今回の動きから読み取れるのは、生成AIの導入評価を、対話の使いやすさだけで終わらせにくくなっていることです。エージェントに業務を任せる場合、その内部では複数の処理が連鎖します。モデルの性能、推論を提供する基盤、長時間の実行を支える環境、操作を制御する仕組みを、業務の完了という一つの目的に沿って確認する必要があるでしょう。
CNCFは、KubeConにAI推論とエージェントを扱う新たなトラックを設けています。ブライス氏が重視しているのは、業界の変化に対応しながら、共通の基盤となるオープンな技術を協力して作ることです。個々の企業がすべての運用課題を独自に解くのではなく、共有できる部分を共同で整備する方向性がうかがえます。ただし、共通基盤が整うことと、自社の業務要件を満たすことは、別々に確認しなければなりません。
導入の検証では、対象を一つの業務に絞ると論点を具体化しやすくなります。例えば、社内で想定するコーディング支援のタスクを定め、依頼から完了までの推論回数、処理時間、費用、人による確認の負担を記録する方法が考えられます。成功したケースだけでなく、途中で止まったケースや、やり直しが発生したケースも評価に含めると、実運用の負担を捉えやすいでしょう。
その結果を基に、処理の遅さがモデルの応答にあるのか、実行環境の待ち時間にあるのか、人の確認にあるのかを切り分けます。Kubernetesや関連プロジェクトの採用は、その課題に対応する手段として検討できます。日本企業が着手する具体的な一歩は、自社の代表的な依頼を一件選び、「完了までに何が起き、どの資源を使ったか」を記録できる検証を組むことです。
参考情報
Kubernetes gets a second act as AI agents turn one prompt into thousands of inference calls
SiliconANGLEによるKubeCon + CloudNativeCon NAでのインタビュー報道です。theCUBEの当該配信はThe Linux Foundationがスポンサーを務めています。SiliconANGLEは、同団体を含むスポンサーが編集内容を管理することはないと開示しています。