

2026/11/12
AIニュース
AIエージェントが自らデータベースを作る時代、企業に必要な「実行中のデータ監視」
この記事の要点
AIエージェントがデータを直接参照し、一時的なデータベースまで作るようになると、企業には実行中のデータ利用を追う仕組みが必要になります。KubeConでの専門家の指摘をもとに、データオブザーバビリティ、判断の監査、文脈の管理を整理し、日本企業が導入前に確認したい実務上の論点を紹介します。
目次
AIの本番運用を左右する、モデルの下にあるデータ基盤
AIエージェントが必要なデータを探し、自ら一時的なデータベースを作って判断するようになったとき、企業はその過程をどこまで把握できるでしょうか。回答の正しさを確認するだけでは、業務を任せるための検証は足りません。どの情報を使い、どこにコピーし、どのような権限で処理したのかまで追えることが、運用上の課題になります。
データとAIの助言を手がけるSanjMoの代表、サンジーブ・モハン氏は、KubeCon + CloudNativeCon North Americaで、AIの成否は堅固なデータ基盤に左右されると指摘しました。同イベントは、コンテナ運用の基盤であるKubernetesをはじめ、クラウド環境で動くシステムの開発・運用技術を扱う催しです。今回はAI推論とエージェント型AIの専用トラックも設けられ、データ基盤の課題がクラウド運用の議論にも及んでいます。
モハン氏が問題視しているのは、モデルの性能改善だけでは解決できない部分です。チャットボットから検索を利用した回答生成、追加学習、業務を実行するエージェントへと利用形態が変わっても、その下ではデータの品質や流れを把握する必要があります。データの状態が見えなければ、出力に問題が起きた際に原因を切り分けることも難しくなるでしょう。
ここで焦点になるのが「データオブザーバビリティ」です。データが正常に届いているか、内容に異常がないか、どこから来てどう処理されたかを観測し、問題を調べられるようにする考え方を指します。今回の論点は、それを分析用システムの保守機能にとどめず、エージェントが動くための設計条件として扱う必要があるという点です。企業が評価すべき対象も、モデル単体から、モデルとデータが組み合わさって働く仕組み全体へ広がります。
定時のデータ処理では追いつかないエージェントの要求
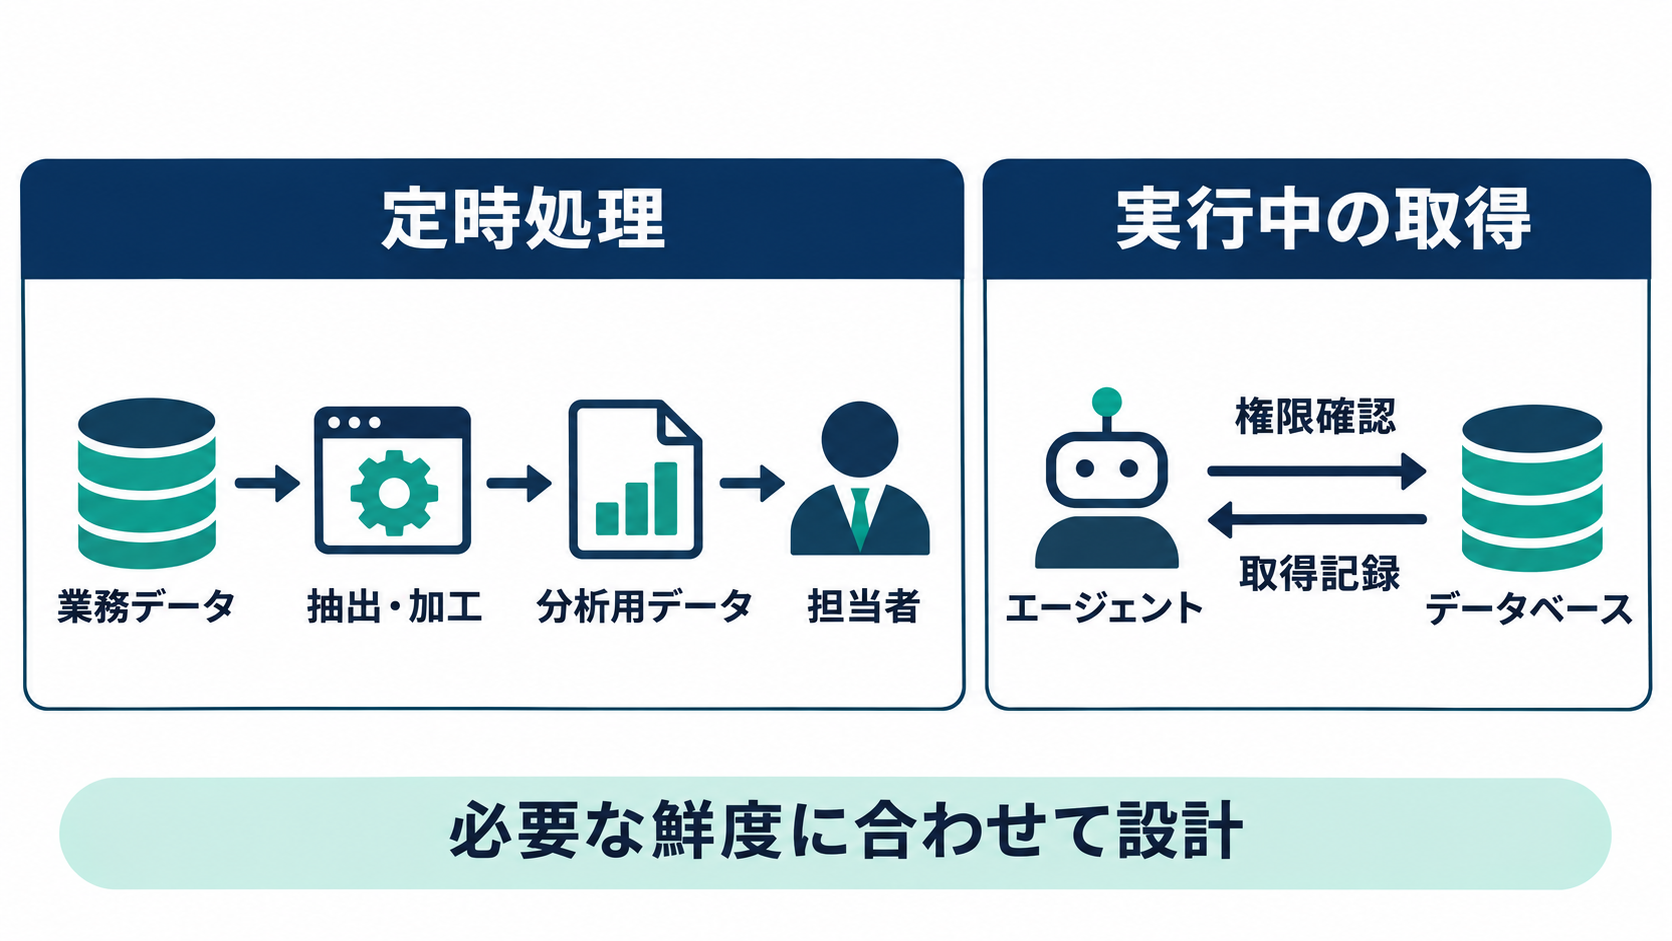
従来の企業システムでは、業務システムで生まれたデータを取り出し、加工し、分析用の場所へ移してから利用する流れが一般的です。売上集計や経営報告のように、人が一定の時刻に確認する用途であれば、処理の完了を待つ運用にも合理性があります。利用する側と、データを準備する側の時間を分けやすいためです。
モハン氏は、多数のエージェントが動く環境では、この前提が変わると説明しています。エージェントはデータ処理の経路である「パイプライン」が完了するまで待つのではなく、データベースへ直接アクセスしようとするという見方です。判断に必要な情報を、その業務が進行している時点で取得したいという要求が強まります。
ただし、この指摘を「すべてのエージェントに基幹データベースを開放すべき」という推奨として受け取る必要はありません。企業の設計では、必要な鮮度を保ちながら、どの経路で、どの権限を使って参照させるかを決めることになります。直接参照が必要な業務もあれば、更新頻度を定めたデータで十分な業務もあるでしょう。判断の基準は、技術の新しさではなく、業務が許容できる情報の遅れです。
この変化によって、監視する時点も変わります。夜間処理が正常に終了したことだけを確認しても、日中に動くエージェントが期待するデータを取得できたかは分かりません。取得時の欠落や遅延、参照先の状態を、個々の実行と結び付けて調べる仕組みが必要になります。エージェントの失敗をモデルの誤りと決めつける前に、判断時点のデータが適切だったかを確認できることが、原因調査の出発点になります。
一時的なデータベースが増やす、見えにくいデータの移動
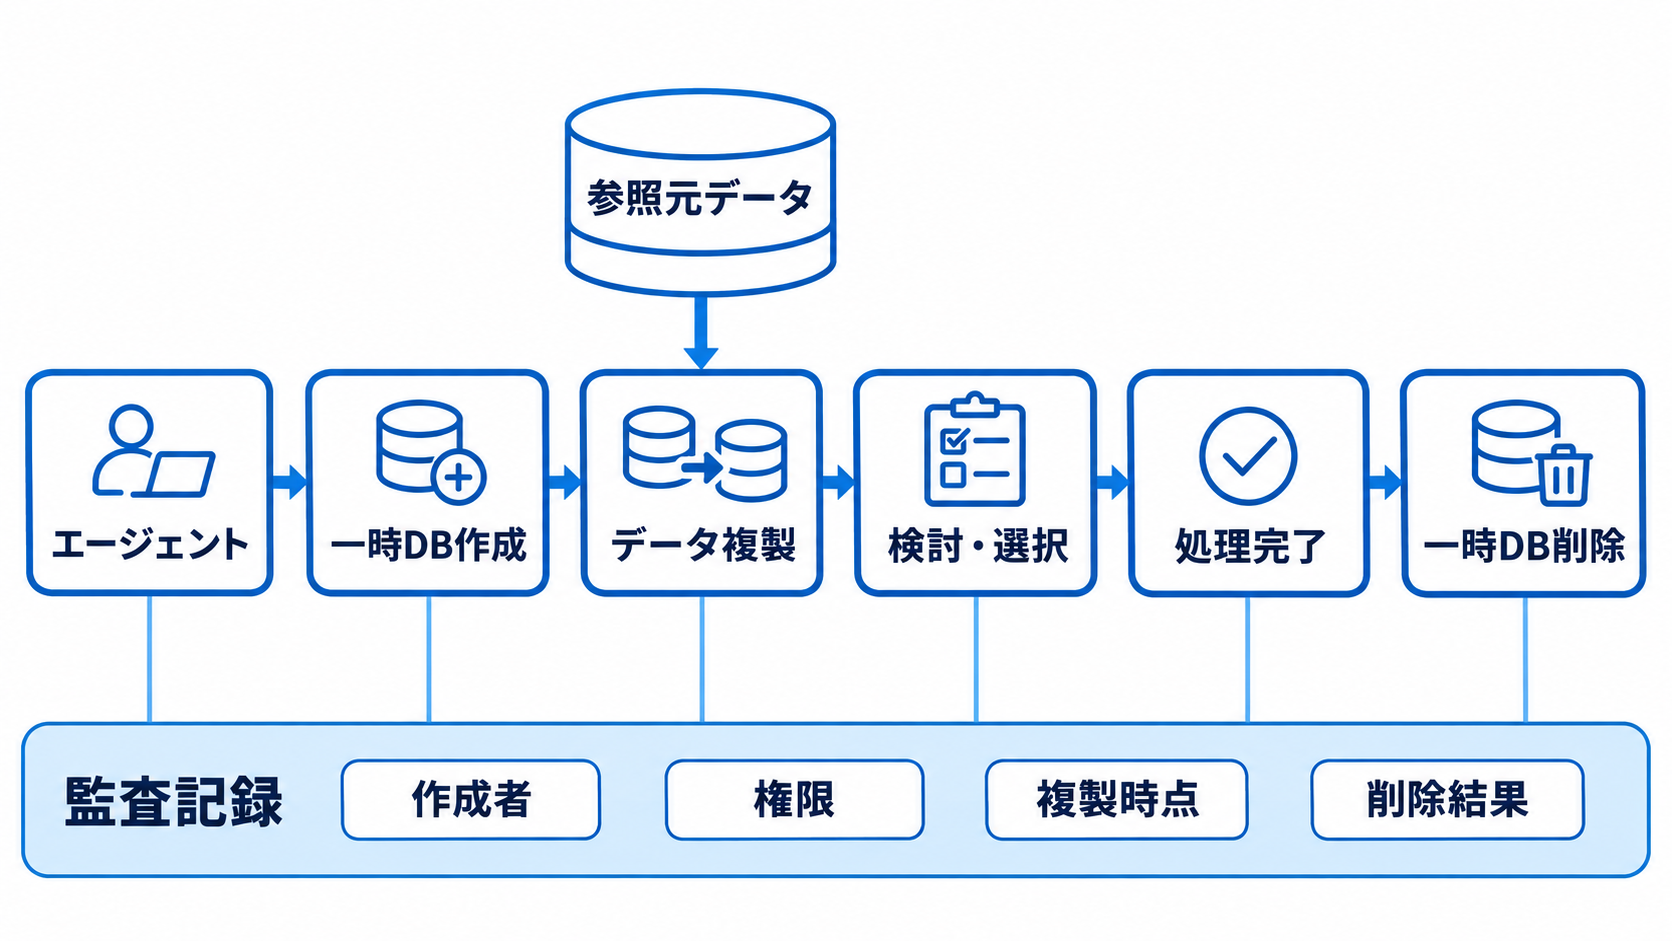
モハン氏によると、エージェントは短時間だけ使うデータベースを立ち上げ、データをコピーし、複数の検討経路を試してから行動を選ぶことがあります。ここで注目すべきなのは、エージェントが既存のデータを読む利用者にとどまらず、新たな保存先やデータの流れを作る主体にもなるという変化です。企業が把握すべき範囲は、あらかじめ登録されたデータベースの一覧だけでは収まらなくなります。
一時的な保存先は、特定の作業に必要な情報をまとめたり、検討用のデータを分けたりするうえで役立つと考えられます。しかし、作成から削除までの時間が短ければ、後から調査しようとした時点で、その保存先が存在しない可能性もあります。処理が完了したという記録だけでは、途中で何が起きたかを説明できない場合があるでしょう。
運用設計では、「一時的だから管理を軽くしてよい」とは考えにくくなります。確認したいのは、どの処理が保存先を作り、どのデータを複製し、誰に相当する権限でアクセスしたかという履歴です。削除の実行状況も含め、保存先そのものの寿命と、監査に必要な記録の保存期間を分けて考える必要があります。これは特定製品の機能要件として示されたものではなく、モハン氏の指摘を企業運用に当てはめた際の設計上の論点です。
また、データをコピーすれば、参照元の更新が自動的に反映されるとは限りません。複製した時点と判断した時点に差がある場合、その差を許容できるかも確認が必要です。データがどこにあるかに加え、いつの状態を表しているかを追うことが、判断結果の検証につながります。エージェントが作業環境を柔軟に作るほど、企業側には、その変化を継続して把握する仕組みが求められます。
判断の根拠を追うガバナンスへ
モハン氏は、融資申請を審査するエージェントが、人口統計やソーシャルメディアの情報を参照して申請を却下する場面を例に挙げています。これは特定の金融機関で起きた事例として紹介されたものではありません。エージェントが複数の情報源を組み合わせて判断したとき、その過程をどう監査するかという問題を示すための例です。
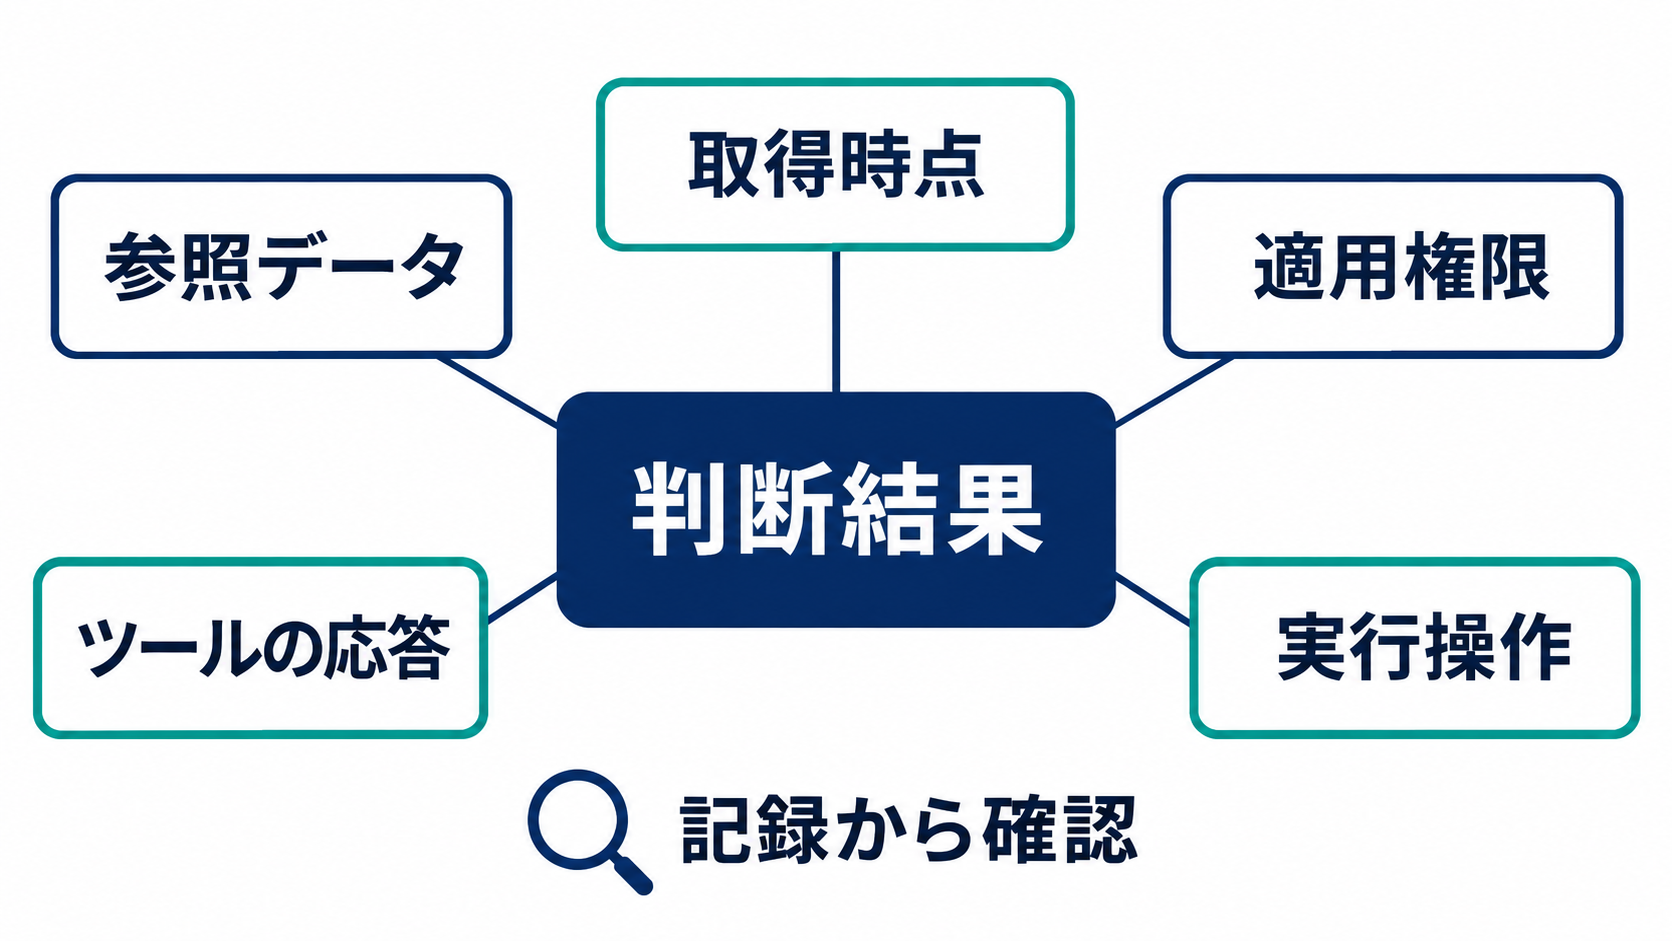
この例で問われるのは、参照先への接続が成功したかだけではないでしょう。その情報を当該業務に使ってよかったのか、対象者と正しく対応していたのか、判断時点で利用できた内容は何だったのかといった確認も必要になります。システムが技術的に正常に動いたことと、業務上妥当な判断をしたことは、別々に検証する必要があります。
従来の定型レポートでは、決められたデータと計算手順を管理することで、結果を説明しやすい面がありました。エージェントが実行の途中で情報源や手順を選ぶ場合、事前に定めたルールだけでは、実際の処理を十分に説明できないことがあります。ガバナンスには、利用前の制御と、実行中・実行後の検証をつなぐ視点が必要になります。
もっとも、判断の透明性を高めることは、モデル内部の思考をすべて文章として保存することと同じではありません。企業が検証に使える記録としては、参照したデータ、外部ツールへの要求と応答、適用された権限、最終的に行った操作などが考えられます。保存する内容は、業務上の必要性や情報の機密性に応じて決めるべきでしょう。結果に説明責任が伴う業務ほど、「何を残せば後から確認できるか」を導入前に具体化しておくことが有効です。
実行中に作られる文脈が、データベース設計を変える
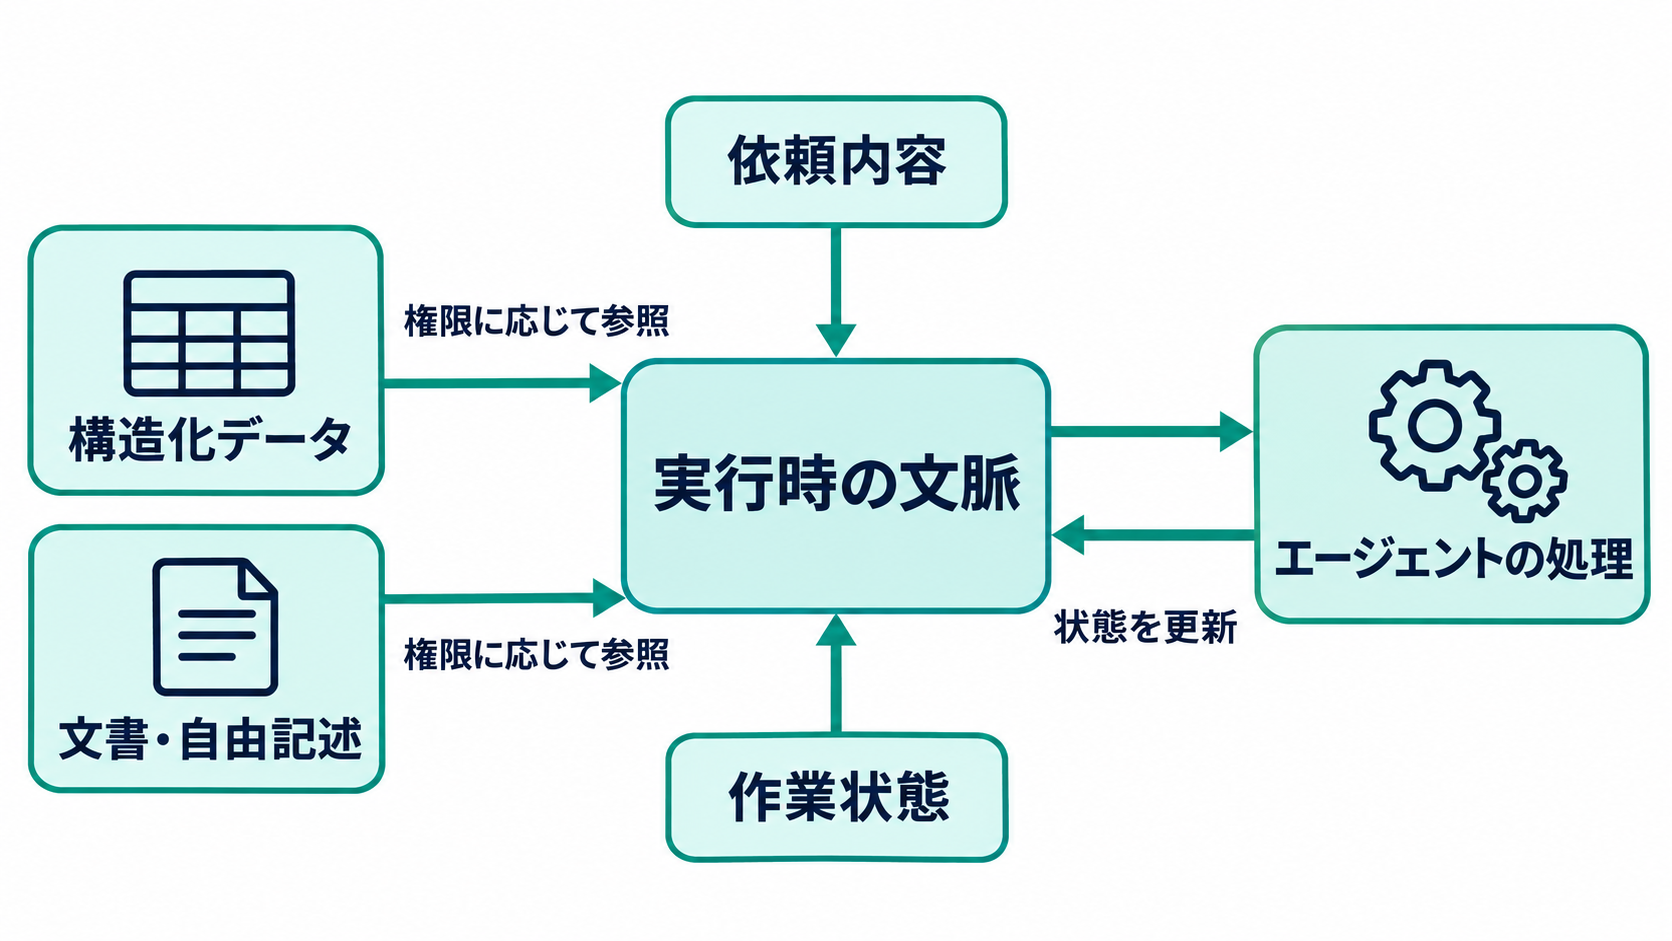
モハン氏は、エージェントの状態を保存し、文脈を構築する必要があると述べています。その文脈は、実行時に作られるという指摘です。同じ名称のタスクでも、依頼者や進行状況によって必要な情報が異なるため、データ基盤には完成済みの情報を渡す以上の役割が生まれます。
ここでいう「状態」は、作業がどこまで進み、どの処理が終わっているかといった情報として捉えられます。「文脈」は、依頼内容や参照情報など、その時点の判断に必要な情報のまとまりです。例えば問い合わせ対応なら、同じ質問でも、問い合わせの履歴や対象となる契約によって確認すべき内容は変わるでしょう。これは仕組みを理解するための一般的な例ですが、固定した入力だけでは業務を扱いにくい理由を示しています。
モハン氏は、今後のプラットフォームでは構造化データと非構造化データを単一の統合システムで扱う必要があるとも指摘しています。構造化データは、顧客番号や注文金額など、項目をそろえて扱う情報です。非構造化データには文書や自由記述の文章などが含まれます。エージェントが業務を進めるには、両方を関連付けて参照する場面が考えられます。
ただし、この見通しから、企業内の全データを直ちに一つの製品へ移すという結論にはなりません。モハン氏は新しい種類のデータベースが登場するという見方を示していますが、具体的な製品構成や移行手順まで提示しているわけではありません。企業にとっての検討点は、複数形式のデータを関連付け、作業状態とともに扱い、その利用履歴を追えるかどうかです。保存先の数だけで統合度を測るより、エージェントが必要な文脈を適切な権限で組み立てられるかを確認するほうが、業務要件を明確にしやすいでしょう。
日本企業が最初に確認したい、ひとつの業務のデータ経路
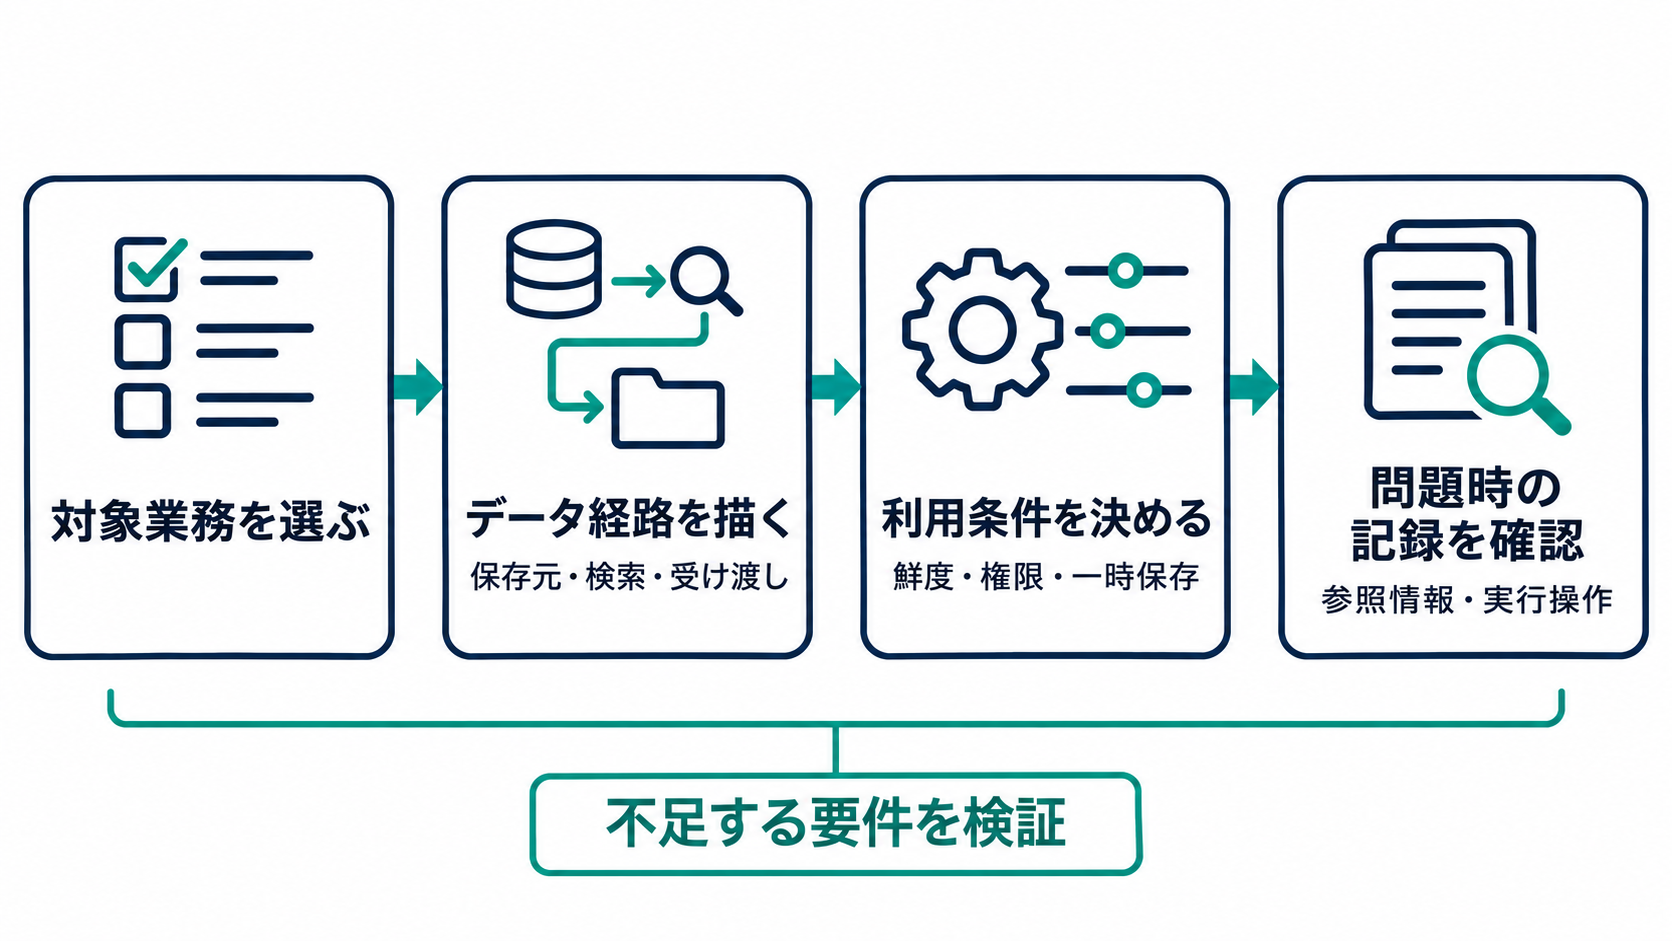
日本企業がこの議論を導入判断に生かすなら、最初に行う作業は、対象業務のデータ経路を描くことです。例えば、社内文書を参照して問い合わせに回答する業務であれば、文書の保存場所、検索対象になるまでの処理、エージェントへの受け渡し、回答の記録までを一続きで確認します。評価対象を回答文だけに絞ると、情報の欠落や古さがどこで生じたかを見落としやすくなります。
確認する際には、必要な情報の鮮度、参照できる範囲、一時保存の有無、問題発生時に残る記録を具体化するとよいでしょう。「適切に管理する」という方針だけでは、設計や製品評価に使いにくいためです。利用部門が必要とする情報と、システム側が実際に取得できる情報に差がないかを確かめることも、試行段階で取り組める作業です。
製品の評価方法にも工夫が必要になります。正常なデータで期待する回答が返るかに加え、参照先が利用できない場合や、必要な情報が欠けている場合に、処理がどう振る舞うかを確認する方法が考えられます。その際に、担当者が記録を見て原因を説明できるかまで確かめれば、運用開始後の調査に必要な機能も見えやすくなるでしょう。これは今回の議論から導ける実務上の提案です。
モデルの性能が高くても、判断時点のデータを追えなければ、障害対応や監査の負担は残ります。反対に、必要なデータと記録を定義できれば、エージェントに任せる範囲を業務単位で判断しやすくなります。導入を検討中の担当者は、候補業務を一つ選び、「この処理が誤った結果を出したとき、参照情報と実行操作を記録から確認できるか」を関係部署で確かめてください。答えられない箇所が、実証実験で優先して検証すべきデータ基盤の要件になります。
参考情報
Agents that build their own databases are forcing a data foundation rethink
SiliconANGLEによる、KubeCon + CloudNativeCon North Americaでのサンジーブ・モハン氏へのインタビュー報道です。取材を行ったtheCUBEは同イベントの有料メディアパートナーです。SiliconANGLEは、イベント取材のスポンサーに編集権はないと開示しています。