

2026/11/18
AIニュース
SID AIの検索特化モデル「SID-2」、企業のRAGを変える自律検索とSwarmの実力
この記事の要点
SID AIが、検索結果を読みながら探索を進める検索特化モデル「SID-2」と、複数エージェントで探索する「SID-2 Swarm」を公開しました。自社評価では12エージェント構成がNDCG 0.720を記録しています。ただし、分野による精度差や測定条件には注意が必要です。企業向けに仕組み、料金、既存RAGとの接続、自社文書での検証ポイントを整理します。
目次
回答を書く前の「必要な文書を探す工程」に特化
社内規程を検索しても、質問への答えが載っている文書にたどり着けない。生成AIに複数の資料を渡したのに、判断に必要な一件が抜けている。企業の文書活用では、回答の文章力よりも、その手前の検索が結果を左右する場面があります。SID AIが発表した第2世代の検索モデル「SID-2」は、この文書探索を専門に担います。
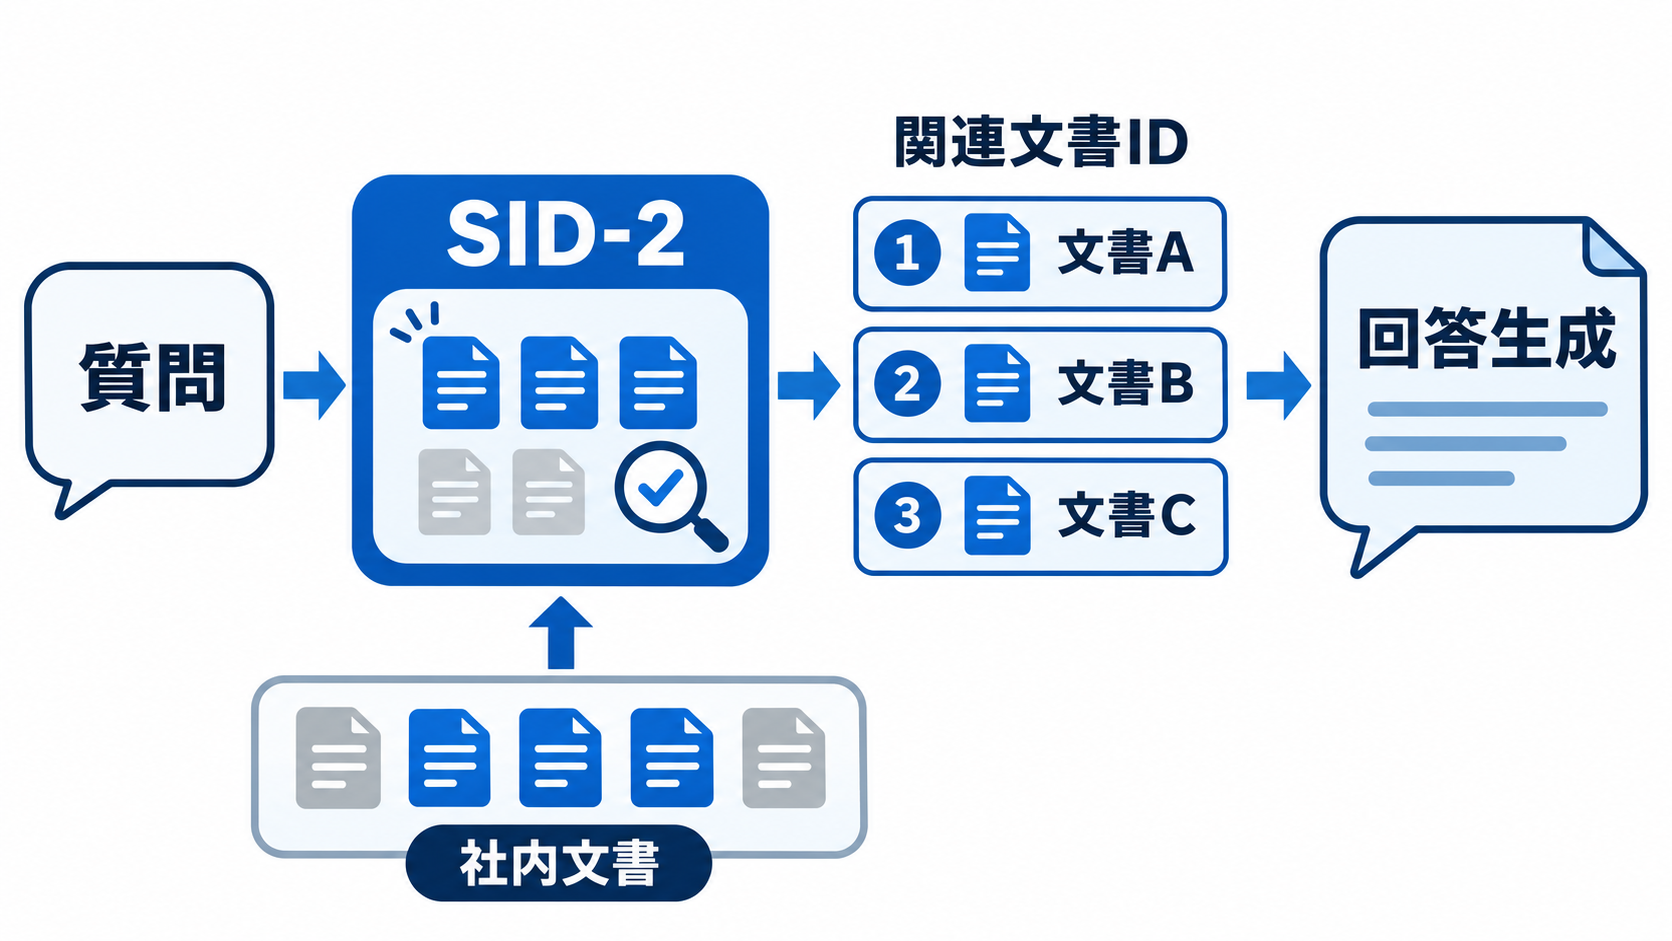
SID-2は、利用者と幅広い話題で会話する汎用モデルではありません。企業などが保有するデータを検索し、取得した内容を読み、関連性の高い文書のIDを順位付きで返すモデルです。最終的な成果物は回答文ではなく、回答の根拠として使う文書の候補になります。回答生成までを一つのモデルに任せる構成とは、役割の置き方が異なります。
この違いを理解するには、RAGという仕組みを押さえると整理しやすくなります。RAGは、質問に関係する情報を外部の文書群から検索し、その情報を使って生成AIに回答させる方法です。検索段階で必要な資料を取り逃すと、後段のモデルが参照できる根拠も不足します。SID-2が改善を狙うのは、この入口に当たる工程です。
SID AIは、単体のSID-2に加えて、複数の検索エージェントを動かす「SID-2 Swarm」も公開しています。自社評価では、単体モデルで応答時間を抑え、Swarmで検索品質を高める結果を報告しました。ただし、示された数値は同社による測定です。企業が注目すべき論点は最高スコアだけではなく、自社の検索基盤でも必要な文書を速く、漏れなく拾えるかという点でしょう。
固定手順の検索から、結果を読んで探し直す検索へ
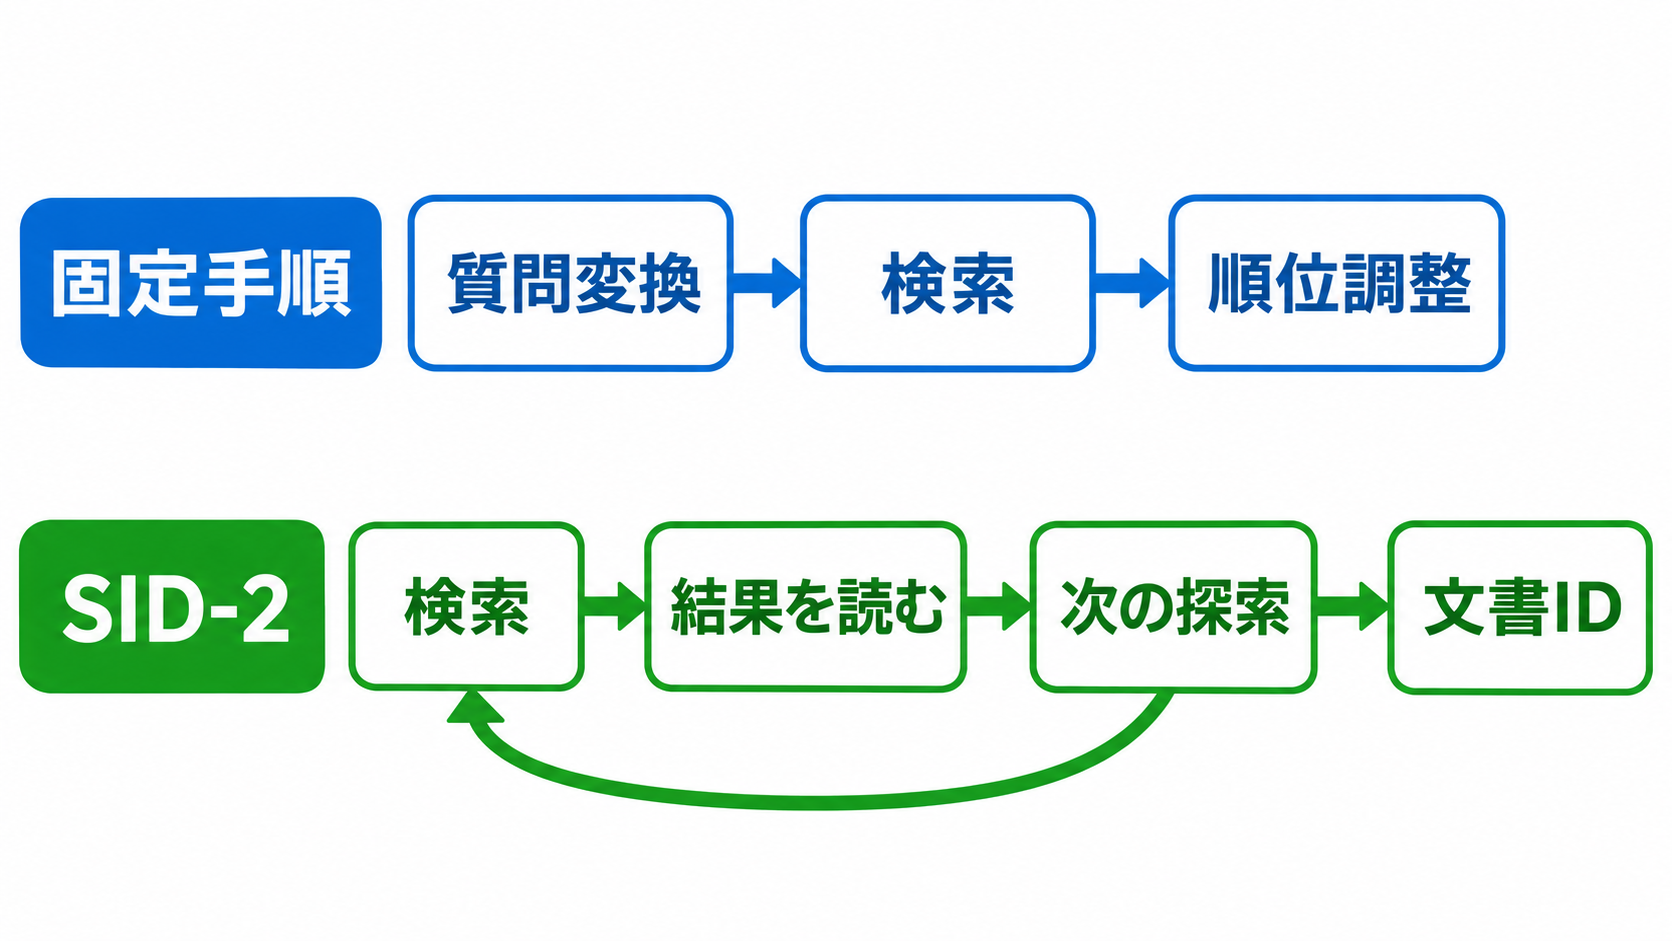
一般的なRAGの構成例では、質問を書き換え、文章を数値表現へ変換し、検索し、候補の順位を付け直す処理をあらかじめ組み合わせます。このような固定手順では、処理の流れを開発側が設計します。SID-2は、検索結果を読んだうえで次に何を探すかを判断し、必要に応じて検索を繰り返す方式です。ここでいう「エージェント型」とは、探索の途中で次の行動を選べることを指します。
開発者は、自社の検索基盤に接続するツールを実装します。キーワード検索には「text_search」、意味の近さを利用するベクトル検索には「search」を使います。モデルはこれらを通じて情報を取得し、探索の最後に「report_helpful_ids」を呼び出して、有用な文書IDを順位付きで返します。
例えば、社内制度の正式名称を利用者が知らない場合を考えてみます。最初の検索結果から制度名や関連部署の名称が分かれば、その語句を使って別の資料を探す、という進め方が考えられます。これは仕組みを理解するための例であり、特定の社内業務でSID-2の精度が確認されたという意味ではありません。検索の途中で得た手掛かりを、次の探索に使える点が特徴です。
SID AIによると、既存データの再インデックス化や移動は不要です。モデルが見る情報は、開発者のツールが返す範囲に限られます。ただし、これだけで接続作業が不要になるわけではありません。検索結果として本文のどこまでを返すか、文書IDをどう対応付けるか、利用者の閲覧権限をどう反映するかは、導入側で設計する必要があります。既存の検索資産を使えることと、そのまま業務運用できることは分けて確認したいところです。
Swarmと評価指標で、検索の広さと目的を調整
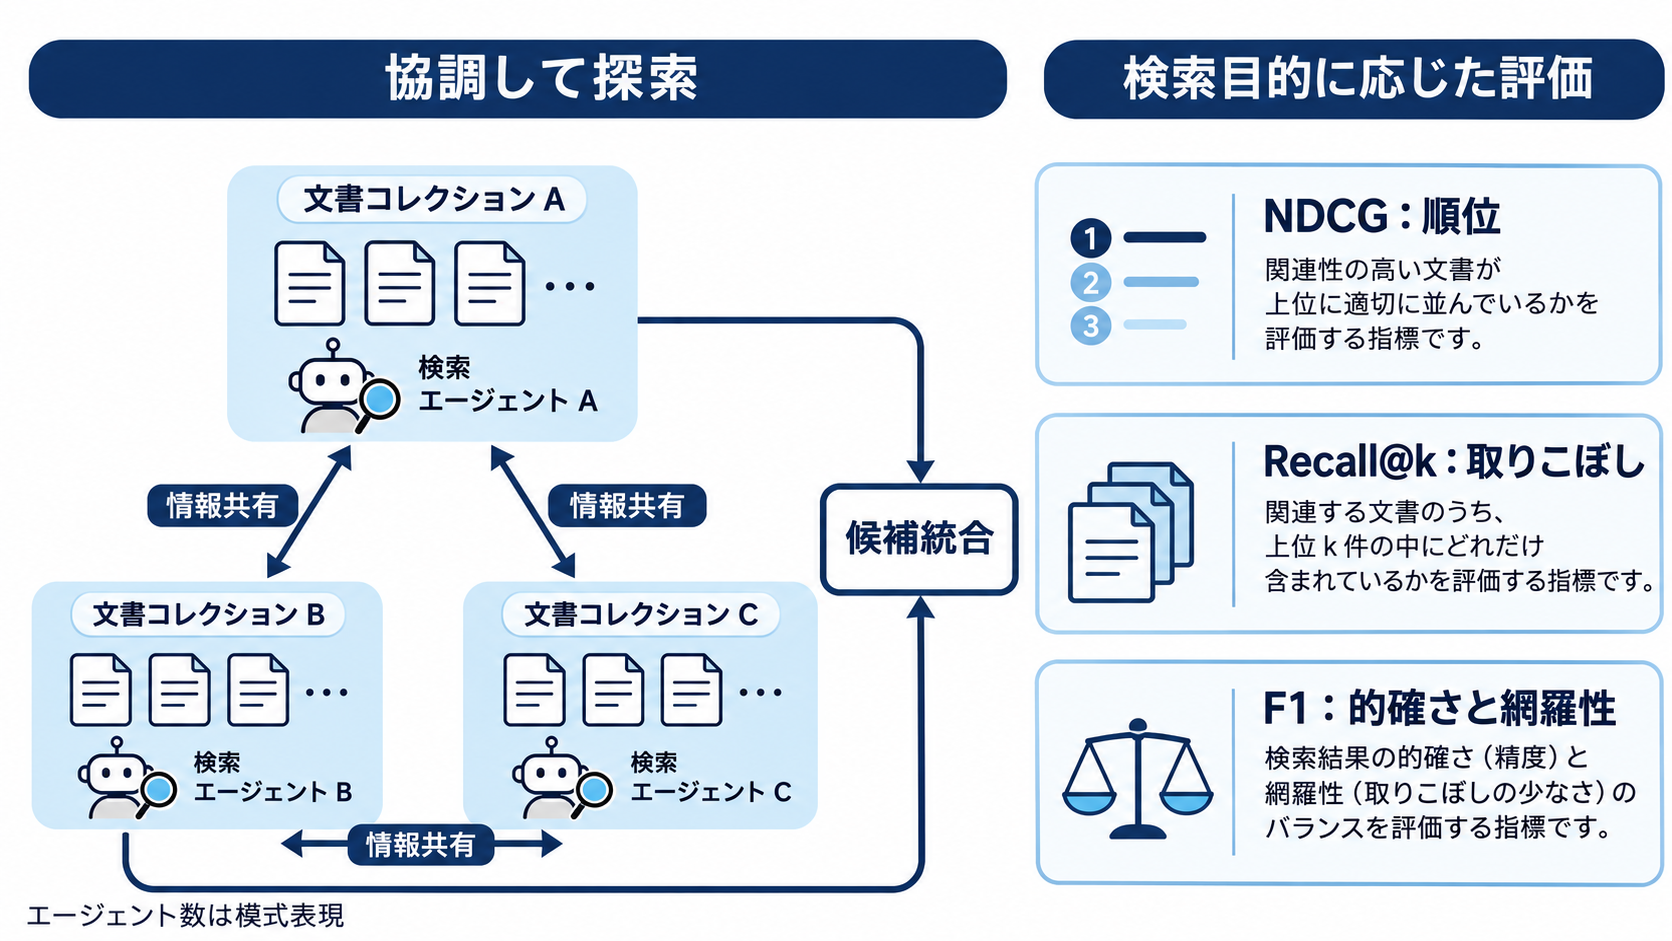
SID-2 Swarmは、複数のエージェントが文書群の異なる部分を探索する仕組みです。エージェント同士でメッセージを交換し、自身の文脈を引き継いだ新しいエージェントを分岐させることもできます。SID AIは、検索では一つの文書について長く推論することより、多くの文書を読むことが品質向上につながるという考え方を示しています。
この設計は、答えの根拠が複数の資料に散らばる業務を考えると理解しやすくなります。探索する範囲を分担できれば、一つの経路だけでは見つけにくい候補にも接近できる可能性があります。ただし、エージェント数を増やせば常に実用上の利益が増えるとは限りません。後述する測定でも単体とSwarmでは時間や費用が異なるため、品質との釣り合いを見る必要があるでしょう。
単体のSID-2には、推論の強さを低・中・高から選ぶ設定があります。それぞれを別の専門モデルとして学習させた後、複数の教師モデルから振る舞いを学ぶ蒸留という手法で統合しています。加えて「Metric Steering」により、NDCG、F1、Recall@kのいずれを重視するかを指定できます。kの指定範囲は1から50です。
NDCGは、関連性の高い文書を上位へ並べられているかを見る指標です。Recall@kは、上位k件に必要な文書がどれほど含まれるかを測り、F1は検索の的確さと取りこぼしの少なさを合わせて評価します。担当者に少数の候補を見せたいのか、後段の処理へ幅広く根拠を渡したいのかによって、適切な指標は変わります。SID AIは506問の検証セットで、高推論設定が基盤モデルを各指標で0.14〜0.22上回ったと報告していますが、自社業務では何を「良い検索」とするかを先に決めることが欠かせません。
最高0.720の検索品質を、測定条件とともに読む
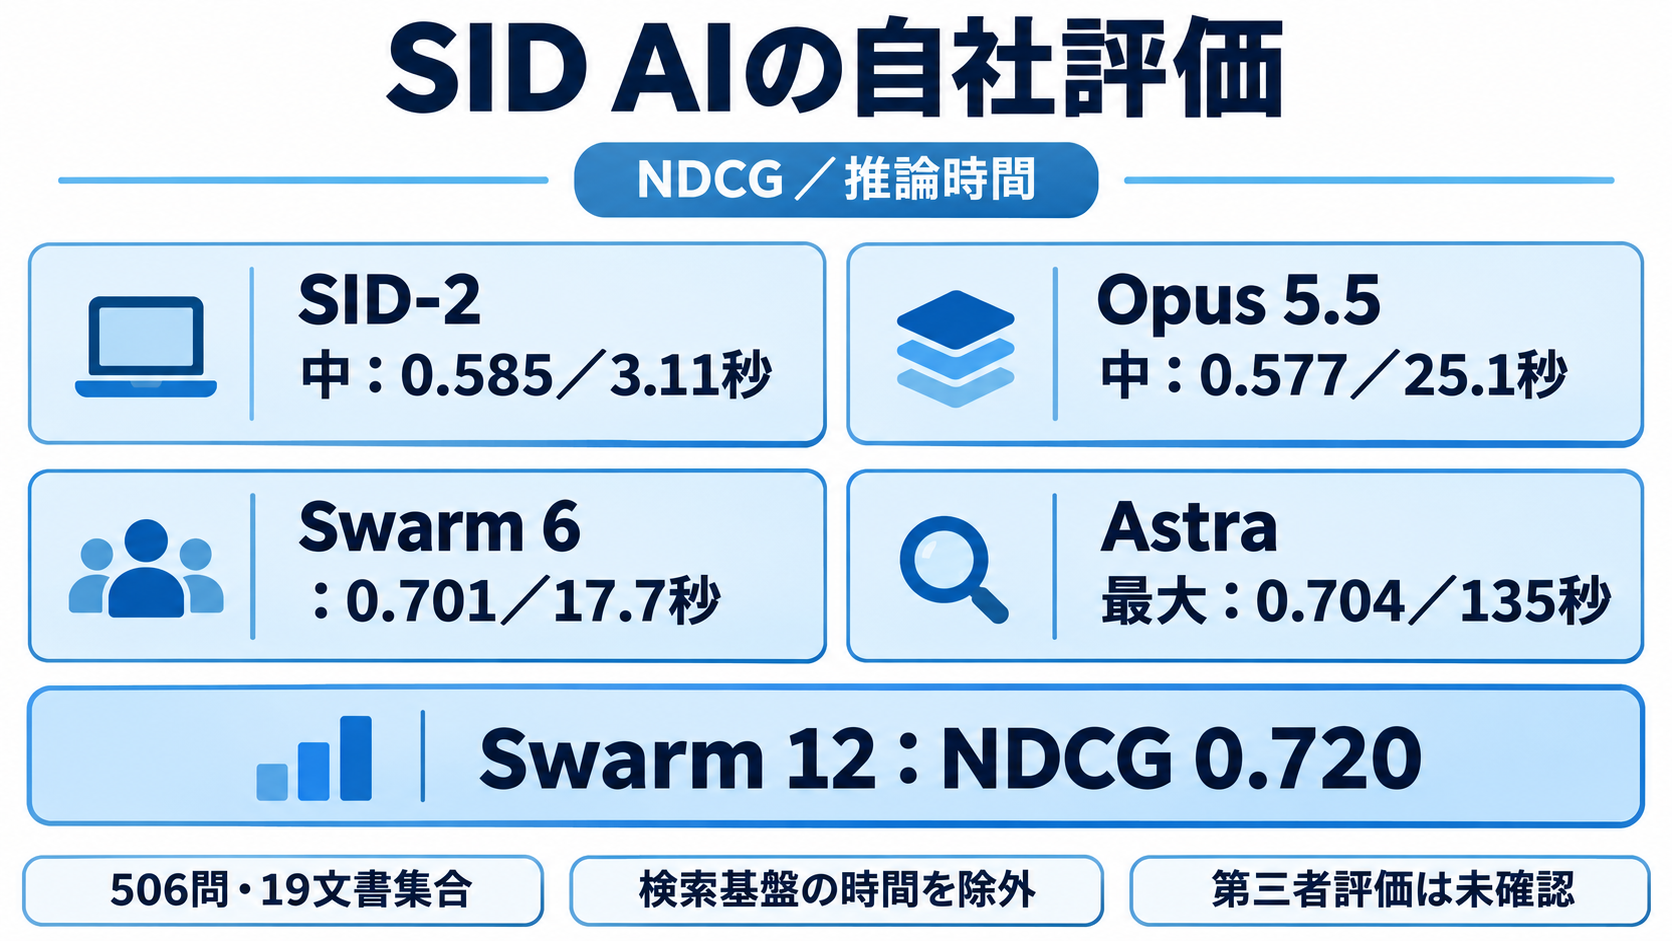
SID AIは、19の文書集合にまたがる506問のベンチマークでSID-2を評価しました。対象には、複数の情報を組み合わせる質問を含むHotpotQA、米エネルギー企業Enronのメール、米証券取引委員会のSEC提出書類、医学・生命科学文献のPubMedなどが含まれます。文書の性質が異なる対象を集めていますが、測定の設計と実施はSID AIによるものです。
同社の報告では、中推論設定のSID-2はNDCGが0.585、1クエリ当たりの推論時間が3.11秒でした。比較対象のClaude Opus 5.5の中推論設定は、NDCGが0.577、推論時間が25.1秒です。この測定では、SID-2が近い検索品質を短い推論時間で示しています。ただし、これは検索文書の順位付けの評価であり、回答文の正確さや会話能力全体を比較した結果ではありません。
6エージェントのSwarmはNDCGが0.701、推論時間が17.7秒でした。GPT-6 Astraの最大推論設定は、それぞれ0.704、135秒と報告されています。12エージェントのSwarmはNDCGが0.720で、比較表の最高値を記録しました。ただし、ここで示された12エージェント構成の情報には対応する推論時間がないため、6エージェントの時間を当てはめることはできません。
平均スコアだけでは見えない差もあります。Swarmが首位だったのは19の文書集合のうち11で、カリフォルニア州法、SEC提出書類、金融分野の質問応答データFiQAではAstraが上回っています。また、低推論設定のSID-2はNDCGが0.556で、Astraより0.148低い結果でした。SID-2の時間測定はB200 GPUを1基、同時クエリ数を8とする条件を前提とし、検索基盤側の処理時間を含みません。モデル規模や重みは非公開で、独立した第三者評価も確認されていないため、数値は導入候補を絞る材料として扱うのが妥当です。
API料金と検索一件の費用は、別々に見積もる
SID-2は、SID AIのホスト型APIと、AIモデルの配信基盤を提供するBasetenで利用できます。AWSの機械学習サービスであるSageMaker向けの補助実装も案内されています。SDKはPython、TypeScript、Goに対応し、参照実装にはOpenAIクライアント形式が使われています。既存アプリケーションへ組み込む際は、利用言語だけでなく、検索ツールとの接続方法まで確かめると検討を進めやすくなります。
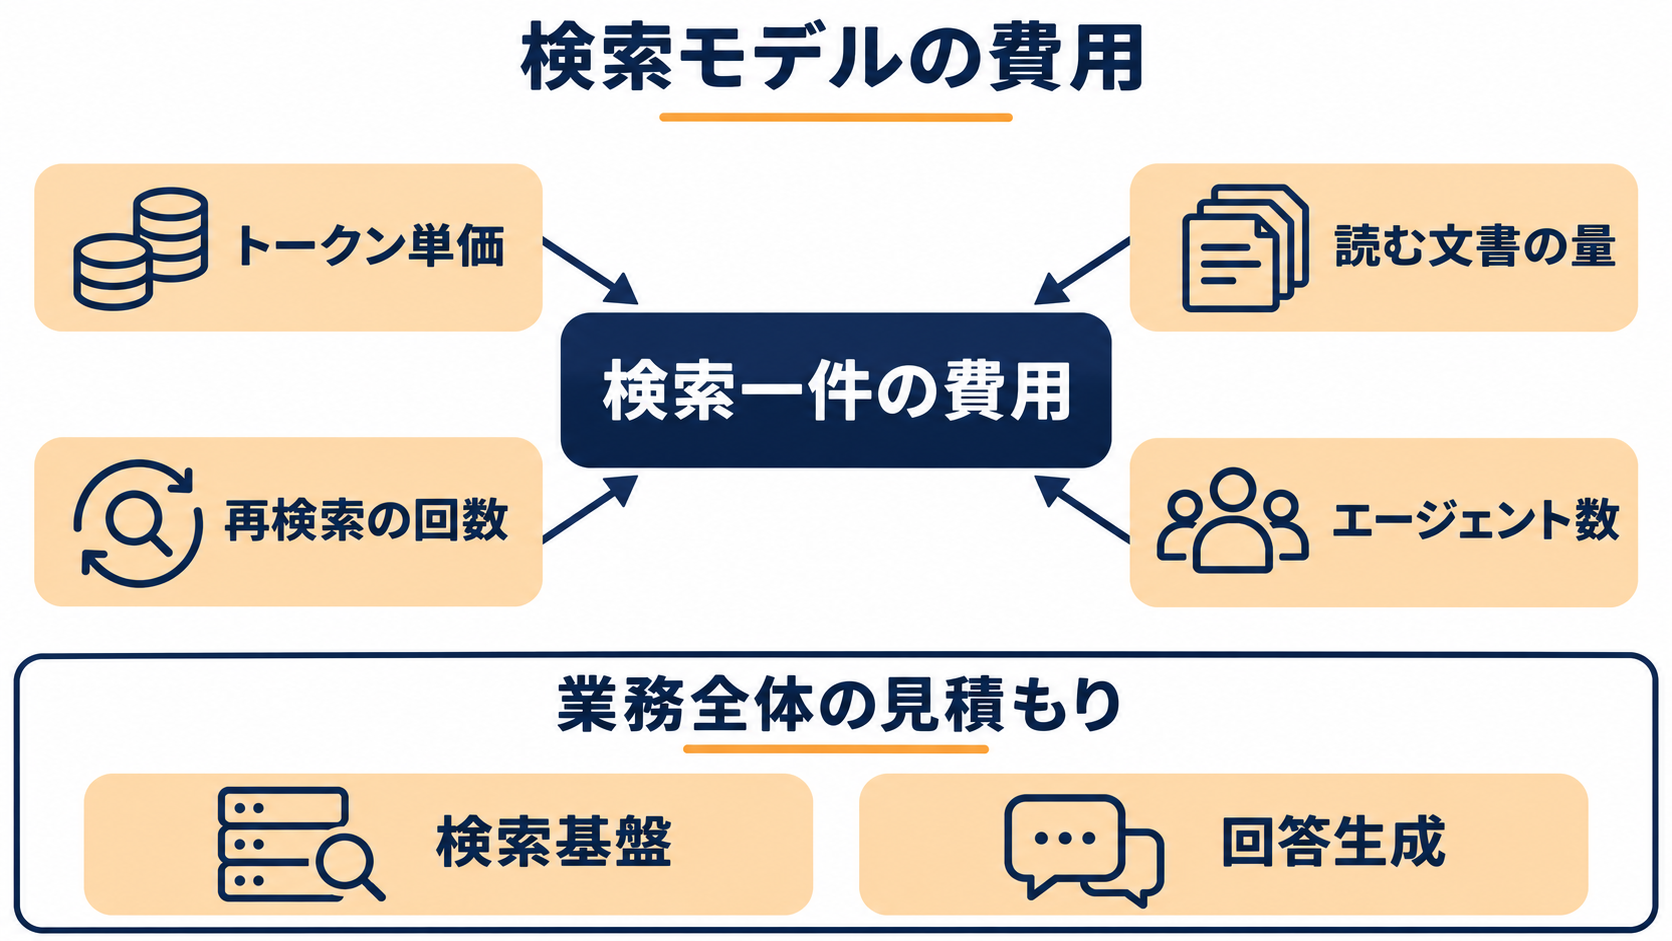
公表されたAPI料金は、SID-2が100万入力トークン当たり0.25ドル、100万出力トークン当たり1ドルです。Swarmは、それぞれ0.50ドルと2ドルになります。キャッシュ済み入力の単価は通常の入力料金の10%とされています。トークンは文章の処理量を数える単位であり、この単価から検索一件の請求額が直接決まるわけではありません。
SID AIのベンチマークでは、1,000クエリ当たりの費用はSID-2の中推論設定が6.54ドル、6エージェントのSwarmが263ドルでした。比較対象はGPT-6 Astraが2,141ドル、Claude Opus 5.5が131ドルと報告されています。これらは同社の評価条件で計算された値です。入力・出力の単価と、探索中に使う総トークン数を混同しないよう注意が必要でしょう。
実務の費用見積もりでは、取得する文書の長さ、再検索の回数、エージェント数に加え、既存の検索基盤や回答生成の処理も検討対象になります。時間についても、利用者が待つのはモデルの推論だけではありません。検索システムへの通信や文書取得を含めた、問い合わせから結果表示までの時間を測る必要があります。なお、コンテキスト長は技術報告で262kトークン、モデルページで256kトークンと表記に差があるため、長い資料を扱う場合は利用先の仕様確認も欠かせません。
導入の第一歩は、自社の「探し損ねる質問」の収集
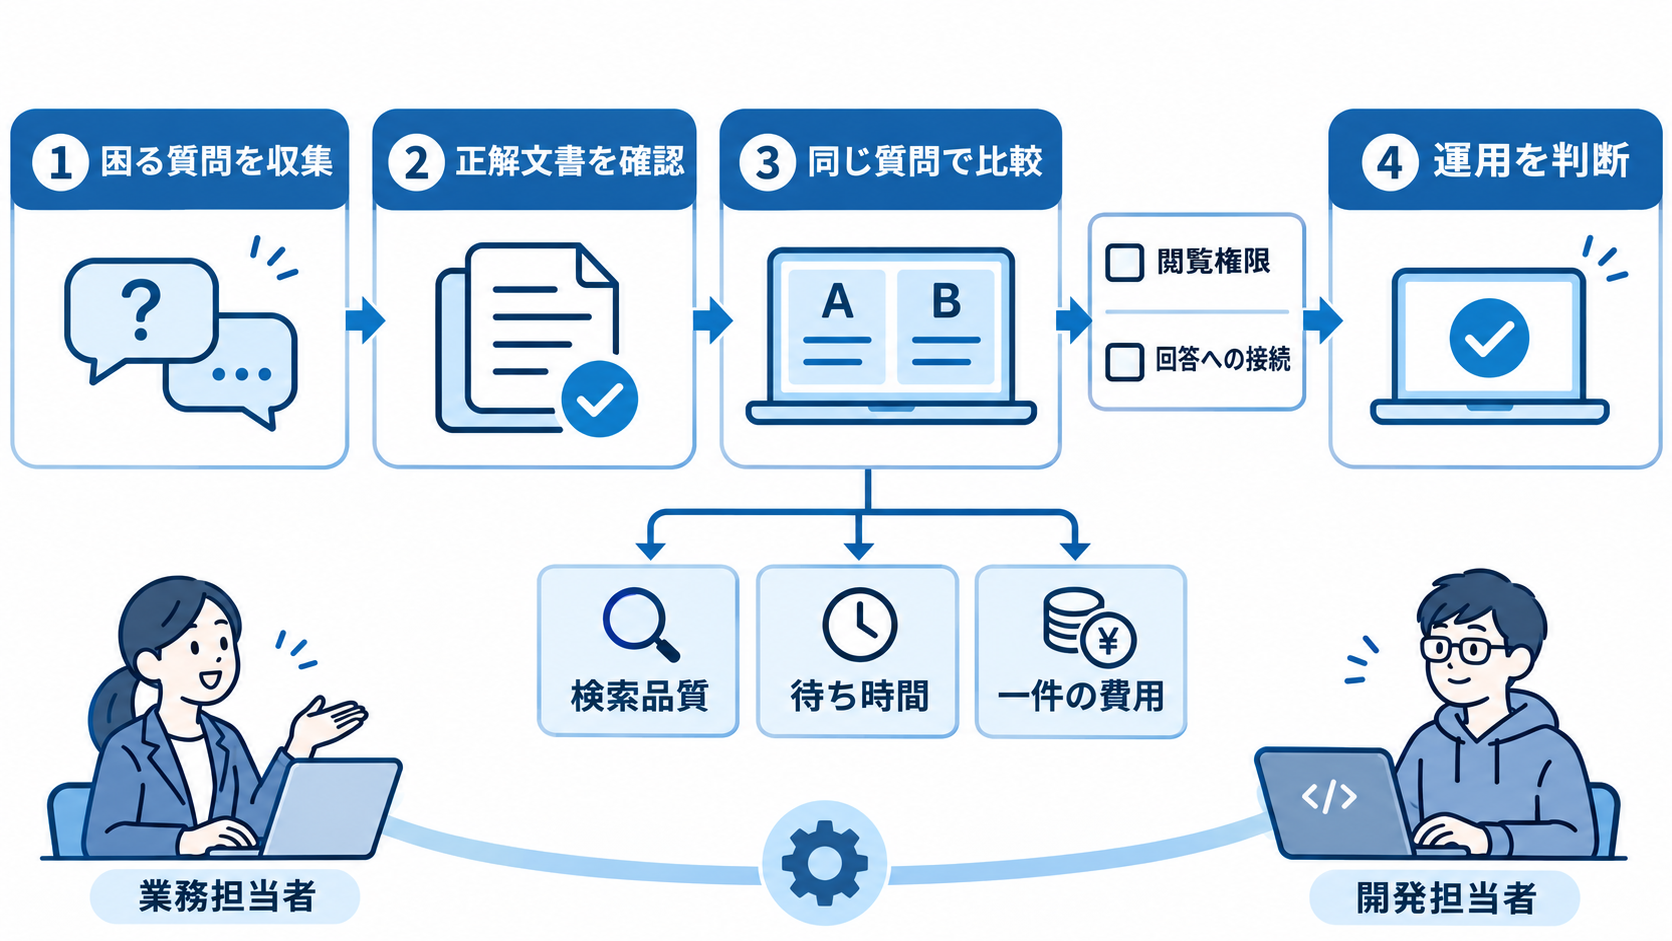
企業がSID-2を試すなら、現在の検索で困っている質問を集めるところから始めると目的が明確になります。正式な製品名を含まない問い合わせ、複数部署の資料を参照する質問、似た文書が多く正しい版を選びにくい質問などが候補になるでしょう。それぞれについて、見つけるべき文書と、その文書が必要な理由を担当者が確認できる形にすると、検索結果を業務の観点から評価できます。
評価では、現在の検索方式、SID-2の単体構成、必要に応じたSwarm構成へ同じ質問を入力します。上位候補の関連性だけでなく、必要な根拠の取りこぼし、結果が返るまでの時間、一件当たりの費用を合わせて見ることが大切です。特定分野で比較モデルが上回るという公表結果も、自社の文書で検証する理由になります。
SID-2が返すのは文書IDなので、回答生成まで含む業務では後段との接続も確認しなければなりません。選ばれた文書の本文を取得できるか、回答内の根拠へ結び付けられるか、閲覧権限のない資料が候補に混ざらないかが確認項目です。検索で適切なIDを返せても、回答に必要な箇所が後段へ渡らなければ、利用者が感じる改善にはつながりにくくなります。
SID-2の学習では、最初に検索品質を最適化し、その後に処理の遅延を抑えるためのペナルティを加える2段階の強化学習が使われています。品質と速さの両方を狙う設計ですが、どちらを優先すべきかは業務で異なります。担当者が即座に候補を確認する検索と、時間をかけて根拠を集める調査では、同じ設定が適するとは限りません。導入検討では、自社で探し損ねている質問を一つ選び、正しい文書へ到達するまでの時間と費用を現在の仕組みと比較することが、具体的な出発点になります。