
2026/10/31
今更聞けないAI知識
LLMとは何? チャット画面の奥で文章を組み立てる「言葉のモデル」
チャットAIに質問するとき、実際には何を使っているのか
チャット画面に質問を入力すると、数秒後には自然な文章が返ってきます。その様子だけを見ると、画面の中に知識豊富な回答者がいるように感じるかもしれません。しかし、文章を生成する中心的な仕組みは、人のように物事を考える存在ではありません。そこで使われることが多いのが、大規模言語モデル、英語の頭文字を取ったLLMです。
一言で表すなら、LLMは「大量の文章から言葉のパターンを学んだモデル」です。質問の内容や、それまでの会話を手掛かりに、どのような言葉の並びが適切そうかを計算し、回答を組み立てます。ここでいう「学ぶ」は、人が本を読んで意味を理解したり、体験を記憶したりすることと同じではありません。入力と出力の間にあるパターンを、計算に使える形へ反映する処理を指します。
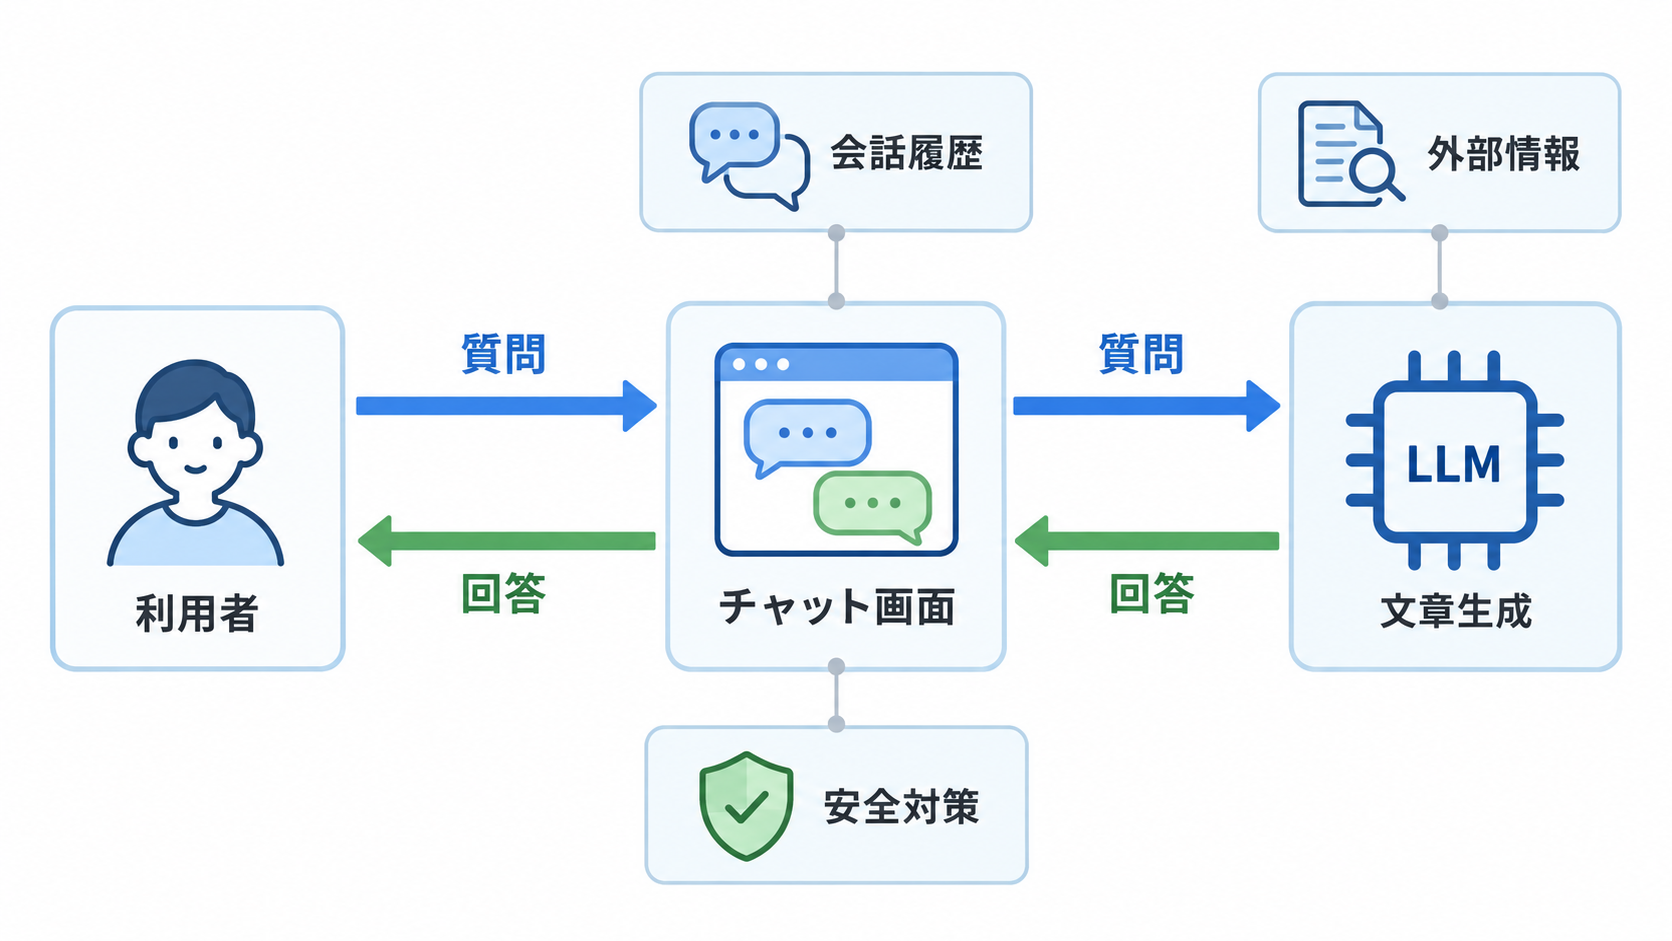
LLMと、普段目にするチャットアプリも同じものではありません。Googleの機械学習用語集では、チャットボットをLLMの応用例と説明しています。つまり、チャット画面は利用者とのやり取りを受け付ける窓口であり、LLMは文章を処理・生成する中核の一つです(出典: Google for Developers)。アプリ側には、入力欄、会話履歴の管理、安全対策、外部情報を扱う仕組みなどが組み合わされる場合がありますが、それらすべてをLLMと呼ぶわけではありません。
身近なたとえなら、チャットアプリはレストラン全体、LLMは調理を担う厨房の設備に近い関係です。客から注文を受ける人、メニュー、食材の確認、配膳の仕組みまで含めて店が成り立つように、対話サービスもLLMだけで完成するとは限りません。この違いを知っておくと、「チャット画面でできることは、すべてLLM単体の能力なのか」という疑問を切り分けやすくなります。
「大規模・言語・モデル」の三語が示すもの
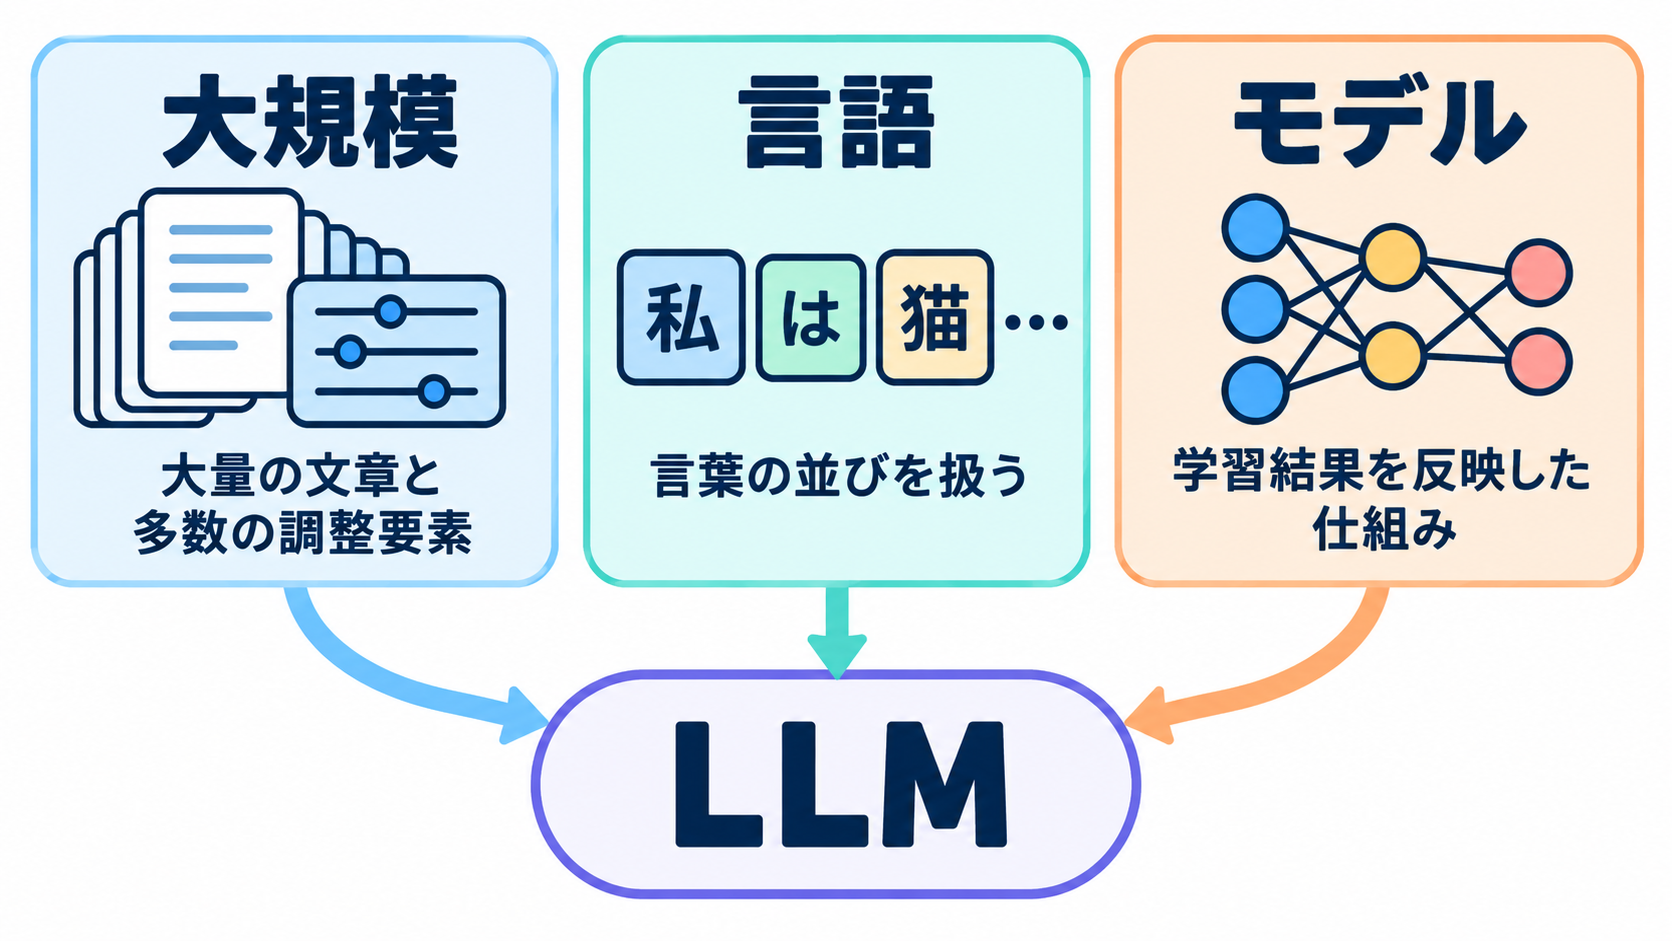
「大規模言語モデル」という長い名称は、三つに分けると輪郭が見えてきます。「大規模」は、学習に使うデータや、学習によって調整される多数のパラメーターなど、仕組みの規模が大きいことを示します。IBMは、基盤モデルの学習では大量の未整理データを扱い、学習結果が多数のパラメーターに反映されると説明しています(出典: IBM)。ただし、「大規模」という言葉だけから、特定のデータ量や性能を一律に判断することはできません。
「言語」は、主に文章や言葉の並びを扱うことを表します。入力された文を処理し、その文脈に応じた文章を生成できる点が特徴です。画像や音声を扱えるサービスの中にもLLMが組み込まれる場合はありますが、画像生成モデルや音声生成モデルまで、すべてをLLMと呼ぶわけではありません。IBMは、基盤モデルには言語向けのLLMだけでなく、画像、映像、音、音楽、複数形式を扱うモデルもあると整理しています(出典: IBM)。
最後の「モデル」は、学習データそのものを指す言葉ではありません。Google Cloudは、機械学習モデルを、アルゴリズムを訓練データ上で動かした結果として得られるものと説明しています(出典: Google Cloud)。身近なたとえに置き換えるなら、膨大な例文をしまった本棚というより、多数の文章を材料に調整された「言葉の予測用の調整盤」に近いでしょう。このたとえも仕組みを完全に表すものではありませんが、原文を一冊ずつ検索して取り出す装置ではない、という点を理解する助けになります。
三語を合わせると、「多くの文章を材料に大規模な学習を行い、言葉のパターンを計算に使える形へ反映したモデル」という姿が見えてきます。名称を分解できれば、「大規模だから何でも知っている」「言語を扱うから人と同じ意味理解をしている」「モデルの中に資料がそのまま保存されている」といった早合点を避けやすくなります。
学習時と回答時に行われることの違い
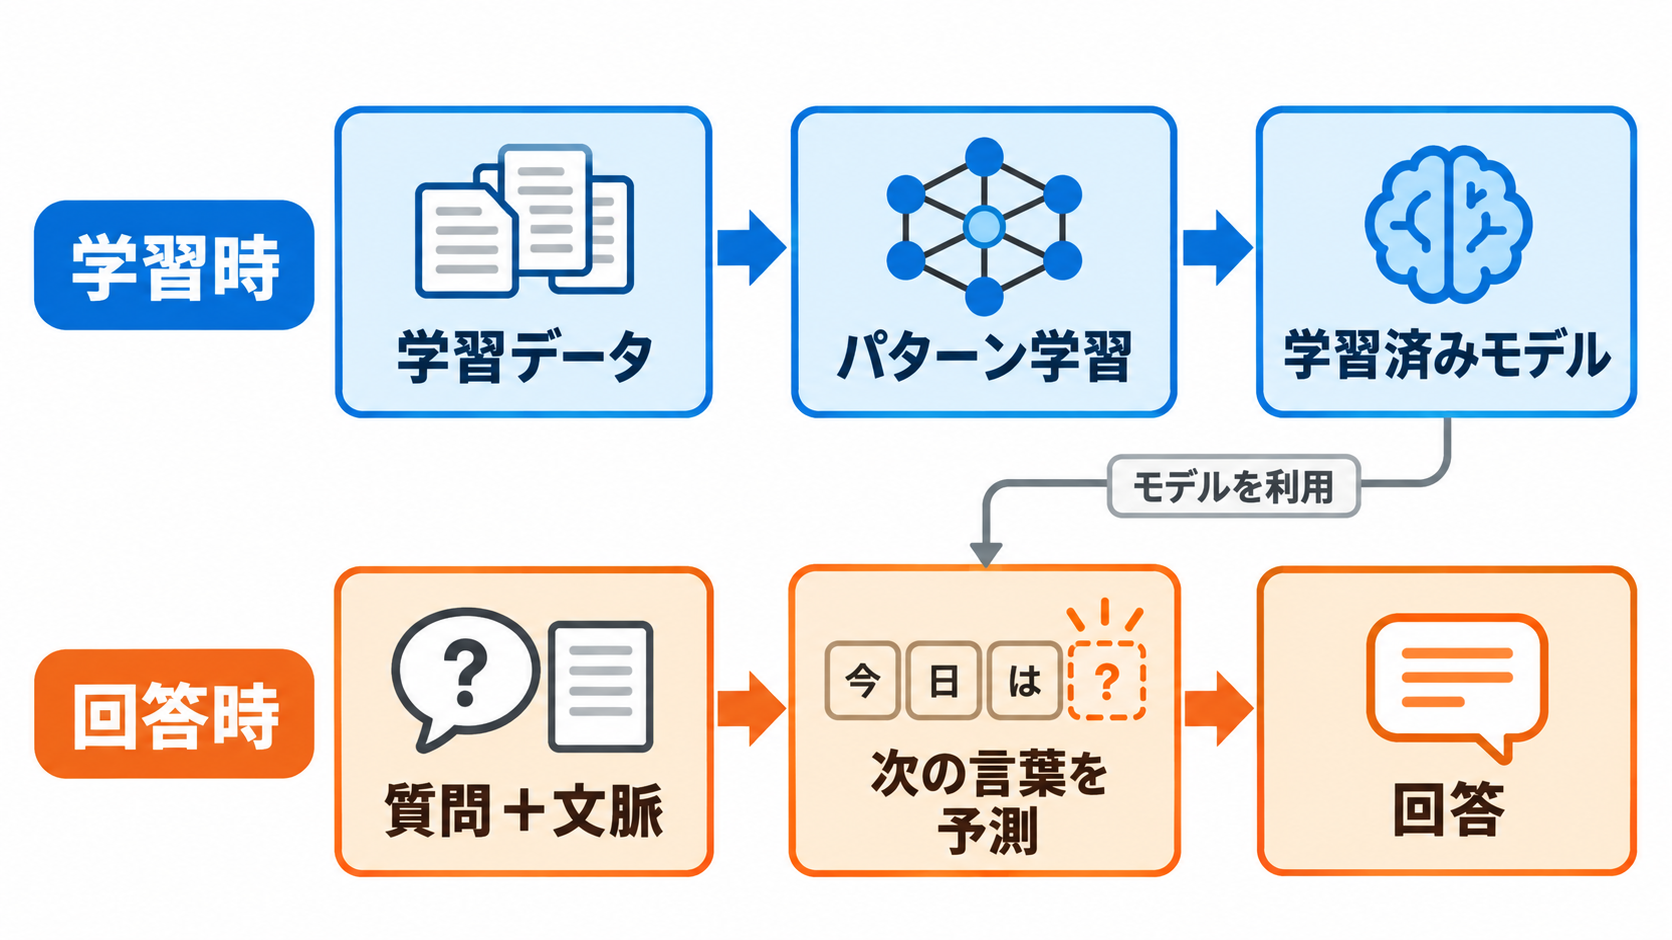
LLMを理解するうえで大切なのは、「学習」と「回答」を同じ処理だと思わないことです。学習時には、大量の文章に含まれる言葉の並びや関係を材料にして、モデルのパラメーターを調整します。IBMは、生成AIが大まかに学習、用途に合わせた調整、生成と評価および追加調整という段階を経ると説明しています(出典: IBM)。基礎となるモデルを作る学習と、利用者が質問を入力するたびに行われる文章生成は、役割の異なる段階です。
利用者が質問したときは、通常、その場で基盤モデルを一から学習し直しているわけではありません。学習済みのパターンと、入力された文や会話の文脈を使って回答を生成します。Googleの用語集によると、Transformerを基礎とするLLMは、それまでに予測された要素を基に次の要素を予測する自己回帰型モデルです(出典: Google for Developers)。文章全体を完成品として保管場所から取り出すのではなく、前後の流れに合いそうな続きを段階的に選ぶ、という見方が近くなります。
たとえば、架空の例として「会議の案内文を丁寧に書いてください」と入力したとします。LLMは、依頼文、案内文、丁寧な表現などに見られるパターンを手掛かりに、目的に合いそうな文章を構成します。実在する特定の案内文を探して、そのままコピーしているとは限りません。日時や会場が入力されていなければ、正確な予定を自動的に把握できるとも限らないため、必要な情報は利用者が与える必要があります。
会話を続けると前の回答が反映されるのも、直前までのやり取りが文脈として扱われるためです。Googleの用語集では、チャットにおける以前の入力と応答が、その後の会話の文脈になると説明されています(出典: Google for Developers)。これは、モデルが人間のように思い出を持つという説明ではありません。現在の処理に渡された会話内容が、続きの生成に利用されるという整理です。学習と回答を分けて考えれば、「今伝えた内容をモデル全体が永久に学習した」と決めつける誤解も避けやすくなるでしょう。
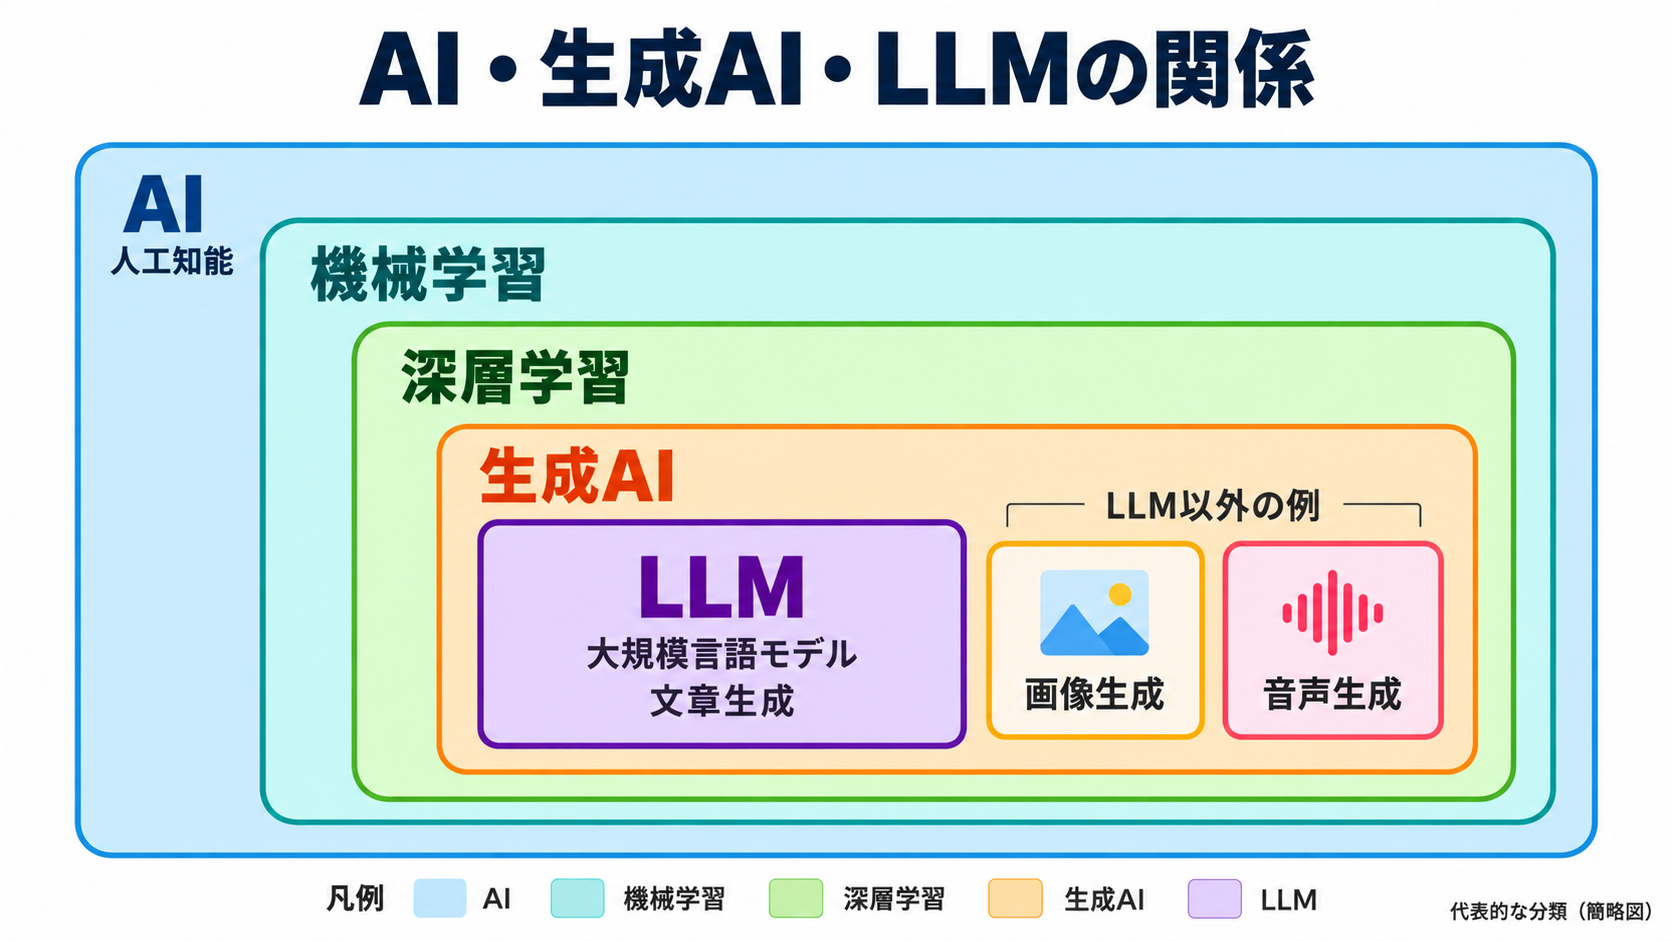
AI・機械学習・生成AIの中でのLLMの位置
LLMはAIそのものの別名ではありません。AIは、人の学習、理解、問題解決、意思決定などに関連する働きを機械で実現する技術を含む広い概念です。機械学習はその一部であり、データからパターンを学んで予測や判断に使うモデルを作ります。深層学習は、多層のニューラルネットワークを用いる機械学習の一分野です。IBMは、AI、機械学習、深層学習、生成AIを、関連しながら範囲の異なる概念として整理しています(出典: IBM)。
生成AIは、利用者からの指示で文章、画像、映像、音声などの新しい内容を生成する深層学習モデルを指します。LLMは、その中でも主に言葉を扱うモデルです。IBMは、現在の基盤モデルのうち、文章生成用途で一般的なものがLLMだと説明しています(出典: IBM)。したがって、「生成AIならすべてLLM」「AIならすべて生成AI」という関係にはなりません。
関係を大づかみに整理すると、次のようになります。
| 用語 | おおまかな意味 | 身近な例の見方 |
| --- | --- | --- |
| AI | 機械で認識や判断などを実現する広い技術領域です | 画像認識や推薦を含む広い範囲です |
| 機械学習 | データからパターンを学ぶAIの一分野です | 過去データに基づく予測などです |
| 深層学習 | 多層のニューラルネットワークを使う機械学習です | 言語や画像の複雑なパターン処理に使われます |
| 生成AI | 入力に応じて文章や画像などを生成するモデルです | 文章作成や画像生成などです |
| LLM | 主に言葉を扱う大規模なモデルです | 質問への文章回答や要約などです |
この表は、製品を厳密に分類するための判定表ではなく、言葉の範囲をつかむための整理です。一つのサービスに、LLM以外のモデル、検索、ルール処理などが同時に使われることも考えられます。チャット形式だからLLM、文章を扱うから必ずLLM、と画面だけで断定することもできません。サービスの説明を読むときは、「AI」という広い呼び名と、「LLM」という具体的なモデルの種類を分けて確認すると、機能の説明を必要以上に広く受け取らずに済みます。
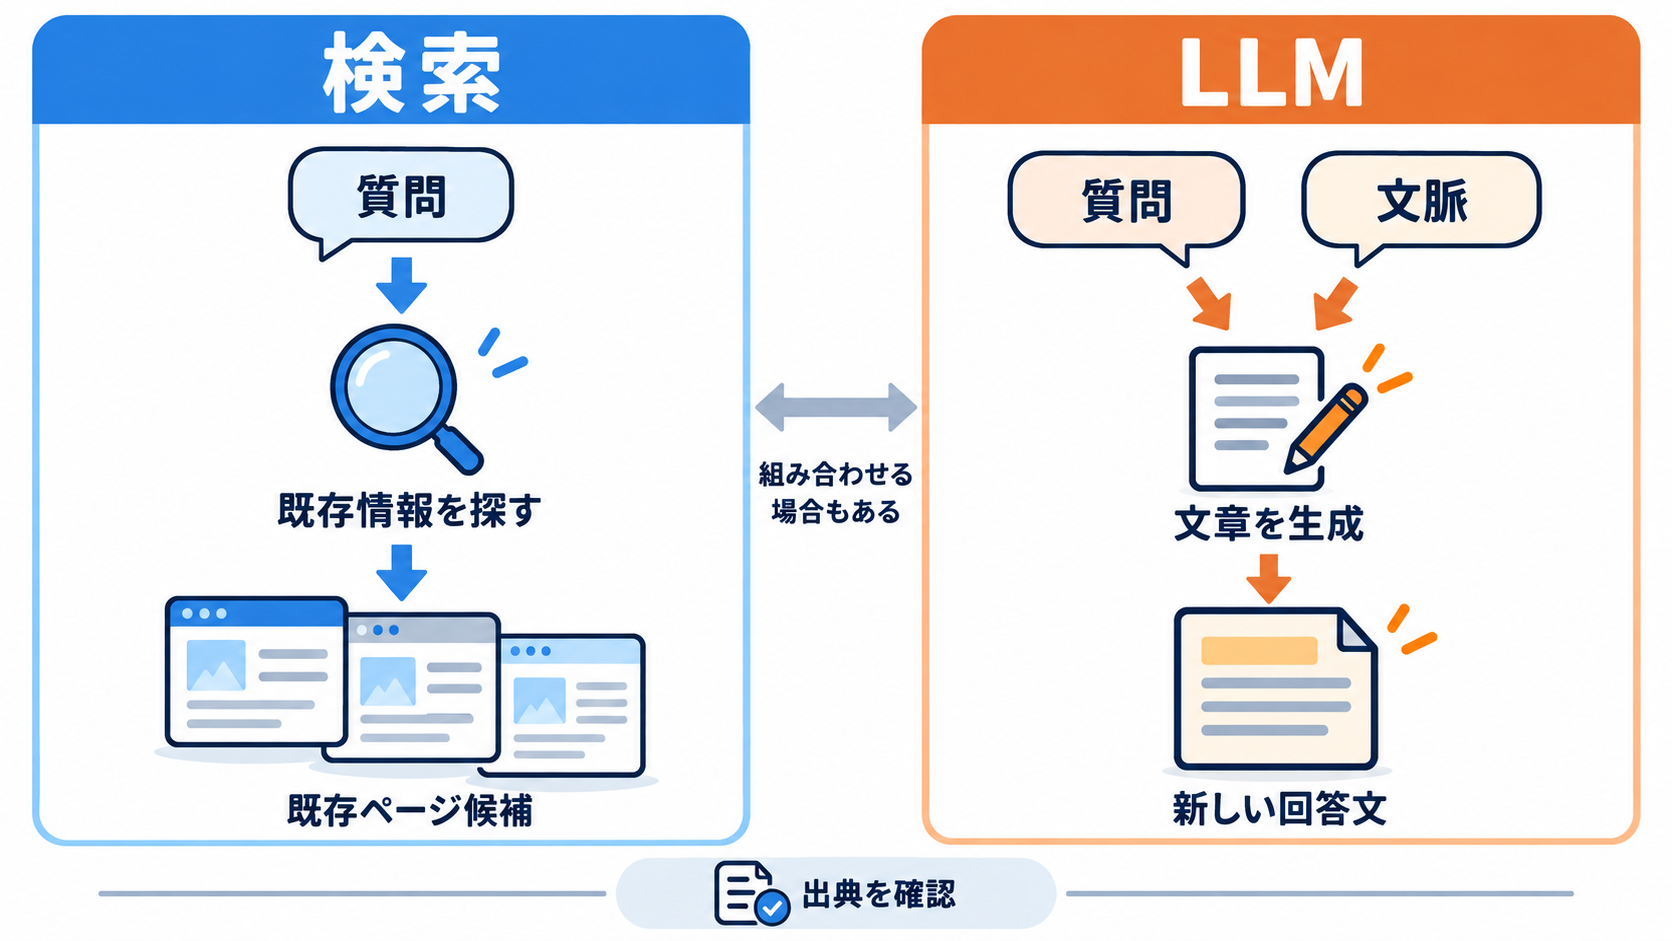
LLMと検索が似て見えても同じではない理由
知りたいことを入力して結果を受け取る点では、LLMを使うチャットと検索サービスはよく似ています。しかし、中心となる処理は異なります。検索では、入力した語句などを手掛かりに、既存のページや文書を探し、候補を示すことが基本になります。LLMは、学習済みの言葉のパターンと入力された文脈を基に、回答となる文章を生成します。生成結果に参考リンクが付いている場合でも、文章生成と情報検索を同じ処理だと思わないほうが安全です。
IBMは、基盤モデルの外にある関連情報を利用して生成結果の正確さや関連性を補う方法として、検索拡張生成、略してRAGを挙げています(出典: IBM)。この説明からも、LLMによる生成と、外部情報の検索・取得は区別できる処理だと分かります。両方を組み合わせたサービスはあり得ますが、LLMという名称だけで、常にウェブや最新資料を検索しているとは判断できません。
身近な場面では、目的によって使い分けると理解しやすくなります。たとえば、文章の言い換え案や、架空のイベント名の候補を考えるなら、LLMの生成機能が役立つ可能性があります。今日の交通規制、現在の価格、制度の施行日など、根拠と時点が重要な事実を知りたい場合は、公開元や信頼できる資料を検索し、日付を含めて確認する必要があります。これは特定サービスの性能を評価する話ではなく、生成と検索の役割を分けるための見方です。
「検索結果のように流暢だから、元ページが必ず存在する」と考えるのも誤解につながります。LLMは、依頼に合いそうな文章を組み立てられる一方、その文章の一文一文に自動で証拠が付くわけではありません。出典が必要な作業では、回答に資料名、URL、公開日を示すよう求めるだけで終えず、実際の資料を開いて記載内容と照合することが欠かせません。生成は下書き、検索は根拠探しというように役割を分ければ、便利さと確認作業を両立しやすくなります。
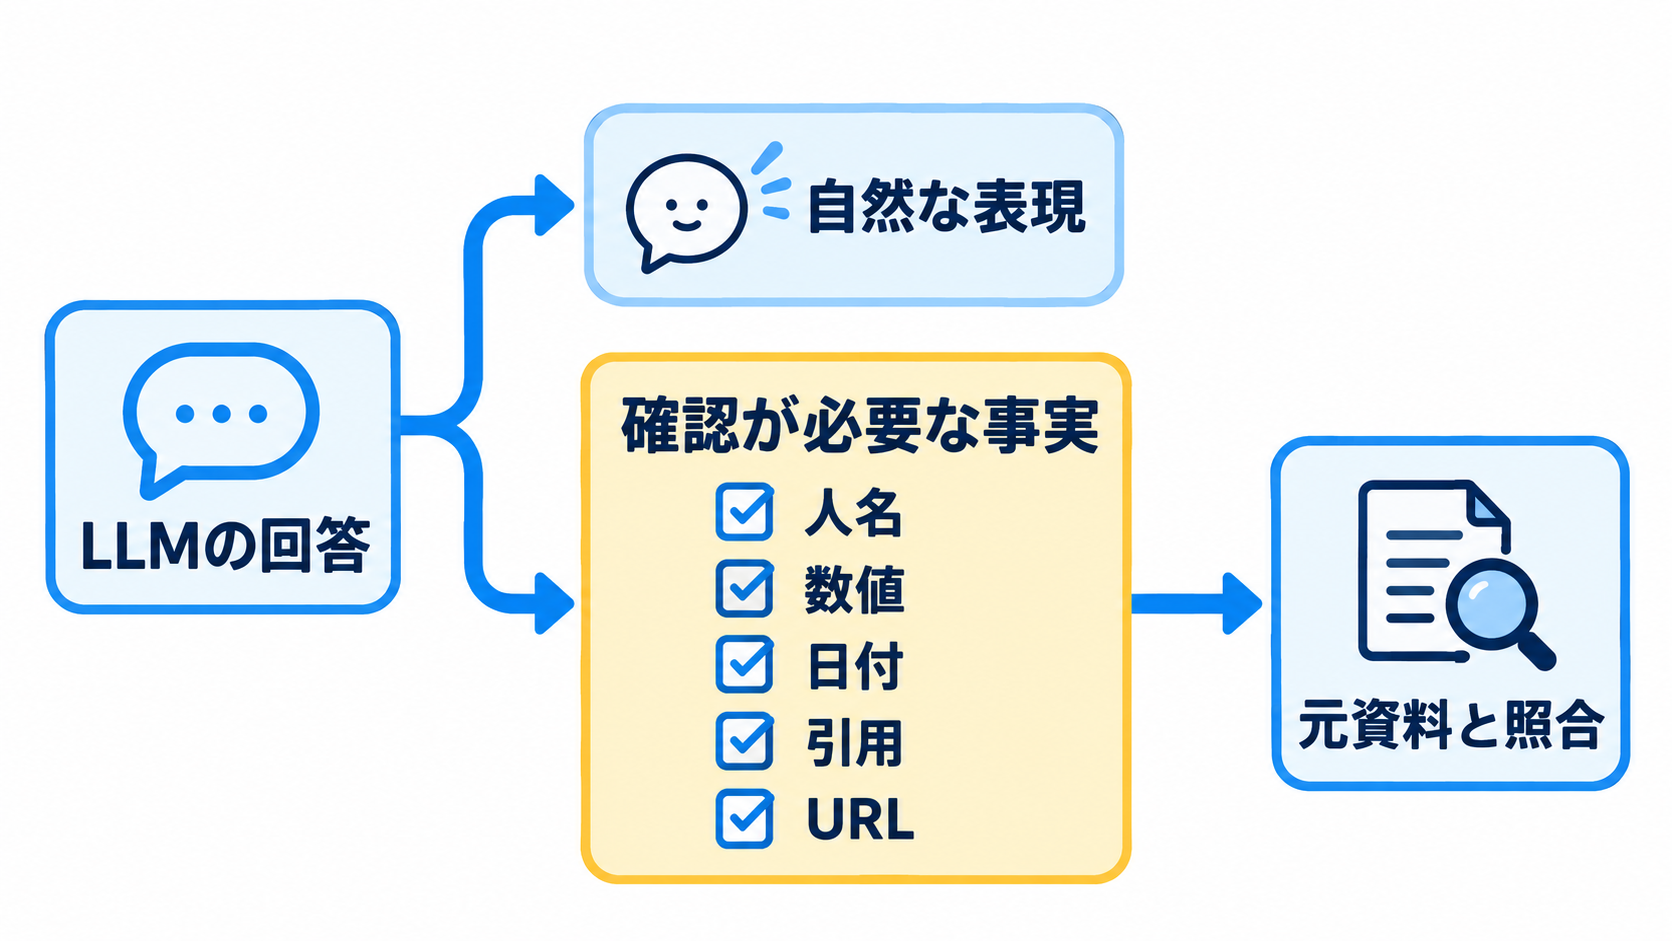
もっともらしい回答と正しい回答の境界
LLMの文章は、文法が自然で説明の形も整っていることがあります。しかし、読みやすさは事実の正しさを保証しません。次の言葉を予測しながら文章を構成する仕組みでは、言葉として自然な流れと、現実の出来事に一致する内容が常に同じになるとは限らないからです。「詳しく書かれている」「断定的に書かれている」「専門用語が入っている」という印象だけでは、正確さを判定できません。
Googleの用語集は、現実に基づく出力の性質を「事実性」として説明する一方、創作を求める依頼では、事実性より創造性が適切な場合もあるとしています(出典: Google for Developers)。たとえば、架空の物語の登場人物を考える依頼では、実在の根拠は必要ありません。社内規程の内容、契約条件、医療や法律に関わる判断などでは、創造的で自然な文章より、参照資料との一致が優先されます。良い回答の条件は、依頼の目的によって変わります。
確認するときは、回答全体を漠然と疑うのではなく、検証できる要素へ分けます。人名、数値、日付、制度名、引用、URLは元資料と照合できます。「唯一」「必ず」「最新」といった強い表現も、根拠の有無を確かめる対象です。資料に書かれている事実と、回答が行った要約・推測・提案を分けるだけでも、どこを重点的に見るべきかが明確になります。
仕事で使う架空の例なら、LLMに会議資料の要点整理を依頼した後、固有名詞と決定事項だけは原文へ戻って確認する方法が考えられます。これは効果を保証する手順ではなく、確認漏れを減らすための提案です。創作案には「面白いか」「目的に合うか」という基準を使い、事実説明には「根拠があるか」「時点が合うか」を使います。LLMの不得意を恐れるより、出力の用途に合わせて評価基準を切り替えるほうが、実際の判断に結び付きます。
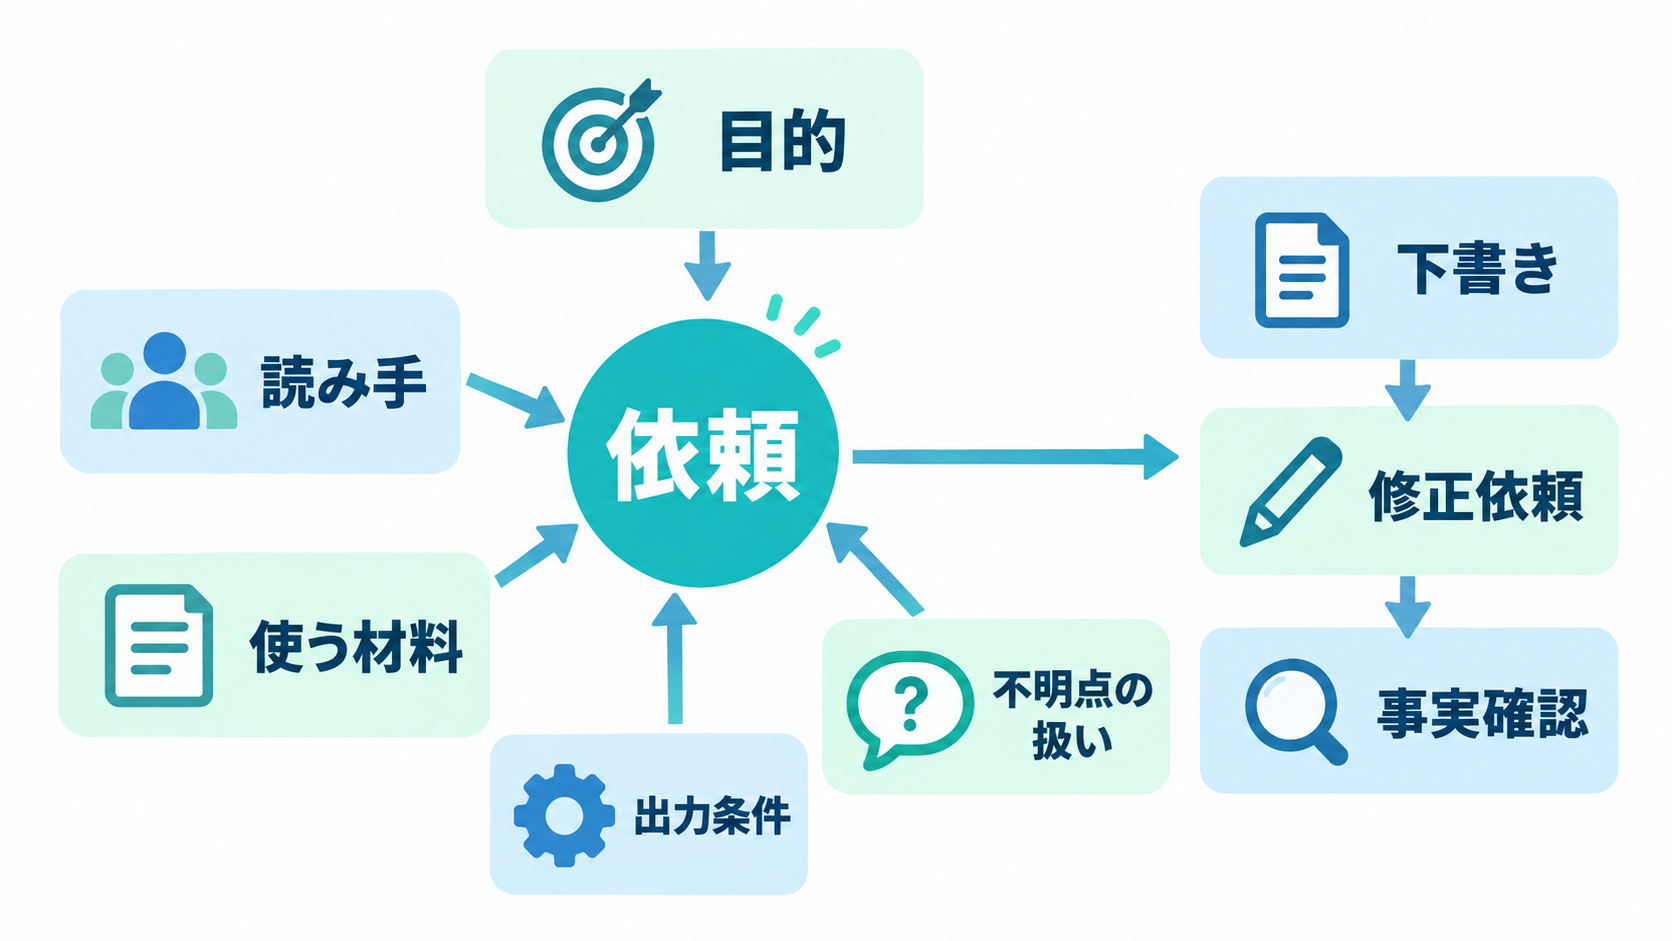
良いプロンプトは「魔法の言葉」ではなく依頼の設計
LLMへ渡す入力や指示は、一般にプロンプトと呼ばれます。難しい専門用語を並べなければ動かないものではありません。人へ仕事を頼むときと同じように、目的、前提、材料、希望する形を伝えると、意図に沿う回答を得やすくなります。ただし、丁寧なプロンプトを書けば事実誤認がなくなる、という意味ではありません。プロンプトは依頼を明確にする手段であり、回答の正しさを保証する仕組みではないからです。
たとえば、「案内文を書いて」だけでは、相手、用件、長さ、必要事項が分かりません。次の入力例は、架空の社内勉強会を想定した提案です。
社内の初心者向け勉強会の案内文を作ってください。
対象はAIを初めて使う社員です。
日時は11月10日14時、場所は第2会議室です。
参加を強制する表現は避け、200字程度にしてください。
不明な情報は補わず、確認事項として分けてください。
この例では、誰向けか、何を作るか、使ってよい事実、文章の条件、情報不足への対応を分けています。最初から完璧な文章を狙う必要はありません。「少し柔らかくしてください」「日時を目立たせてください」「元の事実は変えないでください」と会話を重ねる方法もあります。Googleの用語集が説明するように、チャットでは以前のやり取りが後続の文脈になります(出典: Google for Developers)。ただし、会話が長くなったときに必要事項が確実に維持されるとは決めつけず、重要な条件は再掲するとよいでしょう。
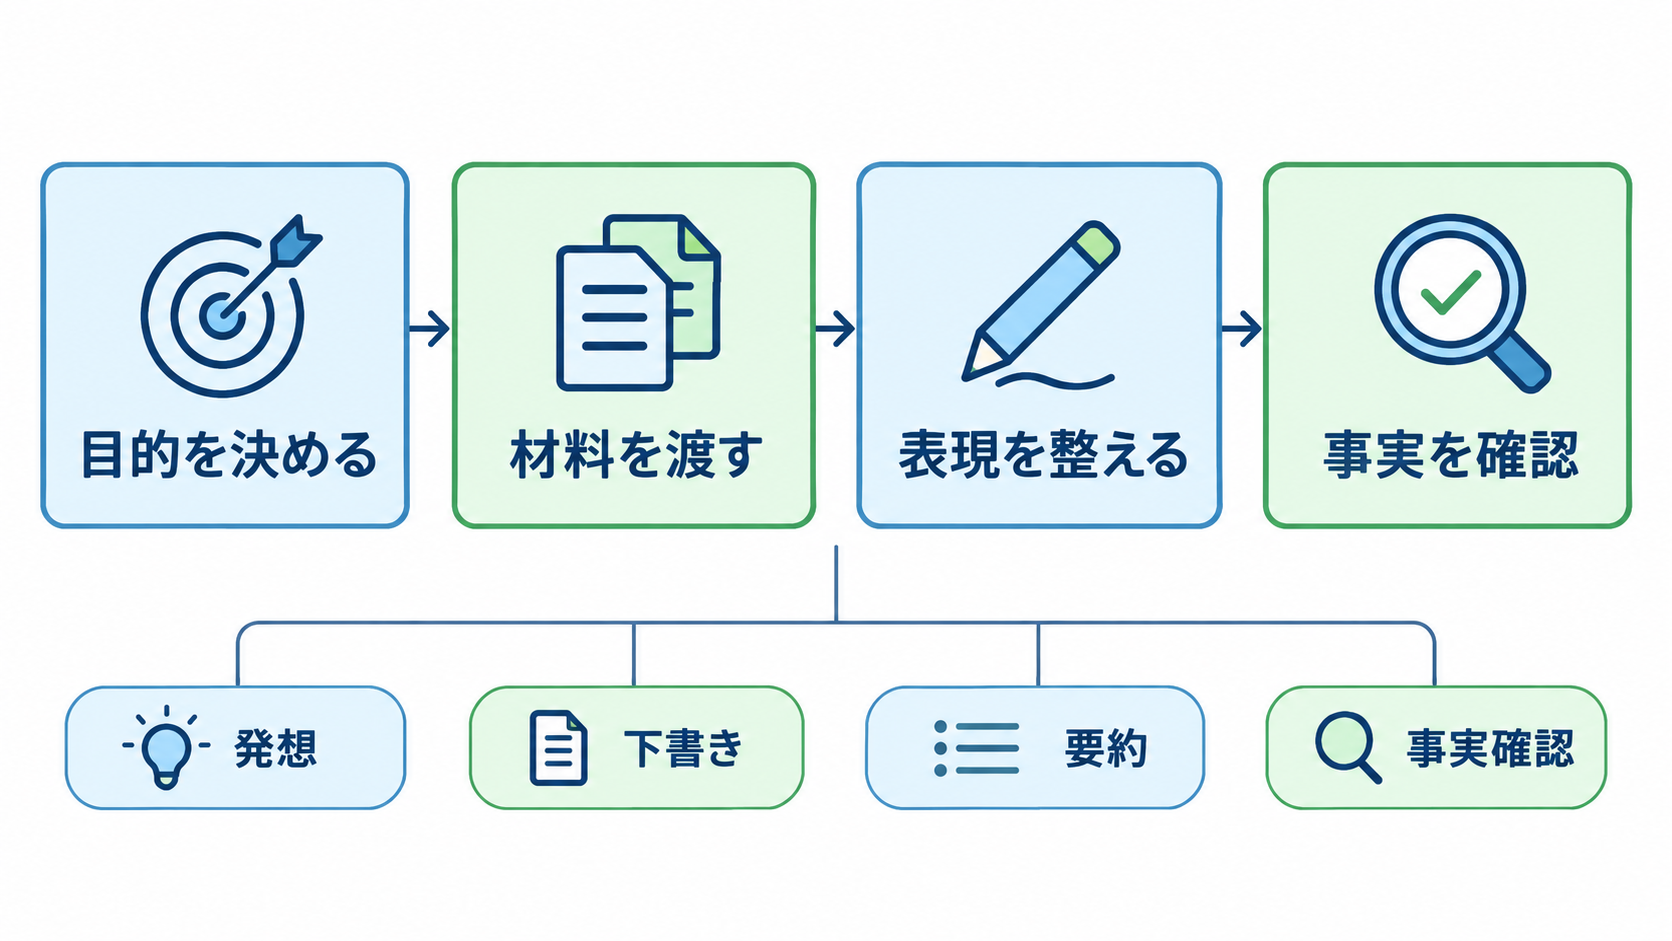
回答を受け取った後は、目的への適合と事実の確認を分けて見ます。読み手に合う表現か、指定した長さか、不足項目が明示されているかは出力から確認できます。日時や規程などは元資料と照合します。プロンプトを書く技術よりも、「何を任せ、何を人が確認するか」を決めることのほうが、初心者には実用的な出発点になります。
明日から変えられるLLMの見方
LLMを使う前に、複雑な数式やプログラミングを覚える必要はありません。最初の一歩は、チャット画面、文章を生成するモデル、事実を確認する情報源を頭の中で分けることです。「この回答は、どの仕組みから出てきたのか」「外部資料を検索した結果なのか」「学習済みのパターンから生成した文章なのか」と考えるだけでも、出力との付き合い方が変わります。
明日、文章作成を試すなら、機密情報や個人情報を入力してよいかという利用環境のルールを確認したうえで、公開可能な短い題材から始める方法があります。目的と材料を示して下書きを依頼し、返ってきた文章を「表現」と「事実」に分けて読みます。表現は自分の意図に合わせて直し、事実は信頼できる元資料へ戻って確かめます。これは、特定製品の機能や契約を前提にしない基本的な進め方です。
判断に迷ったときは、四つの問いが役立ちます。「これは文章の案が欲しい仕事ですか」「正解や最新情報が必要ですか」「確認に使える元資料はありますか」「最終判断を誰が行いますか」という問いです。案を広げる仕事なら生成を活用しやすく、正確さが中心なら確認の比重を高めます。外部サービスで実際の操作まで行うAIエージェントは、文章を返すLLMとは役割が異なるため、権限や実行結果の確認も必要になります。Googleの用語集では、エージェントを利用者の代わりに行動を計画・実行するソフトウェアと定義しています(出典: Google for Developers)。
LLMを「何でも答える頭脳」と捉えるより、「言葉のパターンを使って文章を組み立てるモデル」と捉えるほうが、任せ方と確認方法を決めやすくなります。次にチャットを開いたら、質問を一つ増やす前に、欲しいのが発想、下書き、要約、事実確認のどれなのかを一言で決めてみてください。その区別が、LLMを過信せず、必要以上に遠ざけもしない使い方につながります。
参考情報
- What Is Artificial Intelligence (AI)?(IBM、2024年8月9日公開、2026年10月2日更新、資料取得2026年10月31日)
- AI vs. Machine Learning: How Do They Differ?(Google Cloud、資料取得2026年10月31日)
- Machine Learning Glossary: Generative AI(Google for Developers、資料取得2026年10月31日)