

2026/11/20
AIニュース
AIエージェントの計算基盤は「借りる」から「持つ」へ――Oxideが語るオンプレミス回帰の条件
この記事の要点
AIエージェントの普及に伴い、計算資源を自社で所有する選択が再び問われています。OxideのCTOは、経済性やデータ管理、処理の分離を背景にオンプレミスの意義を説明しています。日本企業が判断する際も、業務ごとの計算量とデータの流れ、運用負担を合わせて比較する必要があります。
目次
AIエージェントが問い直す、計算資源を所有する理由
AIエージェントを業務に組み込むとき、モデルの性能だけでは決められないことがあります。処理をどこで動かし、業務データをどこまで外に出し、その計算資源にどう費用を支払うかという問題です。外部クラウドを使うのか、自社で設備を保有するのかという従来の選択が、生成AIの運用設計でも問われています。
企業向けのラック型コンピューター基盤を手がけるOxide Computerの共同創業者兼CTO、Bryan Cantrill氏は、クラウドの利点を認めながらも、利用規模が一定水準に達するとコンピューターを所有したくなると説明しています。同氏が重視するのは、クラウドの使い勝手と、設備を借りるという契約形態を切り離して考える視点です。必要な資源を柔軟に割り当てる仕組みは、自社のデータセンターでも求められます。
Cantrill氏は、計算科学や高性能計算を扱う国際会議SC26における、テックメディアSiliconANGLE傘下の映像配信メディアtheCUBEのインタビューで、この考えを示しました。SiliconANGLEによると、Oxideはラックの生産拡大に向け、2026年10月に4億4,500万ドルを調達しています。自社設備でクラウド型の運用を実現したい企業の需要を、同社は事業機会として捉えています。
ただし、これは企業向け基盤を販売する立場からの見解でもあります。あらゆる企業で所有が有利になると受け取るべきではありません。今回の論点は、AIエージェントによって処理量やデータの扱いが変わるなら、以前に決めたクラウド利用方針も、業務単位で見直す余地があるということです。
「モデルプレーン」が結び付ける実行場所とデータ管理
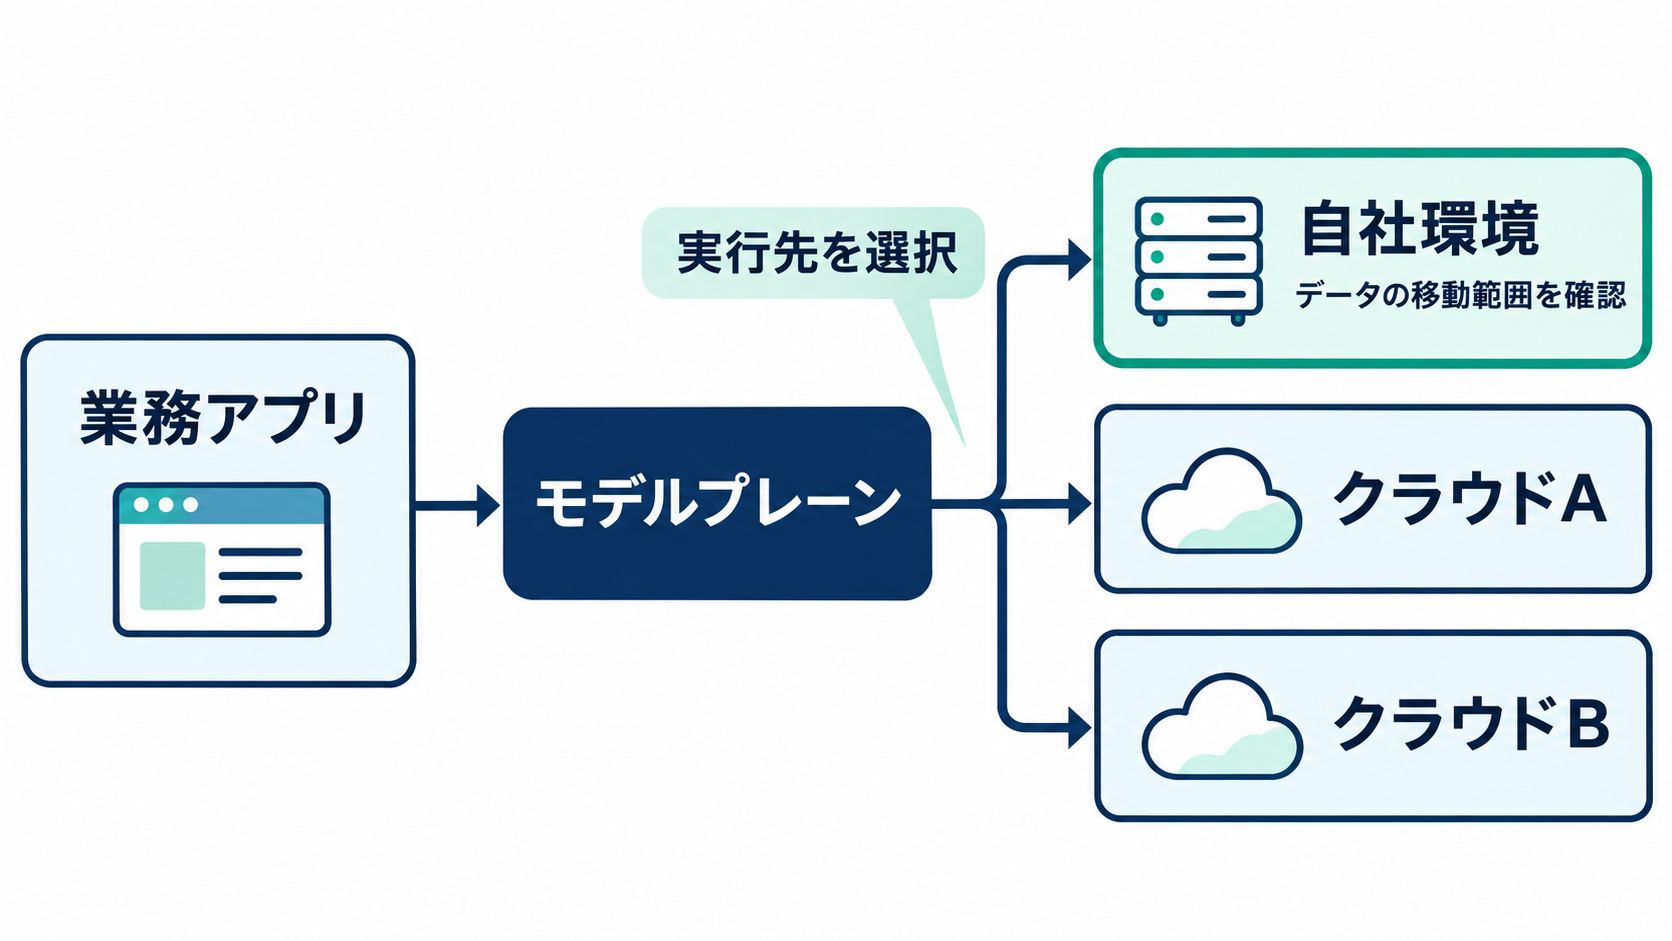
議論の中心にあるのが、AIモデルをどこで実行するかを決める「モデルプレーン」です。業務アプリケーションからモデルを呼び出す際、どの実行基盤へ処理を送るかを扱う層と考えると理解しやすいでしょう。SiliconANGLEは、複数のクラウドにまたがって推論処理を振り分ける取り組みとして、Upboundのオープンソースプロジェクト「Modelplane」を挙げています。
推論とは、学習済みのモデルに入力を渡し、回答や予測を得る処理です。企業がAIを日々の業務で利用する際には、この推論を継続的に実行します。実行先を選ぶことは、処理能力や利用料金を選ぶだけではありません。入力する文書、顧客情報、業務上の指示などを、どの環境へ渡すかという判断にもつながります。
Cantrill氏は、企業には重みが公開された「オープンウェイトモデル」を求める動きがあると述べています。モデルの重みとは、学習によって調整された内部の数値情報です。利用条件や必要な設備を満たせば、企業が管理する環境でモデルを動かす選択肢につながります。ただし、重みの公開は、学習データや開発工程のすべての公開を意味するわけではなく、商用利用などの条件も個別に確認する必要があります。
ここで経営上の意味を持つのが、モデルの配置とデータ管理を同時に設計できる点です。例えば、外部への送信に制約がある業務では、モデルの選定時から実行場所を検討する必要があるでしょう。自社内で動かすモデルでも、外部サービスを呼び出す構成ならデータが外に出る可能性は残ります。確認すべき対象はモデルの所在地に加え、業務全体のデータの流れです。
費用を左右するのは、モデルの推論だけではない計算量
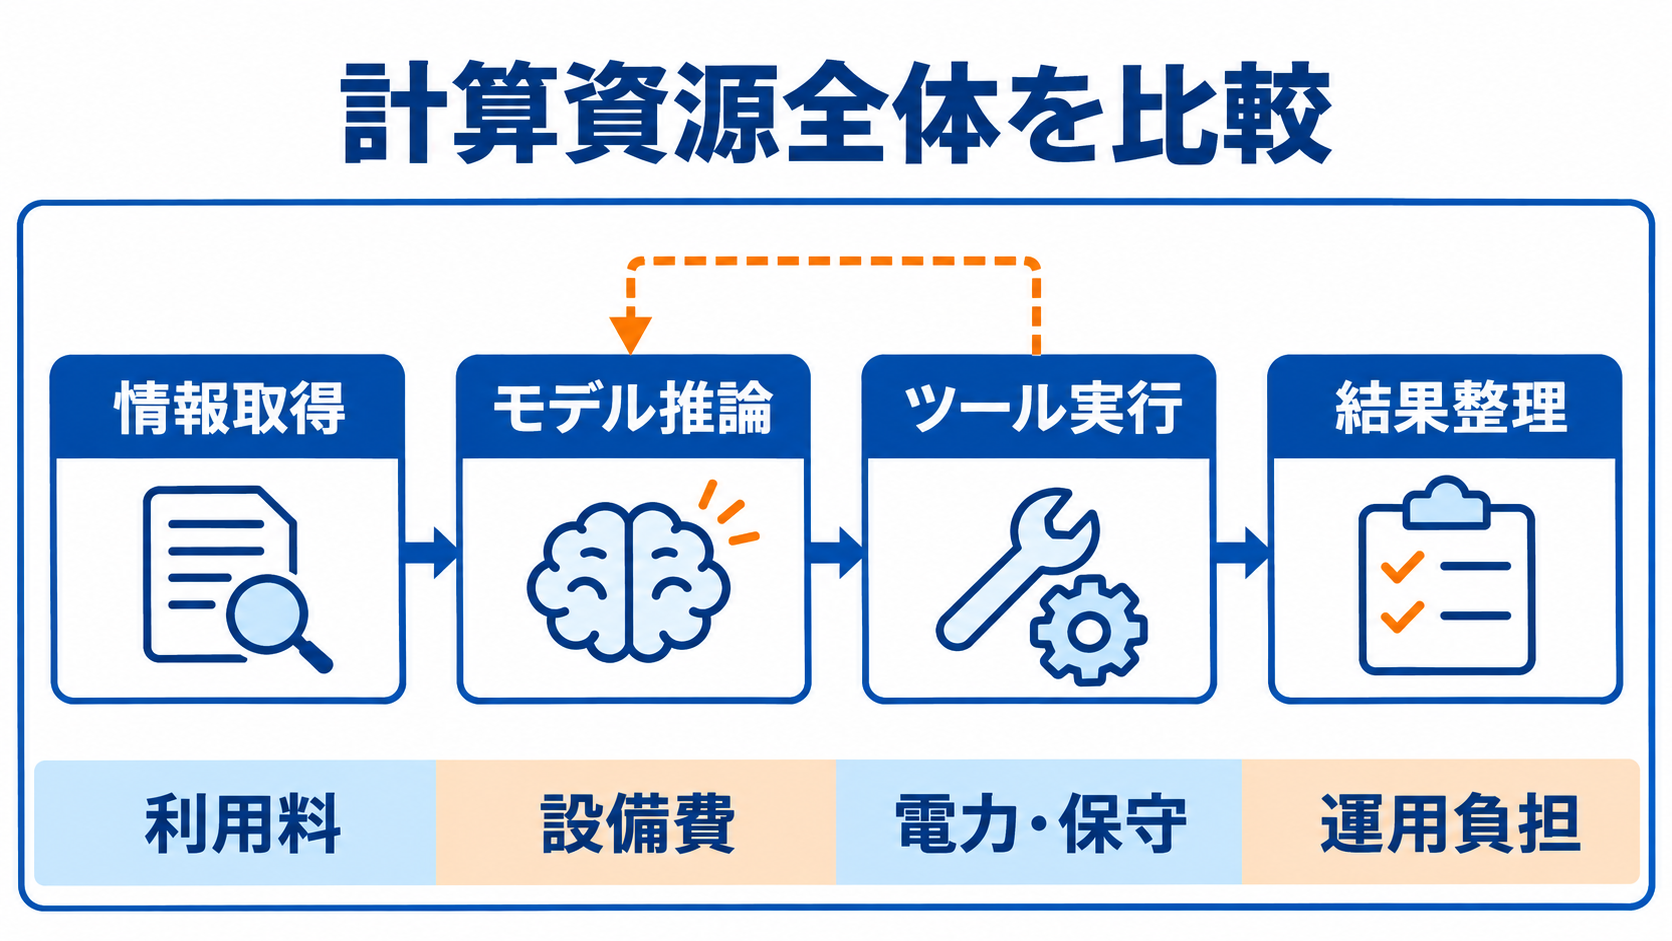
Cantrill氏は、AIエージェントによる処理が計算需要を押し上げており、その多くにはCPUを中心とする処理が含まれると説明しています。生成AIの基盤というとGPUに目が向きがちですが、企業の業務では、モデルが回答を生成する前後にも処理が発生します。この周辺まで含めて見ることが、設備を借りるか所有するかの比較には欠かせません。
一般に、AIエージェントは目的に応じて複数の処理を組み合わせます。情報を取得し、外部の機能を呼び出し、結果を整えてから、必要に応じてモデルへ再び問い合わせます。こうした構成では、モデルの推論に使う計算資源に加え、データ処理や処理手順の制御なども運用対象になります。ただし、CPUとGPUのどちらに負荷が集中するかは、実装や利用するモデルによって異なります。
同氏は、処理を社内へ戻す最大の理由として経済性を挙げています。継続的に多くの資源を使う企業にとって、利用のたびに費用を払う方式と、設備を保有して使う方式の比較が重要になるという主張です。ただし、SiliconANGLEが紹介したインタビューには、所有へ切り替えるべき具体的な利用量や、費用削減率は示されていません。
自社で判断する際は、クラウドの請求額と機器の購入価格を並べるだけでは不十分です。設備の稼働率、電力や設置場所、保守、運用担当者の負担まで含めて比較する必要があります。需要の変動が大きければ、使わない時間の設備も費用になります。逆に、一定の処理が長時間続く業務では、所有を検討する材料が増えるでしょう。最初に把握したいのは、AI関連の支出のうち、何が継続的に資源を消費しているかという実態です。
社内設置でも必要になる、AIエージェント同士の分離
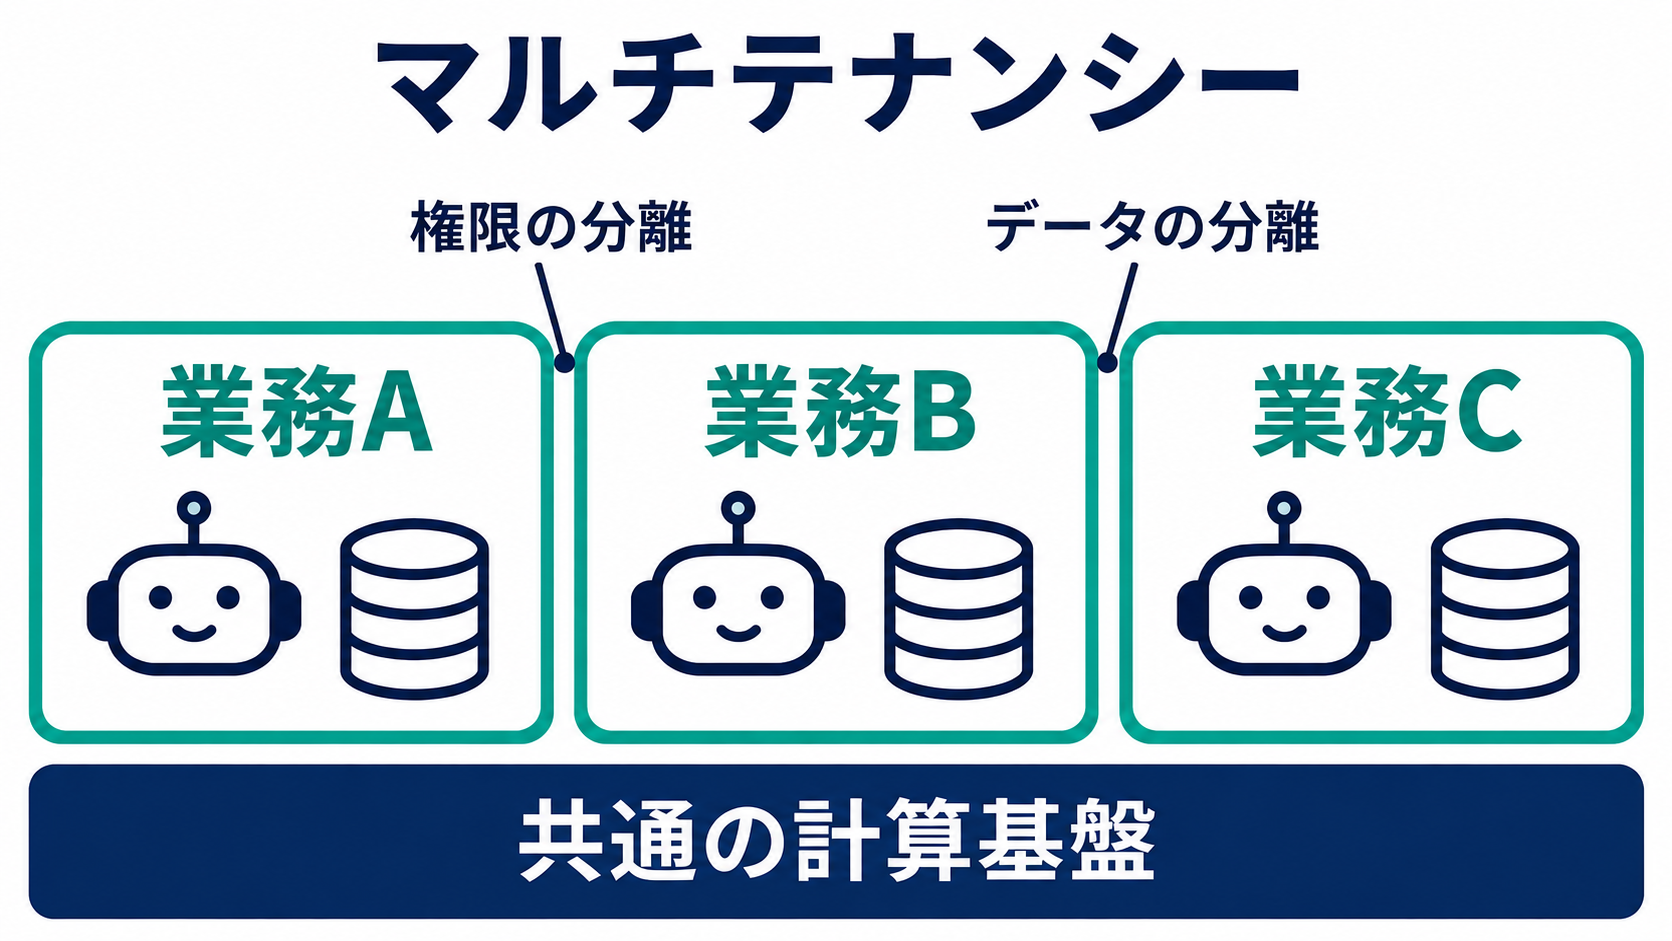
計算基盤を自社のデータセンターへ移せば、それだけで安全性が確保されるわけではありません。複数の業務や部門が同じ設備を使う場合には、互いのデータや処理へ不適切にアクセスできない仕組みが必要です。AIエージェントの配置を考える際も、社外との境界と、社内の共有基盤における境界の両方を設計する必要があります。
Cantrill氏が強調するのは「マルチテナンシー」です。これは、共通の計算資源を複数の利用主体が共有しながら、それぞれの処理環境を分離する仕組みを指します。ここでいう利用主体は、外部顧客に限りません。企業内の異なる業務システムや、扱う情報と権限が異なる処理も、分離の対象として考えられます。
同氏は、同じコンピューターやネットワークを共有する利用主体同士が、場合によっては敵対的であることも想定し、機密性を侵害しない設計が必要だと説明しています。AIエージェントについても、ある業務に与えた権限が、別の業務のデータへ及ばないようにする視点が欠かせません。基盤の共有による効率化と、アクセス範囲の制御は、同時に満たすべき要件です。
Oxideは攻撃対象となる箇所を減らすため、ラックの設計からUEFI BIOSとBMCを取り除いたとしています。UEFI BIOSは起動時の初期化などを担うファームウェア、BMCはサーバーの監視や遠隔管理に使う制御装置です。同社は、こうした設計と、当初から組み込んだマルチテナンシーを強みとして挙げています。ただし、特定の構成要素を取り除くことだけで、業務システム全体の安全性を判断することはできません。企業側には、基盤上で動くアプリケーションの権限や接続先も含めた確認が求められます。
既存の仮想化基盤とAIを、同じ設備で動かす発想
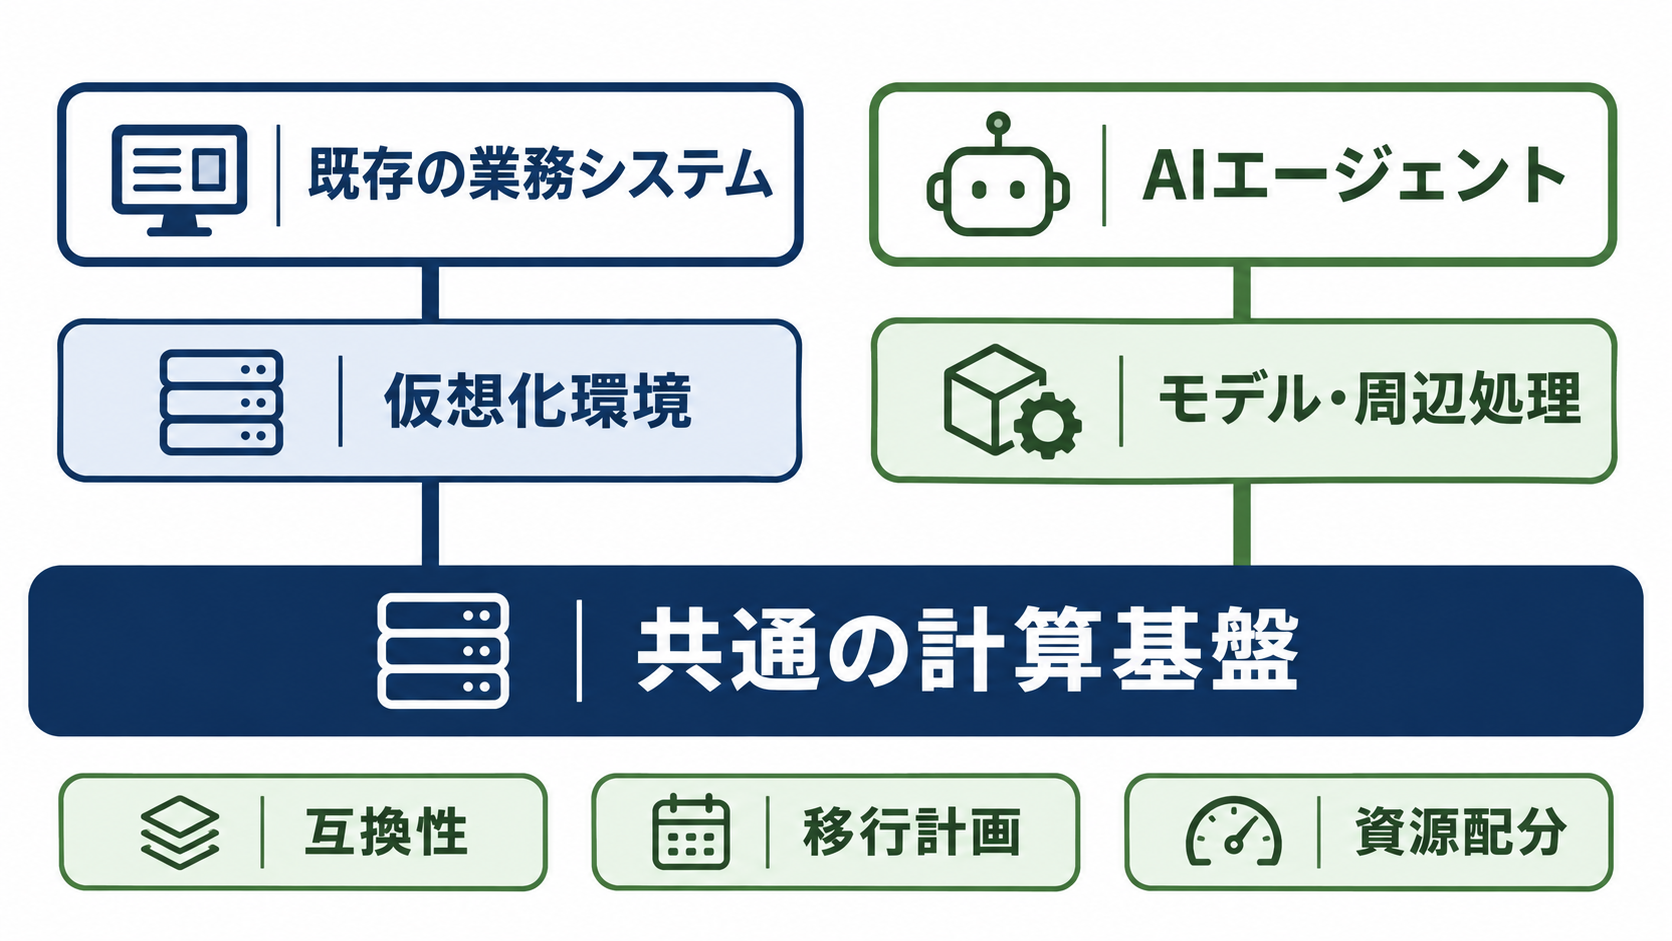
AI向けの設備投資は、既存システムの更新計画とも関係します。Cantrill氏は、OxideのラックがAIエージェント関連の処理に加え、従来型の仮想化された業務システムも実行できると説明しています。同氏が示すのは、既存のアプリケーションと新しいAIの処理を、汎用的な基盤で受け止めるという構想です。
仮想化は、物理的なサーバーの上に複数の実行環境を設け、業務システムを動かす技術です。企業にとっては、AIの導入を進めている間も、現在の業務を支えるシステムの運用が続きます。AIの新規投資だけを個別に考えると、既存設備の更新や運用体制との関係を見落とす可能性があります。
Cantrill氏は、Broadcom傘下のVMware事業における価格変更に不満を持つ顧客の仮想化処理も、同じラックで受け入れられると述べています。VMwareは企業の仮想化基盤で使われる製品群を提供する事業です。今回のインタビューでは、個別製品の価格条件や移行効果の数値までは示されていないため、具体的な費用メリットは各社の契約と構成に照らして判断する必要があります。
共通基盤を選ぶ利点としては、設備や運用手順をまとめられる可能性が考えられます。ただし、同じ設備で実行できることと、すべての業務を無理なく集約できることは別の判断です。既存アプリケーションの互換性、移行時に許容できる停止時間、AIの処理が増えた際の資源配分などを確認しなければなりません。日本企業がこの構想を検討するなら、AI導入の担当部門と既存基盤の運用部門が、更新時期と必要な性能を共有することが出発点になるでしょう。
日本企業が最初に整理したい、所有に向く業務の条件
今回の議論から読み取れるのは、AIエージェントの基盤選びでは、価格、データの管理、応答の速さ、運用の自由度をまとめて考える必要があるということです。Cantrill氏も、自社のデータセンターで柔軟な計算資源を使いたい理由として、経済性、安全性、遅延を挙げています。ただし、それぞれの条件がどの程度判断に影響するかは、業務によって変わります。
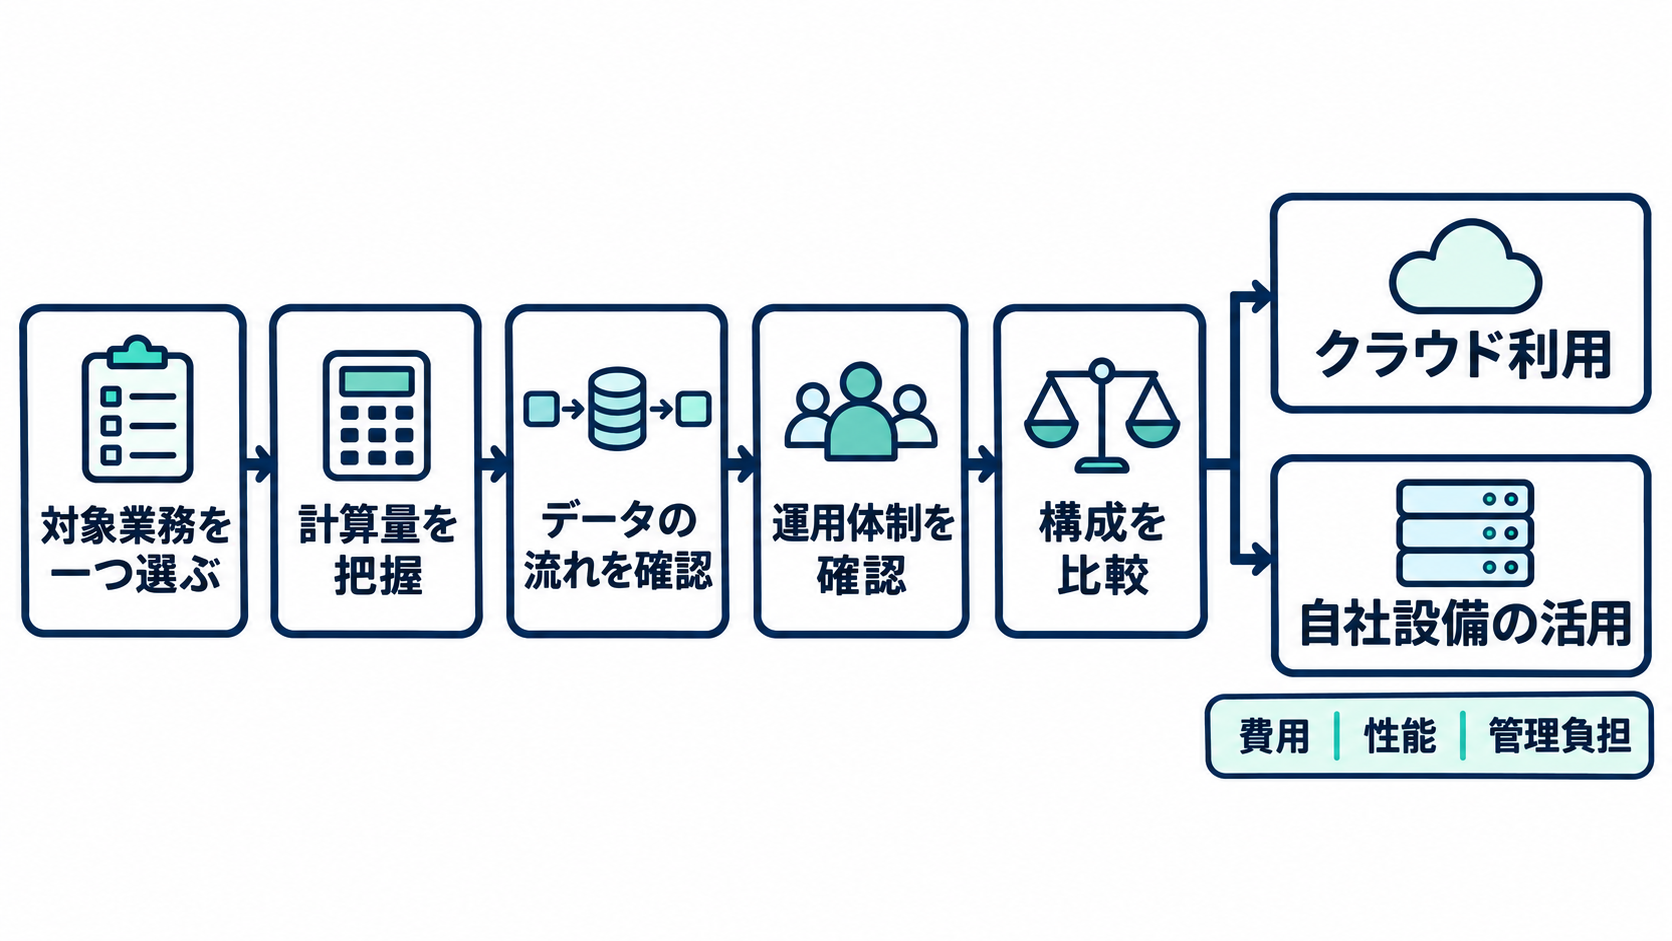
日本企業にとっても、会社全体の方針を一度に変更するより、具体的な業務から条件を整理する進め方が現実的でしょう。例えば、継続的に処理が走り、入力データの移動に制約があり、運用を担当できる体制もある業務なら、自社設備での実行を比較対象に入れやすくなります。反対に、処理量や利用方法がまだ定まっていない段階では、必要な設備規模を見積もること自体が難しいかもしれません。
検討を具体化するには、一つのAIエージェント業務について、扱うデータ、呼び出すモデル、接続するシステム、必要な権限を一枚に整理すると役立ちます。そのうえで、どの処理がどの設備で動き、どこで待ち時間や費用が発生しているかを確認します。モデルの実行場所だけを変えても、周辺の処理や外部接続が残るなら、期待した効果が得られない場合があるためです。
比較には、現在のクラウド利用を続ける構成と、必要な部分を自社設備へ移す構成を用意するとよいでしょう。費用と性能に加え、障害対応や更新作業を誰が担うかまで揃えることで、所有という選択を評価しやすくなります。次の一歩は、現在利用している、または導入予定のAI業務を一つ選び、その計算量とデータの流れを可視化することです。そこから、自社が所有する価値のある処理を具体的に見極められます。
参考情報
Own, don’t rent: Why agentic AI is pulling cloud computing back on-prem
対象のインタビュー企画にはNYSE Wiredがスポンサーとして参加しています。SiliconANGLEは、同社および他のスポンサーが編集内容を管理することはないと明記しています。