

2026/11/21
AIニュース
Thinking MachinesのInkling 2 Mini、約20GBで動くAIは企業の開発業務に使えるのでしょうか
この記事の要点
Thinking Machines LabのInkling 2 Miniは、中央の層を繰り返し使い、264億パラメータを約20GBに収めた公開重みモデルです。自己申告の評価ではコーディングに強みを示しますが、知識の想起や複雑な指示への追従には課題があります。企業導入では、32GB環境での実行条件と実業務の品質を分けて検証する必要があります。
目次
約20GBのモデルが狙う、手元で動く開発支援AI
社内のコードや文書を扱う生成AIを、手元のマシンで動かしたい。その際に壁になるのが、モデルを収めるメモリと、実用的な処理能力の両立です。Thinking Machines Labが公開した「Inkling 2 Mini」は、この課題に対して、モデルの一部を繰り返し使う設計で応えようとしています。中心となる論点は、モデルの大きさを抑えながら、開発作業をどこまで任せられるかという点です。
Inkling 2 Miniの総パラメータ数は264億ですが、保存されたモデルデータであるチェックポイントは約20GBです。Thinking Machinesは、32GB以上のメモリを搭載したAppleシリコンのMacや、NVIDIAのAI開発向けシステム「DGX Spark」1台などを実行環境として挙げています。クラウド上の大規模な計算基盤に限らず、比較的小さな環境での利用を想定したモデルです。
入力はテキストと画像に対応し、出力はテキストのみです。想定用途には、AIがツールを使いながら作業を進めるエージェント型のコーディング、ツール利用、文書処理が含まれています。画像を入力できることと、画像を生成できることは区別して理解する必要があるでしょう。
モデルの重みは、AIモデルの共有基盤であるHugging FaceでApache 2.0ライセンスの下に公開されています。重みを取得して自社環境で運用する選択肢に加え、Tinkerではホスト型の推論とファインチューニングも提供されます。ただし、公開時点の案内ではMiniのTinker料金は示されていません。導入の検討では、取得しやすさと、継続運用に必要な費用や管理作業を分けて考えることが大切です。
重みを増やさず、中央の層を3回使う仕組み
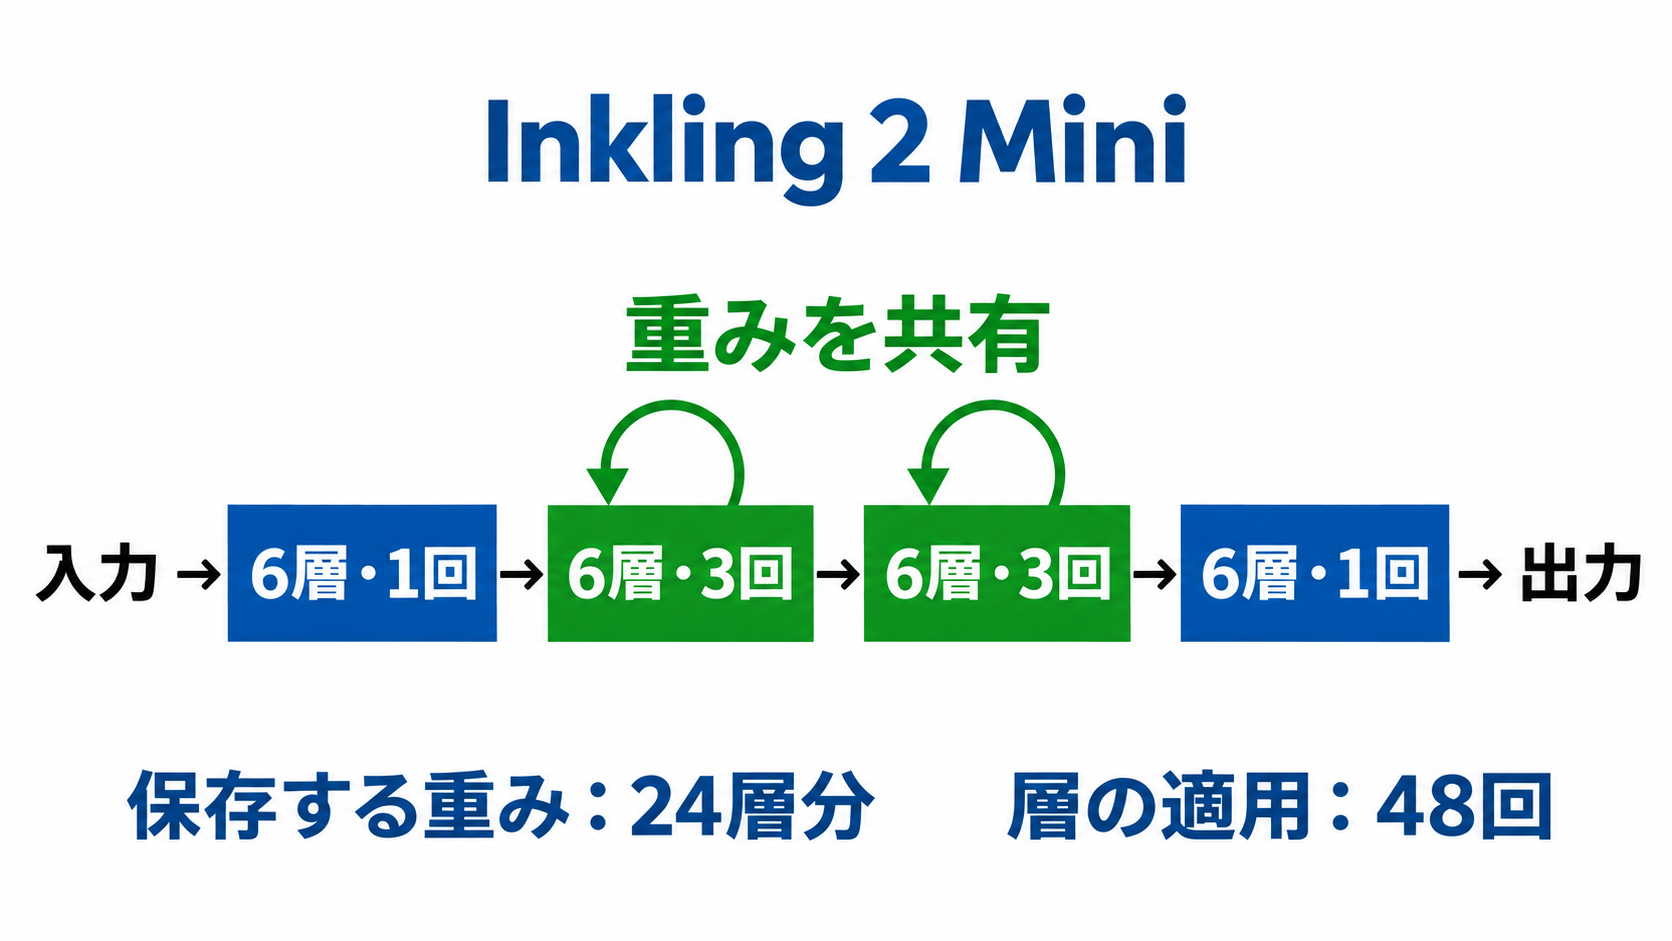
Inkling 2 Miniの特徴は、モデルの中央部分を繰り返し通過させる「ループ型Transformer」です。Transformerは、文章中の要素の関係を捉えながら情報を処理するニューラルネットワークの構造です。通常は層を増やすと保存する重みも増えますが、同じ重みを再利用すれば、保存容量を抑えつつ処理を重ねられます。
このモデルは24層を保持し、6層ずつの4ブロックに分けています。最初と最後のブロックはそれぞれ1回、中央の2ブロックはそれぞれ3回実行される構成です。その結果、保存する重みは24層分でも、1トークン当たりの層の適用回数は48回になります。単純に48層分の独立した重みを持つモデルと同じ構造になるわけではありません。
繰り返し処理では、2回目以降のパスに前のパスからの情報を渡します。Thinking Machinesは、その伝達にAttention Residualsと学習可能なゲートを使っています。また、モデルは処理の一部を複数の専門ネットワークに振り分けるMoE方式を採用しており、フィードフォワード層では128個の専門ネットワークのうち、トークンごとに8個を選択します。全体の重みを毎回すべて使う構造ではない点も、規模を見るうえで欠かせません。
同社は、中央部分をループさせる構成が28件の評価のうち27件で優位だったと報告しています。ここで注意したいのは、ループが計算を不要にする技術ではないことです。重みを再利用しても演算は発生するため、約20GBという保存容量だけから応答速度や消費電力は判断できません。設計の価値は、容量と計算量、得られる品質の組み合わせで評価する必要があります。
小型化を支える専門ネットワークの削減と追加学習
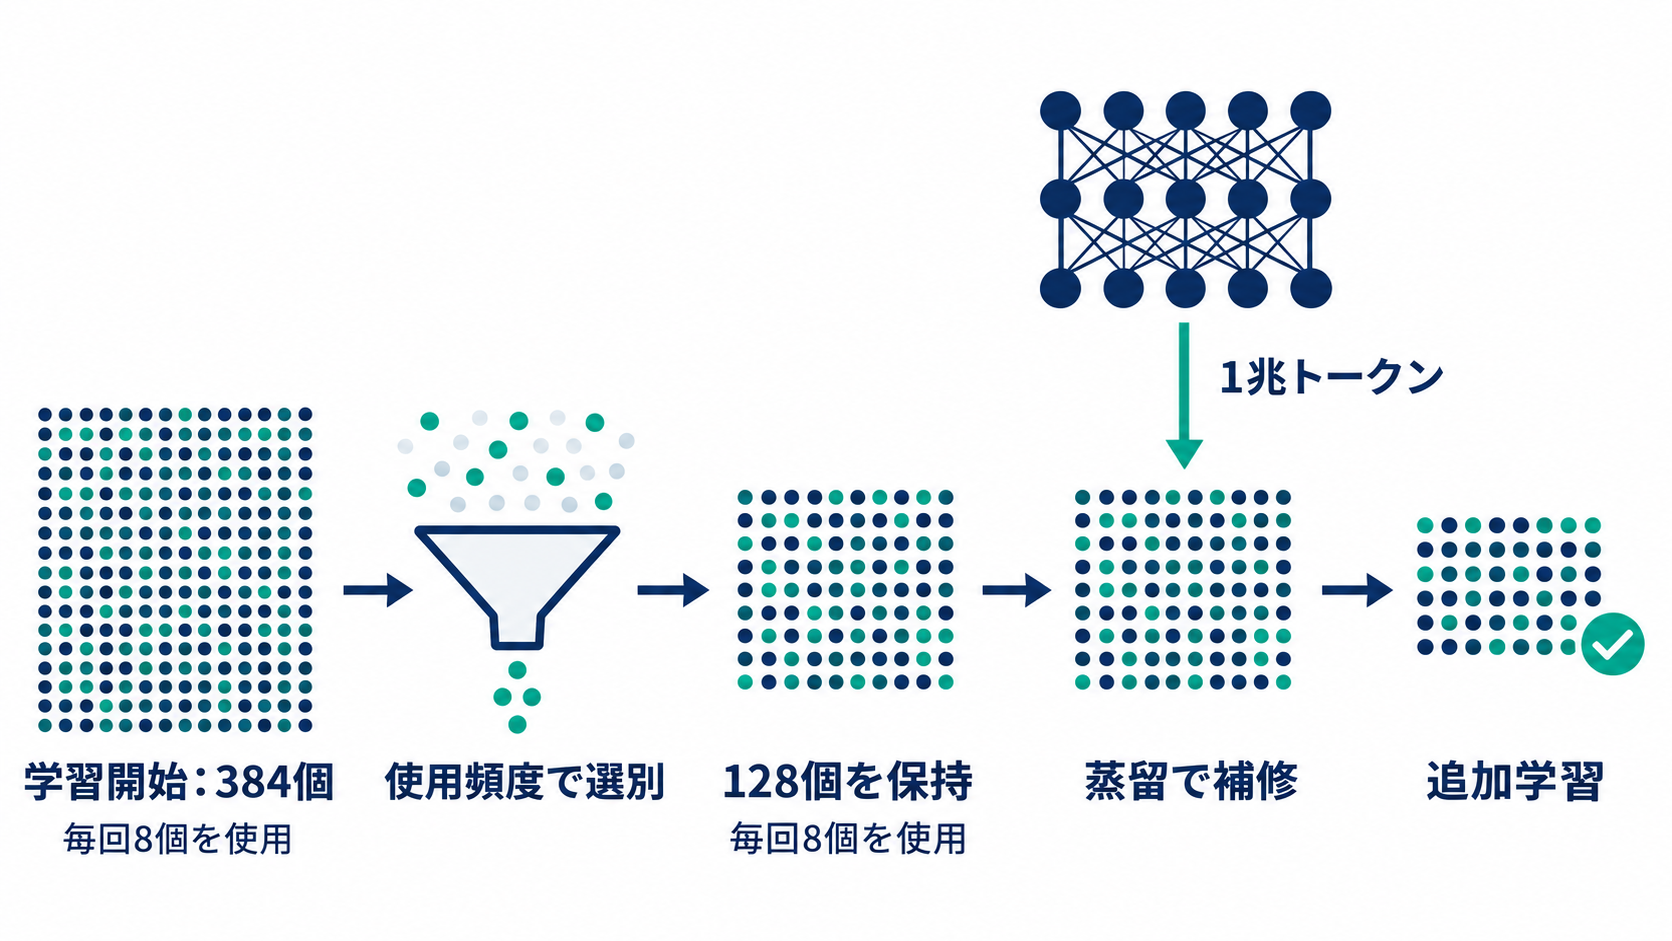
Inkling 2 Miniは、最初から現在の構成だけで学習したモデルではありません。Thinking Machinesは、学習開始時には各層に384個の専門ネットワークを用意し、トークンごとに8個を使う構成を採用しました。学習の途中で、そのうち3分の2を削減し、利用頻度の高い128個を残しています。使われ方を確認してから構造を絞り込む手順です。
専門ネットワークを削れば、保持する重みは減らせます。ただし、それまでの構成で獲得した能力に影響する可能性があるため、削減だけで工程が終わるわけではありません。同社は、大きな社内Inklingモデルから知識を移す蒸留を1兆トークン分実施し、削減後のモデルを補修したと説明しています。ここでいう蒸留とは、教師となるモデルの出力などを使い、別のモデルへ振る舞いを学習させる手法です。
その後の学習では、回答例を使って振る舞いを調整する教師ありファインチューニング、評価結果に基づいて改善する強化学習、モデル自身の生成に沿った蒸留が使われています。強化学習については、2.2兆トークン、2,000ステップという規模が報告されています。ただし、これらの工程のどれが個々の業務性能をどの程度押し上げたかまでは、提示された情報だけでは切り分けられません。
数値の表現形式も設計の一部です。専門ネットワークの層にはNVFP4、最後の4層にはMXFP8を使い、Thinking Machinesは学習から配備まで対応する形式を用いることで、量子化の変換に伴う損失を取り除くと説明しています。企業の担当者が押さえたいのは、小型化が単一の工夫によるものではないという点でしょう。層の再利用、専門ネットワークの削減、蒸留、数値形式を組み合わせた結果として、現在のモデルが成立しています。
コーディングの成績は有力でも、業務全体の合格点とは別です
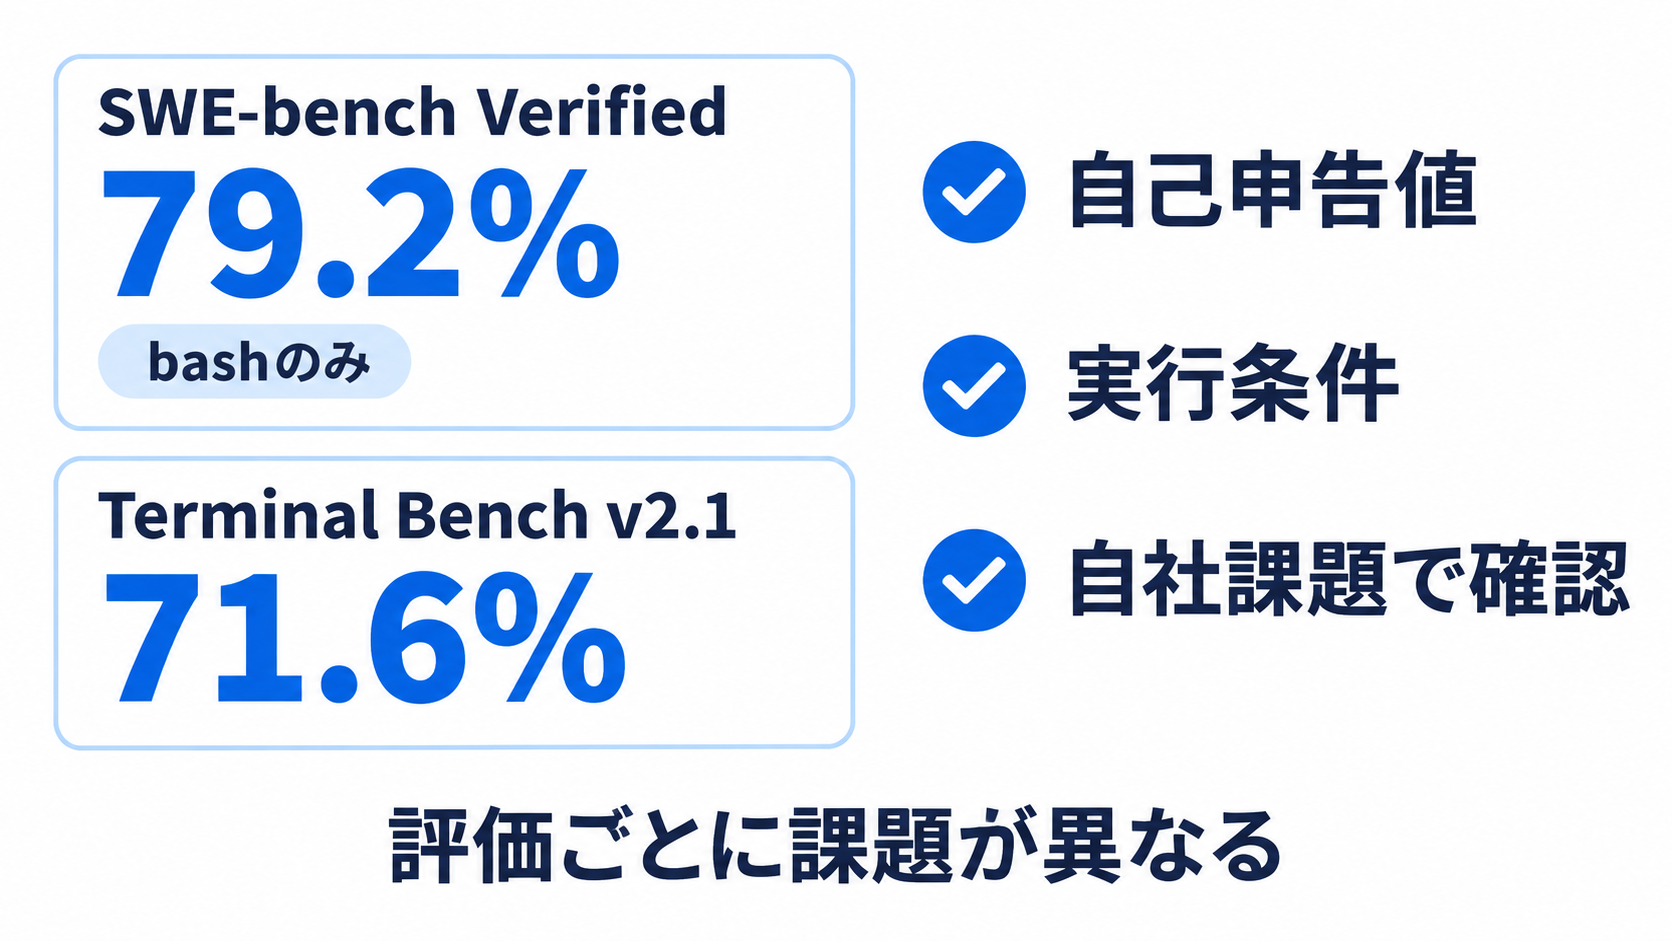
公開された評価では、Inkling 2 Miniの強みはコーディングに表れています。Thinking Machinesの自己申告によるスコアは、SWE-bench Verifiedで79.2%、SWE-bench Pro v2のHardで77.9%です。ソフトウェアの修正課題を扱う評価であり、単に短いコードを生成する能力だけを見るものではありません。特に前者には「bashのみ」という実行条件が付いているため、数値と条件をセットで読む必要があります。
DeepSWE v1.1では48.2%、ターミナル上の作業を評価するTerminal Bench v2.1では71.6%を記録しています。比較対象として挙げられたQwen3.8-27Bは、それぞれ42.2%と73.0%です。評価によって優劣が入れ替わるため、「開発用途なら常に上位」と一般化することはできません。
検索や文書処理にも評価結果があります。BrowseCompではコンテキスト圧縮を使う条件で79.0%、MCP Atlasでは82.7%、OmniDocBench v1.6では92.8%と報告されています。これらは検討対象となる用途を広げる材料ですが、異なるベンチマークの得点をそのまま横並びにして、文書処理がコーディングより得意と判断することはできないでしょう。課題も採点方法も異なるためです。
モデル間の比較にも同じ慎重さが必要です。提示された比較値は各社のモデルカードに基づき、実行の仕組みや設定がそろっていません。Thinking MachinesはDGX Spark上での電力効率も報告していますが、その値だけで自社の電気代や処理件数を見積もるのは早計です。企業が確認すべきなのは、自社のリポジトリや文書を使い、同じ条件で実行したときに、必要な正確さと処理時間を両立できるかという点です。
32GBで実行できることと、長文を快適に扱えることの違い
Thinking Machinesが挙げる実行環境は、DGX Spark 1台、32GB以上のメモリを備えるAppleシリコン環境、32GB以上のVRAMを持つその他のGPUです。チェックポイントはSafetensors形式で約20GBとされ、Unslothやllama.cppを通じた量子化GGUF形式も用意されています。SafetensorsやGGUFはモデルを保存・配布する形式であり、利用する実行ソフトに合わせて選ぶ必要があります。
対応する実行・配信基盤としては、Transformers、vLLM、SGLang、Ollama、NVIDIA Dynamo、TokenSpeedが挙げられています。すでに社内で使っている基盤に対応していれば、検証へ進みやすくなるでしょう。ただし、対応ソフトの一覧に名前があることだけで、すべての機能や設定が同じ条件で利用できると考えるべきではありません。
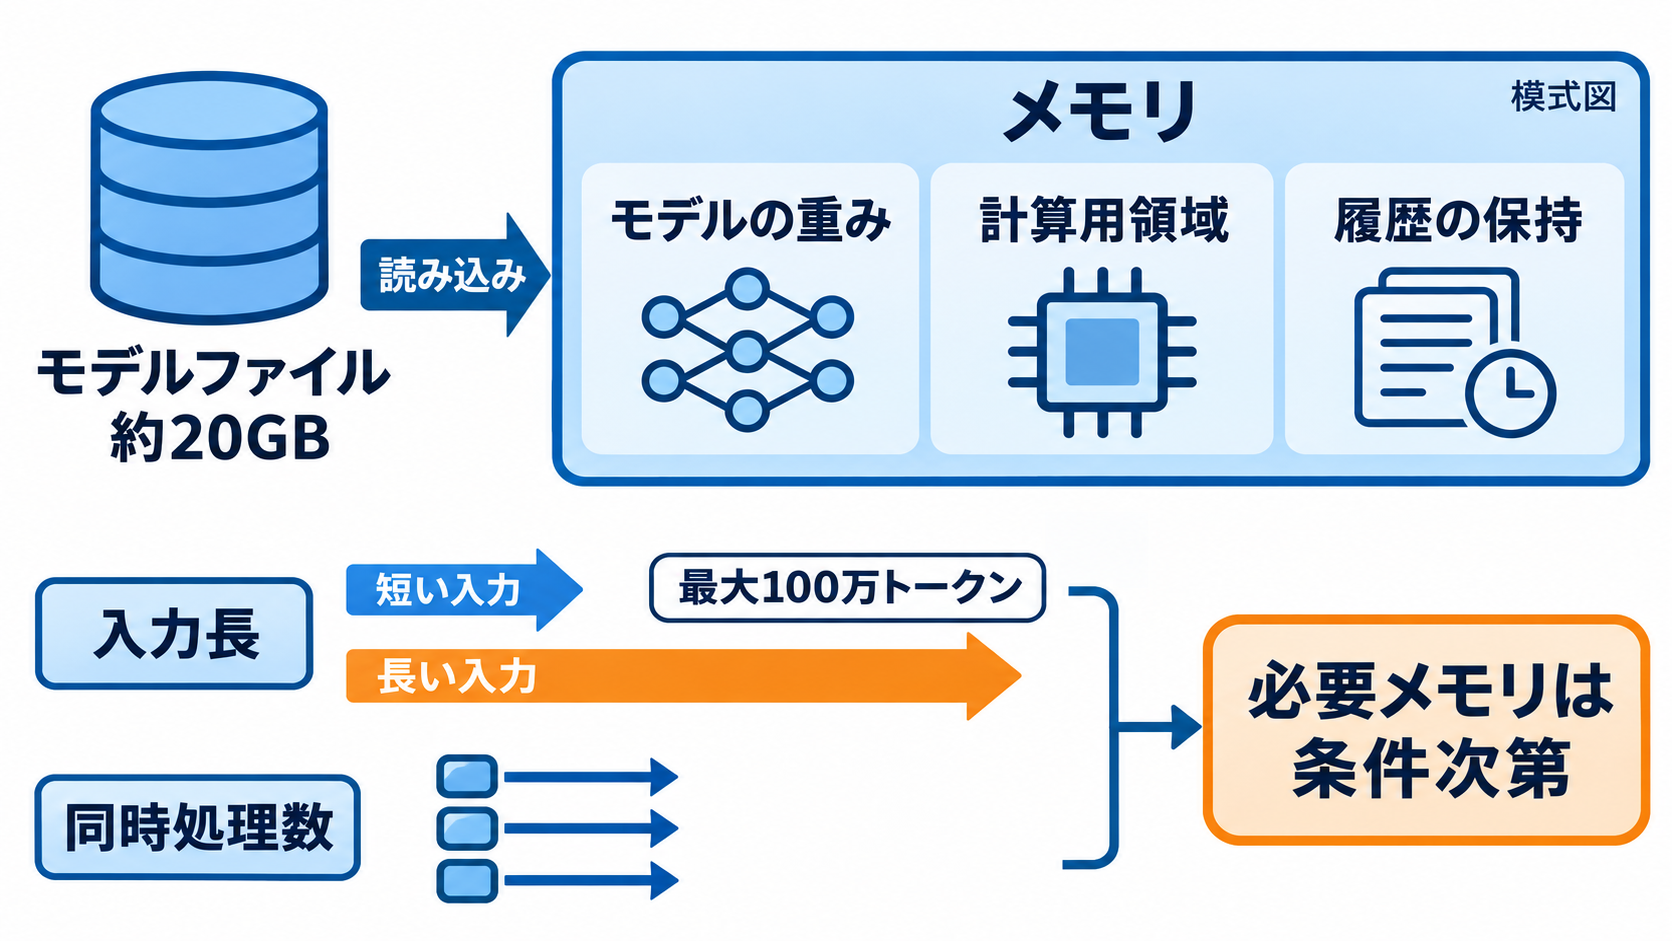
特に注意したいのが、最大100万トークンというコンテキスト長です。コンテキストとは、モデルが処理に利用できる入力や会話履歴などの範囲を指します。長いコードや大量の文書をまとめて渡せる余地はありますが、最大長に対応するという仕様は、32GB環境でその長さを快適に処理できる保証ではありません。
一般に、実行時にはモデルの重みに加え、計算用の領域や、過去のトークンに関する情報を保持するメモリが必要です。入力の長さや同時に処理する件数によって、必要な容量も変わります。約20GBのファイルがメモリに収まるという確認で検証を終えず、普段扱う入力長での余裕を測ることが欠かせません。短い修正依頼、長い仕様書、複数ファイルを含む依頼を分けて試せば、どの業務から導入できるかを判断しやすくなります。
日本企業の初期検証は、確認しやすいコード修正から
Inkling 2 Miniには、用途を選ぶうえで無視できない弱点も報告されています。MultiChallengeは50.0%、ComplexConstraints v1.1は33.4%で、複数ターンにまたがる指示への追従や、条件の多い依頼には課題が残ります。HLE-Diamondは15.2%、知識関連のAA-Omniscienceはマイナス8.6、非ハルシネーション率は63.4%とされています。これらもThinking Machinesの自己申告値です。
中央の層を繰り返す工夫が、知識の想起まで改善するわけではない点は、企業利用で特に意識したいところです。コード修正が得意でも、社内規程の正確な説明や、長い会話の途中で追加された条件の保持まで同じ水準で任せられるとは限りません。日本語の文書や社内固有の表現を扱う性能も、今回提示された数値だけでは判断できないでしょう。
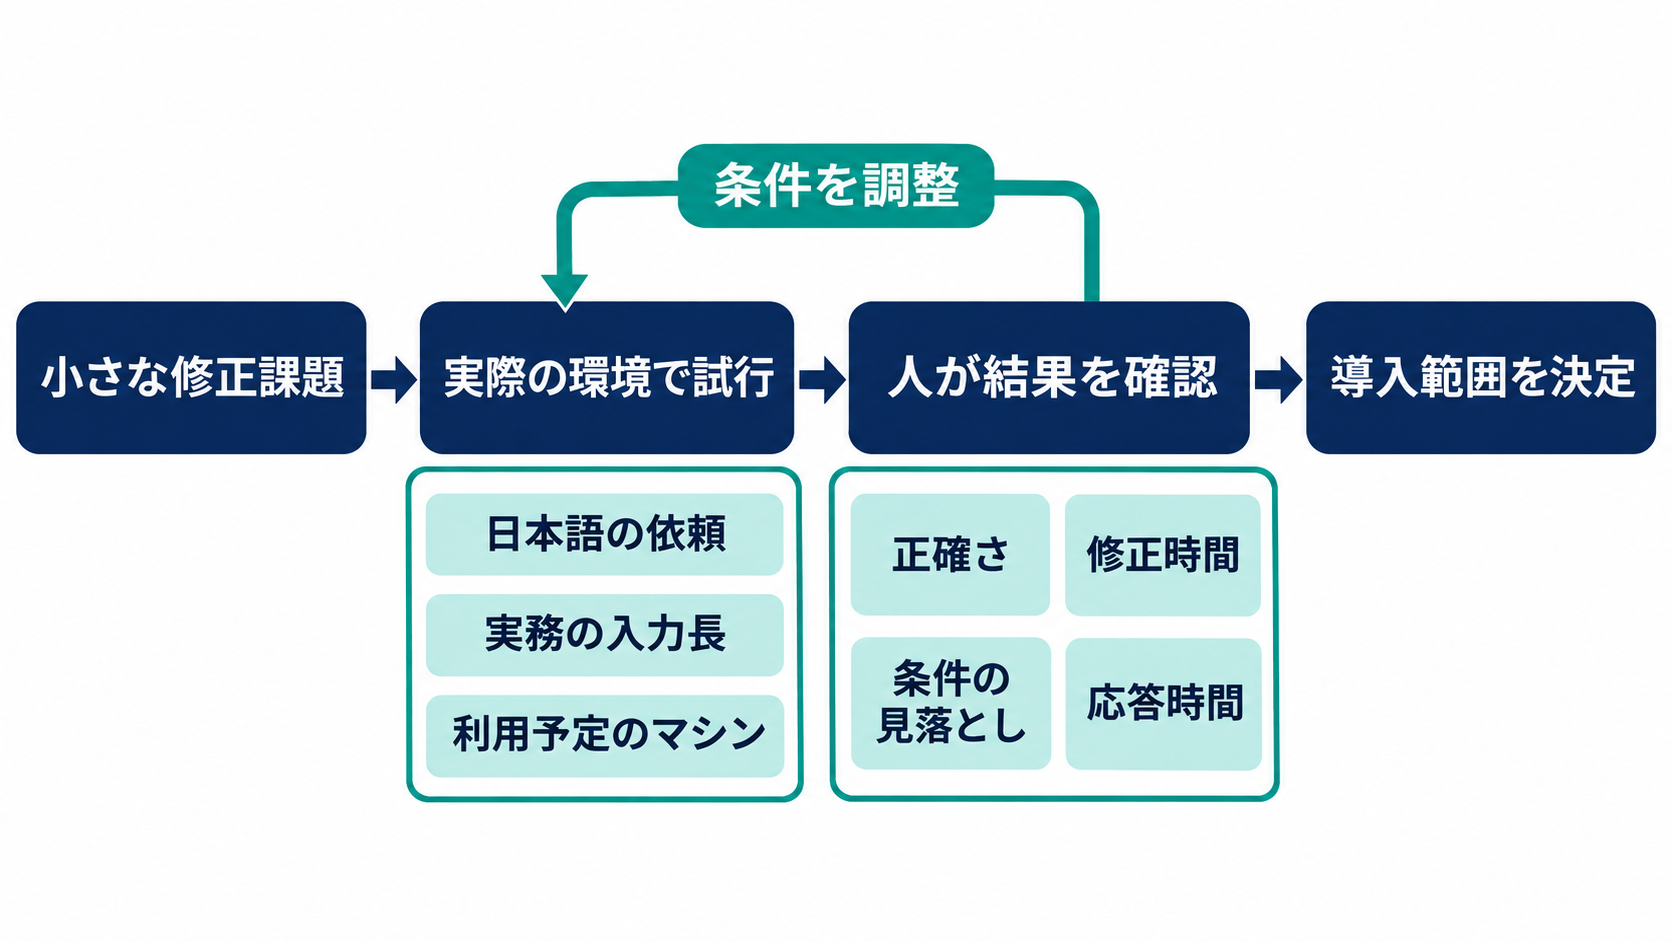
初期検証には、成果を確認しやすい小さなコード修正が候補になります。期待する挙動が明確で、テストや差分レビューによって結果を確かめられる課題なら、モデルの提案が役立ったかを評価しやすいためです。文書処理を試す場合も、回答と根拠箇所を人が照合できる資料から始める方法が考えられます。これは性能を保証する方法ではなく、失敗の種類を把握するための進め方です。
評価では、正答率だけでなく、修正にかかった人の時間、ツールの誤操作、条件の見落とし、応答待ちの時間も記録するとよいでしょう。ローカル実行を選ぶ場合は、モデルの配置先だけでなく、接続するツールやログにどの情報が残るかも確認が必要です。導入の第一歩としては、実際の業務から小規模な修正課題を選び、日本語の依頼、実データに近い入力長、利用予定のマシンという3つの条件をそろえて試すことを勧めます。その結果が、任せられる仕事の範囲を決める材料になります。