

2026/11/21
AIニュース
Basetenのbison-1とgroundhog-1、文章生成ではなく「判断の確率」で業務を支援
この記事の要点
Basetenは、文章を生成せず判断結果を確率で返すbison-1とgroundhog-1を公開しました。両モデルはGemma 4を基盤とし、128kトークンと画像入力に対応します。bison-1は公表された意思決定モデル指数で首位ですが、知識に依存する判断には弱点もあります。企業での選定には、日本語の業務データを使い、確率の信頼性と人の確認負担まで検証することが必要です。
目次
問い合わせを誰に回すか、生成AIの前段で判断するモデル
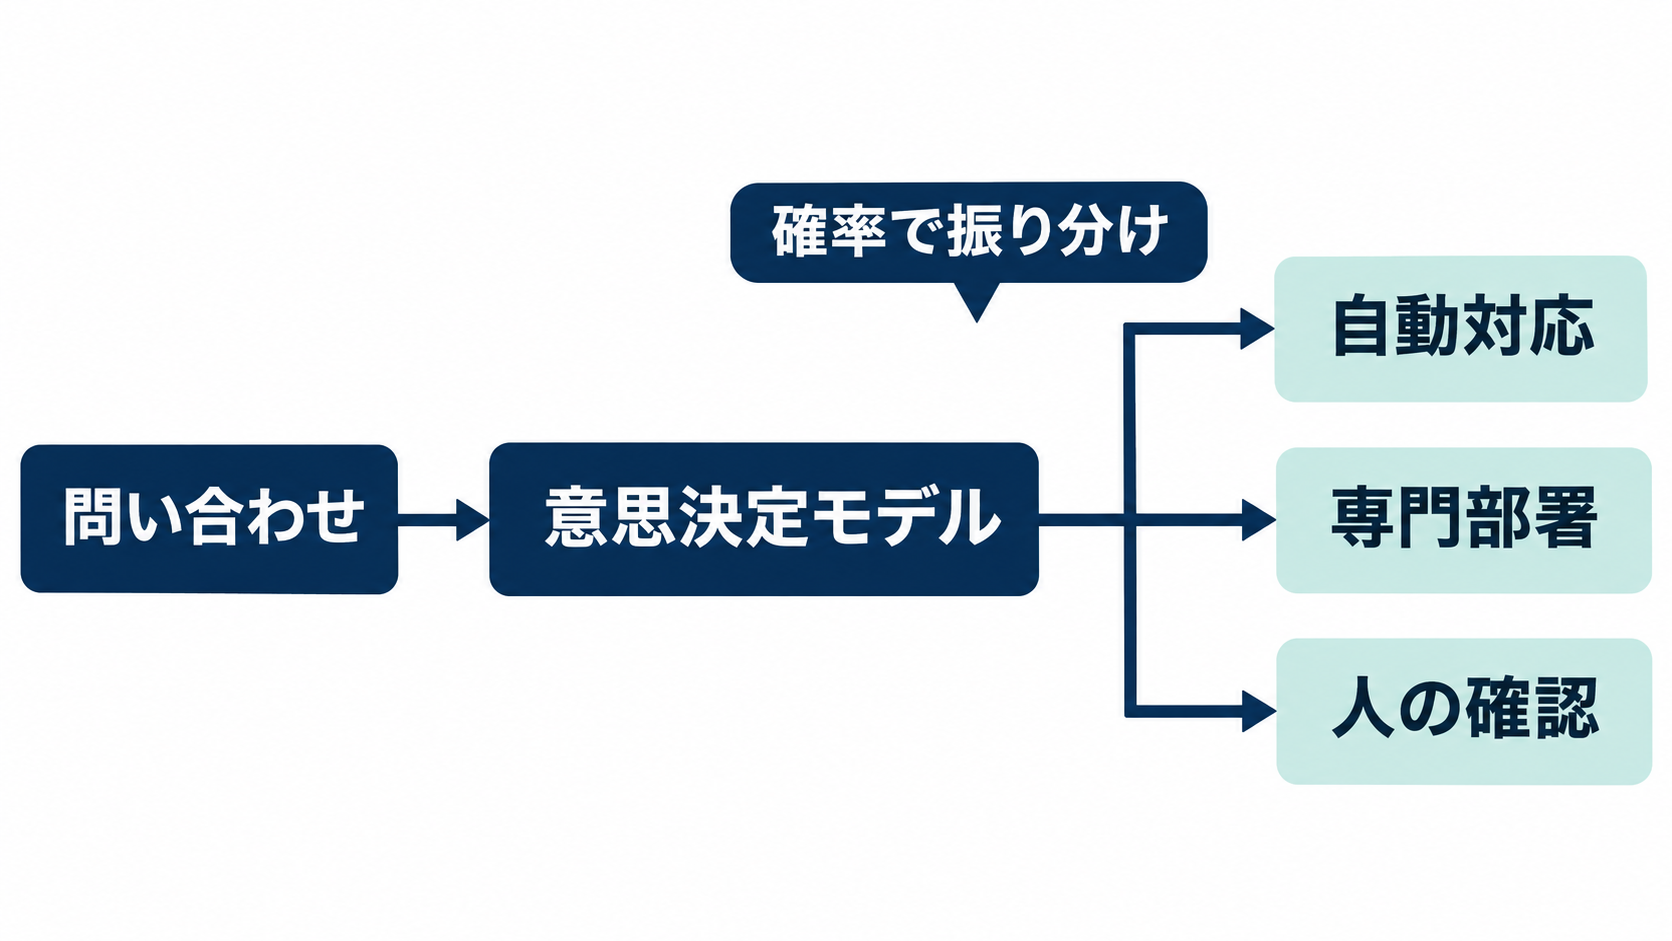
顧客から届いた問い合わせを担当部署に振り分ける際、必要なのは丁寧な回答文だけではありません。緊急対応が必要か、専門部署に回すべきか、自動処理を続けてよいかという判断が先にあります。Basetenが公開したbison-1とgroundhog-1は、こうした分岐を支える「意思決定モデル」です。自由な文章を生成する代わりに、肯定・否定や選択肢に対応する確率を返します。
AIモデルの配信基盤を手がけるBasetenは、2026年11月20日に両モデルの提供を発表しました。基盤にはGoogleのモデル系列であるGemma 4を採用しています。bison-1は310億パラメーターの密なモデルで、groundhog-1は総パラメーター数260億のMoEモデルです。MoEは複数の専門部分を使い分ける構造で、groundhog-1ではトークンごとに約40億パラメーターが稼働します。
両モデルはテキストと画像を受け付け、最大131,072トークンの入力を扱います。Basetenの従来のModel API提供モデルに比べ、コンテキスト長は8倍になりました。企業で注目したいのは、単に長い文章を読める点ではありません。判断基準となる規程と、判断対象の問い合わせや履歴を、一度の処理にまとめられる余地が広がる点です。Basetenの提供開始案内でも、分類、リクエストの振り分け、基準に沿った採点を用途として挙げています。
導入を検討する際の中心的な問いは、「どれだけ自然に話せるか」から変わります。「どの処理を自動化し、どの案件を人に渡すかを、信頼できる確率で決められるか」が評価の軸になるでしょう。
一つの状況に複数の質問を投げ、確率をまとめて受け取る仕組み
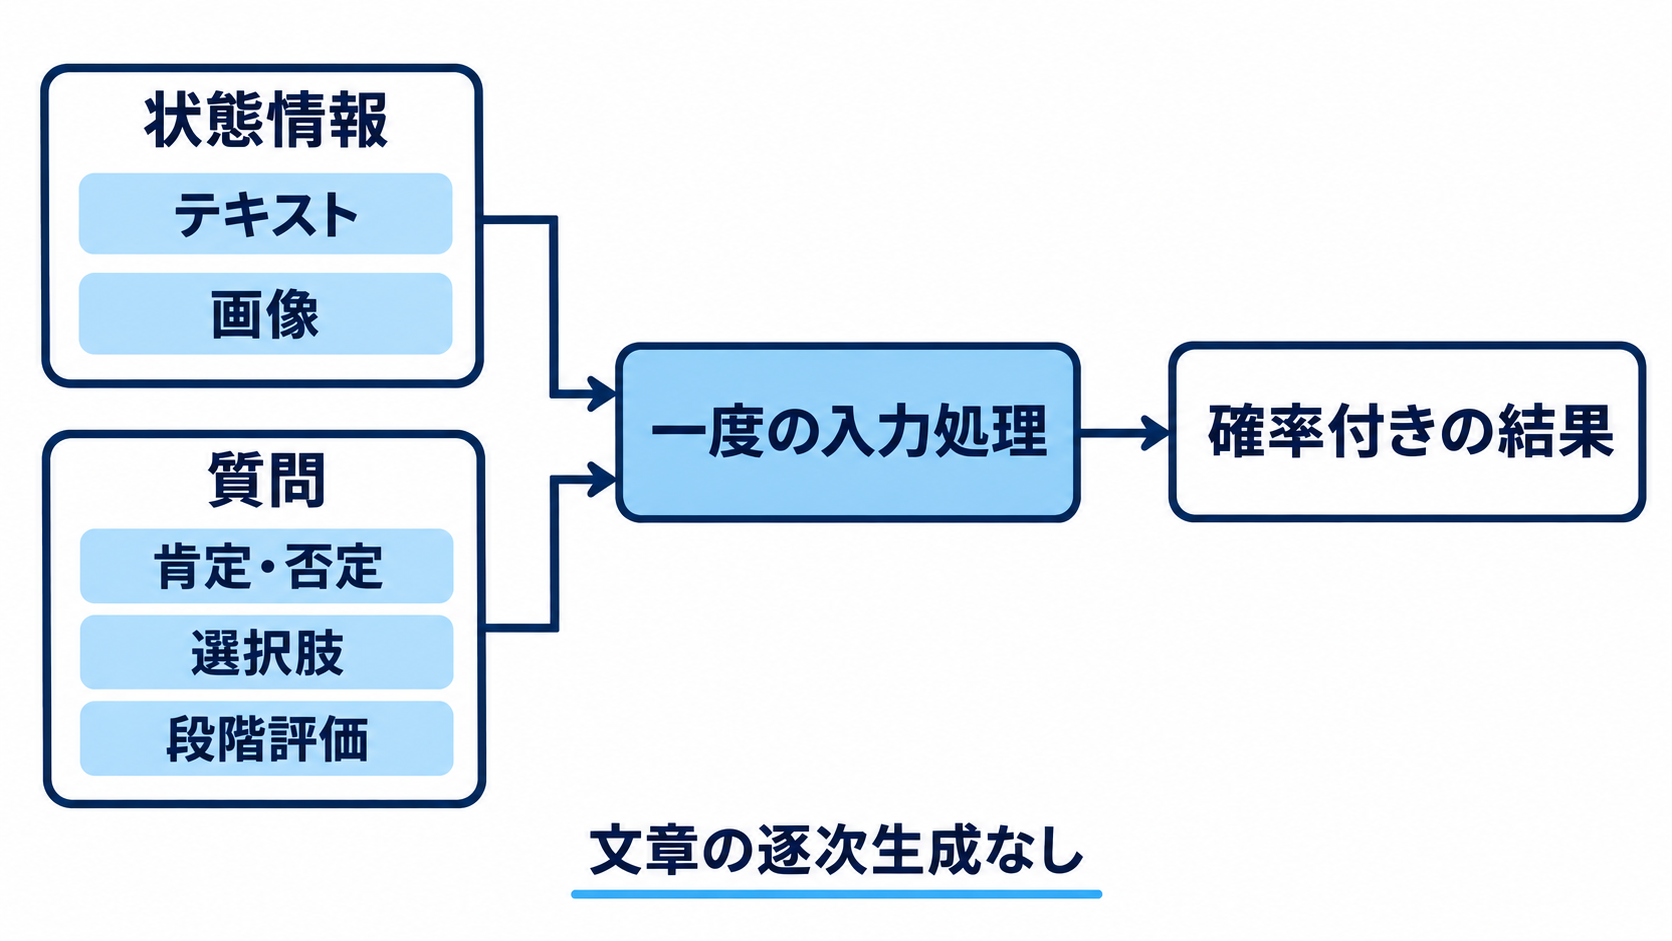
意思決定モデルへのリクエストには、判断対象となる一つの状態情報と、任意の数の質問を含めます。状態情報はテキストを基本とし、画像も追加できます。質問の形式は、肯定・否定を問う形式、名前を付けた選択肢から選ぶ形式、順序のある段階で評価する形式です。返り値は肯定の確率や、選択結果と各選択肢の確率などになります。
問い合わせ対応に置き換えると、顧客の文章や過去のやり取りを状態情報として渡し、「緊急性があるか」「担当部署はどこか」「優先度はどの段階か」を同時に尋ねる設計が考えられます。これは業務への応用例であり、特定の企業で実証された運用成果ではありません。質問を業務上の分岐に対応させることで、後続のシステムが結果を利用しやすくなります。
Basetenの説明によると、モデルは入力を読み込むプリフィルという処理を一度行い、すべての質問に回答します。通常の文章生成のように、出力トークンを順番に生成する仕組みではありません。ただし、出力トークンがないことは、計算処理や待ち時間がなくなることを意味しません。入力を読み取る処理は必要で、実際の応答時間は業務データで確かめる必要があります。
この構造は、文章を生成するAIと役割を分ける設計に向いています。たとえば、意思決定モデルが問い合わせの種類を判定し、その結果に応じて回答用のモデルや人の担当者へ処理を渡す構成です。Basetenは、問い合わせの振り分け、スパム検知、不適切な指示への対策、LLMの振り分けを用途に挙げています。長い説明文の中から判定結果を抜き出す処理を減らせる点は、システム連携上の利点と考えられます。
正解率だけでは測れない「確率の信頼性」
モデルが「対応が必要」と判定しても、その確信の強さが分からなければ、自動処理に進めてよいか判断しにくくなります。反対に、高い確率を返していても、その数字に見合う頻度で正解しなければ、運用上の基準には使えません。意思決定モデルでは、分類の正確さに加え、確率の校正が焦点になります。
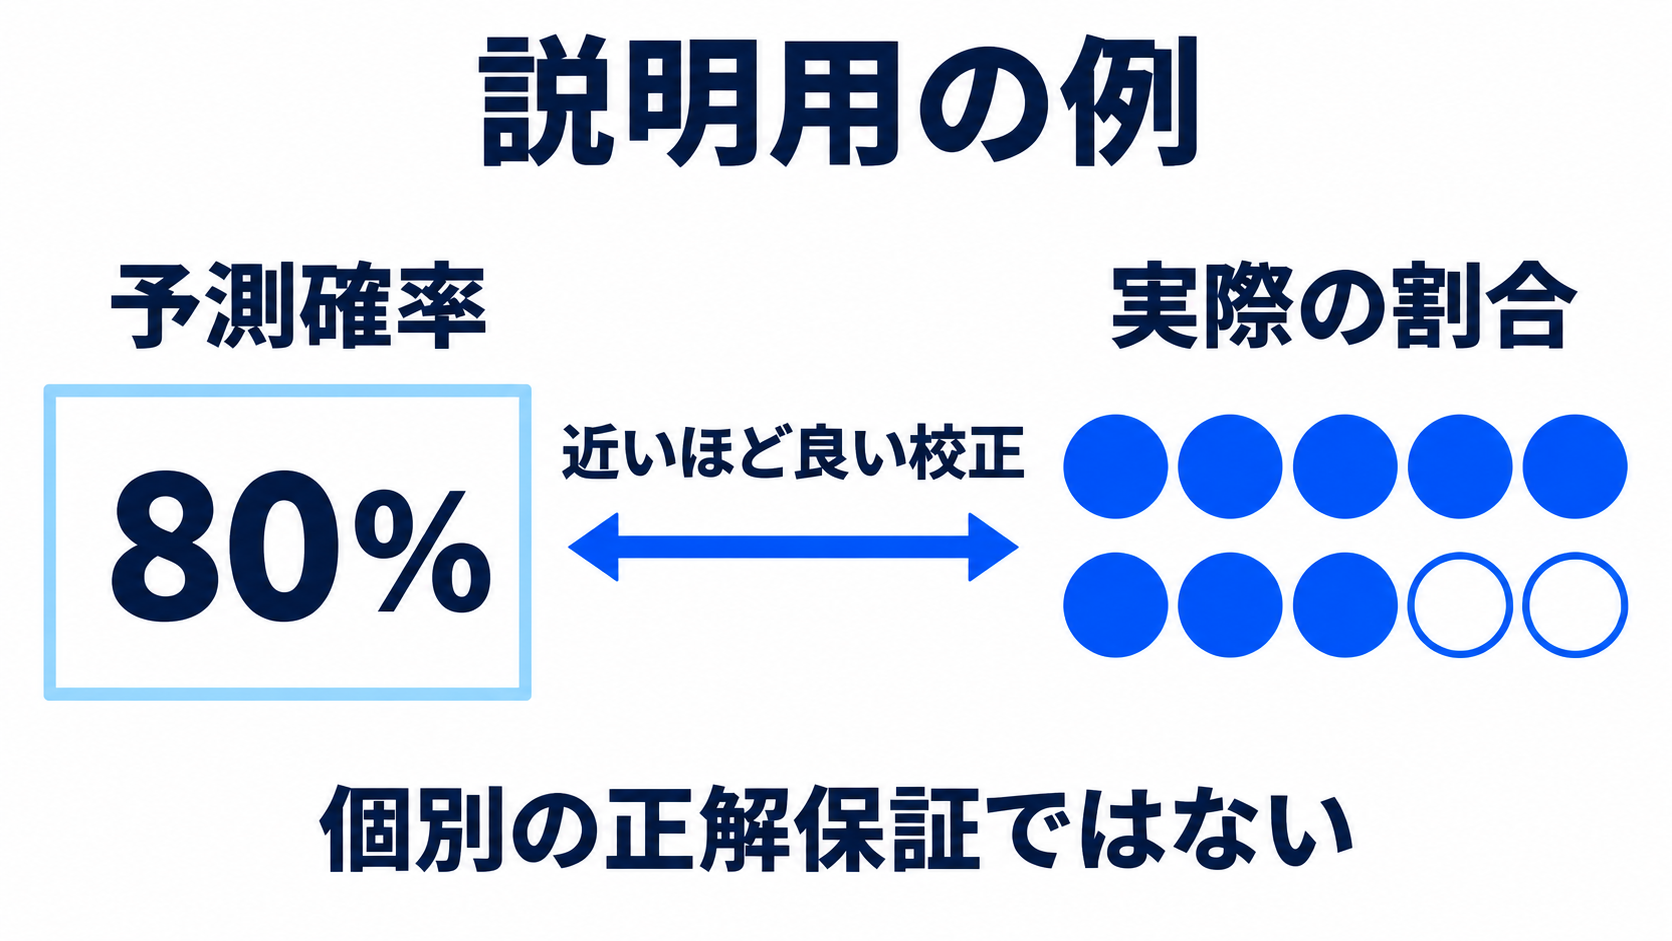
校正とは、モデルが示す確率と実際の結果がどれだけ整合しているかという性質です。説明のために単純化すると、同じ条件で「80%」と評価した案件を多数集めたとき、実際におおむね80%が該当する状態を目指します。一件ごとの判定が必ず当たるという意味ではなく、確率の数字を運用上の目安として使えるかどうかに関わります。
Basetenは、bison-1の校正性能にGemmaの基盤モデルと、学習データに増やした「ソフトラベル」が寄与したと説明しています。ソフトラベルは、一つの答えを唯一の正解として与える代わりに、確率を学習目標として使う方法です。判断が曖昧になるケースも確率として学ばせ、実際の正しさに見合う不確実性を返すことを狙います。
公表されたBrierスコアはbison-1が0.14で、Basetenが示したLiquid AIのd1.2-ultraの値は0.15です。Brierスコアは予測確率と結果のずれを評価する指標で、低いほど良好です。ただし、0.14という値を誤判定率14%と読み替えることはできません。
企業で活用するなら、確率に応じて自動処理、人による確認、追加情報の収集を分ける設計が候補になります。その境界値は、公開指標だけでは決まりません。見逃しと過剰な確認のどちらが業務に重い負担を与えるかを整理し、自社データで確率と結果の対応を確かめる必要があります。
総合首位でも、業務ごとに得意・不得意を見極める必要
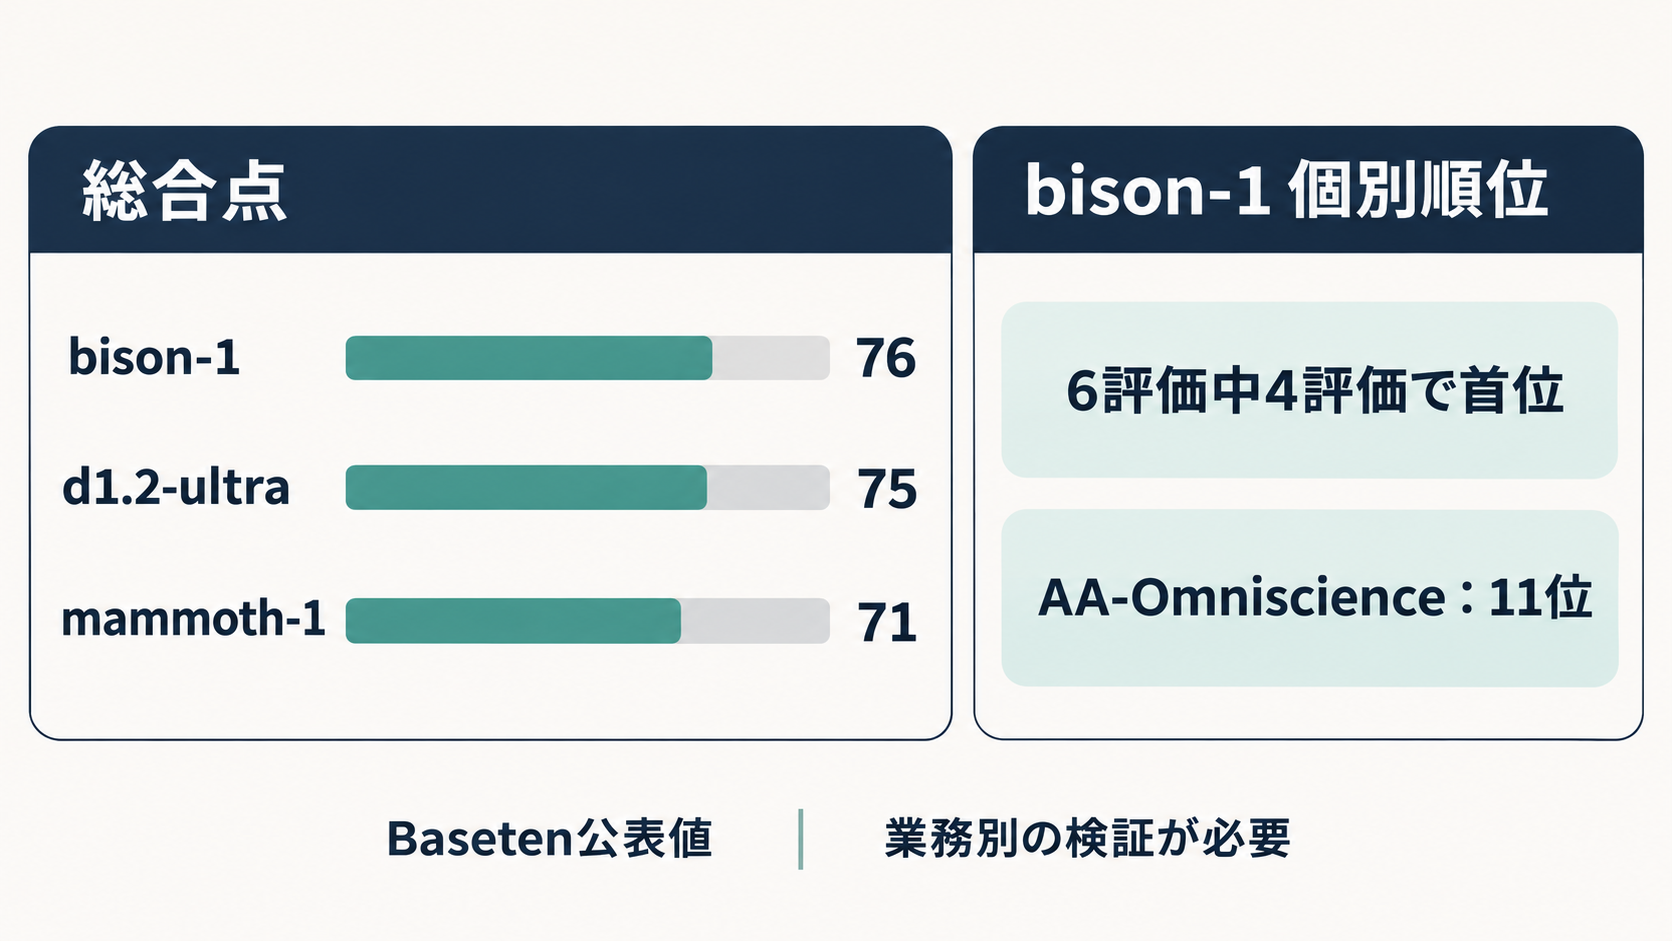
Basetenが公表したArtificial Analysis Decision Index v2.1の結果では、bison-1は76点で19モデル中の首位です。比較対象のd1.2-ultraは75点、Basetenの既存モデルmammoth-1は71点でした。Artificial AnalysisはAIモデルの評価を行う組織で、この指数は六つの評価を組み合わせています。総合点は比較の入口になりますが、そのまま各社の業務成績を示すものではありません。
内訳を見ると、bison-1はWhen2Callが98点、EvalSafe-O*NET-AAが93点、AA-Symmetry v1.1が89点、HLE-MultiChoice v1.1が51点で、それぞれ首位とされています。AA-Paperclipは73点で2位でした。六つのうち四つで首位という結果から、幅広い判断課題で競争力があることはうかがえます。
注意したいのは、AA-Omniscience-Decision v1.1が60点で11位だった点です。公表結果では、知識を多く必要とする判断が弱点として浮かびます。専門用語を含む問い合わせや、社内固有の知識に依存する分類を任せる場合には、その業務に近い問題を別途用意して確認するのが適切でしょう。総合首位という順位だけで、専門判断まで一括して任せる根拠にはなりません。
指数の構成にも目を向ける必要があります。AA-Paperclipは全体の30%を占めるため、総合点は各評価の単純平均ではありません。自社の業務がどの評価課題に近いかによって、同じ76点でも受け止め方が変わります。
groundhog-1については、紹介された公表情報の時点で同指数の公式スコアがありません。Basetenはmammoth-1に並ぶ性能を見込んでいますが、これは期待値です。また、今回示された性能値はBasetenの報告に基づきます。検証候補を絞る材料として使い、実運用での精度を保証する数字とは区別する必要があります。
128kの入力枠で広がる運用と、長文処理で残る確認点
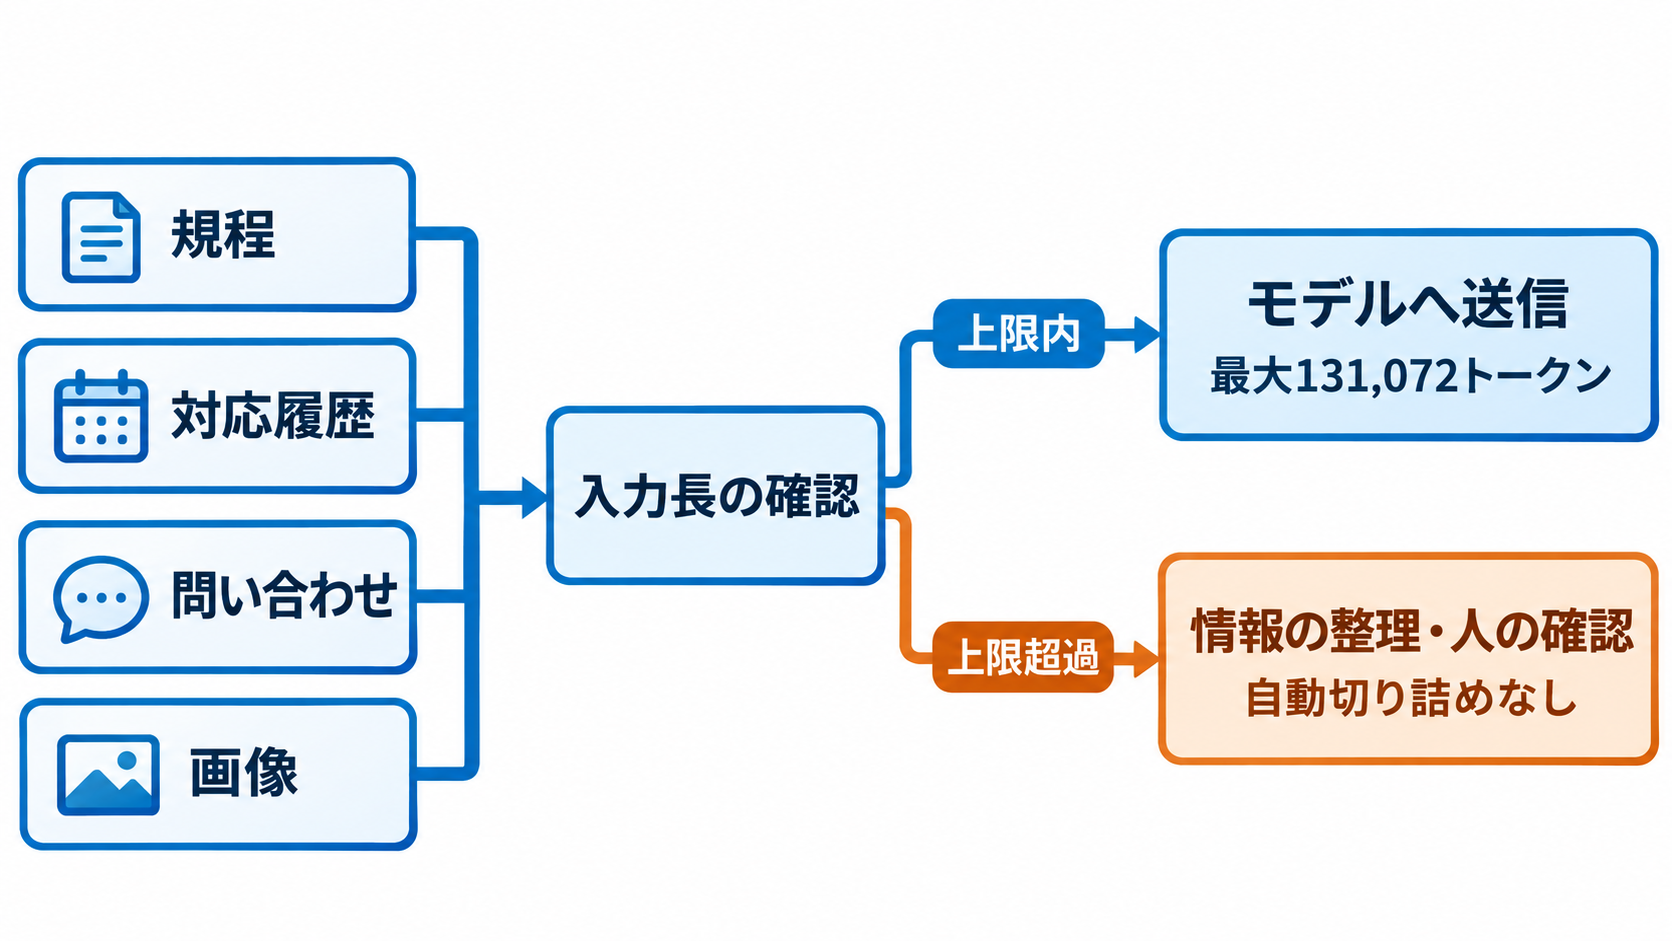
判断に必要な情報が短い問い合わせ文だけで完結するとは限りません。顧客とのやり取りが続いている場合、直近の一文だけでは緊急性や対応状況を読み違える可能性があります。社内規程に照らして処理を分ける業務では、判断対象に加えて基準となる文書も必要です。最大128kトークンへの拡張は、こうした情報を同じ入力に含める余地を広げます。
トークンはモデルが文章を処理する単位で、日本語の文字数と一対一には対応しません。そのため、128kトークンを固定のページ数や文字数に置き換えて運用するのは避けたいところです。システムでは、問い合わせ本文、履歴、規程、質問などを合わせた入力全体を対象に、実際のトークン数を管理する必要があります。
両モデルは画像も受け付けます。文章に添付された画面や資料を判断材料に含める構成が検討できますが、日本語の画面や細かな文字を含む画像での精度は、今回の情報だけでは分かりません。画像対応という仕様と、自社の資料を正確に読み取れるという実証は分けて考えるべきでしょう。
長文処理の評価では、BasetenはLongMemEval Mの128k条件でbison-1が84.8、groundhog-1が77.4と報告しています。LongMemEval Sでは、それぞれ87.1と79.3です。これらは長い文脈を扱う能力を検討する材料になりますが、必要な条件を常に漏れなく参照することまで保証するものではありません。
実装上、見落とせないのが入力上限を超えたときの挙動です。両モデルは、学習上の上限を超えるリクエストを自動的に切り詰めず、拒否します。長い履歴をそのまま送る運用では、呼び出し前に長さを確認し、上限超過時に情報を整理するか、人の確認へ回すかを決めておく必要があります。入力枠の拡大と例外処理の設計は、セットで検討することになります。
API料金だけでなく、誤判定と確認作業を含めて比較する
両モデルはBaseten Model APIsで利用でき、従来の意思決定モデルと同じAPIを使います。モデルIDはbison-1が「decision-models/baseten-bison-latest」、groundhog-1が「decision-models/baseten-groundhog-latest」です。Basetenはモデル名の変更で切り替えられると説明しています。ただし、呼び出し方を共通化できても、返る確率の傾向や運用上の境界値まで同じになるとは限りません。
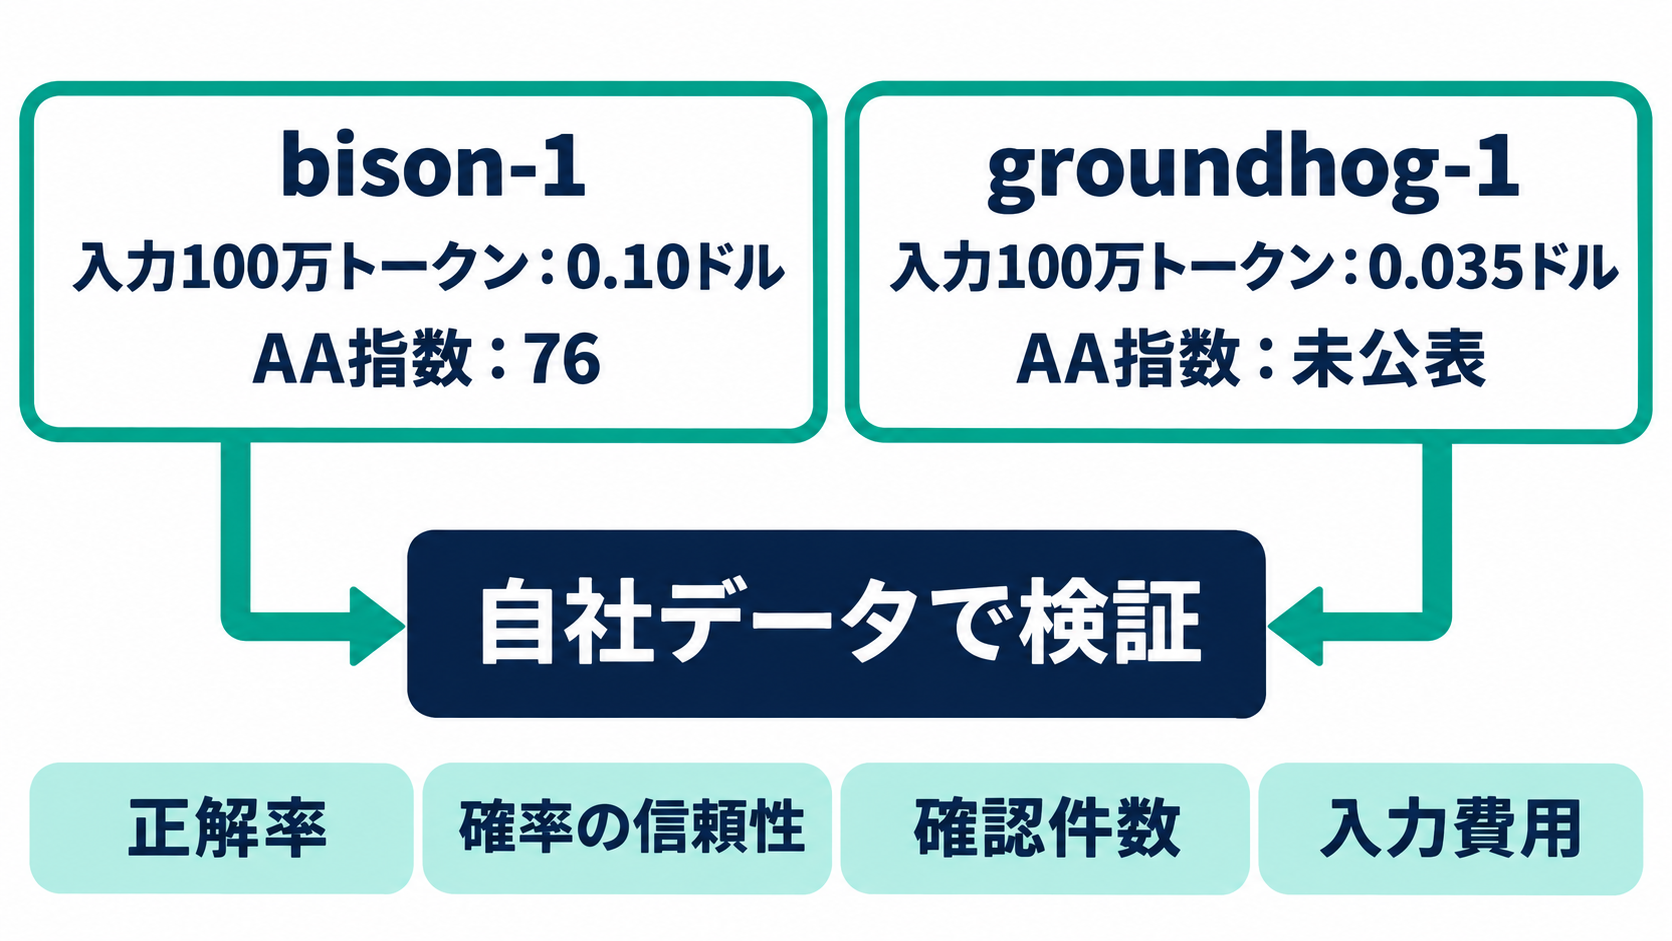
公表料金は、入力100万トークン当たりbison-1が0.10ドル、groundhog-1が0.035ドルです。出力トークンを生成しないため、料金を見る際は入力側が中心になります。同じ入力量ならgroundhog-1の料金が低くなりますが、長い履歴や規程を毎回含めれば、処理件数が同じでも入力量は増えます。単価と一件当たりの入力量を合わせて見積もることが必要です。
| 比較項目 | bison-1 | groundhog-1 |
| --- | --- | --- |
| モデル構造 | 310億パラメーターの密なモデル | 総数260億、稼働約40億のMoE |
| 最大入力 | 131,072トークン | 131,072トークン |
| 入力形式 | テキスト、画像 | テキスト、画像 |
| 入力100万トークン当たり料金 | 0.10ドル | 0.035ドル |
| AA Decision Index v2.1 | 76点 | 公式スコア未公表 |
重みは、AIモデルの共有サービスであるHugging FaceでもBF16形式で公開されています。BF16は数値を16ビットで表す形式で、重みだけの容量を概算するとbison-1は約62GB、groundhog-1は約52GBになります。この値は実行時に必要なGPUメモリーの総量ではありません。groundhog-1は稼働するパラメーターが少なくても、公開された重み全体が小さくなるわけではない点に注意が必要です。
推論向けGPUの具体的な構成や量子化済みモデルは、紹介された公開情報には示されていません。自社運用を選ぶなら、実行環境とライセンス条件を別途確認する必要があります。日本語の業務データでの精度も、今回の結果から直接は判断できません。
導入の最初の一歩としては、担当部署の振り分けなど一つの判断に対象を絞り、人が確定した過去の結果と両モデルの出力を照合する方法が考えられます。正解率だけでなく、確率の信頼性、見逃し、人の確認件数、入力費用を並べて確認してください。どちらが安いかより先に、どの判断をどこまで任せられるかを定めることが、モデル選定の具体的な基準になります。