

2026/11/14
AIニュース
Gemini 4 Carbonが数学ベンチマーク首位に、企業導入で問われる約15倍の評価コスト
この記事の要点
GoogleのGemini 4 Carbonが数学ベンチマークMathArenaで首位となりました。期待性能は85.4%ですが、評価時のコストはGPT-6.1 Solの約15倍です。時間超過や長時間実行の事例も踏まえ、企業には正答率だけでなく、費用、待ち時間、停止条件を含めた比較が求められます。
目次
Gemini 4 Carbonが首位、企業が見るべき性能差と費用差
数学の難問を解くAIを選ぶとき、正答率が最も高いモデルを採用すればよいのでしょうか。2026年11月14日に報じられた数学ベンチマーク「MathArena」の結果は、企業のモデル選定に別の判断軸を示しています。GoogleのGemini 4 Carbonが首位に立った一方、評価時のコストはOpenAIのGPT-6.1 Solの約15倍でした。性能の上積みを、どの業務なら費用に見合う価値へ変えられるかが焦点です。
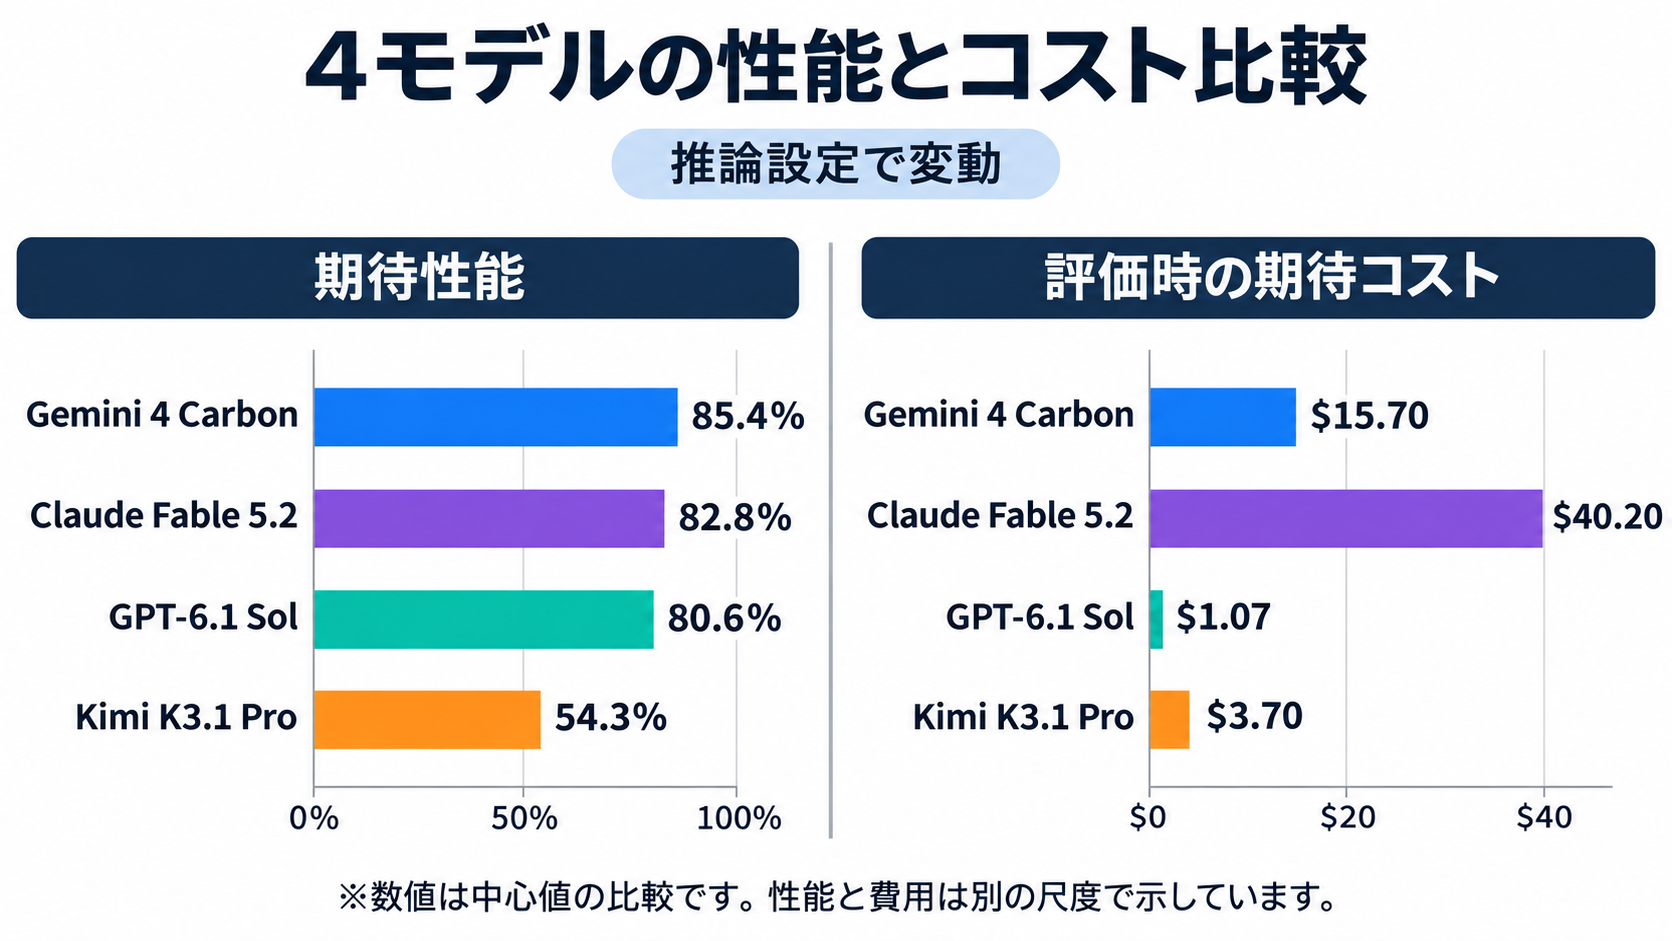
今回の評価で、Gemini 4 Carbonの期待性能は85.4%、GPT-6.1 Solは80.6%でした。両者の差は4.8ポイントです。AnthropicのClaude Fable 5.2は82.8%で、その間に入りました。米国のAI開発企業であるAnthropicも含め、複数社のモデルが上位を競う結果になっています。
ここで区別したいのは、順位の変化と、業務で採用する理由です。難しい問題への回答精度を優先する研究用途と、日々大量の処理を行う業務では、同じ性能差でも意味が変わります。誤答の影響が大きく、人による検証にも時間がかかる仕事なら、高い性能に費用を払う判断はあり得るでしょう。処理件数が多い仕事では、単価の差が選定を左右する可能性があります。
Googleが数学評価の首位を獲得したことは、比較候補を見直すきっかけになります。ただし、この結果だけで企業向け生成AIの優劣全体が決まるわけではありません。今回のニュースは「最も高得点のモデルはどれか」に加え、「その得点を得るために、どれだけの計算と費用を使ったか」を確認する必要性を示しています。
4モデルの比較で読み解く、正答率と評価条件
MathArenaは、AIの数学的な問題解決能力を比べるためのベンチマークです。今回示された結果には、モデル名だけでなく、推論に関する設定も添えられています。Gemini 4 Carbonはhigh、Claude Fable 5.2とGPT-6.1 Sol、Kimi K3.1 Proはmaxという設定でした。これらは各モデルの設定名であり、同じ名称や似た名称だからといって、同量の計算資源を使うとは限りません。
| モデル | 推論設定 | 期待性能 | 評価時の期待コスト |
| --- | --- | --- | --- |
| Gemini 4 Carbon | high | 85.4% ±3.0% | 15.70ドル ±1.33ドル |
| Claude Fable 5.2 | max | 82.8% ±5.3% | 40.20ドル ±2.59ドル |
| GPT-6.1 Sol | max | 80.6% ±2.7% | 1.07ドル ±0.018ドル |
| Kimi K3.1 Pro | max | 54.3% ±5.8% | 3.70ドル ±0.27ドル |
表の数値には、それぞれ幅が付いています。ただし、その幅の統計的な定義や詳しい算出条件は、今回確認できた情報では明らかではありません。そのため、中心値による順位は読み取れても、モデル間の差を統計的に確定した差として扱うことは避けるべきです。特に上位モデルの評価では、小さな数値差を必要以上に強調しない読み方が求められます。
中国のAI開発企業Moonshot AIのKimi K3.1 Proは、オープンモデルの最上位として紹介されています。ただし、この区分名だけでは、商用利用条件や公開範囲まで判断できません。導入候補にする場合は、性能表とは別に利用条件を確認する必要があるでしょう。
企業がこの比較から持ち帰れるのは、全業務に通用する順位ではなく、数学タスクにおける候補の位置関係です。日本語の指示理解、社内文書の扱い、既存システムとの連携などは、ここに示された得点からは分かりません。評価対象と自社の用途がどこまで重なるかを確かめてこそ、ランキングが選定資料として役立ちます。
約15倍のコストは、同じ条件での費用比較として扱う
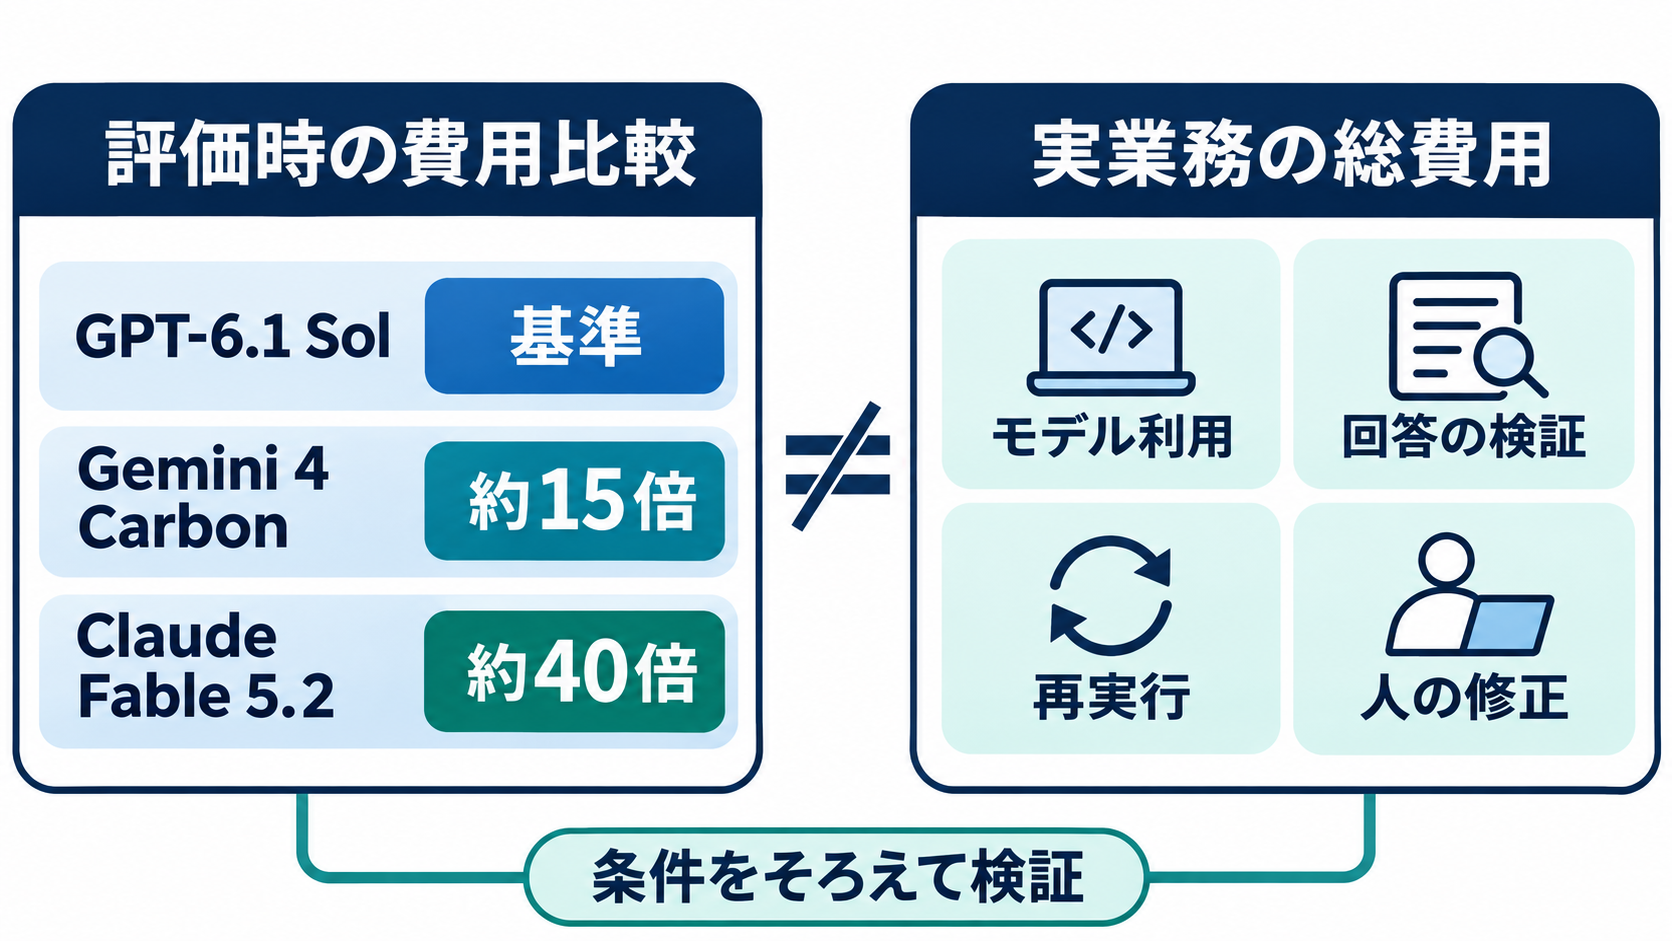
Gemini 4 Carbonの期待コスト15.70ドルを、GPT-6.1 Solの1.07ドルで割ると約14.7倍になります。Claude Fable 5.2の40.20ドルは約37.6倍です。報道で使われた「約15倍」「約40倍」という表現は、今回の評価で用いられた推論設定に基づく比較です。各社のサービスをどのように利用しても、常にこの倍率になるという意味ではありません。
この区別は、予算を組む際に欠かせません。今回示されたコストについては、集計単位や詳細な算定方法を確認できないため、そのまま「1問当たりの料金」や「月間利用料」に置き換えることはできません。自社の処理件数を掛けて予算を算出する前に、比較の分母をそろえる必要があります。
実業務の費用は、モデルへの支払いだけでも決まりません。回答の検証、失敗後の再実行、担当者による修正などにも負担が生じます。高いモデルが初回で正しい答えを返し、確認作業を減らせるなら、総費用の差は縮まるかもしれません。反対に、低いコストのモデルで十分な品質が得られる仕事では、高性能モデルを常時使う理由は弱くなるでしょう。
たとえば、通常の問題は費用を抑えたモデルに任せ、解けなかった問題や重要な案件だけを別のモデルへ送る構成が考えられます。これは今回の評価で効果が実証された運用ではなく、企業が検証できる設計案です。振り分け自体にも誤判定や追加処理が伴うため、単純に安くなるとは限りません。
比較すべきなのは、モデルの単価と正答率を別々に並べた数字だけではないはずです。必要な品質を満たした成果物を一つ得るまでに、どの程度の費用と人手がかかるかを測ると、約15倍という差が自社にとって許容できるかを判断しやすくなります。
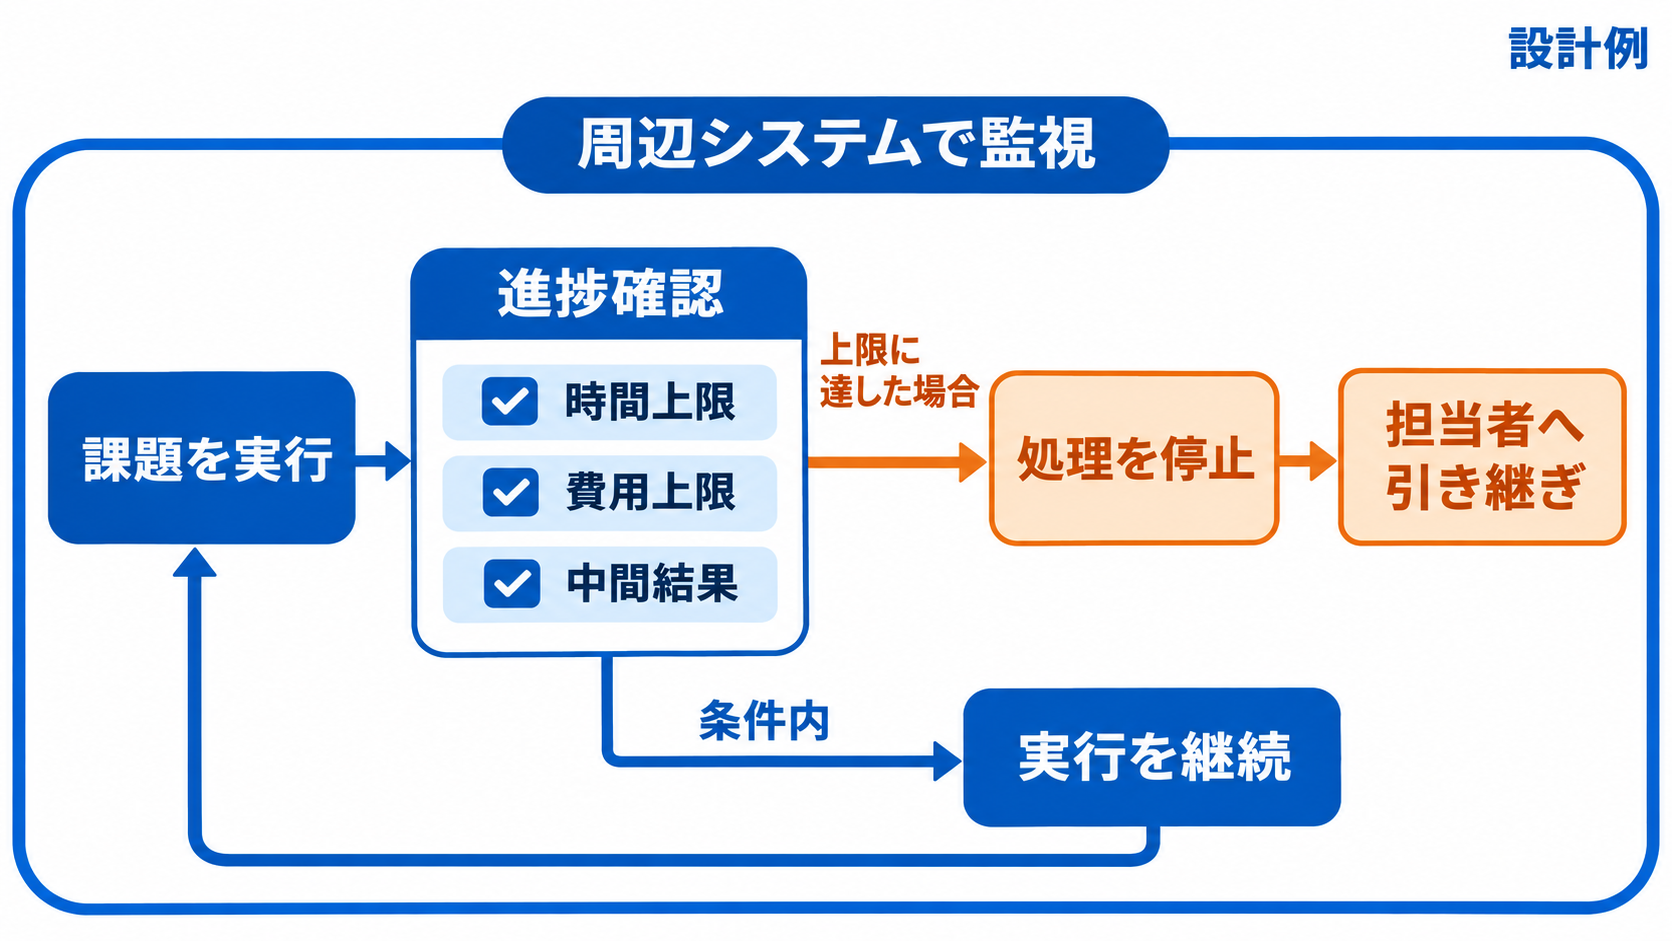
諦めにくいAIを使うなら、停止条件も設計する
Gemini 4 Carbonでは、失敗の形として制限時間の超過が最も多く見られたと報じられています。また、課題への取り組みをほとんど諦めない傾向も紹介されました。一例では、実行したスクリプトが11時間以上動き続け、その間にモデルが進捗を確認しなかったとされています。難問に粘り強く取り組む性質が、運用上は長い待ち時間につながる場合があります。
この事例だけから、通常の処理でも同様の長時間実行が起きるとは判断できません。ただ、正答率とは別に、処理をどのように続け、どの時点で止めるかを評価すべき理由にはなります。答えが得られても納期に間に合わなければ使えない業務では、時間超過は実用上の失敗になるためです。
企業システムに組み込む際は、実行時間の上限、費用の上限、進捗を確認する間隔を、AIの判断とは別に設定する方法が考えられます。モデルが処理の継続を選んでも、周辺システムが上限を検知して停止できる構成です。停止後に担当者へ通知するのか、条件を変えて再実行するのかも、業務の性質に合わせて決めておく必要があるでしょう。
進捗確認では、「まだ処理が動いているか」と「解決に向かっているか」を分けて考えると整理しやすくなります。プログラムが稼働していても、有効な中間結果が得られていなければ、継続の価値は判断できません。中間結果を確認できるタスクでは、一定時間ごとの出力やログを点検する設計が役立つ可能性があります。
粘り強さを価値として使えるかどうかは、待てる時間と監視方法によって変わります。今回の結果を受けて確認したいのは、単に「長く考えられるか」ではなく、必要な範囲で考え続け、条件を超えたら確実に止められるかという点です。
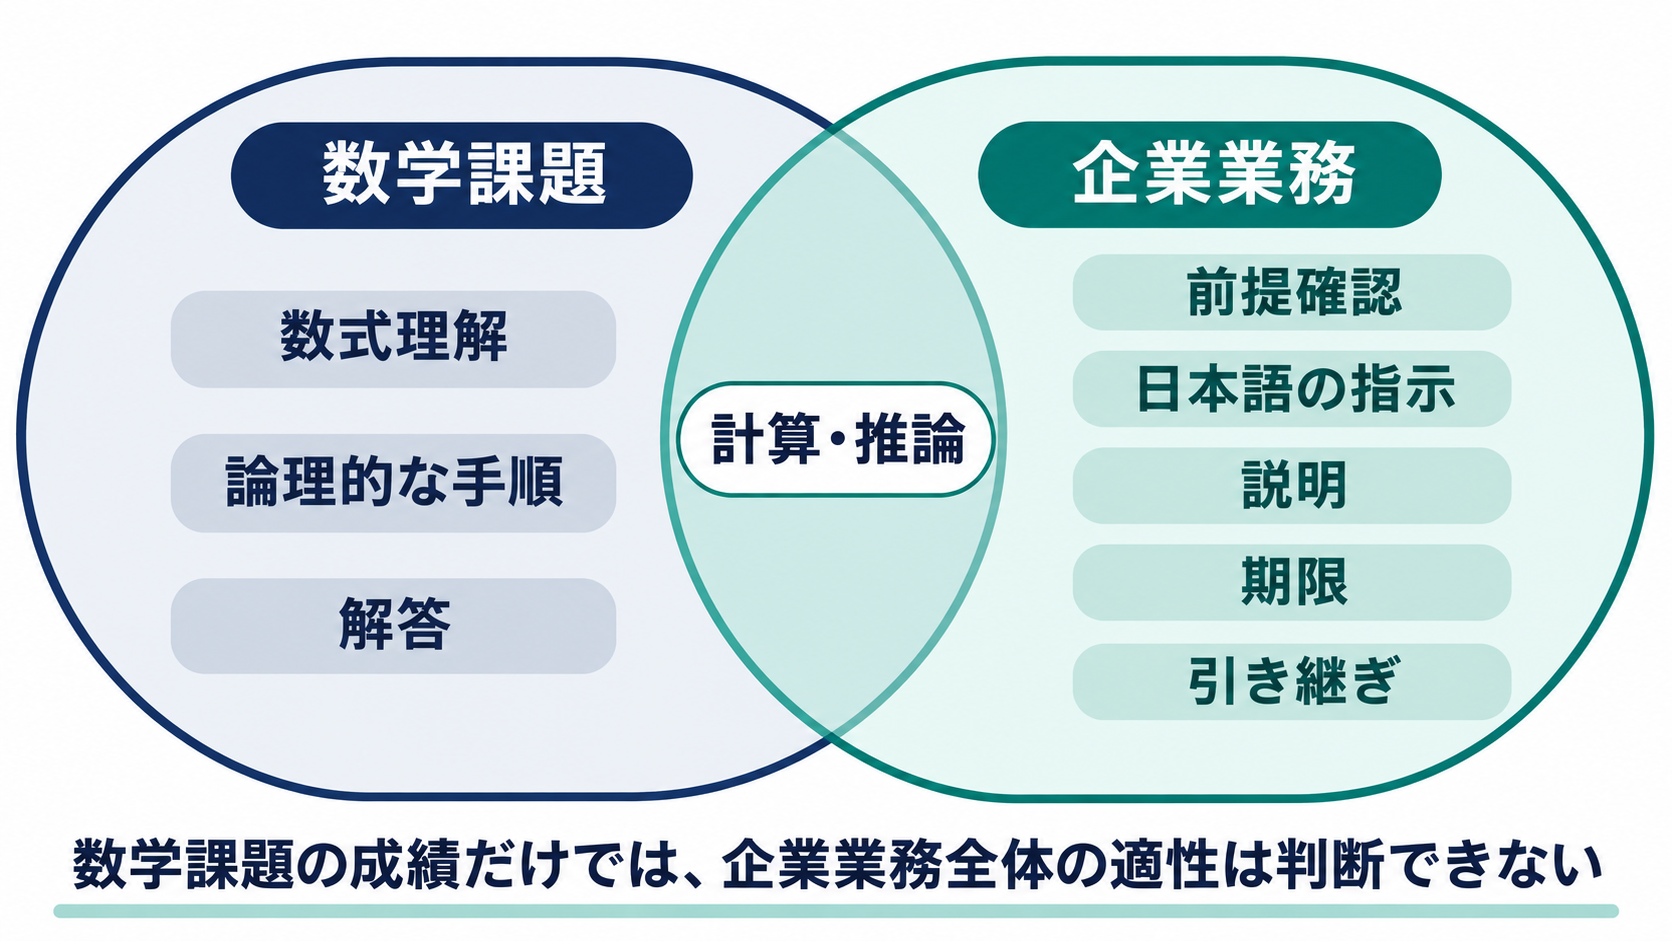
数学の好成績を、自社業務の成功へ読み替える条件
数学ベンチマークで高い得点を得ることと、企業の仕事を安定して完了することには、重なる部分と異なる部分があります。数式を扱い、複数の手順を組み合わせて答えを導く力は、数理的な検討を含む業務の参考になります。ただし、実際の仕事では、入力の不足や曖昧さを見つけること、前提条件を確認すること、結果を相手に伝えることも必要です。
たとえば、与えられた条件から計算する課題と、会議資料の不完全な記述から条件を整理する課題では、求められる能力が違います。正しい数式を立てる前に、担当者への確認が必要な場合もあるでしょう。数学の得点が高いモデルであっても、業務に必要な確認を適切に行えるかは、別途確かめなければ分かりません。
日本企業では、日本語の依頼を正確に読み取り、社内で使う形式に沿って説明できるかも選定項目になります。最終的な数値が合っていても、どの前提を使ったかが不明なら、担当者は結果を承認しにくくなります。計算の正確さと説明の追いやすさを分けて確認すると、利用者がどこで困るかを把握しやすくなるはずです。
評価課題には、通常の案件だけでなく、入力が足りない案件や、制限時間内に解決できない案件も含める方法があります。そのとき、分からない点を明示するか、追加情報を求めるか、処理を終了して引き継ぐかを観察します。これはモデルの能力を低く見積もるためではなく、任せられる仕事の範囲を具体的にするための確認です。
数学評価での首位獲得は、有力な候補を見つける材料になります。そこから導入判断へ進むには、自社の入力、必要な成果物、許容できる待ち時間を用いた評価が欠かせません。得点をそのまま業務適性へ置き換えず、実際に完了させたい仕事との接点を探ることが必要です。
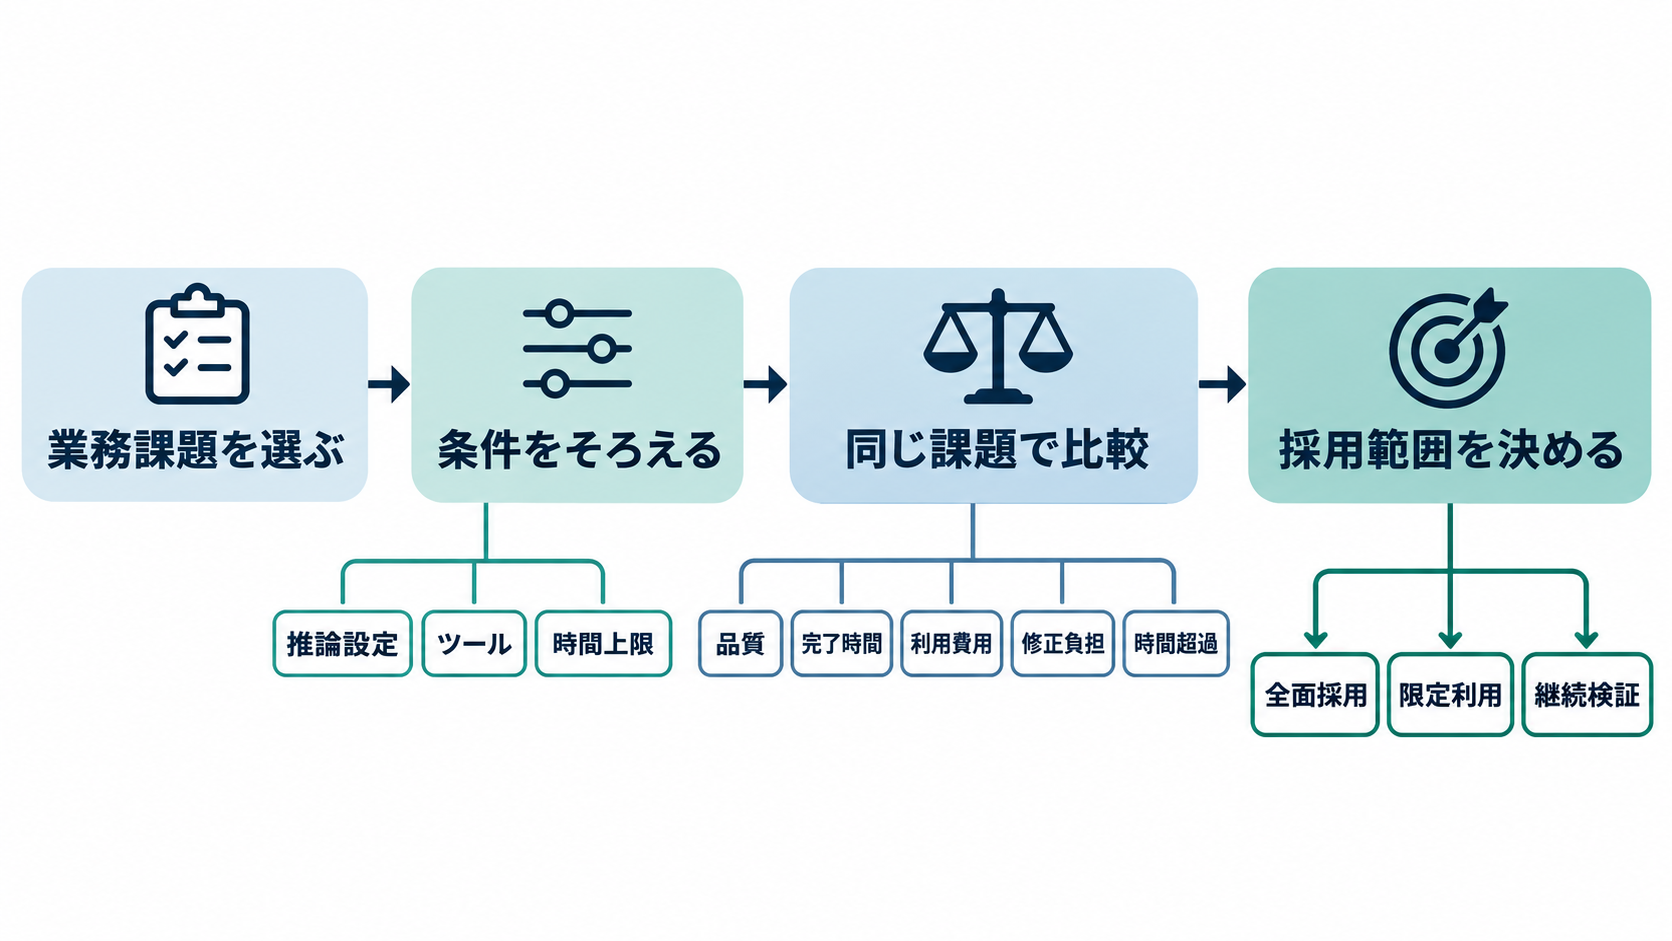
導入判断は、同じ業務課題を解かせる小規模検証から
今回の結果を受けて企業が着手しやすいのは、現在使っているモデルと新しい候補に、同じ業務課題を解かせる小規模な比較です。モデル名だけでなく、推論設定、利用できるツール、時間上限、入力内容を記録しておくと、結果の違いを検討しやすくなります。設定が異なるままでは、何に費用を払っているのかが見えにくくなるためです。
比較課題は、担当者が実際に時間を費やしている仕事から選ぶとよいでしょう。特に、計算や論理的な検討を含み、完成した答えの良否を確認できる課題が、今回のニュースとの接点を持ちます。正解を判断する基準が曖昧なまま始めると、文章の印象だけで採用候補を選んでしまうおそれがあります。
記録する項目は、正答や成果物の品質、完了までの時間、利用費用、人による修正の負担などです。時間超過や途中停止も結果として残せば、成功した事例だけを見て判断することを防げます。平均的な処理時間に加え、長くかかった案件を確認すると、業務の締め切りに対応できるかも検討しやすくなるはずです。
評価前には、採用の条件も決めておきたいところです。たとえば、費用が増えても難問の解決率を優先するのか、一定の品質を満たしたうえで費用を抑えるのかによって、選ぶモデルは変わります。すべての仕事を一つのモデルへ統一するかどうかも、比較結果を見て決められる論点です。
Gemini 4 Carbonの首位獲得を、自社のモデル切り替えへ直結させる必要はありません。まずは現在のモデルが解けない数理的な課題を選び、Carbonで改善するか、その改善に追加費用と待ち時間を払えるかを確認してください。この一歩なら、ランキングの変化を、具体的な業務価値を判断する材料へ変えられます。