

2026/11/09
AIニュース
MoEの専門家を「組み合わせ」で削減するHOPE、モデル軽量化とコード修正能力の両立へ
この記事の要点
Amazonの研究チームが発表したHOPEは、MoEモデルの専門家を個別の重要度だけでなく、ペアの相互作用も考慮して削減します。Qwen3.5-35B-A3Bの専門家を50%削減した実験では、コード修正評価で削減前と同程度の結果を示しました。企業での採用には、メモリ削減幅と実際の業務品質を同じ条件で比較する検証が必要です。
目次
動く専門家は一部でも、メモリには全員分が必要です
大規模言語モデルを自社環境で動かそうとすると、計算量より先に、モデルを載せるメモリの容量が壁になることがあります。必要な部分だけを動かすMoE(Mixture-of-Experts)でも、この問題は残ります。Amazonの研究チームが発表したHOPEは、モデル内の「専門家」を削減する際に、専門家同士の組み合わせまで考慮する軽量化手法です。焦点は、単に容量を減らすことではなく、残した構成でどれだけ能力を維持できるかにあります。
MoEは、複数の専門家ネットワークから、入力に応じて一部を選んで処理する仕組みです。ここでいう専門家は、人間の担当者や独立したチャットボットではありません。モデルの層の中に置かれた、MLPと呼ばれるニューラルネットワークです。選択的に計算することで、総パラメーター数を増やしながら、入力ごとの計算負荷を抑えられます。
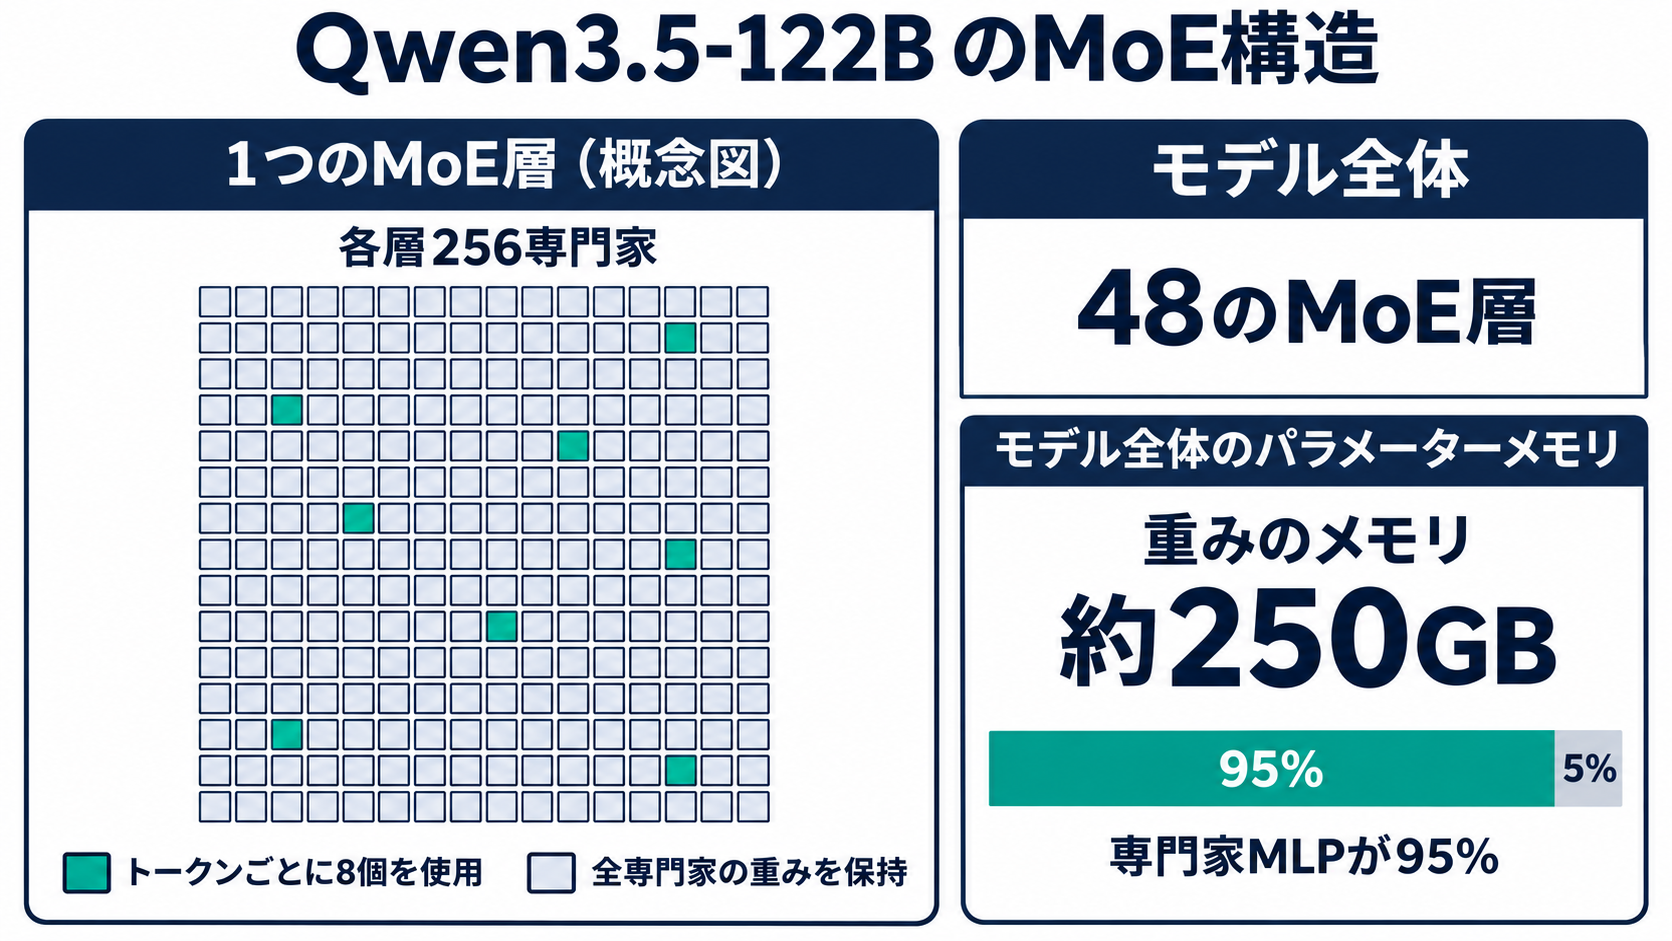
研究チームが示したQwen3.5-122Bの例では、48のMoE層それぞれに256個の専門家があり、各トークンの処理に使うのは各層で8個です。それでも推論時には全専門家の重みを保持する必要があります。約250GBというパラメーターメモリのうち、専門家のMLPだけで95%を占めると説明しています。計算を休んでいる専門家も、保存場所は必要というわけです。
この容量を直接減らす方法が、不要と判断した専門家を恒久的に取り除く「専門家プルーニング」です。必要に応じて専門家を読み込む方式とは異なり、動的な転送に伴う遅延を避けられます。再学習を必要とせず、重みの数値表現を小さくする量子化とも組み合わせられる点が利点です。ただし、削減対象の選択を誤れば、容量と引き換えに業務で必要な能力を失いかねません。HOPEが取り組むのは、この選び方の問題です。
個別の重要度だけでは、専門家の協力関係を見落とします
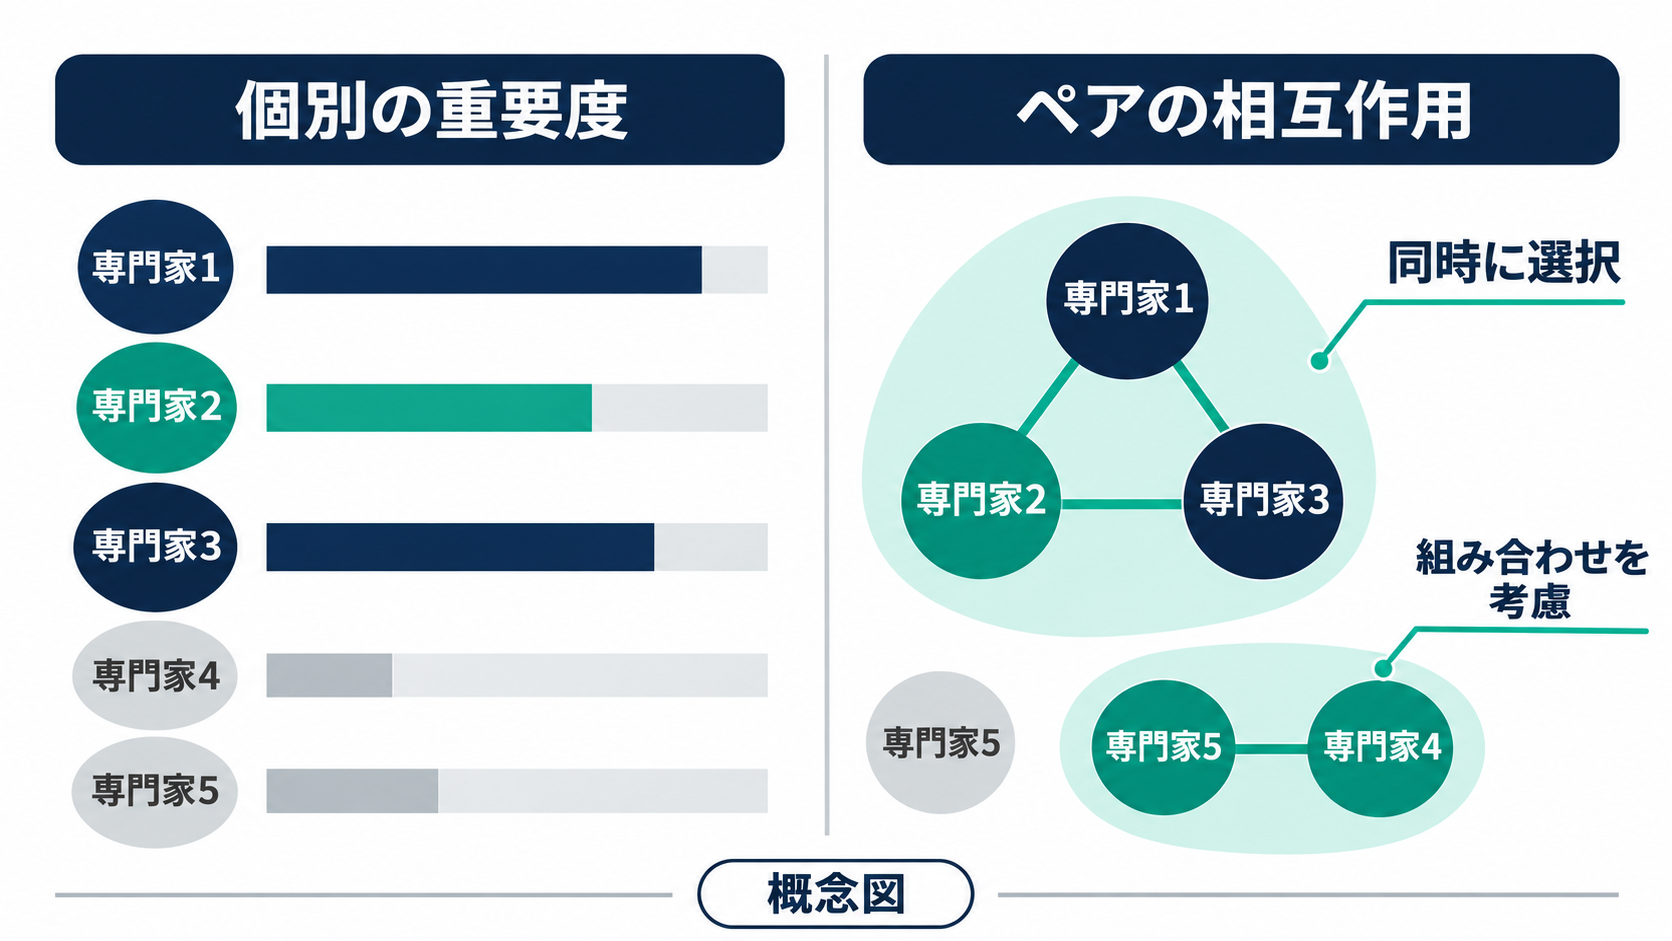
専門家を削ると聞くと、利用頻度や重要度を測り、下位から取り除けばよいように思えるかもしれません。実際、比較対象となった既存手法は、校正用データを使って専門家ごとの重要度を数値化し、層ごとに削減対象を決めます。校正用データとは、モデルがどのように動くかを観測するための入力例です。この方法は判断基準が明快ですが、各専門家の貢献を個別に扱うという前提があります。
MoEでは、ルーターと呼ばれる仕組みが入力ごとに専門家を選びます。ルーターは各専門家に重みを付け、上位の専門家を有効化します。選ばれた専門家の出力を、その重みに応じて足し合わせたものが層の出力になります。専門家が一つずつ独立して回答を完成させる構造ではなく、複数の出力が同じ処理に寄与する構造です。
研究チームは、実験で一定の専門家群が繰り返し同時に選ばれる様子を確認しています。また、先行研究でも、専門家の協調的な選択パターンが学習の早期に現れ、その後安定することが報告されていると紹介しています。HOPEは、この関係を削減判断に取り込みます。
例えば、専門家Aの個別スコアが低くても、重要な専門家Bと頻繁に組み合わされている場合があります。Aだけの評価では削減候補になっても、Bを含む組み合わせとして見ると、残す価値があるかもしれません。これは人間の部署にそのまま置き換えられる話ではありませんが、個人別の数字だけでチームの働きを判断しにくい状況に似ています。
削減率が上がるほど、同時に失われる組み合わせも増えます。専門家を少数取り除く段階では目立たなかった影響が、半数を取り除く段階で表面化する可能性があります。HOPEの中心的な着眼点は、「誰を残すか」を一人ずつ決めるのではなく、「どの組み合わせを残すか」という問題として扱うことです。
HOPEは専門家ペアの情報から削減対象を決めます
HOPEの正式名称はHigher-Order Pruning of Expertsです。名称には高次という意味が含まれますが、今回の手法が直接扱うのは、専門家2個の間の相互作用です。3個以上の組み合わせをすべて評価する仕組みではありません。個々の重要度だけを使う一次の手法に対し、ペアの情報まで取り込む二次の手法として位置付けられます。
専門家を削除すると、それまで選ばれていた専門家の代わりに、ルーターの重みが次に高い専門家が選ばれる場合があります。この入れ替わりによって層の出力が変わります。理想的には、削減後の出力変化が最も小さくなる構成を探したいところですが、代役の選ばれ方自体が削減対象に依存するため、そのまま最適化するのは困難です。
そこでHOPEは、削減誤差の主要成分に対する上界を与える、計算可能な代理指標を使います。指標には、選択された専門家のルーター重みと、出力の大きさを用います。和を二乗する形にすることで、各専門家単独の項に加え、専門家同士の積を表す項が現れます。このペアの項が、個別評価では扱わなかった情報です。代理指標を小さくする設計であり、あらゆる入力の最終回答品質を直接保証するものではありません。
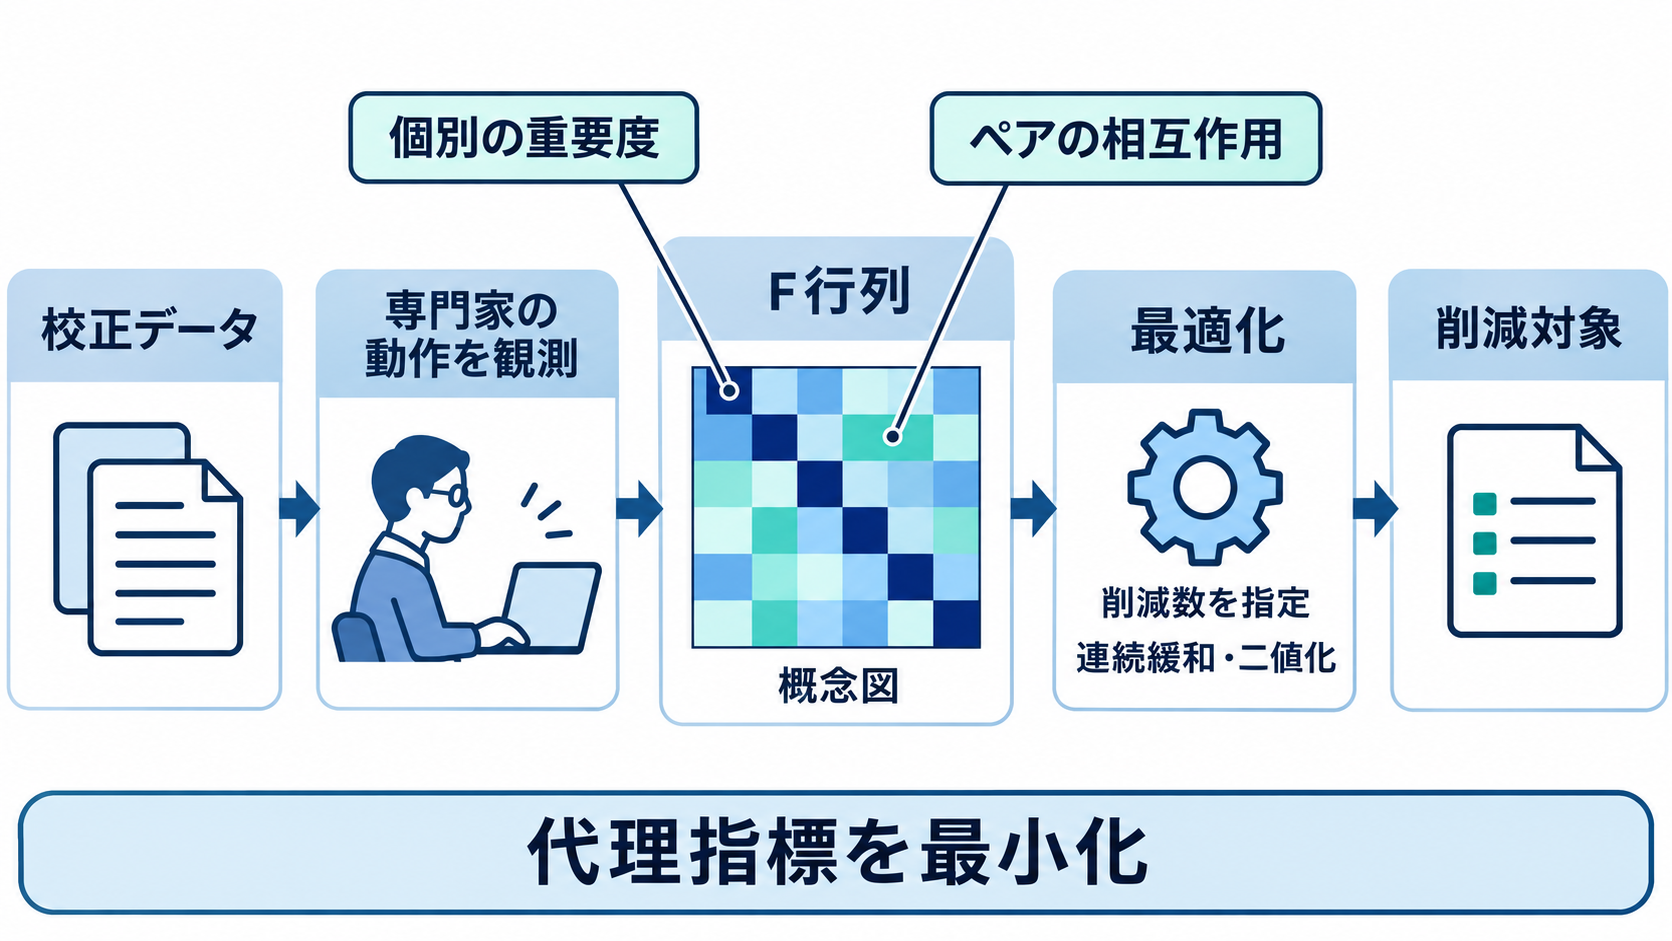
観測結果は、専門家同士の関係を並べた「F行列」にまとめます。対角成分は個別の重要度に対応し、対角以外の成分は、同時に選ばれた専門家ペアの重み付き出力の積を表します。ここでいう協力の強さは、この指標による評価です。専門家の役割を人間が読める意味で特定したり、依存関係の因果を証明したりするものとは区別して理解する必要があります。
HOPEは削減数を指定したうえで、行列全体を使う二次計画問題を解きます。連続値で扱える形に緩和し、結果を削除するか残すかの二値に丸めます。研究チームによると、追加の求解処理は1層あたり約1〜2秒で、処理時間の中心は校正データを流す工程です。既存手法REAPに近い個別評価を土台に、組み合わせの情報を加える構成と捉えると理解しやすいでしょう。
半数削減時のコード修正評価で差が広がりました
評価にはQwen3.5-122B、Qwen3.5-35B、GLM-4.5-Airの3モデルを使い、専門家の削減率を10〜50%で変えています。校正にはEvol-CodeAlpacaと、SWE-Bench Verifiedの課題に取り組む際の処理記録を使用しています。性能は複数の能力を測るTulu3の評価群と、ソフトウェア修正課題を扱うSWE-Bench Proで検証し、REAP、MAN、EAN、Frequencyの4手法と比較しています。
全条件を通じたHOPEの平均順位は、5手法中2.07位でした。1位となった条件は39%、2位以内は67%です。これは、常に最高性能だったという意味ではありません。モデル、校正データ、評価項目、削減率をまたいで比較した際に、相対的に安定した順位を得た結果として読む必要があります。
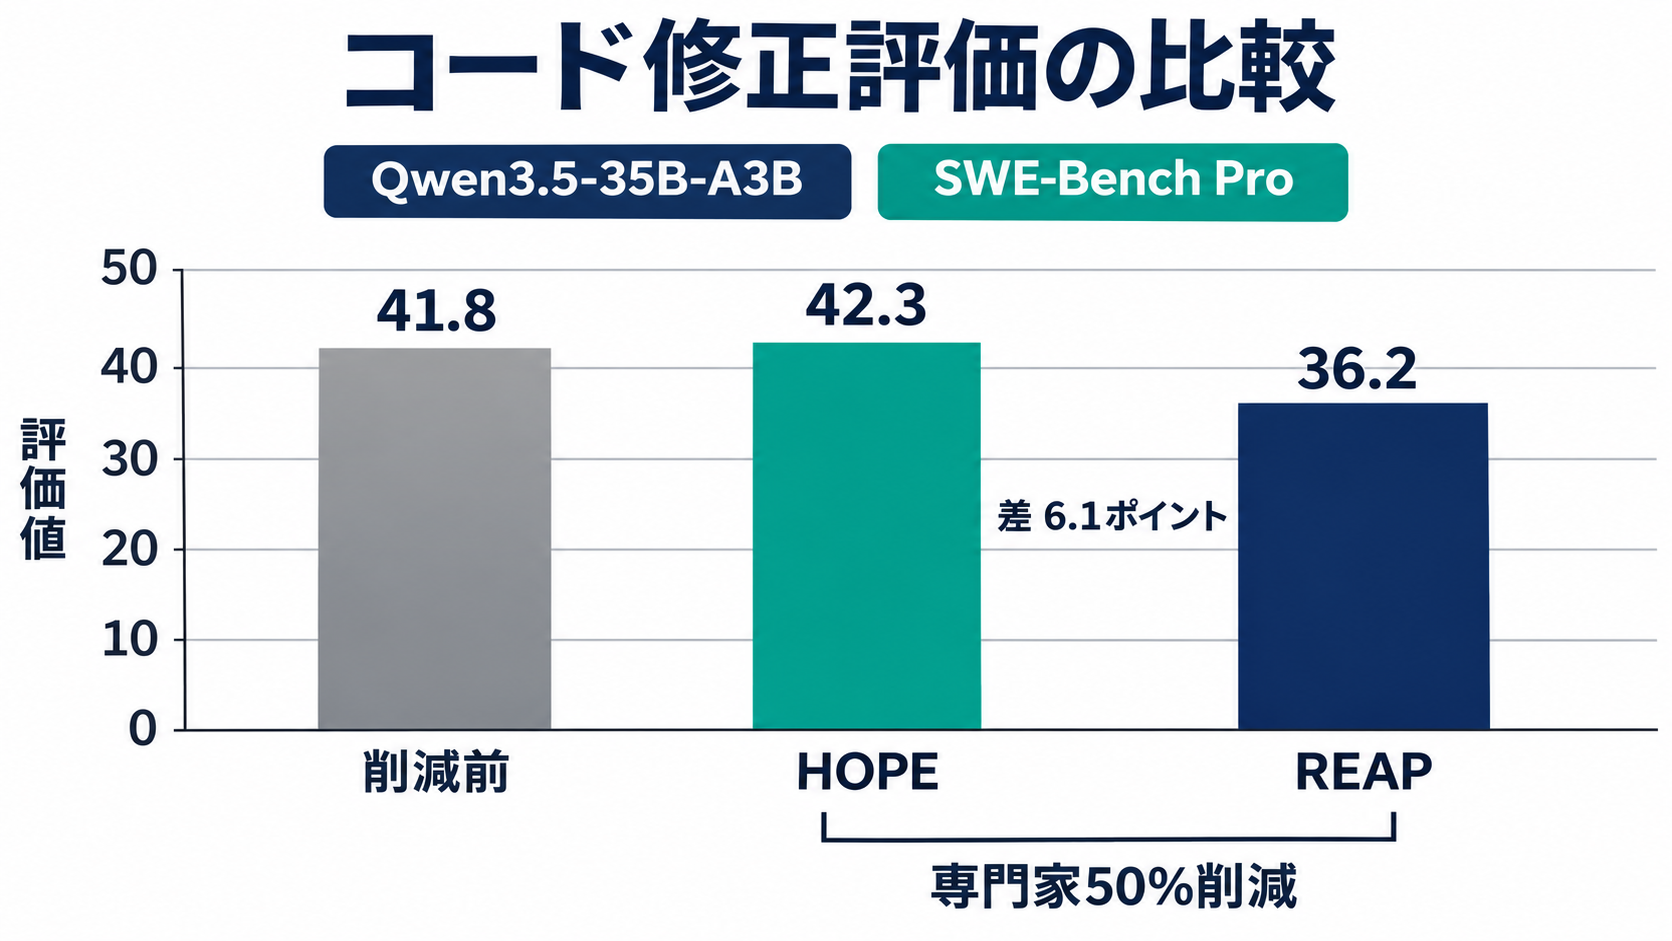
差が広がったのは削減率が高い条件です。50%削減時の平均順位はHOPEが1.58位、次点のREAPが2.42位でした。特に目を引くのが、複数ターンにわたりコードの確認やツール利用を行うSWE-Bench Proでの結果です。Qwen3.5-35B-A3Bの専門家を50%削減した条件で、HOPEの評価値は42.3、削減前は41.8、REAPは36.2でした。HOPEとREAPの差は、評価値で6.1ポイントです。
削減後の42.3が削減前の41.8を上回った点だけを取り上げ、軽量化すれば能力が上がると判断するのは早計です。研究チームは、対象課題との関連が低い専門家を除くことでノイズが減る可能性を挙げていますが、これは結果に対する解釈です。この数値だけでは、広い用途での性能向上や、差の統計的な確実性までは判断できません。
企業での評価に置き換えるなら、コード修正の成功率に加えて、別領域の業務品質も確認すべきでしょう。今回の実験では、コード中心の校正によって非コード系の評価が深刻に悪化する傾向は見られず、HOPEは校正データによらずTulu3でも良好な結果を示しています。ただし、社内の日本語文書や独自の業務手順まで同じ結果になるかは、別途検証が必要です。
導入は「観測・選択・削減」の3工程です
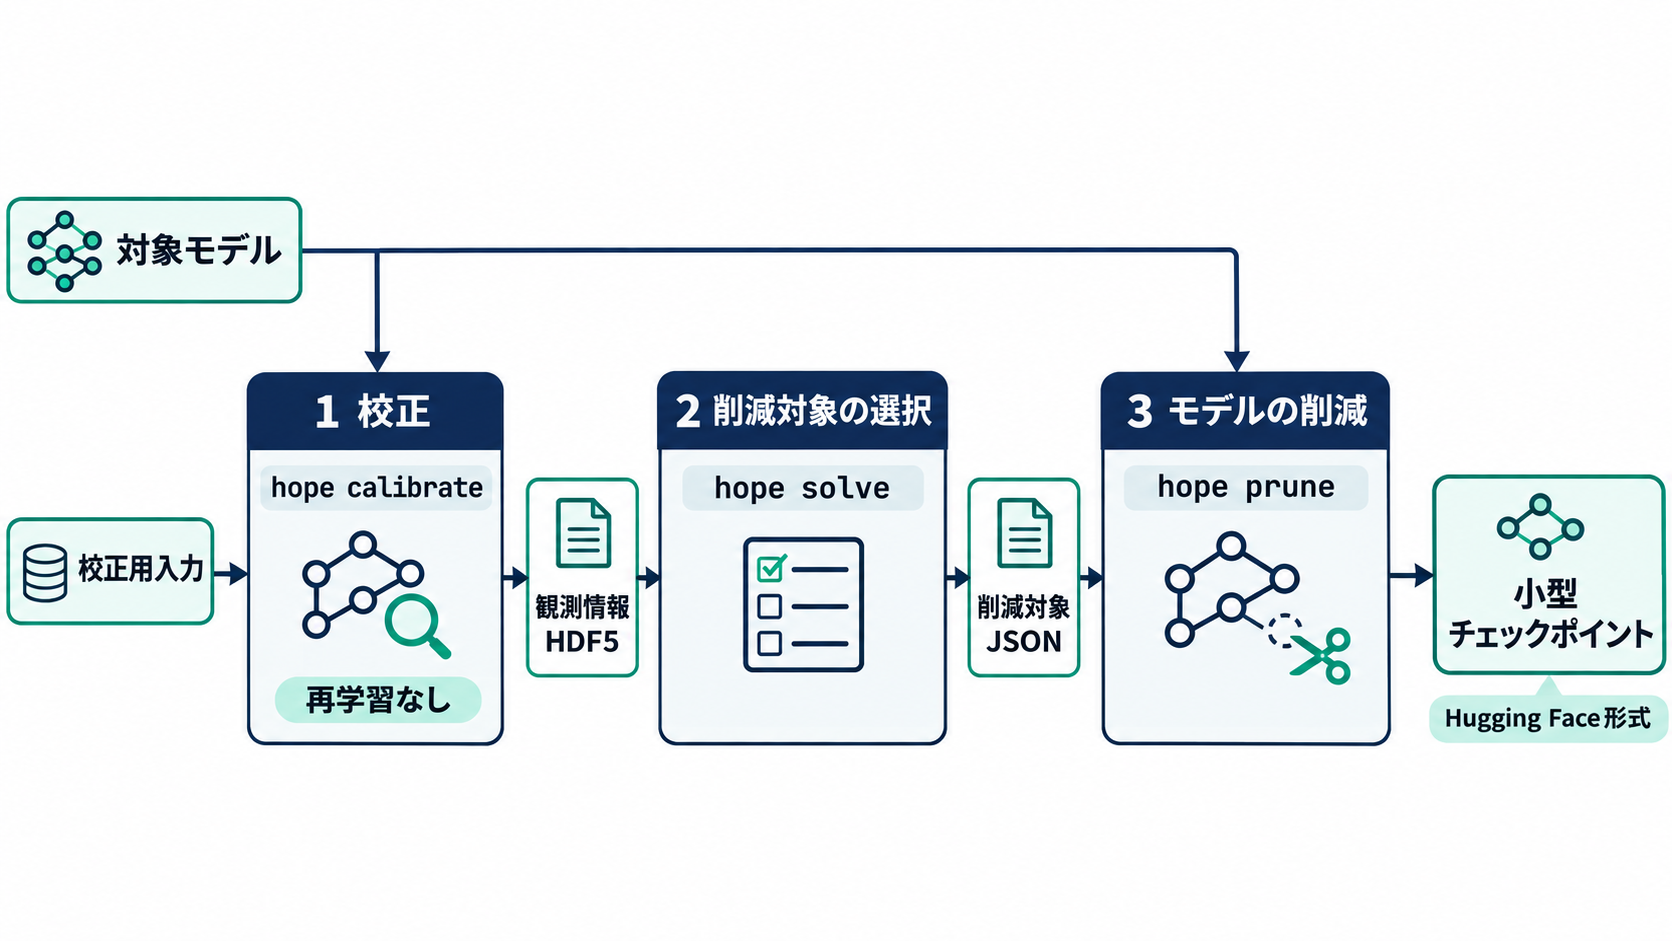
研究チームが公開したパッケージは、校正、削減対象の選択、モデルの削減という3工程で利用します。検証済みのモデル系列として、Qwen3、Qwen3-Next、Qwen3.5、GLM-4.5が挙げられています。公開されているからといって、すべてのMoEモデルにそのまま適用できると考えるのではなく、利用予定の構成との適合を確認する必要があります。
校正を担当するのはhope calibrateです。対象モデルと入力例を指定し、校正データを使って1回の順伝播を実行します。順伝播は、入力をモデルに通して出力を計算する処理であり、この工程で重みを学習し直すわけではありません。Hugging Face Transformersを利用して、各層で選ばれた専門家、ルーターの重み、出力の大きさ、ペアの同時有効化に関する統計を取得し、HDF5形式のファイルに保存します。
続くhope solveでは、保存した観測情報と削減率を指定し、削減対象を求めます。例えば削減率を0.50にすれば、専門家を半数削減する設定です。出力は削減対象を記載したJSONファイルで、この時点ではモデルの重み自体は小さくなっていません。選択結果とモデル生成が分かれているため、どの構成で削減するかを確認してから次の工程へ進められます。
最後のhope pruneで、対象モデルと削減対象のJSONを読み込み、小型化したチェックポイントを書き出します。研究チームによると、出力は標準的なHugging Face形式で、ディスク容量とメモリ使用量が小さくなります。vLLMやSGLangといったLLM推論基盤についても、モデル定義を変更する必要はないと説明しています。コマンドに加えてPython APIも公開されています。
導入時に意味を持つのは、コマンドの実行以上に校正データの選び方です。単発の質問応答と、ツールを繰り返し使う業務では、通過する処理の組み合わせが異なる可能性があります。自社で想定する入力や作業の流れを校正に含め、そのデータとは別の評価例で品質を測る設計が考えられます。校正でよく見せた入力に対応できることと、日々の業務で能力を保てることは、分けて確かめるべきでしょう。
企業が確かめるべきは、削減率より業務の完遂率です
HOPEの利点が強く現れたのは、専門家を40〜50%削減する領域です。10〜20%程度の削減では、REAPやMANなどの一次手法が競争力を持つ場合もあり、HOPEとの差は縮まります。少量の容量削減で要件を満たせる企業と、モデルの配置構成を変えるほどの削減が必要な企業では、比較すべき条件が異なります。最も高い削減率を選ぶこと自体が目的ではありません。
手法にも境界があります。HOPEは基本的に層ごとに独立して削減対象を決めるため、別の層にある専門家同士の関係までは最適化していません。研究チームは層をまたぐ拡張の理論的な枠組みも示していますが、結果は予備的な段階です。3個以上の専門家による相互作用も、今回の方式が直接評価する対象には含まれません。組み合わせが急増するため、推定は難しくなります。
専門家を半数削ることと、システム全体のメモリが半分になることも区別が必要です。モデルには専門家以外の重みがあり、推論中には文脈を保持するためのキャッシュなども必要になります。容量が空けば長い文脈や複数の処理に割り当てやすくなる可能性はありますが、今回の評価値だけから、実環境での同時処理数や応答速度の改善幅までは決められません。
日本企業にとっては、モデルを小さくできたかに加え、日本語の業務を最後まで実行できるかが判断の中心になります。例えば社内文書を参照した回答であれば、必要な根拠を拾えるか、条件を取り違えないかを確認します。コード修正であれば、修正案を出せるだけでなく、必要な確認やツール操作まで続けられるかが評価対象です。これはHOPEで得られた追加の実験結果ではなく、導入判断に向けた検証の考え方です。
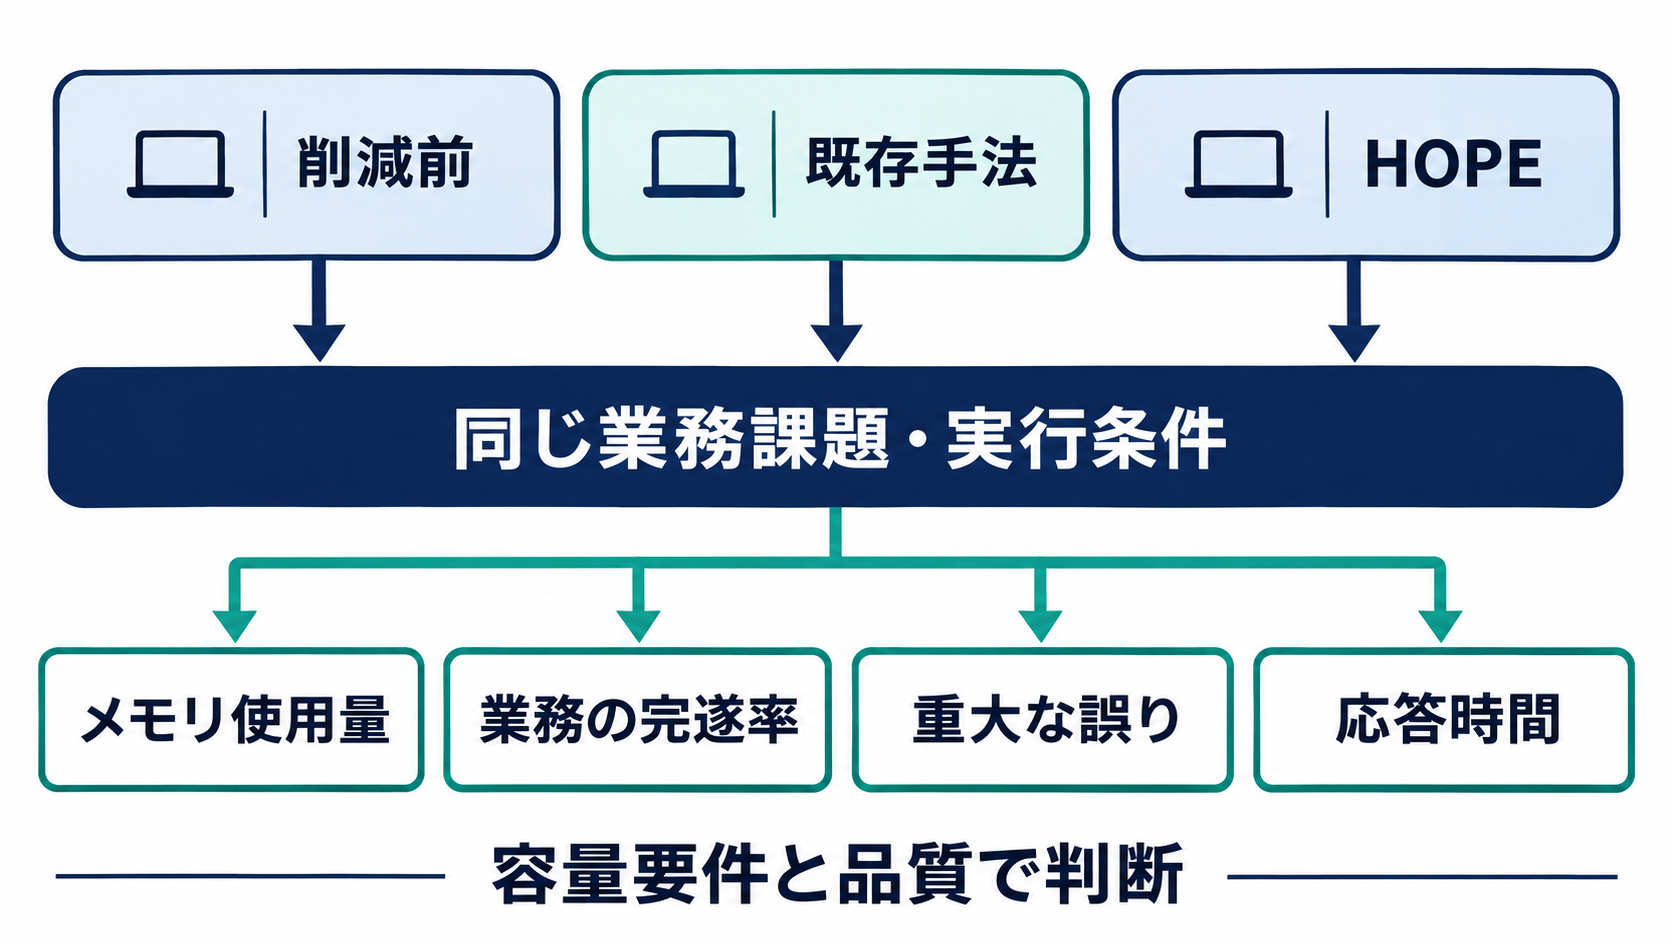
検証の第一歩として、削減前、既存手法、HOPEを同じ業務課題と実行条件で比較する方法が考えられます。許容できるメモリ容量を先に定め、その範囲で業務の完遂率と重大な誤りを測れば、削減率の数字だけに判断を引っ張られにくくなります。HOPEの成果を自社の価値につなげるには、まず実務に近い小さな評価セットを用意し、容量を減らしても守るべき能力を明確にすることが出発点です。