
2026/11/08
AIニュース
MoEの「稼働パラメータ数」だけでは見えない違い――DeepSeek、Qwen、Llamaなど10モデルのルーティング比較
この記事の要点
MoEモデルは、稼働パラメータ数が近くてもGPUメモリや通信の負荷が異なります。DeepSeek、Qwen、Llamaなど10モデルのエキスパート数、top-k、共有経路を比較し、企業が設備見積もりと業務検証で確認すべき点を整理します。
目次
「17B稼働」だけではGPUの必要量は決まりません
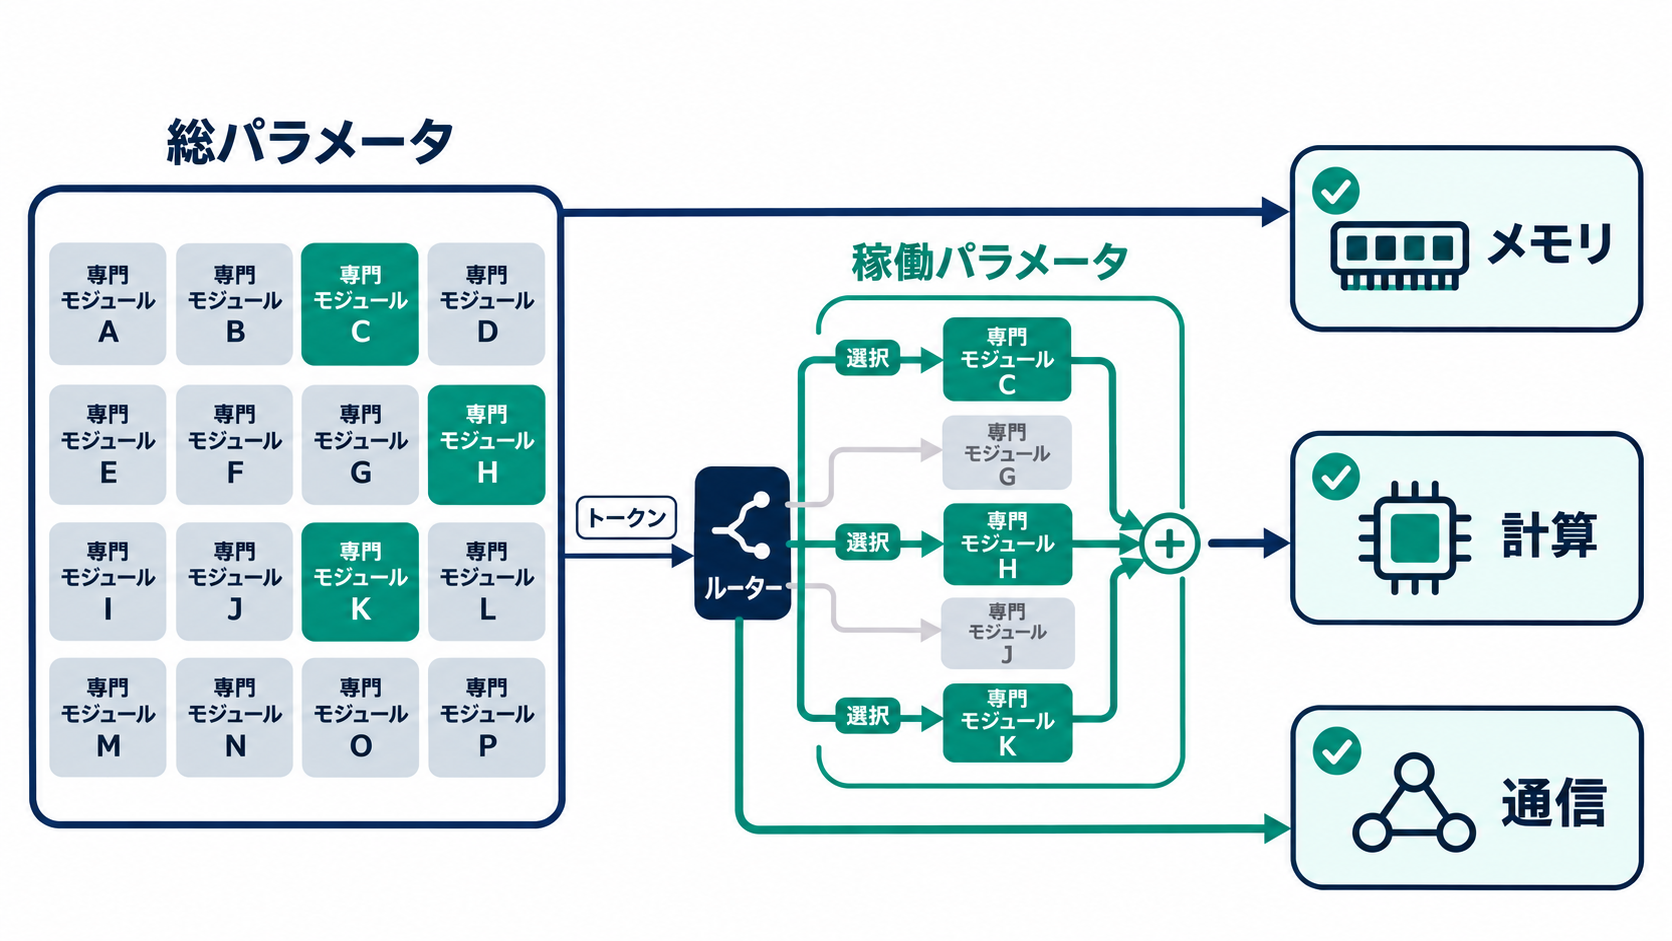
生成AIモデルの導入候補を絞る際、「総パラメータ数は大きいものの、推論時に動く部分は小さい」という説明は魅力的に映ります。ところが、稼働パラメータ数が近いモデルでも、必要なGPUメモリやGPU間の通信、応答時間まで同じになるわけではありません。複数の専門ネットワークを使い分けるMoE(Mixture-of-Experts)では、入力をどの専門ネットワークへ振り分けるかという設計が、運用条件を左右します。
MarkTechPostが2026年11月8日に掲載した比較では、10モデルのエキスパート数、入力ごとの選択数、共有エキスパート、スコア計算、負荷分散の違いが整理されています。比較対象の総パラメータ数は350億から1.6兆、稼働パラメータ数は30億から490億まで広がります。ただし、企業が注目したいのは規模の順位よりも、その数字がどのような処理構成から生まれているかという点です。
今回の比較対象は、入力を分割した単位であるトークンごとに、処理先のエキスパートを選ぶ方式を採っています。この振り分け役がルーターです。同じMoEでも、128個から1個を選ぶ設計と、384個から8個を選ぶ設計では、読み込む重みの総量や処理先の広がりが異なります。すべてのトークンが通る共有エキスパートの有無も、計算量を変える要素になります。
そのため、モデル名に含まれる「A3B」や仕様表の「17B active」といった表記は、導入検討の入口として扱うのが適切でしょう。必要な設備を判断するには、重みを保持する容量、実際に使う計算量、分散実行時の通信を分けて確認する必要があります。MoEの比較は、この三つを読み分けるところから始まります。
10モデルを分けるエキスパート数と選択数
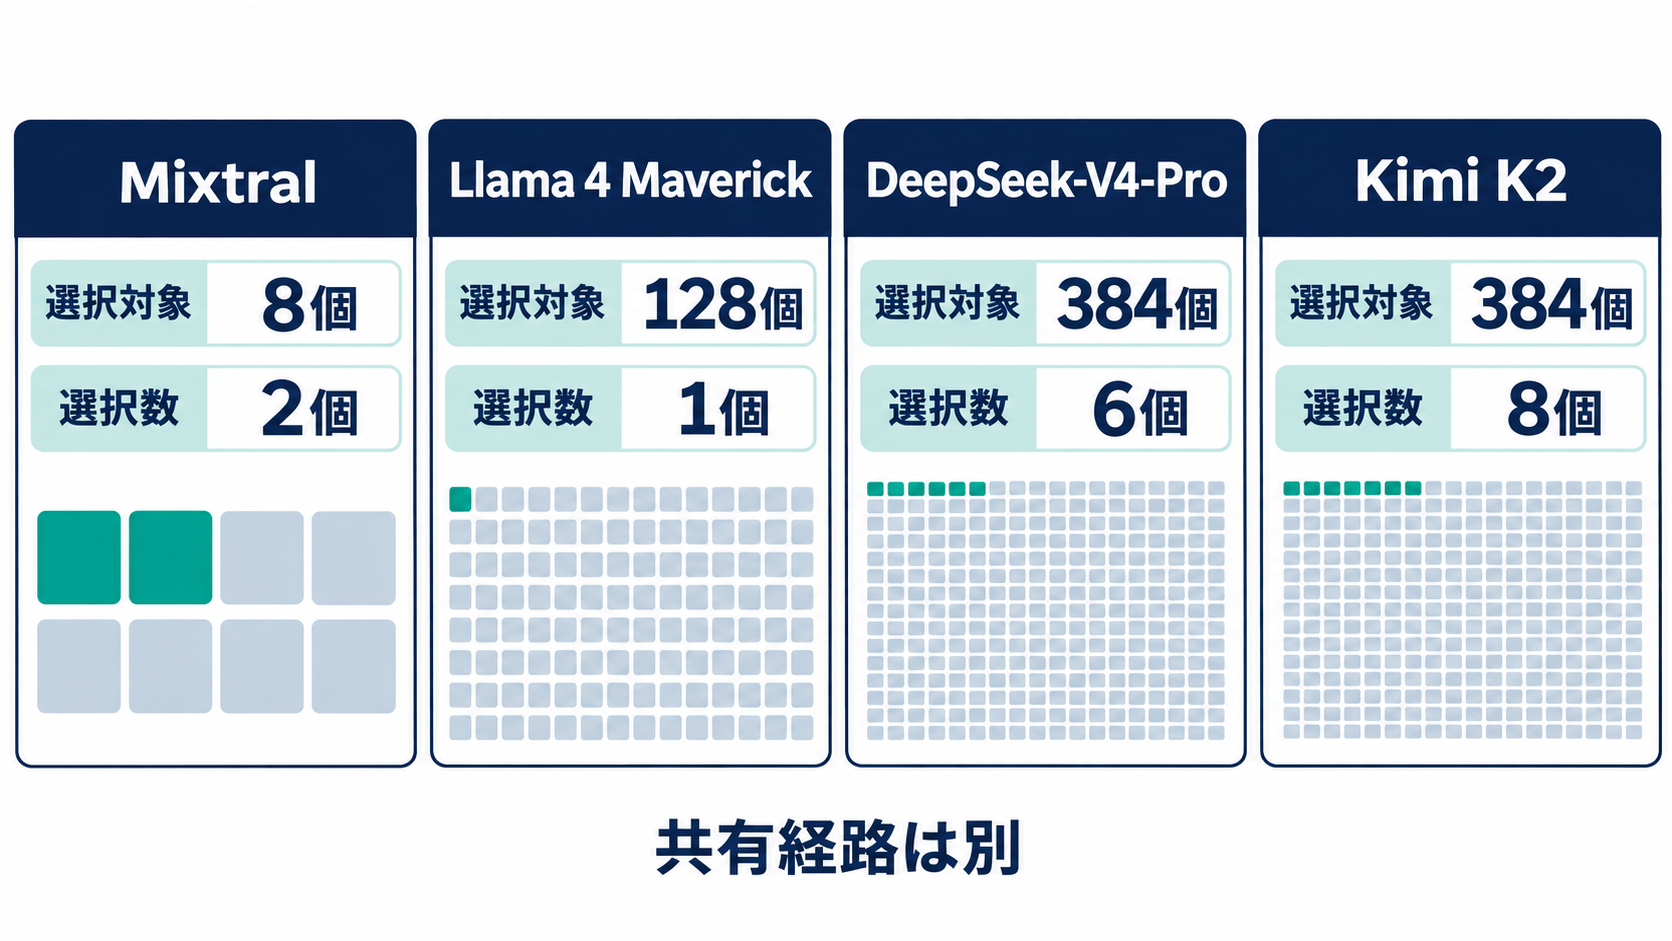
MoEの仕様を読むうえで、最初に押さえたいのが「ルーティング対象のエキスパート数」と「top-k」の組み合わせです。top-kは、一つのトークンに対して選択するエキスパートの数を表します。共有エキスパートがある場合は、この選択とは別に常時動く経路が加わります。MarkTechPostが11月7日確認としてまとめた構成は、次のとおりです。
| モデル | 総パラメータ数/稼働数 | 選択対象数 | top-k | 共有数 |
| --- | --- | --- | --- | --- |
| Mixtral 8x7B | 470億/130億 | 8 | 2 | 0 |
| gpt-oss-120b | 1,170億/51億 | 128 | 4 | 0 |
| Qwen3-235B-A22B | 2,350億/220億 | 128 | 8 | 0 |
| Qwen3.6-35B-A3B | 350億/30億 | 256 | 8 | 1 |
| Llama 4 Maverick | 4,000億/170億 | 128 | 1 | 1 |
| DeepSeek-V3 | 6,710億/370億 | 256 | 8 | 1 |
| DeepSeek-V4-Pro | 1.6兆/490億 | 384 | 6 | 1 |
| DeepSeek-V4-Flash | 2,840億/130億 | 256 | 6 | 1 |
| Kimi K2 | 1.04兆/320億 | 384 | 8 | 1 |
| GLM-4.5 | 3,550億/320億 | 160 | 8 | 1 |
選択対象数をtop-kで割ると、ルーティング部分の疎さを比較できます。Mixtralは8÷2で4倍、Llama 4 Maverickは128÷1で128倍です。ただし、この倍率はモデル全体の速度向上率ではありません。共有エキスパートや、それ以外の常時動く部分の計算を含んでいないためです。エキスパートの大きさや層数も異なるため、倍率だけで性能や費用を順位付けすることはできません。
この違いは、同じ稼働パラメータ数を持つモデルの比較でも表れます。Kimi K2とGLM-4.5はいずれも320億稼働とされていますが、選択対象はそれぞれ384個と160個です。どちらもtop-8であっても、保持する重みや層の構成まで同じではありません。仕様表では、総数と稼働数の二列に加え、選択対象数、top-k、共有経路を一組として確認すると、比較の前提をそろえやすくなります。
DeepSeekの変更点は「選び方」と「配り方」にあります
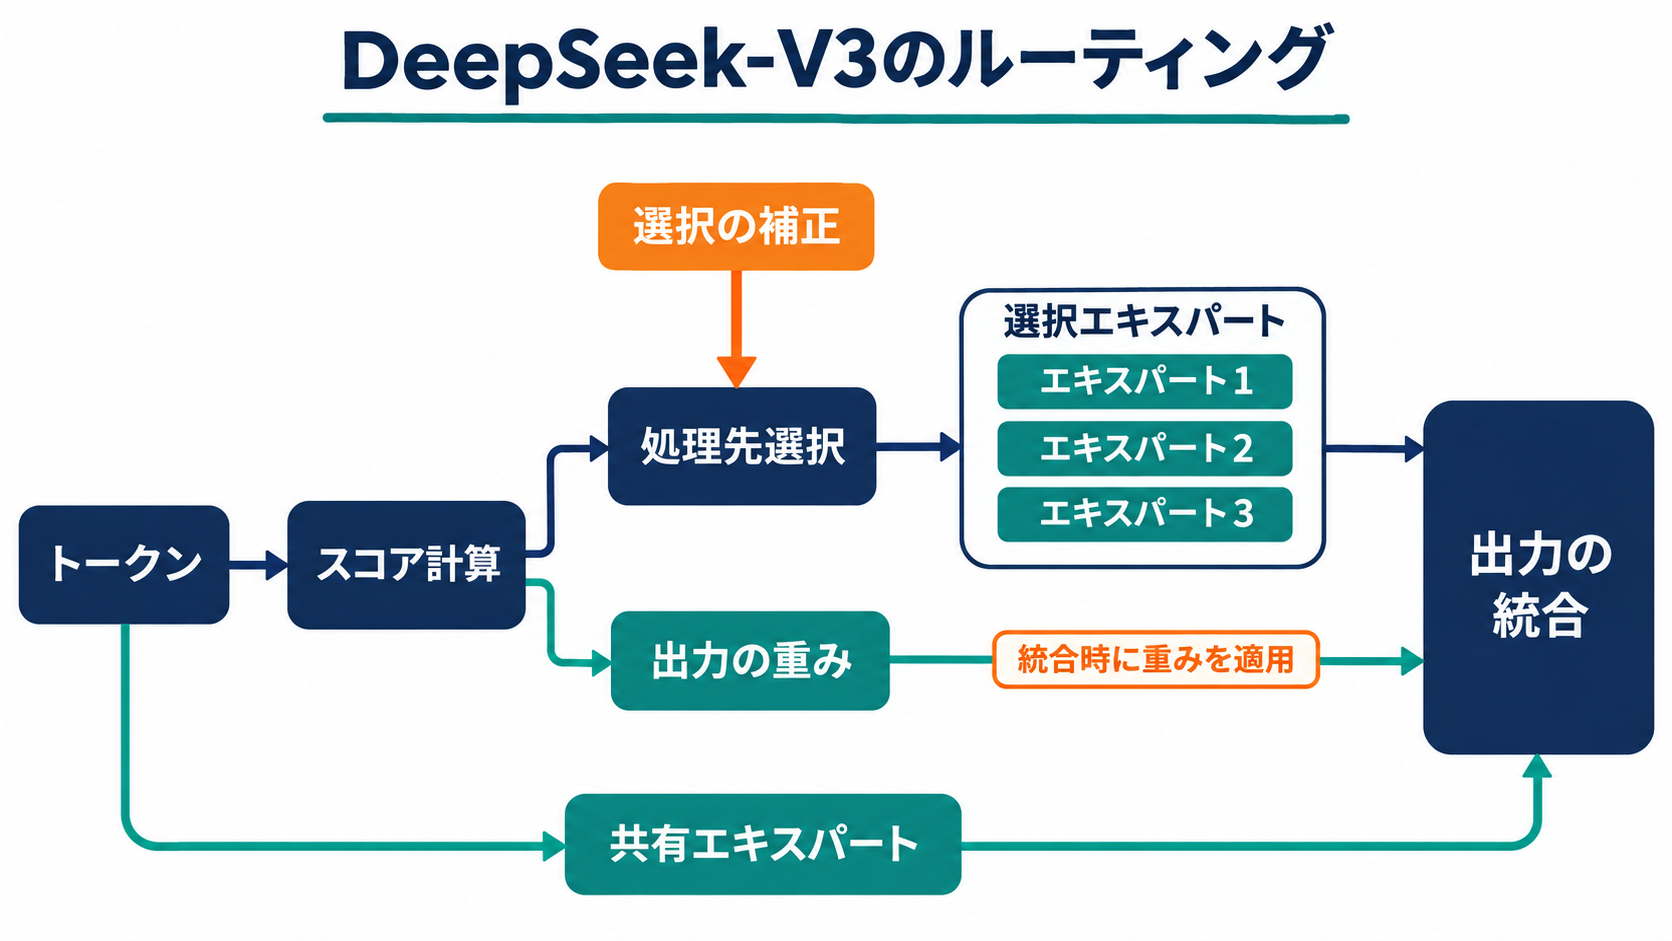
DeepSeek-V3は、256個のルーティング対象エキスパートに対してsigmoidという関数でスコアを計算し、そのうち8個を選びます。選択後のスコアは正規化され、各エキスパートの出力を混ぜ合わせる重みに使われます。これとは別に、すべてのトークンを処理する共有エキスパートが一つあります。ここで注目したいのは、処理先を選ぶための調整と、出力を混ぜる重みを分けている点です。
特定のエキスパートに処理が集中すると、ほかに余力があっても全体の待ち時間が増えかねません。DeepSeek-V3はエキスパートごとのバイアス、つまり選択を促したり抑えたりする補正値を使って、top-8の選択を調整します。この補正は、出力を混ぜ合わせる重みには直接反映させない設計です。比較で使われる「noaux_tc」は、このバイアスによる負荷分散に関係するルーティング方式の識別名です。
通信範囲を抑える工夫もあります。DeepSeek-V3ではエキスパートを8グループに分け、先に4グループへ絞り込みます。技術報告によると、各トークンが到達する計算ノードは最大4台です。分散推論では計算を速くするだけでなく、処理先が広がりすぎないようにすることも運用上の焦点になります。
DeepSeek-V4-Proでは、選択対象を384個に増やしながら、top-kを8から6へ減らしています。V4-Flashもtop-6です。スコア関数はsqrtsoftplusに変わり、最初の3つのMoE層には、トークンと処理先を固定的に対応付けるハッシュルーティングが導入されています。バイアスに基づく負荷分散は維持されます。候補数の増加と選択数の削減が同時に進んでいるため、世代更新を単純な大規模化として捉えると、実行時の違いを見落とすでしょう。
Qwen、Llama、Kimiは異なる構成を選んでいます
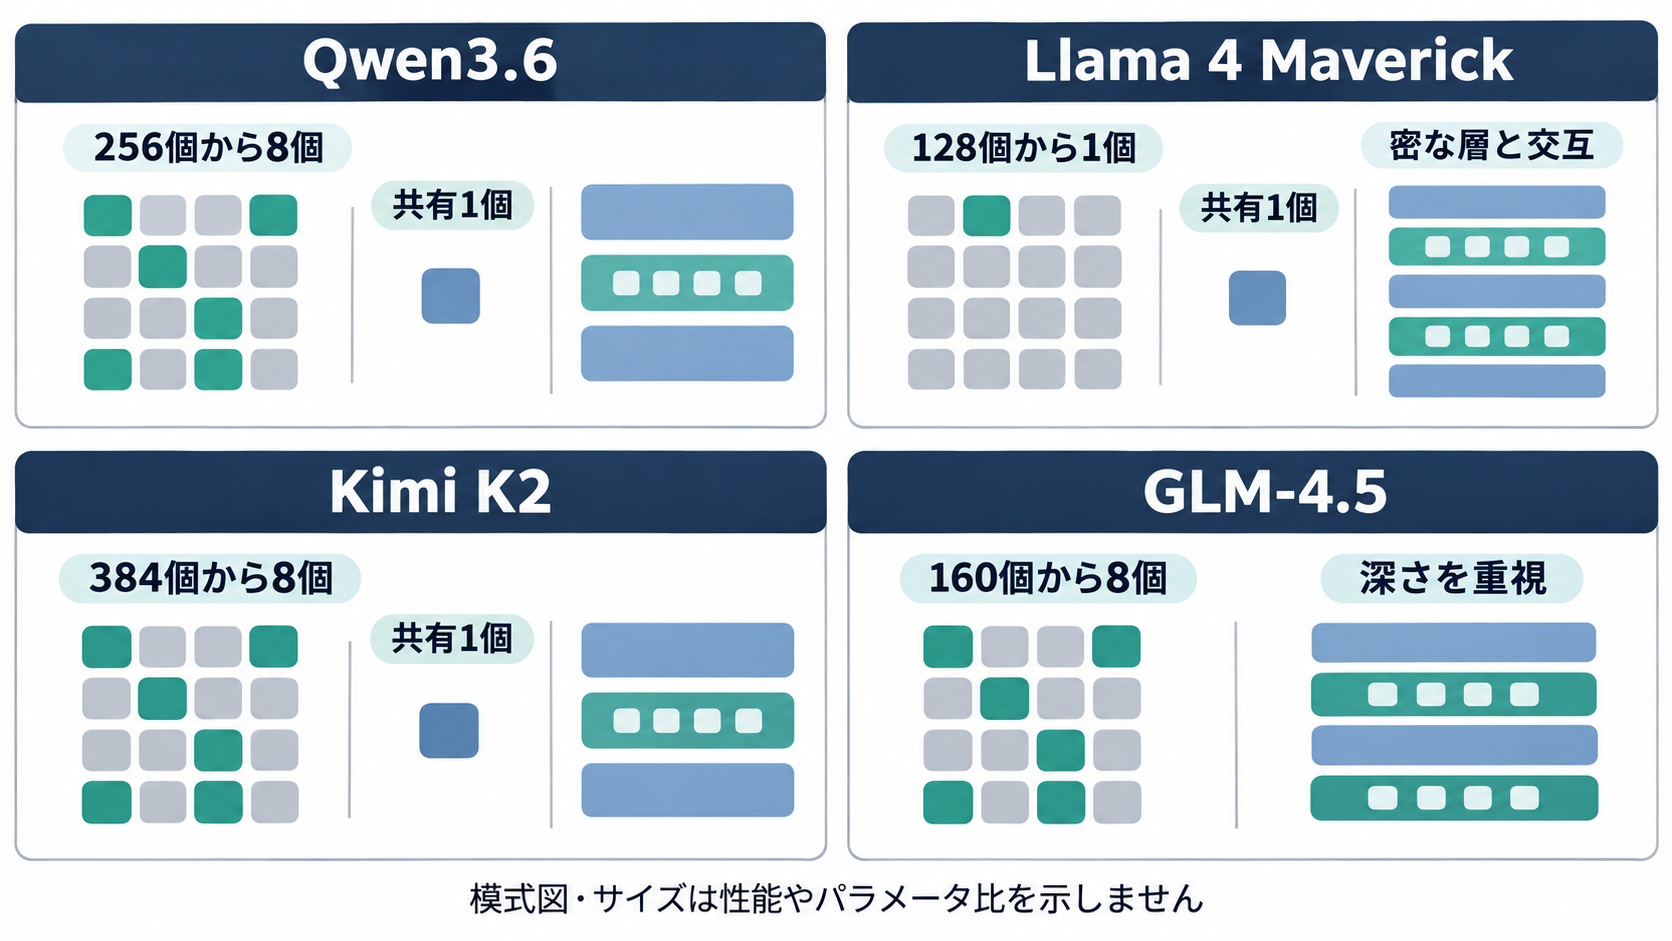
Qwenの構成を見ると、同じモデル系列でも共有エキスパートの扱いが変わることが分かります。当初のQwen3 MoEは128個から8個を選び、Qwen2.5-MoEにあった共有エキスパートを取り除きました。負荷分散には、学習時の大きな処理単位全体を対象とするグローバルバッチの補助損失を採用しています。ところがQwen3.6-35B-A3Bでは、選択対象が256個へ増え、top-8に共有エキスパート一つを加えた構成へ変わっています。
Llama 4 Maverickは、通常の密な層とMoE層を交互に配置します。MoE層で各トークンが通るのは、共有エキスパート一つと、128個から選ぶ一つです。このtop-1構成は、少数の処理先へ振り分けるMoE設計であるSwitch Transformerと共通する考え方です。総パラメータ数4,000億に対して稼働数170億という差は、こうした層構成と選択経路を伴う数字として読む必要があります。
Kimi K2は、実装上のアーキテクチャ識別子としてDeepseekV3ForCausalLMを使い、noaux_tcルーターを採用しています。top-8を維持しつつ選択対象を384個へ増やし、系列単位の補助損失も組み合わせています。技術報告では、疎さを8から48へ高めた比較で、同じ検証損失に達するための浮動小数点演算量が約1.69分の1になったとしています。ただし、これは報告された比較条件での結果であり、業務推論の速度や請求額へそのまま換算できる数字ではありません。
GLM-4.5は、選択対象を160個とし、より多くの層を持たせる方向を選んでいます。Kimi K2がエキスパート数を広げるのに対し、GLM-4.5は深さを重視した構成です。企業の評価では、ルーティング方式の類似性だけで候補をまとめず、自社の質問や文書で得られる回答品質も確認したいところです。構造が近くても、業務上の成果まで同じになるとは限りません。
GPU設計ではメモリ、計算、通信を分けて見ます
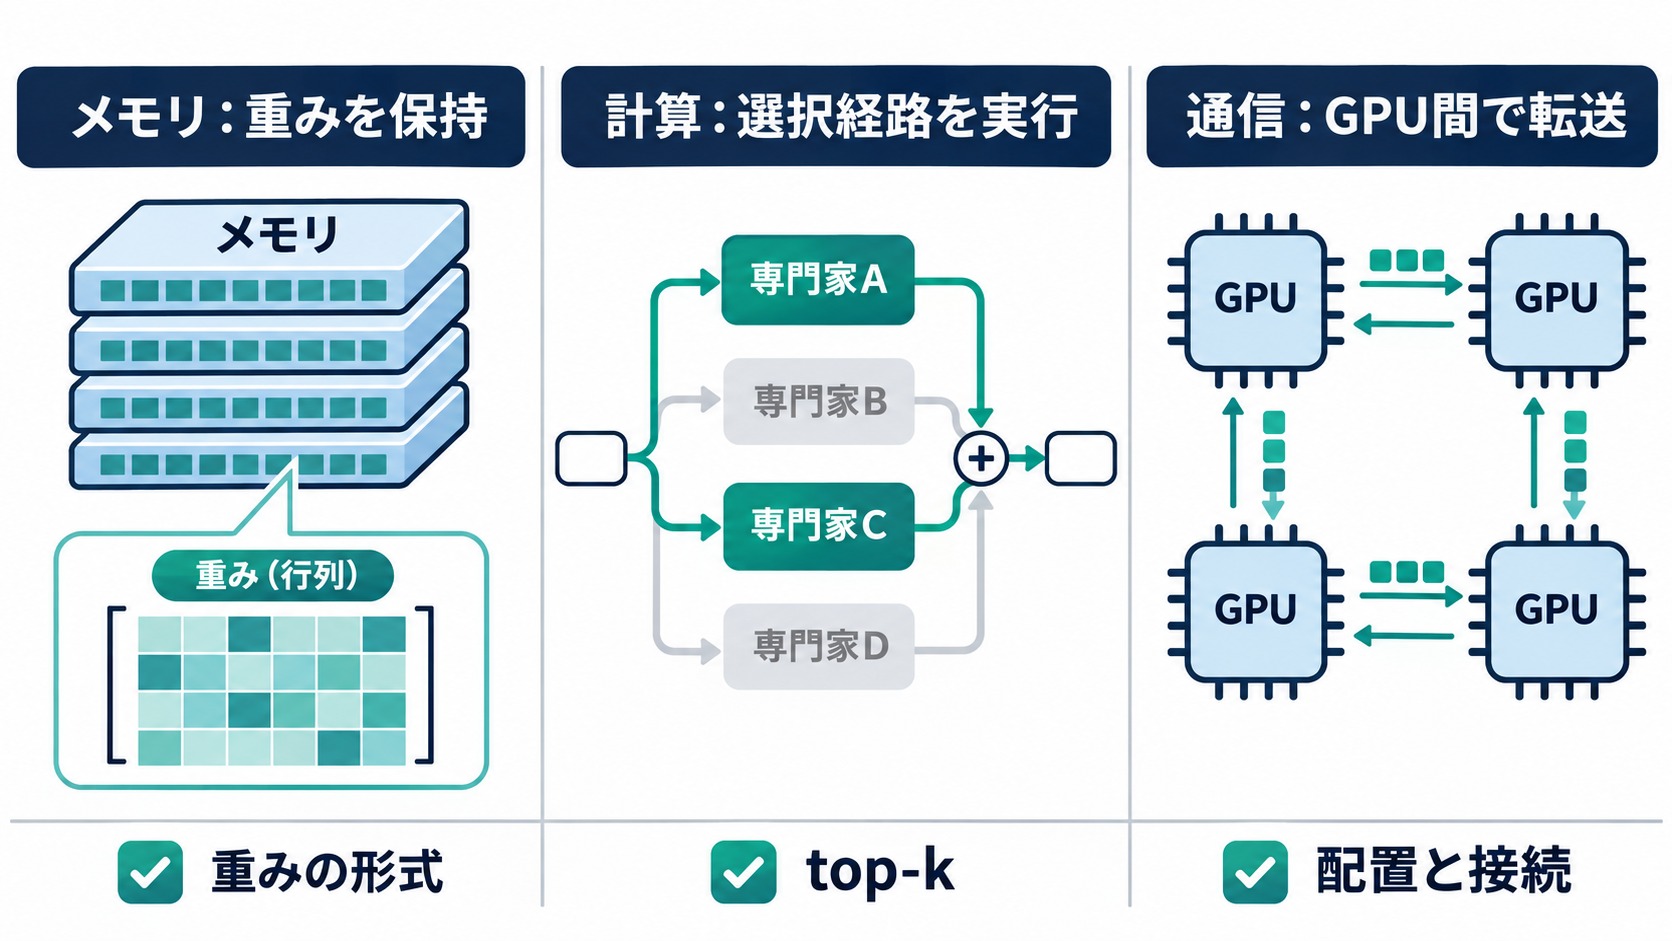
MoEの設備見積もりで混同しやすいのが、重みを保持するためのメモリと、トークンごとの計算量です。あるトークンが使わないエキスパートでも、後続のトークンが使う可能性があります。したがって、稼働パラメータ数が小さいという理由だけで、モデル全体の重みを置く容量も小さく済むとは判断できません。選択対象の増加は、保持する重みの増加につながります。
gpt-oss-120bは128個から4個を選ぶ線形ルーターを使い、設定上は共有エキスパートを持ちません。MoEの重みにはMXFP4という低ビットの数値形式を用いており、比較では総パラメータ数1,170億のモデルを80GB GPU一台に収められるとされています。この条件には、ルーティングだけでなく重みの保存形式も関わっています。稼働数51億という値だけで、一台に収まる理由を説明することはできません。
DeepSeek-V4-ProやKimi K2では、複数GPUにエキスパートを分散配置するエキスパート並列が必要とされています。処理先が別のGPUにある場合、トークンの情報を送り、結果を集める通信が発生します。複数のGPUが互いにデータをやり取りするall-to-all通信は、この分散実行で意識したい要素です。top-kを下げる設計は、ほかの条件が同じなら、トークンごとの計算や通信を減らす方向に働きます。
ただし、重みがメモリに収まることと、想定した利用人数で安定して応答できることは別の確認事項です。実運用では入力の長さ、生成する長さ、同時処理数によって、追加のメモリや処理時間が変わります。GPU候補を決める際は、重みの形式と配置を確認したうえで、業務に近い条件の測定へ進むとよいでしょう。稼働数を比較する段階から一歩進み、どこで待ち時間が発生するかを確かめることが必要です。
企業の選定は設定確認と業務テストをつなぎます
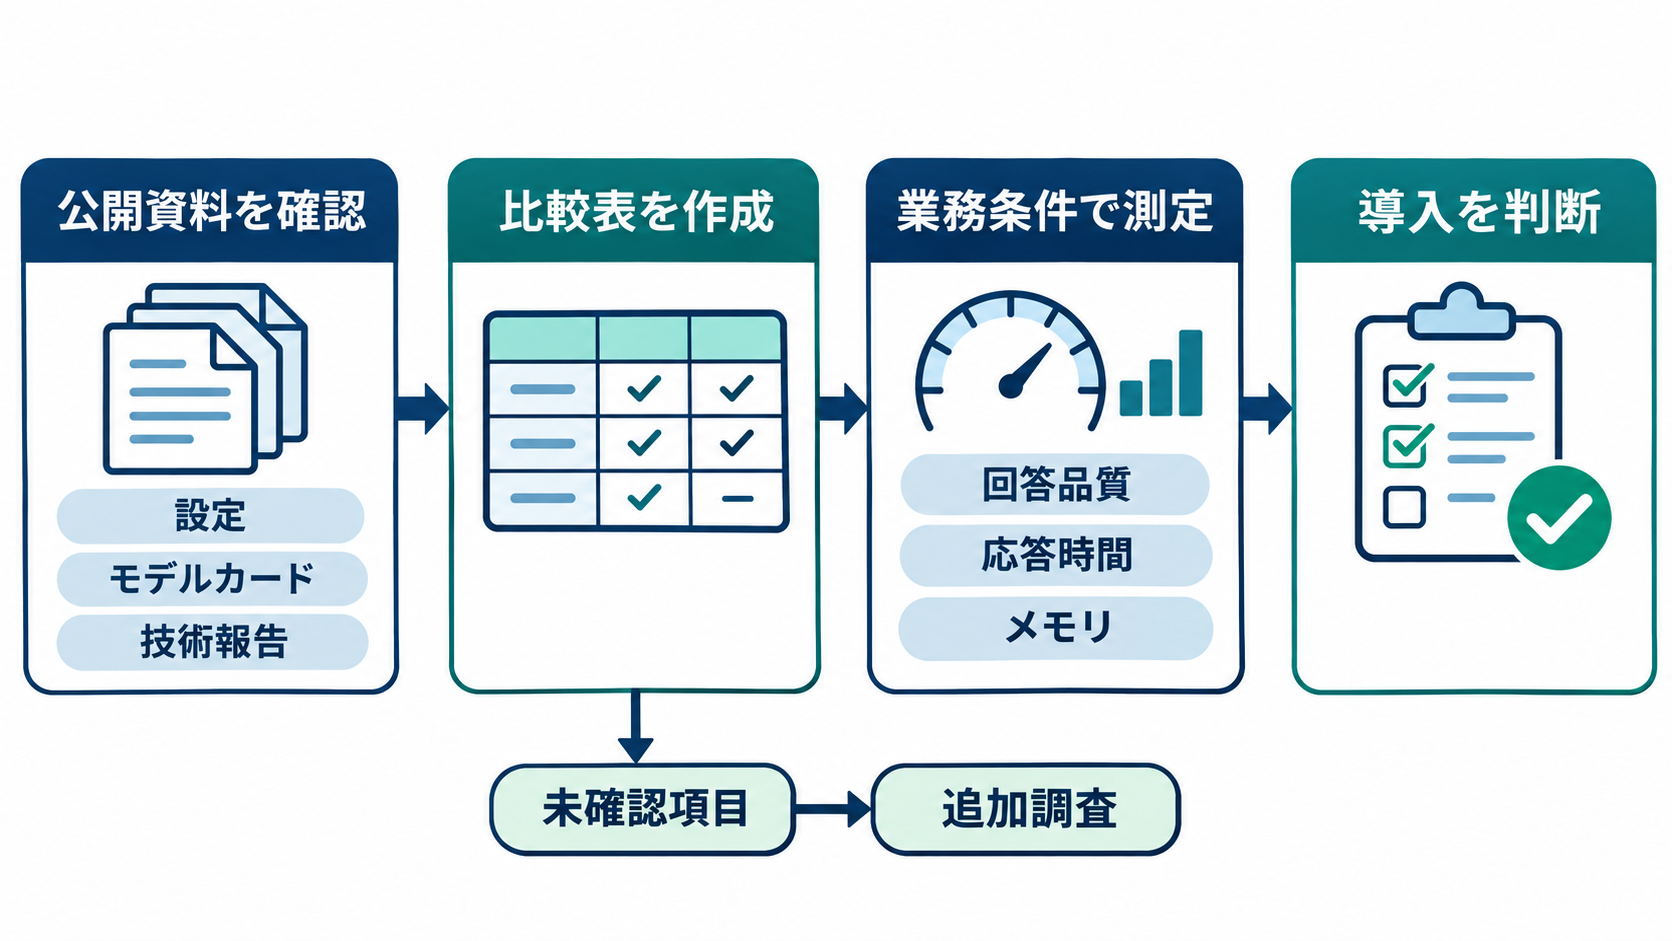
公開された設定ファイルは、MoEの構造を調べる有力な入口になります。Hugging Faceは、モデルや関連ファイルを共有するプラットフォームです。そこで公開されるconfig.jsonには、エキスパート数やtop-kなどが記載されることがあります。ただし、一つのファイルだけで設計の全体像を確認できるとは限りません。モデルの説明資料であるモデルカードや技術報告も合わせて読む必要があります。
今回の比較では、Qwen3.6とLlama 4の設定・モデルカードにはスコア計算方式の記載がなく、gpt-ossとLlama 4の設定ファイルでは負荷分散方式を確認できないとされています。この違いは、方式が存在しないことを意味しません。公開資料のどこまでで確認できるかという情報の範囲を示します。検証記録には、確認した仕様と資料上で確認できなかった項目を分けて残すと、後の比較がしやすくなるでしょう。
負荷分散の方式も、名前だけで優劣を決める対象ではありません。MixtralやQwen3のように補助損失を使う方法は、学習時にエキスパートの利用が偏りすぎないよう促します。DeepSeek系のバイアスを使う方法は、処理先の選択を補正して配分を調整します。設計意図を理解したうえで、実際の入力に対して処理が偏らないか、混雑時に応答が遅くならないかを測ることが企業側の確認になります。
社内文書の検索支援や問い合わせ対応を想定するなら、評価用の入力には実際に近い長さと種類の日本語文書を用意します。そのうえで、回答品質、応答時間、処理量、GPUメモリ使用量を同じ条件で記録する進め方が考えられます。共有エキスパートやtop-kの違いは、こうした測定結果を理解する手掛かりになるはずです。
次の選定会議には、候補モデルの総数と稼働数だけでなく、エキスパート数、top-k、共有数、重みの形式、必要なGPU構成を並べた比較表を持ち込むとよいでしょう。公開資料で埋まらない欄は、そのまま実測や追加調査の確認項目にできます。仕様の読み取りを具体的な検証条件につなげることで、導入判断に使える比較へ近づけられます。