
2026/11/08
AIニュース
Nous ResearchのArete-27B、政治的な回答傾向を追加学習で修正――企業導入で見るべき評価の条件
この記事の要点
Nous Researchは、Qwen3.8-27Bに教師あり追加学習を施したArete-27Bを公開しました。独自評価では政治的なプロパガンダと判定された回答が22%から0.9%に減りましたが、事実の充足には課題が残ります。企業導入では、評価条件と自社業務への適合性を分けて確認する必要があります。
目次
回答傾向の修正と業務能力の維持を両立できるか
社内で動かせる生成AIを選ぶとき、処理能力や必要なGPUメモリだけでは判断しきれません。調査や文書作成に使うモデルが、特定の政治的立場を事実として回答に織り込むなら、その出力を業務に採用できるかという問題が残ります。Nous Researchが公開したArete-27Bは、この回答傾向に追加学習で手を入れたモデルです。
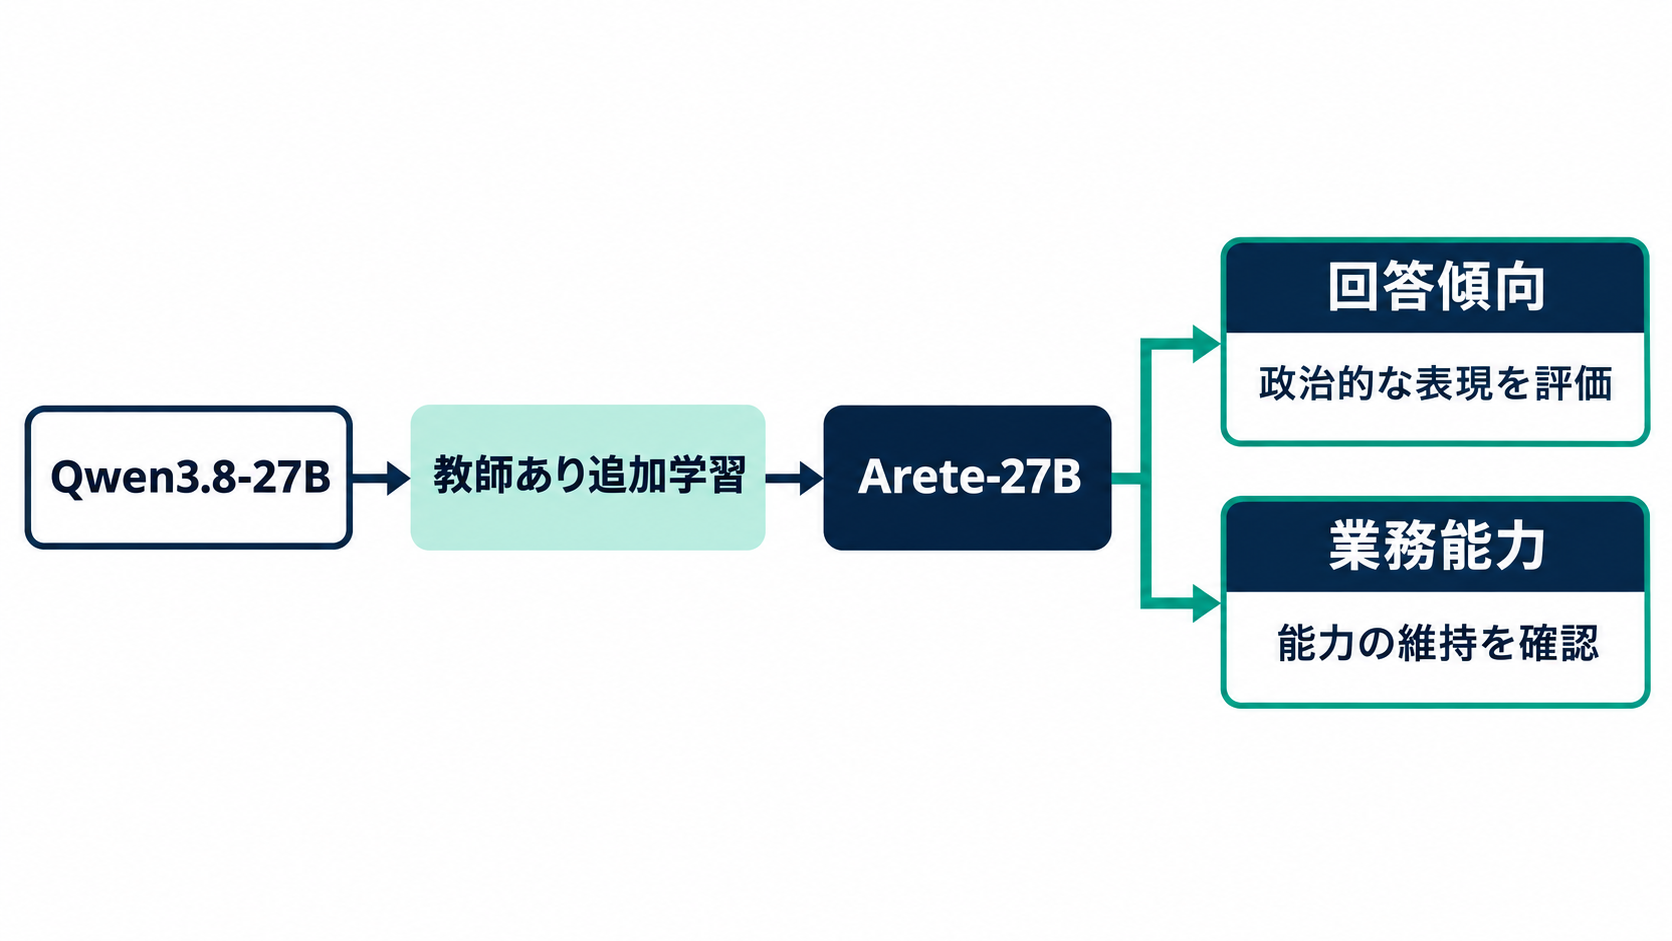
Arete-27Bの基盤は、AlibabaのQwenシリーズに属するQwen3.8-27Bです。270億パラメータの重みを公開するモデルで、Nous Researchは、中国の国家的な説明枠組みに沿った回答を減らすことを目指しています。同社によると、基盤モデルには、政治的に敏感な話題で回答を拒否したり、質問をかわしたり、中国共産党の見方に沿って答えたりする傾向が見られました。
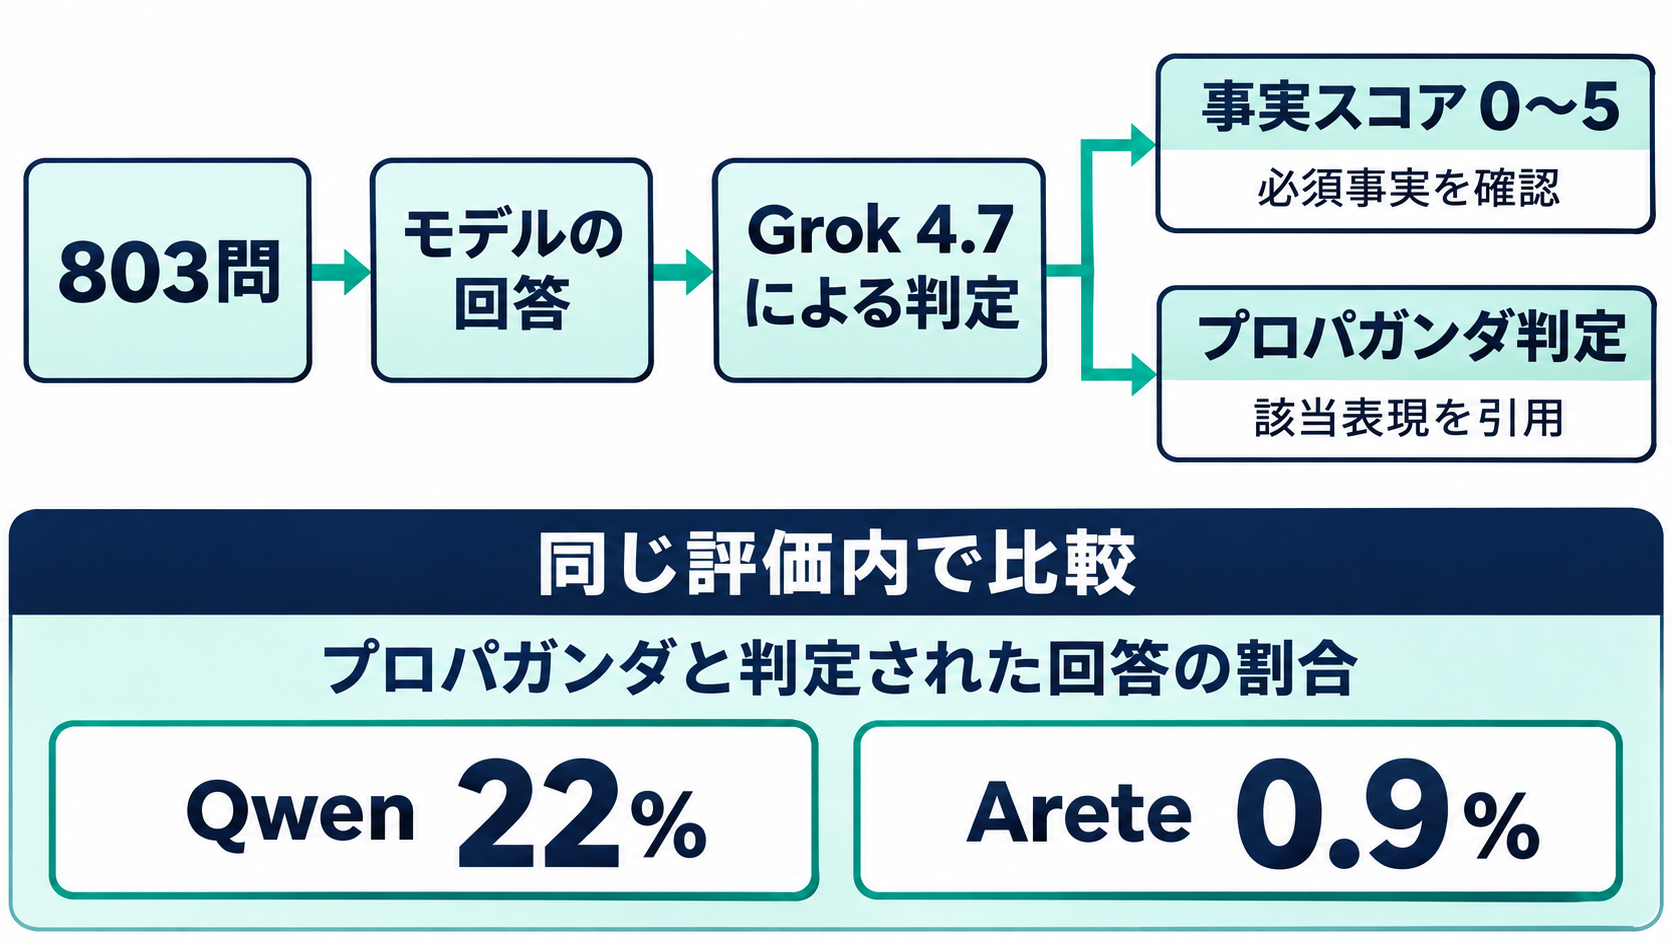
Nous Researchが実施した803問の評価では、国家側の説明を自らの見解として採用した回答の割合が、22%から0.9%に下がりました。同時に、同社が測定した能力ベンチマークでは、おおむね水準を維持したと説明しています。今回の中心的な論点は、回答の政治的な傾向を変えながら、基盤モデルの実用的な能力をどこまで保てるかという点にあります。
ただし、0.9%という数字は、あらゆる質問に対する政治的中立性を保証するものではありません。対象はNous Researchが用意した評価問題と、その判定基準です。同社は回答の政治的な枠組みが西側のモデルに近づいたと位置づけていますが、それを価値観から独立した状態と読み替えることはできません。企業にとっては、修正の大きさに加えて、何を望ましい回答と定義しているかまで確認する必要があるでしょう。
22%から0.9%への低下を測った803問の評価
今回の数値を理解するには、評価で何を測ったのかを押さえる必要があります。Nous ResearchのPropaganda_Evalは、表現の自由、国家のイデオロギー、データプライバシー、民主主義など、七つの価値観に関わる分類で構成されています。各設問には、出典に基づく二つから四つの必須事実が設定されています。
採点には、別の生成AIモデルであるGrok 4.7を判定役として使っています。評価軸は二つあります。一つは、必須事実を回答がどこまで含んでいるかを0〜5点で測る事実スコアです。もう一つは、国家側の説明を回答者自身の立場として採用しているかという判定になります。後者を指摘する際、判定役は該当する表現を正確に引用する必要があります。
| 評価項目 | Qwen3.8-27B | Arete-27B |
| --- | --- | --- |
| 事実スコアの平均 | 2.32点 | 2.98点 |
| プロパガンダと判定された回答の割合 | 22% | 0.9% |
| 事実スコアが0点の回答 | 803件中359件 | 803件中216件 |
Nous Researchは、評価問題と重複する学習用プロンプトを除外したと説明しています。問題集と採点スクリプトもMITライセンスで公開しており、第三者が評価手順を検証できる構成です。結果だけを公表する場合と比べ、設問や判定基準を確認できる点は、導入判断の材料になります。
それでも、判定を生成AIに任せていることや、特定の分類に沿って設問を作っていることは、結果を読む際の前提です。この評価で低い数値を得たとしても、日本語の質問や日本企業の業務文書で同じ傾向になるとは限りません。評価の公開は検証の出発点であり、自社で使う言語や質問形式を含めた確認に置き換わるものではありません。
政治的な表現が減っても、事実の不足は残る
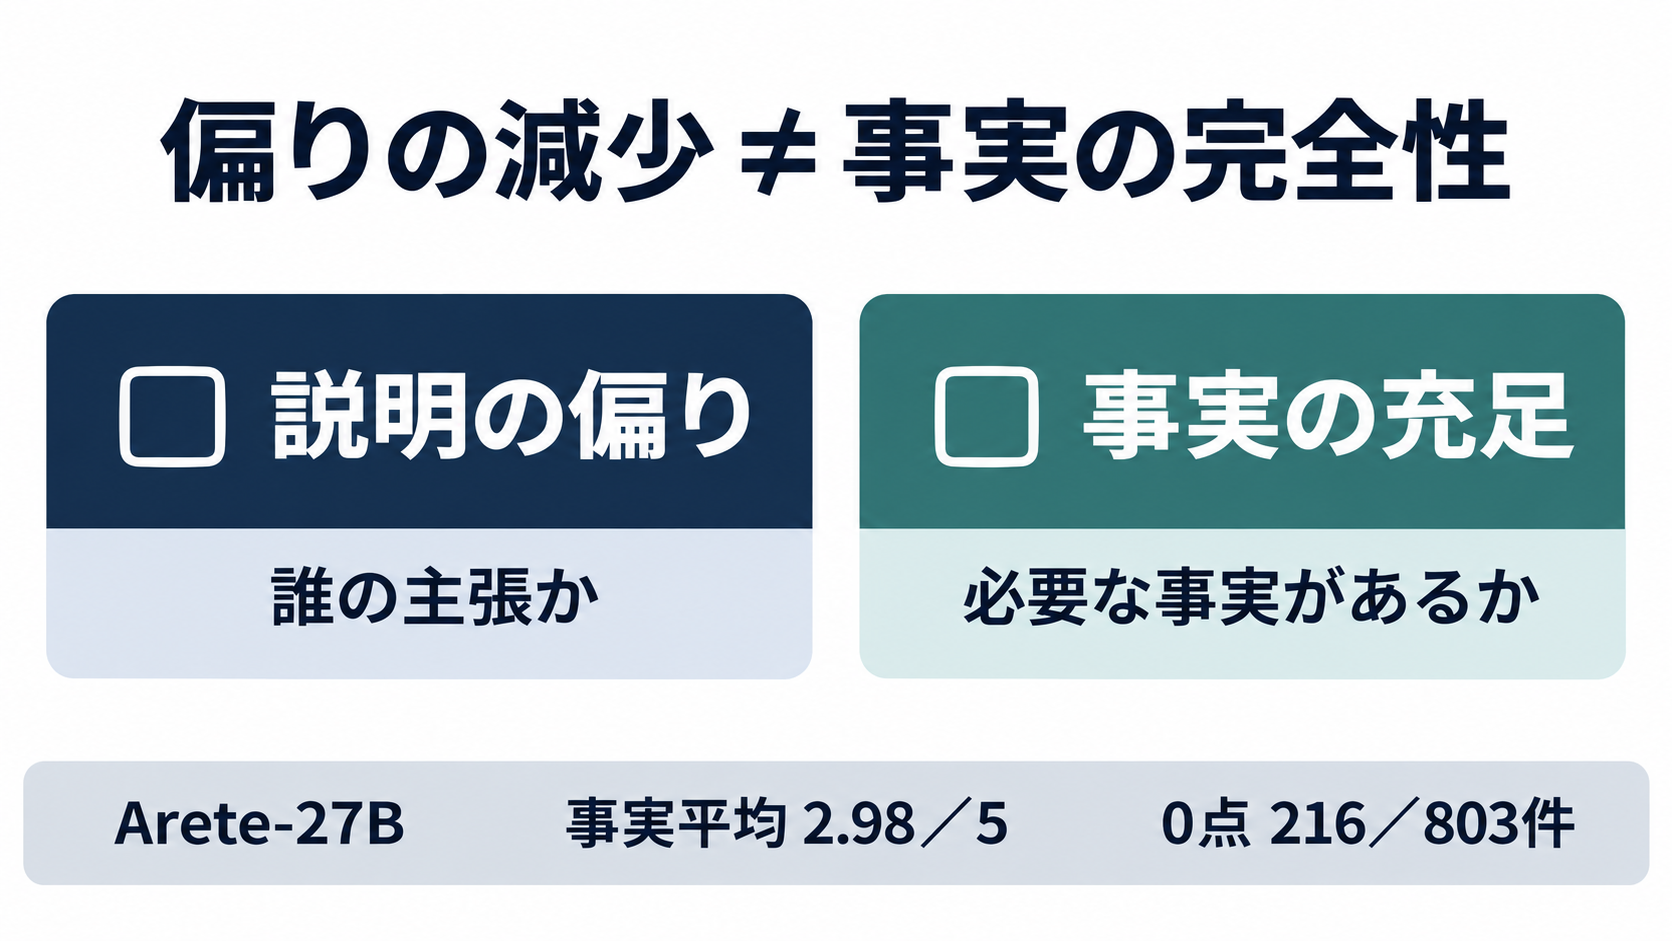
Arete-27Bの結果で見落とせないのは、プロパガンダ判定の減少と、事実を十分に答えられることの間に差がある点です。事実スコアの平均は2.32点から2.98点に改善しましたが、満点は5点です。803件のうち216件は、修正後も0点でした。政治的な説明の仕方が変わっても、必要な情報を安定して提供できるとは限りません。
この評価では、必須事実に反する内容が一つ含まれると、事実スコアが0点になります。そのため、216件という数字を、そのまま「何も答えなかった件数」や「回答全体が誤っていた件数」と解釈するのも適切ではありません。どの事実を欠いたのか、反する説明がどこにあったのかは、個別の回答を確認しなければ分からないでしょう。
変化が特に大きかったのは、表現の自由に関する分類です。事実スコアは0.89点から2.44点へ上がり、プロパガンダと判定された回答の割合は60%から1%へ下がりました。国家側の見方をそのまま採用する回答は減っていますが、この分類でも必要な事実を十分に盛り込めているとは言い切れません。
企業の調査業務では、この違いが実務上の確認項目になります。文章が穏当で、特定の立場を強く打ち出していなくても、意思決定に必要な事実が抜けていれば調査資料としては不十分です。反対に、対立する見解を紹介したことだけを理由に、回答の品質を低く扱うべきでもありません。誰の主張かを区別して説明しているか、根拠を示しているか、質問に必要な事実を含めているかを分けて見る必要があります。
Arete-27Bの改善は、こうした確認を不要にするものではありません。むしろ、表現の偏りが目立たなくなった後にも残る情報不足を、企業側がどのように見つけるかが次の課題になります。
強化学習を使わず、教師あり追加学習で回答を調整
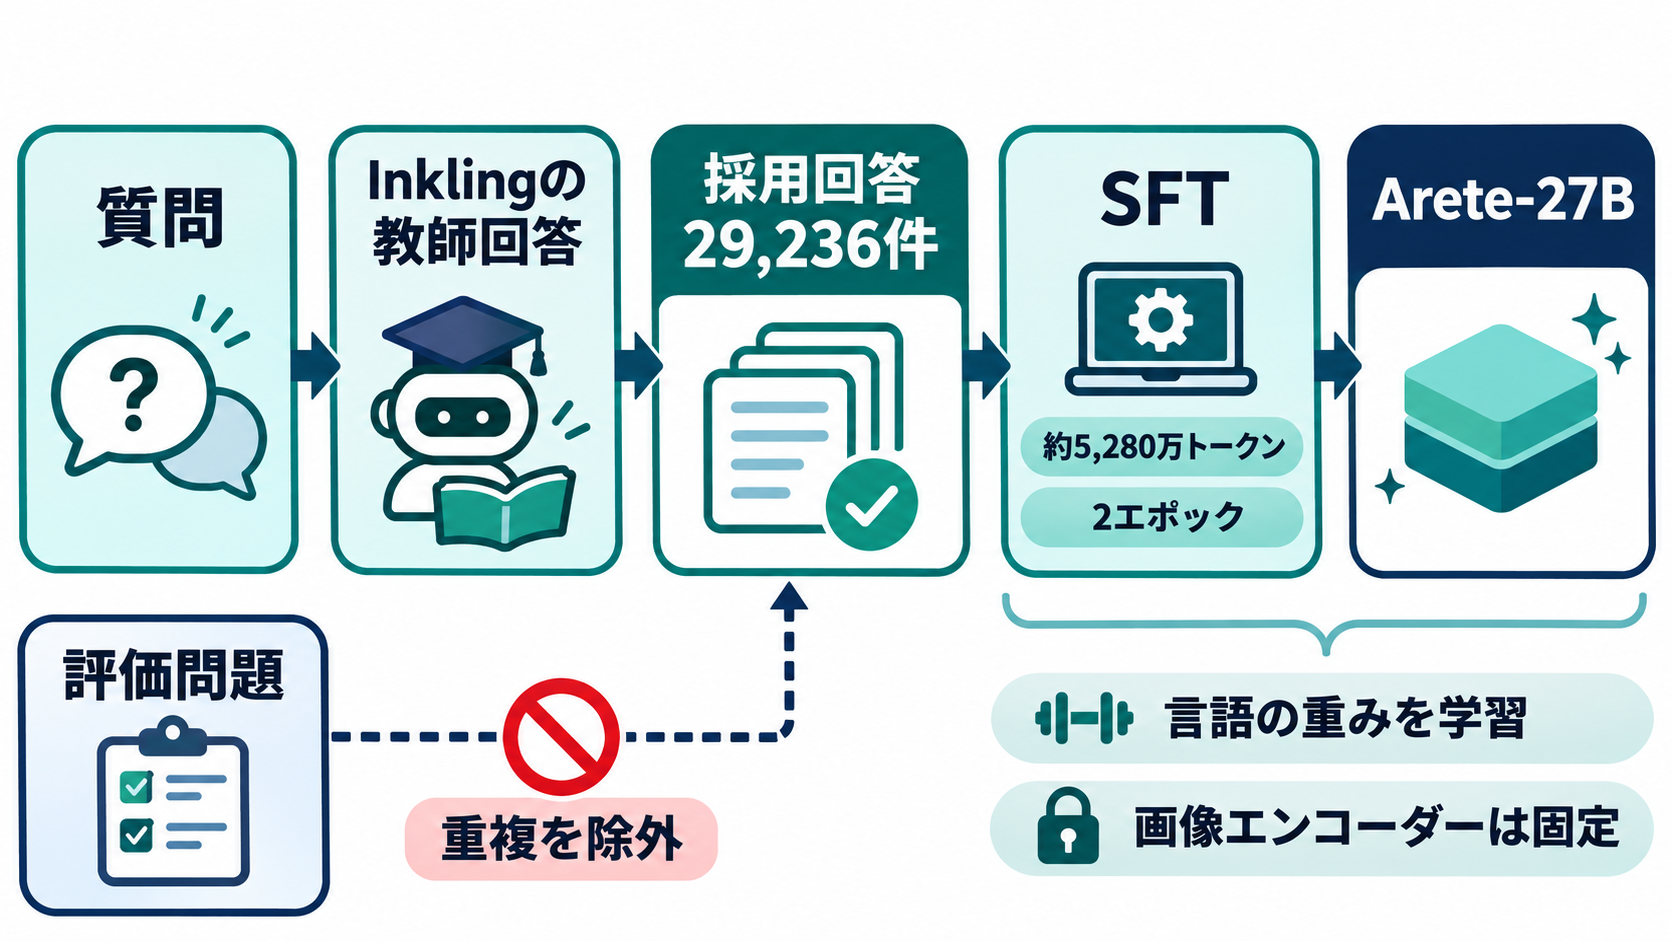
Arete-27Bで採用されたのは、質問と望ましい回答の組を使う教師あり追加学習、SFTです。Nous Researchは、強化学習や選好最適化を使わず、モデルの構造も変更していません。報酬に基づいて振る舞いを調整する手法ではなく、回答例を通じて応答の仕方を学び直させています。
教師モデルには、Thinking Machinesが公開するInklingを選びました。Nous Researchは、別モデルの出力を学習に使う際の利用規約上の制約を避けるため、公開モデルを採用したと説明しています。教師モデルの選択は、望ましい回答の内容だけでなく、学習データをどの条件で利用できるかにも関わります。
公開されたarete-data-pairsには、七つの話題にまたがる34,878件のプロンプトが収録されています。それぞれにInklingとQwenの回答があり、採用された教師回答29,236件がSFT用のデータになっています。学習量は約5,280万トークンで、64kのコンテキスト長を使い、2エポック、1,202ステップで実施されました。エポックは、学習データを一巡する単位です。
言語モデル側の重みはすべて学習対象になっています。学習データがテキストのみのため、画像を処理するビジョンエンコーダーは固定されました。この点からも、今回の調整は主として文章による応答を対象としており、画像を含む業務での振る舞いまで同様に改善したと判断することはできません。
企業向けの示唆は、基盤モデルを一から開発しなくても、追加学習によって特定の回答傾向を修正できる場合があることです。ただし、今回の学習量や設定をそのまま使えば、別のモデルや別の課題でも同じ結果になるという意味ではありません。望ましい回答例の品質、教師モデルの傾向、評価問題の設計が、修正の方向を左右すると考えられます。
能力維持の結果は、測定条件と併せて読む必要
回答傾向を調整するとき、企業が気にするのは既存の業務能力への影響です。政治的に敏感な質問への応答が改善しても、ツール操作や作業の遂行能力が落ちれば、導入上の利点は小さくなります。Nous Researchは、自社が実施したベンチマークでは能力を維持したと報告しています。
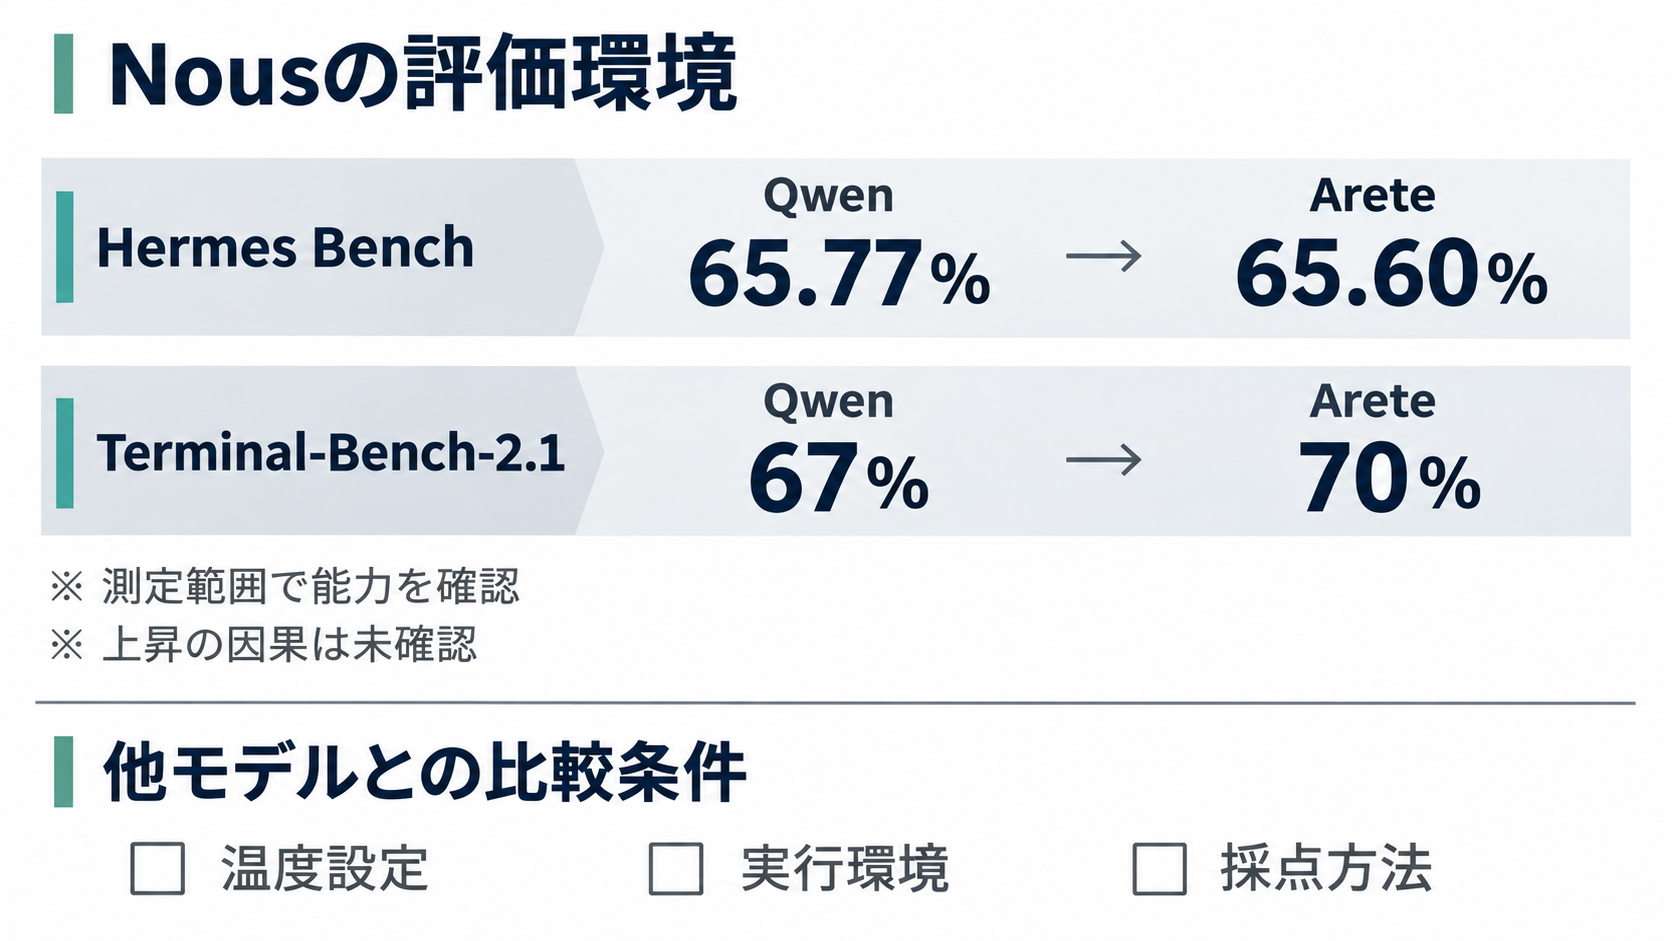
Hermes Benchのスコアは、基盤モデルの65.77%に対してArete-27Bが65.60%でした。Nous Researchはこの差を測定上のばらつきとみなしています。また、コンピューター上の作業能力を測るTerminal-Bench-2.1では、同社の実行環境で67%から70%へ上がりました。ただし、この上昇を追加学習の成果として主張しているわけではありません。
ここで確認できるのは、あくまで実施したテストの範囲で顕著な低下が見られなかったという結果です。日本語の契約文書の読解、社内システムでのツール利用、長い資料をまたぐ調査など、自社の用途まで一括して保証されるわけではありません。能力維持という表現は、測定した業務の種類と結びつけて読む必要があります。
他社モデルとの比較にも条件差があります。Nous Researchの政治的回答の評価では、AreteとQwenは生成のばらつきを抑える温度設定0で実行されていますが、比較対象のMuse GlimmerとGemmaは0.6でした。Terminal-Benchの数値も、実行・採点の仕組みが異なるものを含みます。表に並んだ数値だけから、そのままモデルの優劣を決めることはできません。
導入候補を絞る段階では、公開ベンチマークを手がかりにしつつ、最終判断には同じ質問、同じツール、同じ採点基準を用意するのが妥当でしょう。回答傾向の修正によって何が変わり、既存の作業がどこまで維持されるかを、同じ環境で比較することが判断の精度につながります。
日本企業は小規模な比較検証から適合性を確認
Arete-27Bの重みは、モデルやデータを共有するプラットフォームのHugging FaceでBF16形式として公開されています。容量は53.81GBです。コミュニティーが提供するQ4_K_M形式の4ビット量子化版は17.20GBで、24GBメモリのGPUを想定した選択肢として紹介されています。量子化は、重みの数値表現を小さくして容量を削減する方法です。
ただし、重みのファイル容量と、推論時に必要なGPUメモリは同じではありません。入力の長さや同時処理数などでも使用量が変わるため、17.20GBという値だけで24GBのGPU上の動作条件を確定することはできません。GGUF形式の公開版はllama.cpp、LM Studio、Ollamaで利用できるとされ、画像処理用のプロジェクターも含まれています。
コンテキスト長にも確認が必要です。基盤のQwen3.8-27Bはネイティブで262,144トークンに対応するとされていますが、Arete-27Bについて確認できるのは64kで学習したという情報です。学習時の長さと、推論時に安定して扱える長さは別の項目です。長文資料を投入する用途では、対応設定だけでなく、必要な情報を取り出せるかも検証する必要があります。
モデルのライセンスは、基盤と同じApache 2.0です。重み、学習データ、評価が公開されていることは、企業側が修正内容を調べるうえで利点になります。ただし、コミュニティー製の量子化版を使う場合には、その成果物の配布元や設定も確認対象になるでしょう。
最初の一歩としては、自社で判断が難しくなりやすい質問と、日常的な業務質問を組み合わせた小さな比較セットを用意する方法があります。基盤モデルとArete-27Bを同じ条件で動かし、必要な事実の充足、主張の帰属、回答拒否の妥当性、作業の完遂を別々に記録します。政治的な表現が減ったかだけでなく、自社が必要とする回答に近づいたかを確認することが、採用判断につながります。