

2026/11/19
AIニュース
AIの本番化を阻むデータの壁、日立ヴァンタラがストレージに知能を組み込む理由
この記事の要点
日立ヴァンタラは、AIの本番化を阻む課題として、データの分散や利用管理を挙げています。VSP Oneでの個人情報の識別や、Apache Icebergを使ったメタデータへの問い合わせを通じ、保存先からデータ活用を支える構想です。日本企業にも、実証実験で人手に頼った準備を本番で継続できるか、具体的な業務で確かめる視点が求められます。
目次
GPUをそろえても、必要なデータに届かない問題
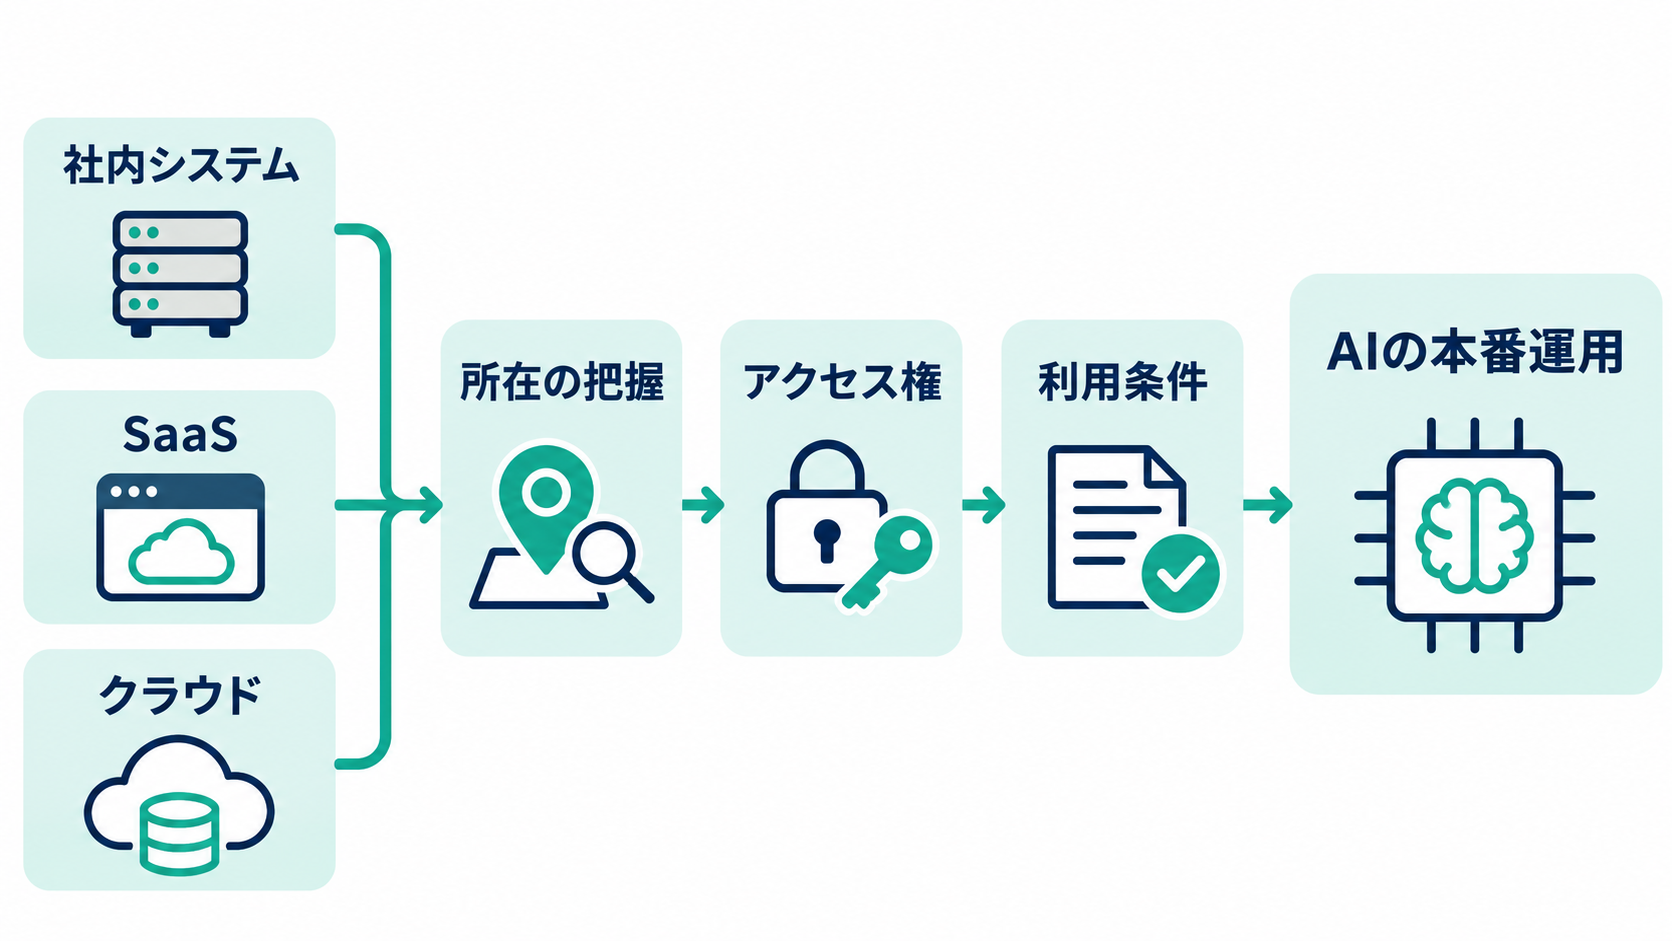
AIの実証実験では成果が出たのに、業務システムへの組み込みが進まない。その原因を計算能力だけに求めると、解決すべき課題を見誤るかもしれません。日立グループでデータ基盤を手がける日立ヴァンタラは、AIを本番運用へ移す際の難所として、企業内に分散するデータと、その利用を制約する管理の問題を挙げています。モデルを動かす設備があっても、必要な情報を安全に取り出せなければ、業務で継続的に使うところまでは到達できません。
同社のジェフ・ランドバーグ氏は、AI向け基盤やデータプラットフォームの参照アーキテクチャーは、おおむね固まってきたと説明しています。それでも案件が停滞するのは、情報が社内設置のシステム、クラウド、インターネット経由で利用する業務ソフトのSaaSなどに散在しているためです。そこにアクセス権限、データ管理、変化する規制への対応が重なります。これは、同じ資料を見つけられるかという問題に加え、誰がどの目的で使えるかを判断する問題でもあります。
こうした見方を示した場は、技術イベントSC26で行われた、技術メディアtheCUBEのインタビューです。登壇したのは、ハイブリッドクラウド・AIインフラ担当バイスプレジデントのアルン・プラサド・ラマン氏と、製品・ソリューション担当のランドバーグ氏でした。両氏の説明を貫くのは、ストレージを単なる保存先として扱うだけでは足りないという考え方です。日本企業がこの動きを読む際も、保存容量や処理性能の向上だけでなく、蓄積した情報を利用可能な状態へ近づける取り組みとして捉えると、導入判断の論点が見えてくるでしょう。
保存先に分類と管理を組み込むVSP One
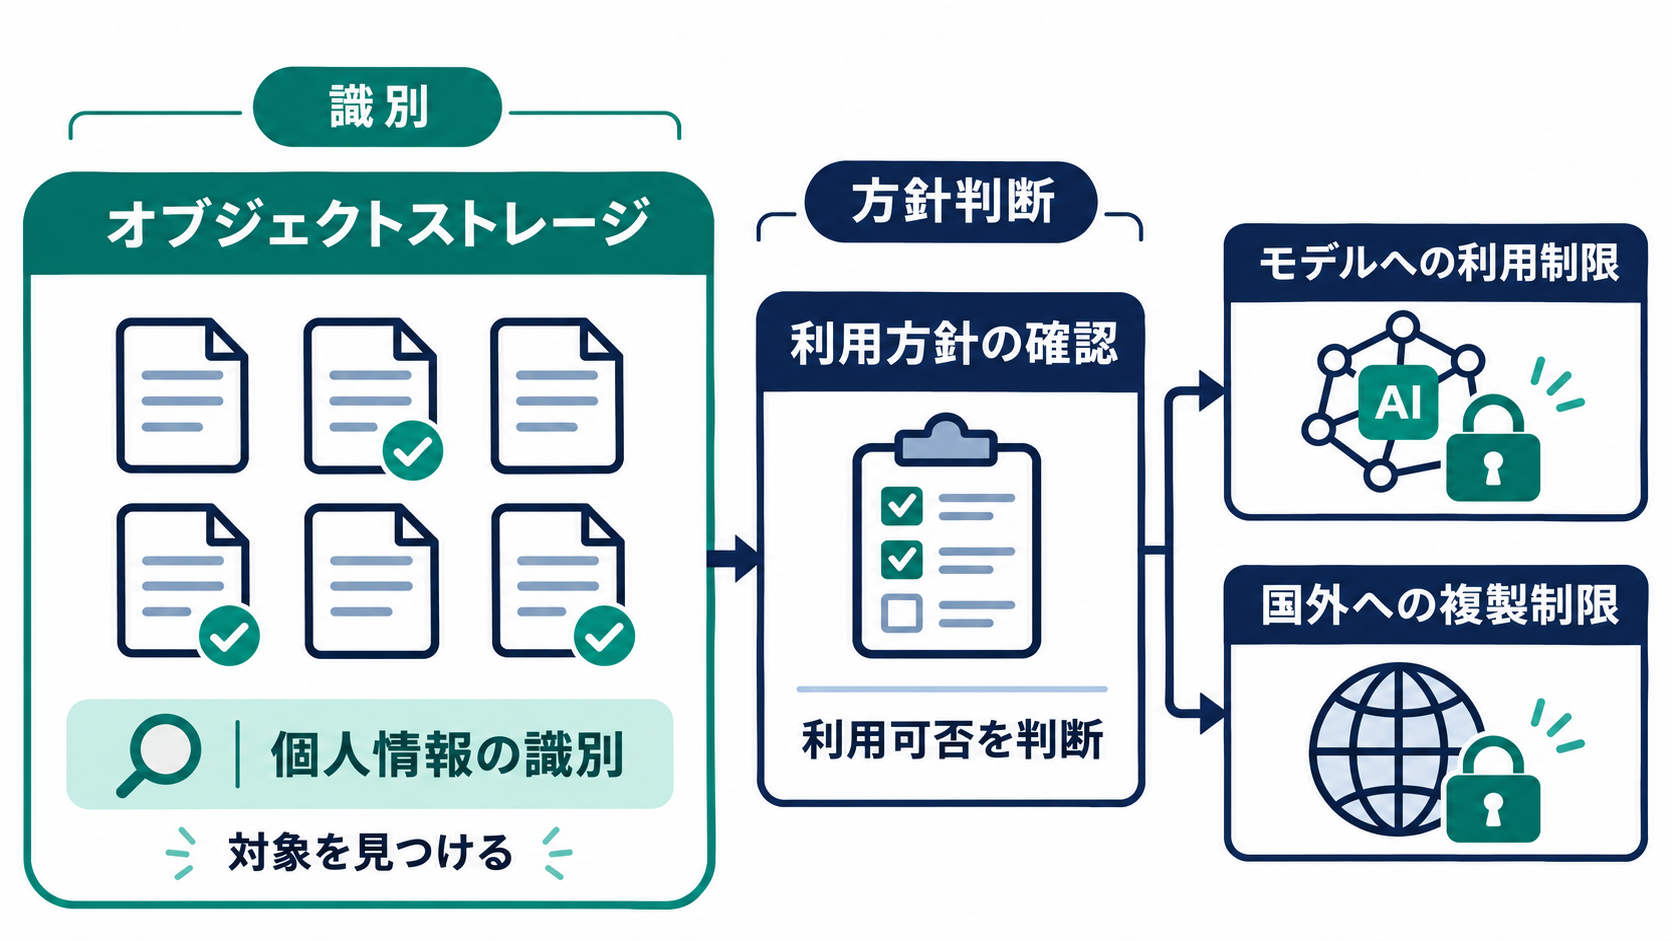
日立ヴァンタラが打ち出しているのは、データを保存する場所に、情報の分類や管理の機能を持たせる方向性です。同社はVSP Oneプラットフォームを拡張し、新たなオブジェクトストレージとデータレイクハウスの機能を紹介しています。オブジェクトストレージは、ファイルなどのデータを個別のオブジェクトとして扱う保存方式です。ここで注目したいのは保存方式そのものより、保存された内容を把握し、利用条件の判断につなげようとしている点です。
ラマン氏が示した例では、オブジェクトストア内のサービスが、米国の社会保障番号などの個人情報を含むファイルを検出し、印を付けます。社会保障番号は、米国で個人の識別に用いられる番号です。その識別結果を使えば、データサイエンティストは特定のモデルに該当データを使わせない、あるいは別の国への複製を制限するといった対応を取れると同氏は説明しています。データの中身に関する情報を、保存後の管理や利用制御へ結び付ける発想です。
ラマン氏は、索引作成などのためにデータを別の場所へ複製し、処理後に戻すのではなく、保存先で処理できることに価値があると述べています。ただし、この説明を、保存先に任せれば管理がすべて自動で完了するという意味に広げるべきではありません。情報を検出する機能と、何を禁止するかを決める業務上の方針は、役割が異なります。企業が評価する際には、分類結果をどのような利用判断へつなげられるのかまで確認する必要があるでしょう。知能を備えたストレージの実務上の価値は、その接続部分に表れます。
Apache Icebergが担う、保存と分析の接点
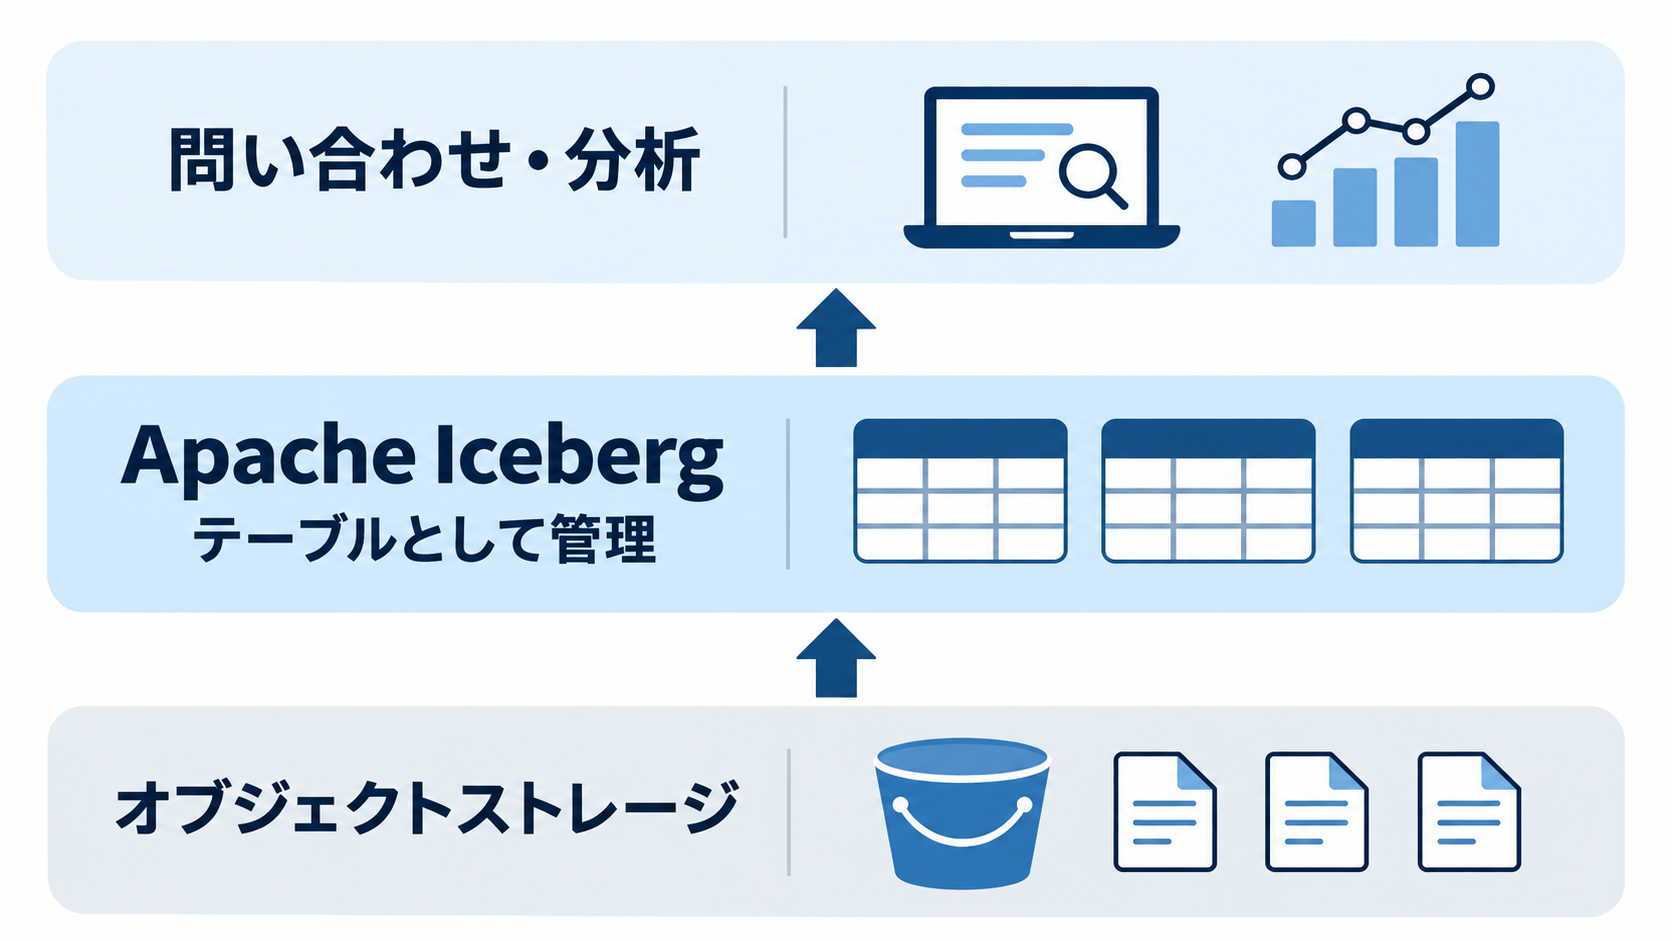
今回の説明で、保存されたデータを分析へつなぐ要素として挙げられたのがApache Icebergです。Apache Icebergは、分析用のデータをテーブルとして管理するためのオープンなテーブル形式です。AIモデルそのものでも、画像を読み解く機能でもありません。企業向けの議論では、保存場所の話と分析手段の話が混ざりがちですが、どの情報をどの形で整理し、問い合わせられるようにするかを支える仕組みとして捉えると理解しやすくなります。
日立ヴァンタラが関連機能として紹介したデータレイクハウスも、この接点に位置する考え方です。さまざまな情報を蓄積するデータレイクと、分析向けに整えたデータを扱うデータウェアハウスの特徴を組み合わせることを目指します。企業にとっての関心は、名称の新しさよりも、保存しているデータを分析に使うまでの準備をどこまで減らせるかにあるでしょう。別の保存先へ移す作業や、分析用に組み直す工程が必要なら、その準備自体が利用開始までの負担になります。
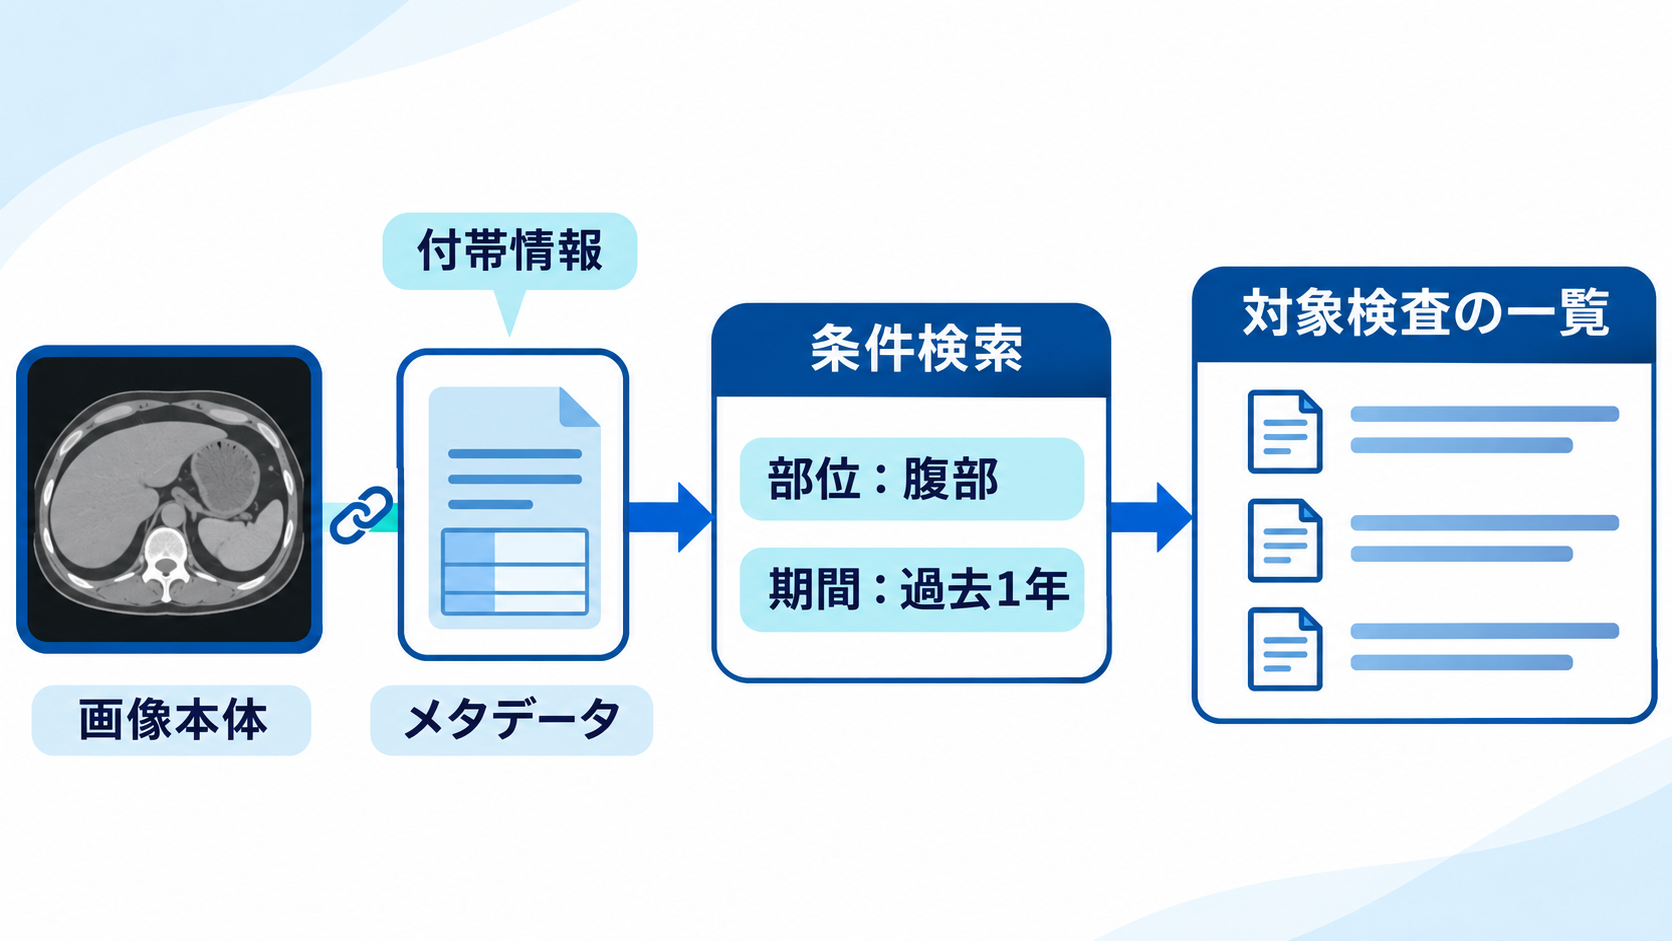
ラマン氏は、同社のオブジェクトストア上で、CT検査のメタデータをApache Iceberg形式で保存し、直接問い合わせる例を示しています。ここでの要点は、オープンな形式を採用したというだけではなく、保存した情報を検索・分析へ結び付ける使い方です。ただし、オープンな形式であることと、社内のすべてのデータを直ちに統合できることは別の話です。部署ごとに項目の意味や記録方法が違えば、その整理は必要になります。形式の選定を評価する際も、自社の情報をどう表現し、どの業務から参照するのかという具体的な利用場面と併せて検討するのが適切です。
CT画像の例で見える、メタデータを使う意味
医療分野の例としてラマン氏が挙げたのは、過去1年分の腹部CT検査をアプリケーションから一覧にする使い方です。同氏の説明では、CT検査のメタデータをオブジェクトストア上にApache Iceberg形式で保持することで、別途ETL処理やデータベースを用意せずに問い合わせられます。ETLは、データを抽出し、利用目的に合う形へ変換して、別の場所へ格納する工程を指します。この例では、その工程を別立てにする負担を減らすことが焦点になっています。
メタデータは、データそのものを説明する付帯情報です。この使い方を理解するには、画像の内容をAIが読み取る処理と、検査に関する条件を使って対象を探す処理を分けて考えるとよいでしょう。「必要な検査を一覧にできる」という説明は、CT画像から診断結果を自動で導けるという説明ではありません。日立ヴァンタラが示した具体例も、検査情報を条件に応じて取り出す場面です。画像の内容を解析する機能や、その精度まで示されたわけではありません。
この区別は、医療以外の企業にも参考になります。例えば、蓄積された資料をAIに使わせる計画でも、内容の高度な解析に着手する前に、対象となる資料を適切な条件で絞り込めるかを考える余地があります。必要なデータを探し出す段階と、見つかったデータから答えを得る段階では、確認すべき機能が異なるためです。保存先での問い合わせが役立つかどうかは、自社が求める条件をメタデータで表せるかによって変わります。製品説明を評価するときは、扱う対象がデータ本体なのか、その付帯情報なのかを明確にすると、期待する効果の食い違いを減らせるでしょう。
古いデータの価値と、業務成果を軸にした設計
ラマン氏は、バックアップであっても、10年前のデータであっても、意味のある情報を含む限りAIにとって重要になると説明しています。ログや医療画像など、従来は活用しきれなかった非構造化データから、AIが情報を取り出せるという見方です。非構造化データとは、表の行と列のような一定の形に整理されていない情報を指します。保存したままになっているデータを、単なる保管負担ではなく、利用を検討できる情報資産として見直す発想が背景にあります。
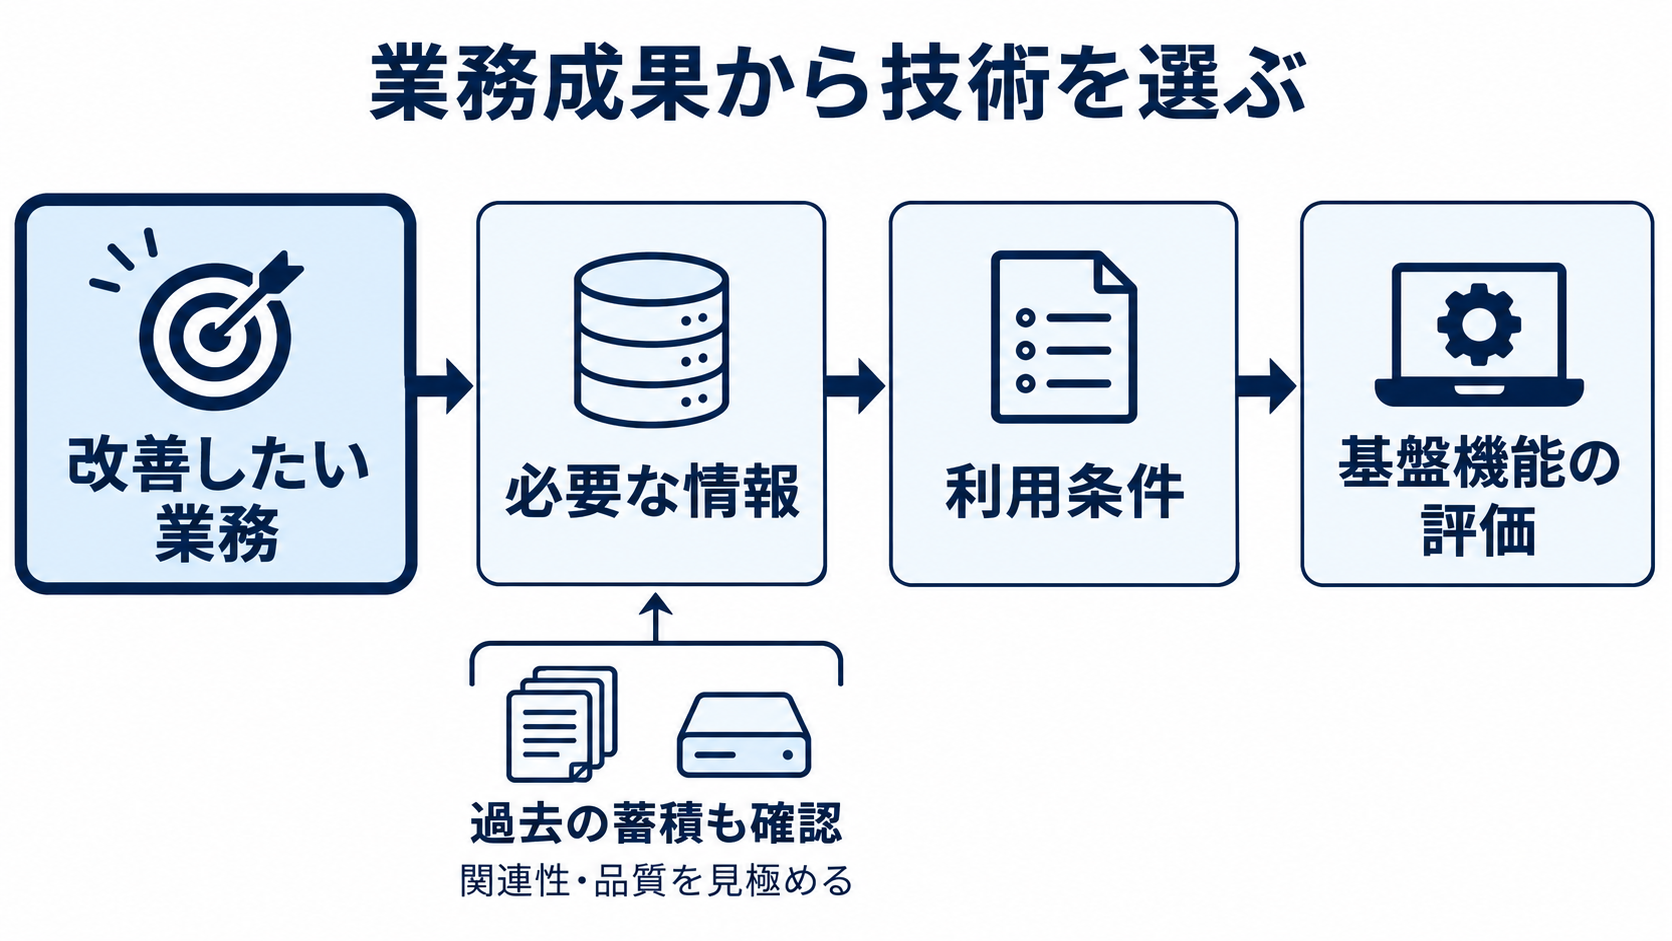
もっとも、古いデータが残っていることと、現在の業務に役立つことは同義ではありません。これは導入時の考察ですが、記録された時点の事情が今も当てはまるか、利用目的に必要な情報が含まれるかを確かめなければ、蓄積量だけで価値を判断することになります。AIが読み取れるようになることで、利用候補は広がるでしょう。それでも、どの業務のどの判断を助けたいのかを定める作業は残ります。保存機能の進化を成果へ結び付けるには、この用途の絞り込みが欠かせません。
ランドバーグ氏も、技術の導入そのものより成果を重視する姿勢を示しています。同社はHitachi iQを基盤に、日立グループの鉄道・エネルギー分野での経験も生かした業種別ソリューションに取り組んでいると説明しました。この方向性から読み取れるのは、共通の基盤技術だけで業務上の課題を解き切るのは難しいという認識です。企業側も「AIで何かできないか」と保管庫全体を眺めるより、改善したい作業を起点に必要なデータを選ぶほうが、製品の適合性を判断しやすくなります。業種向けという説明についても、自社の作業や制約にどう対応するかまで確認したいところです。
日本企業が確かめたい、実証実験の次の条件
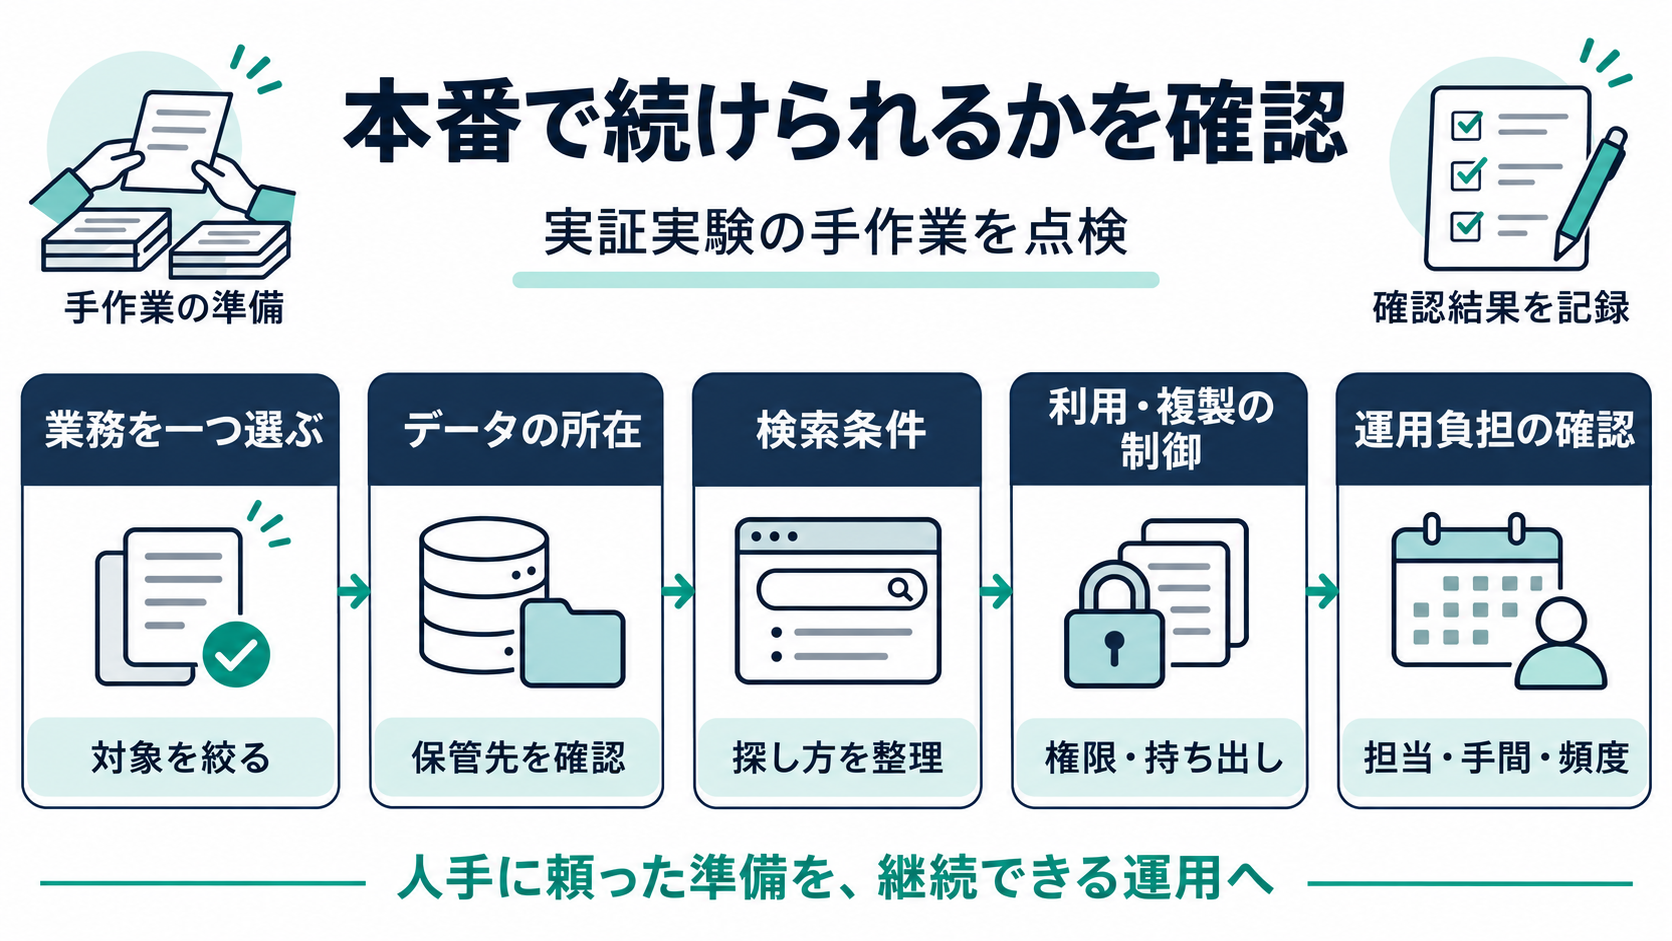
日本企業にとって、この発信を導入判断へつなげる出発点は、AIの性能評価にデータ利用の条件を加えることです。実証実験では、担当者が必要な資料を手作業で集め、利用してよい情報だけを選んで渡すことも考えられます。その方法で回答品質を確認できても、本番で同じ準備を継続できるとは限りません。誰が情報を探し、利用条件を判断し、更新されたデータを反映するのかまで具体化して初めて、運用に必要な作業量を見積もれるでしょう。
評価対象を一つの業務に絞れば、確認事項も明確になります。必要な情報はどこにあり、どの条件で検索できるのか。個人情報を含む場合、識別結果を誰が確認し、モデルへの利用や複製の制限へどう結び付けるのか。こうした問いを、実際に使いたいデータで検証する方法が考えられます。特に、保存先で処理できるという説明については、自社の環境で省ける工程と、引き続き必要な準備を分けて確かめることが有効です。機能の有無だけでは、業務上の負担がどれほど変わるかまでは分かりません。
なお、今回のtheCUBEのインタビュー枠は日立ヴァンタラがスポンサーを務めています。SiliconANGLEは、スポンサーに編集権はないと明示していますが、登壇者による製品や構想の説明である点を踏まえて読む必要があります。紹介された機能や利用例は、自社環境での効果を保証するものではありません。次の一歩として、実証実験で人手によって準備したデータを一つ選び、その準備作業を本番でも再現できるか確認してみてください。必要な分類、検索、利用制御を具体的な作業に置き換えることで、ストレージに組み込まれた知能が、自社のどの負担を減らせるのかを判断しやすくなります。