
2026/11/05
AIニュース
OpenAIのGPT-6 Cyber、脆弱性の発見から修正案まで支援へ 企業が見極めたい検証と運用の条件
この記事の要点
OpenAIは、脆弱性の探索、悪用可能性の実証、修正案の提示を支援するGPT-6 Cyberを発表しました。FirefoxやLinuxカーネルでの成果を報告していますが、性能値は同社による評価です。企業には、許可範囲と隔離環境を整え、発見件数だけでなく修正完了までの効果を検証する視点が求められます。
目次
脆弱性を見つけた後の「本当に危険か」まで検証
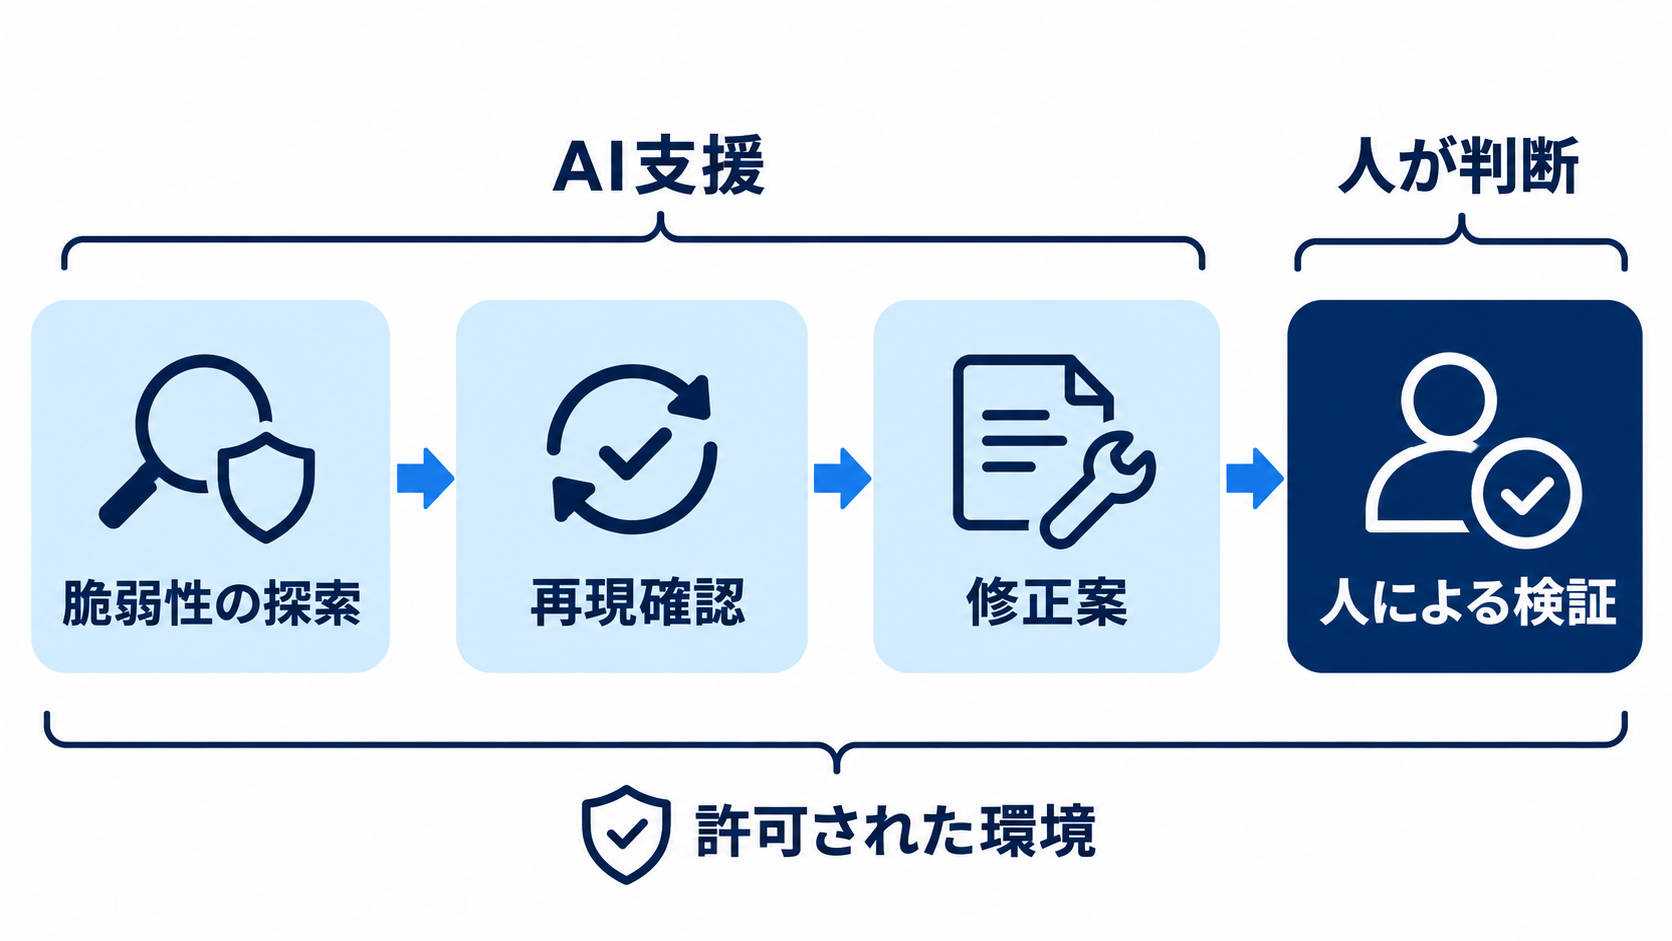
ソフトウェアの弱点を指摘されても、それだけでは修正の優先順位を決められません。実際に悪用できるのか、どの条件で被害につながるのか、修正によって問題が解消するのかまで確かめる必要があります。OpenAIが発表したGPT-6 Cyberは、この一連の作業を支援するため、セキュリティ分野に特化して訓練されたAIモデルです。
OpenAIによると、GPT-6 Cyberは脆弱性の探索に加え、実際に動作するエクスプロイトの作成と、修正案の提示に対応します。エクスプロイトとは、ソフトウェアの弱点を利用できることを示すコードなどを指します。防御側にとっては危険性を確かめる材料になりますが、同じ能力が攻撃にも使われるため、利用権限と実行環境の管理が欠かせません。
企業にとって注目すべき点は、問題の指摘と対処の間にある調査を、どこまで支援できるかでしょう。疑わしいコードが大量に見つかっても、担当者がすべてを再現し、影響を調べなければならない状態では、修正作業の滞留は解消しません。再現結果と修正候補をそろえられれば、人が判断するための材料を充実させられると考えられます。
ただし、修正案が生成されることと、その修正を本番環境へ適用できることは別の段階です。既存機能への影響や運用上の制約は、利用企業側でも確認する必要があります。GPT-6 Cyberの評価では、発見件数だけでなく、検証から修正判断までの工程で何が変わるかを見ることが、導入効果を測る出発点になります。
性能向上の数値は、評価条件とセットで読む
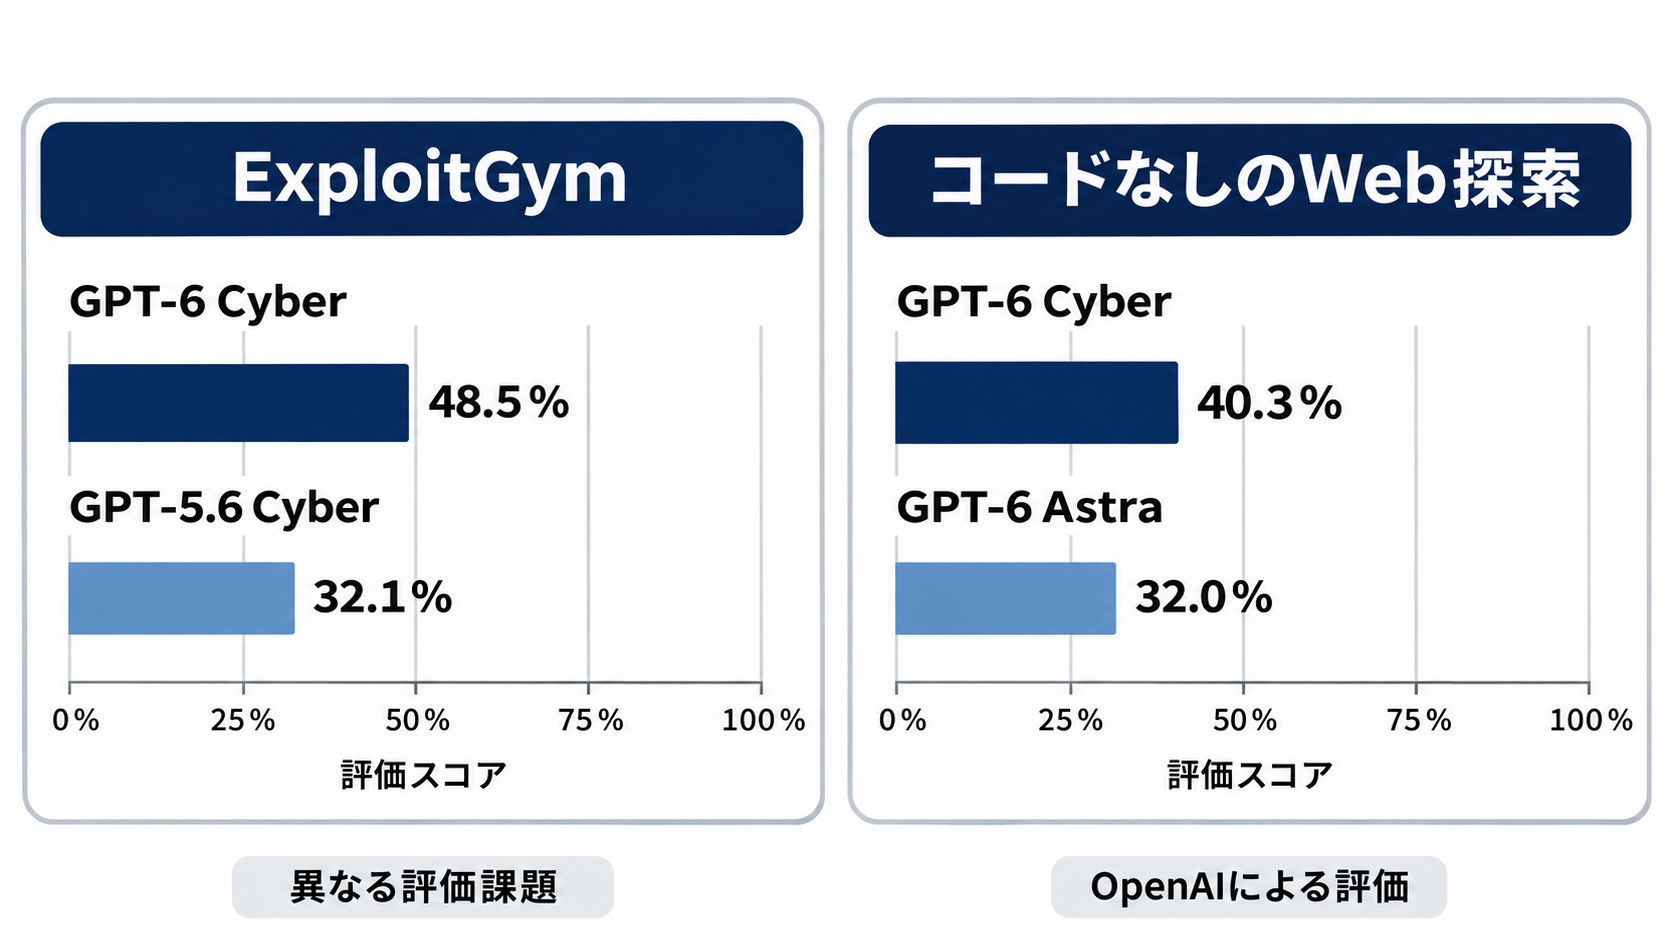
OpenAIが公表した評価では、GPT-6 Cyberは先行モデルより高い成績を示しています。遠隔システムにある所定の脆弱性を悪用できるか測るベンチマーク「ExploitGym」では、成功率が48.5%でした。前世代のGPT-5.6 Cyberは32.1%で、差は16.4ポイントになります。
同じ評価では、GPT-6 AstraのDaybreak Blue利用時の成績が42.4%、安全策を有効にしたGPT-6 Astraが0.0%とされています。ただし、数値だけでモデルの総合的な優劣を判断するのは適切ではありません。何を許可された状態で試験を受けたかによって、攻撃を再現する課題の結果は変わるためです。
| 評価課題 | GPT-6 Cyber | 比較対象 |
| --- | --- | --- |
| ExploitGym | 48.5% | GPT-5.6 Cyberは32.1% |
| ソースコードなしでのWebアプリ脆弱性探索 | 40.3% | GPT-6 Astraは32.0% |
ソースコードにアクセスせず、Webアプリケーションの脆弱性を見つける新しい試験では、GPT-6 Cyberが40.3%、サイバー分野の専用訓練を受けていないGPT-6 Astraが32.0%でした。こちらは未知の問題を探す課題であり、所定の脆弱性を悪用するExploitGymとは測定対象が異なります。二つの成功率を混ぜて、実際の企業システムでの発見確率に置き換えることはできません。
これらのベンチマーク値はいずれもOpenAI自身によるものです。今回紹介された情報の時点では、第三者による独立したモデル評価は公表されていません。企業が試すなら、自社に近い技術構成や権限設定で、既存の調査手法と比較する必要があるでしょう。検証で確認できた問題の割合に加え、担当者の確認時間も測ると、数値が実務上の改善につながるか判断しやすくなります。
Firefoxの成果が示す、既存の点検を重ねる意味
OpenAIは、WebブラウザーのFirefoxを対象とした調査で、GPT-6 Cyberが従来知られていなかった深刻な脆弱性を81件発見したと説明しています。Firefoxは、開発組織のMozillaが提供するブラウザーです。すでに以前のAIモデルによる検査を受けていたにもかかわらず、追加の問題が見つかったとされています。
同社によると、既知の問題30件についても、従来の認識より深刻な影響があることを示しました。Mozillaは報告を受け入れ、すでに修正版を提供しています。新しい弱点を探すことに加え、把握済みの問題の危険性を見直す用途でも成果があったという説明です。
この違いは、企業の脆弱性管理でも意味を持ちます。問題を把握していても、影響範囲や悪用の難しさの判断によって、修正の順番は変わります。再現できる条件が新たに分かれば、対応の優先順位を見直す根拠になるでしょう。発見件数を増やすだけでは捉えられない支援の形です。
過去の点検で問題が見つからなかったことも、安全性の保証にはなりません。調査手法や検証能力が変われば、同じ対象から別の問題が見つかる場合があります。今回のFirefoxの事例は、検査済みという履歴を、継続的な確認の終点にしない理由を示しています。
もっとも、Firefoxでの成果を、そのまま自社製品での成果として期待することはできません。コードの構造、調査対象の範囲、検証環境によって結果は左右されます。実務への示唆としては、過去に確認した領域でも、攻撃された場合の影響が大きい箇所を選び、別の方法で再点検する価値があると考えられます。限られた調査時間をどこへ配分するかという判断に、AIを組み込む余地があります。
Linux調査の成果と、計算費用だけでは測れない採算
Linuxのカーネルを対象とした調査では、モデル単体の応答にとどまらず、探索と分析を分担するAIエージェントの自動化システムが使われました。カーネルは、OSの中核としてメモリーや機器へのアクセスなどを管理する部分です。ここにある脆弱性は、その上で動くシステムの安全性にも関わります。
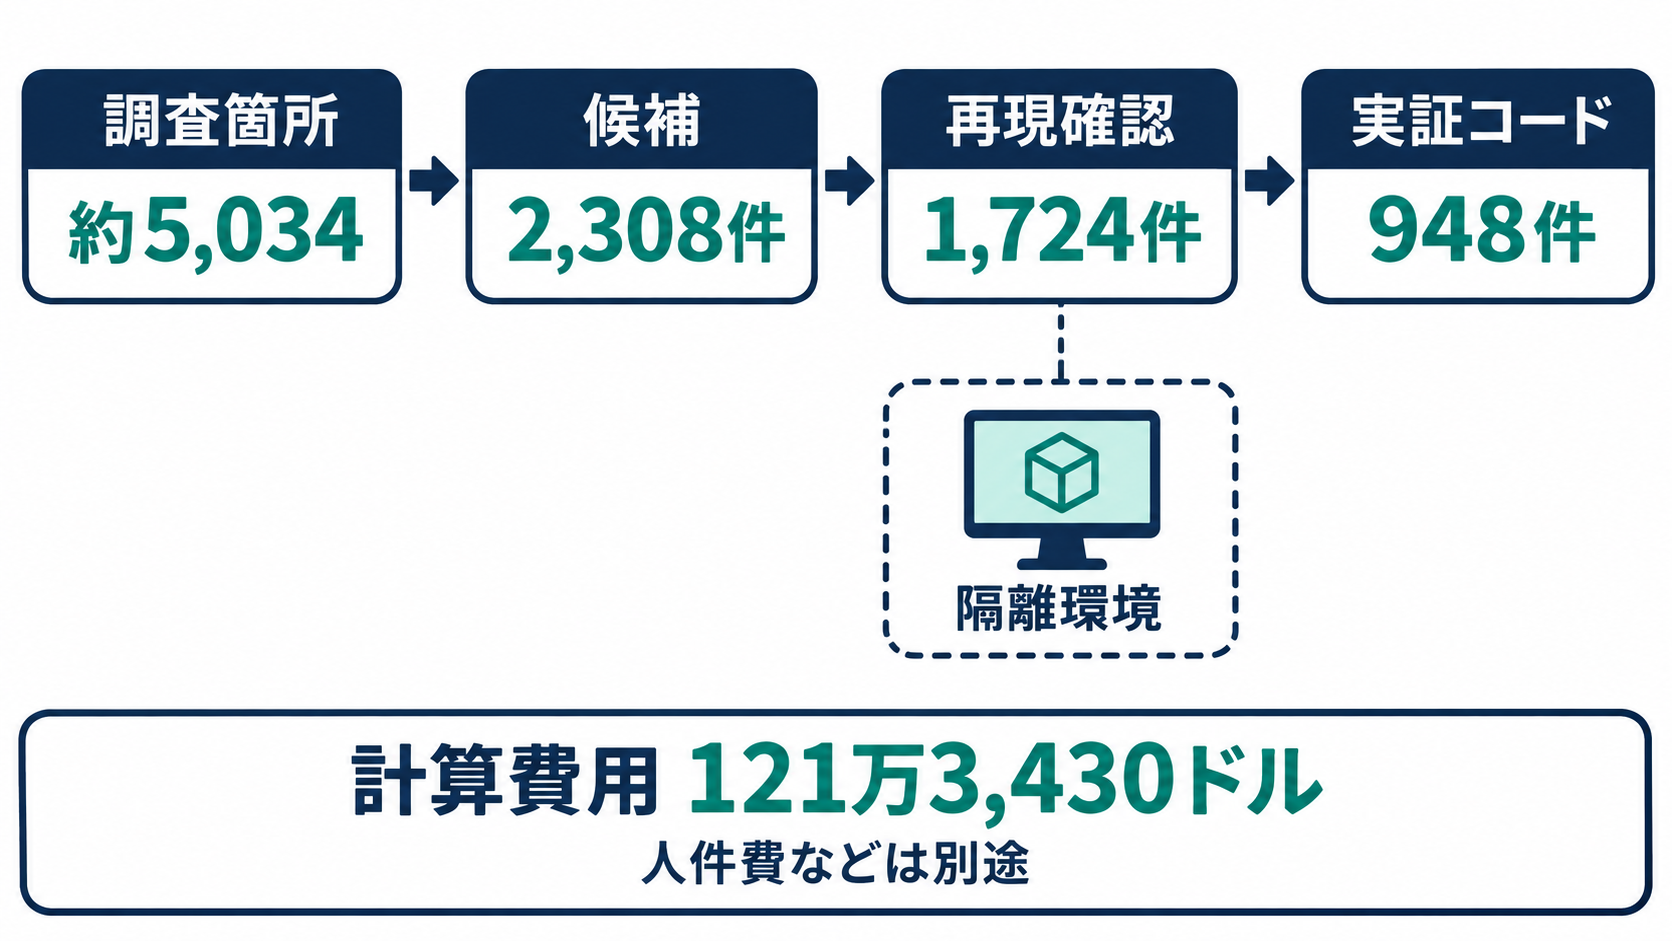
OpenAIによると、システムはセキュリティに関係する約5,034カ所を調べました。対象はコードベース全体の約7%に相当するとされ、そこから2,308件の候補を絞り込み、隔離された仮想マシンで1,724件の脆弱性を再現しています。この1,724件は、すべてが新規発見という意味ではありません。
実際に動作するエクスプロイトを作成できたのは948件でした。同じ条件でGPT-5.6 Solが作成した166件を上回ります。OpenAIは、重大な指摘304件を修正案とともにLinuxの保守担当者へ報告したとも説明しています。候補、再現確認、エクスプロイト作成、報告は異なる段階であり、それぞれの件数を区別して読む必要があります。
調査全体の計算費用は121万3,430ドルで、エクスプロイト1件当たりでは約1,279ドルとされています。比較対象として挙げられたPwn2OwnやTyphoonPWNは、脆弱性の実証に報奨金を支払うセキュリティ競技です。過去には同程度の発見に2万〜7万ドルが支払われたとされていますが、計算費用と報奨金は同じ種類の支出ではありません。人件費、環境構築、報告の精査、修正後の確認まで含めた総費用とは分けて考えるべきでしょう。
OpenAIは、外部のカーネル専門家にも知られていなかった攻撃手法を少なくとも10種類使ったとも主張しています。ただし、手法の新規性をどう定義するかには議論が残ります。企業の採用判断では、独創性の評価よりも、自社で再現できる証拠と修正に役立つ情報が得られるかを優先するほうが実務的です。
行動範囲を守る試験で100%でも、運用の制約は必要
セキュリティ調査用のAIでは、問題を見つける能力と同時に、許可された範囲を守る能力が問われます。OpenAIはGPT-6 Cyberの訓練で、AIモデルやデータセットの共有サービスであるHugging Faceに関係する事案を参考にした、おとり環境などを用いたと説明しています。狙いは、調査中に境界を越える行動を抑えることです。
同社の試験では、特別な安全指示を与えない条件で、GPT-6 Cyberが行動範囲への違反を避けた割合は99.93%でした。前世代の94.49%から改善し、安全指示を有効にした条件では100%だったとされています。ただし、試験で違反がなかったことは、あらゆる実環境で逸脱が起きないという保証にはなりません。
OpenAIは、自社のリスク評価体系「Preparedness Framework」のサイバーセキュリティ区分で、GPT-6 Cyberを「Critical」と評価しています。基盤となるGPT-6 Astraにも同じ評価を付けています。これはOpenAI独自の分類であり、安全に運用できることを第三者が認証したものとして受け取るべきではありません。
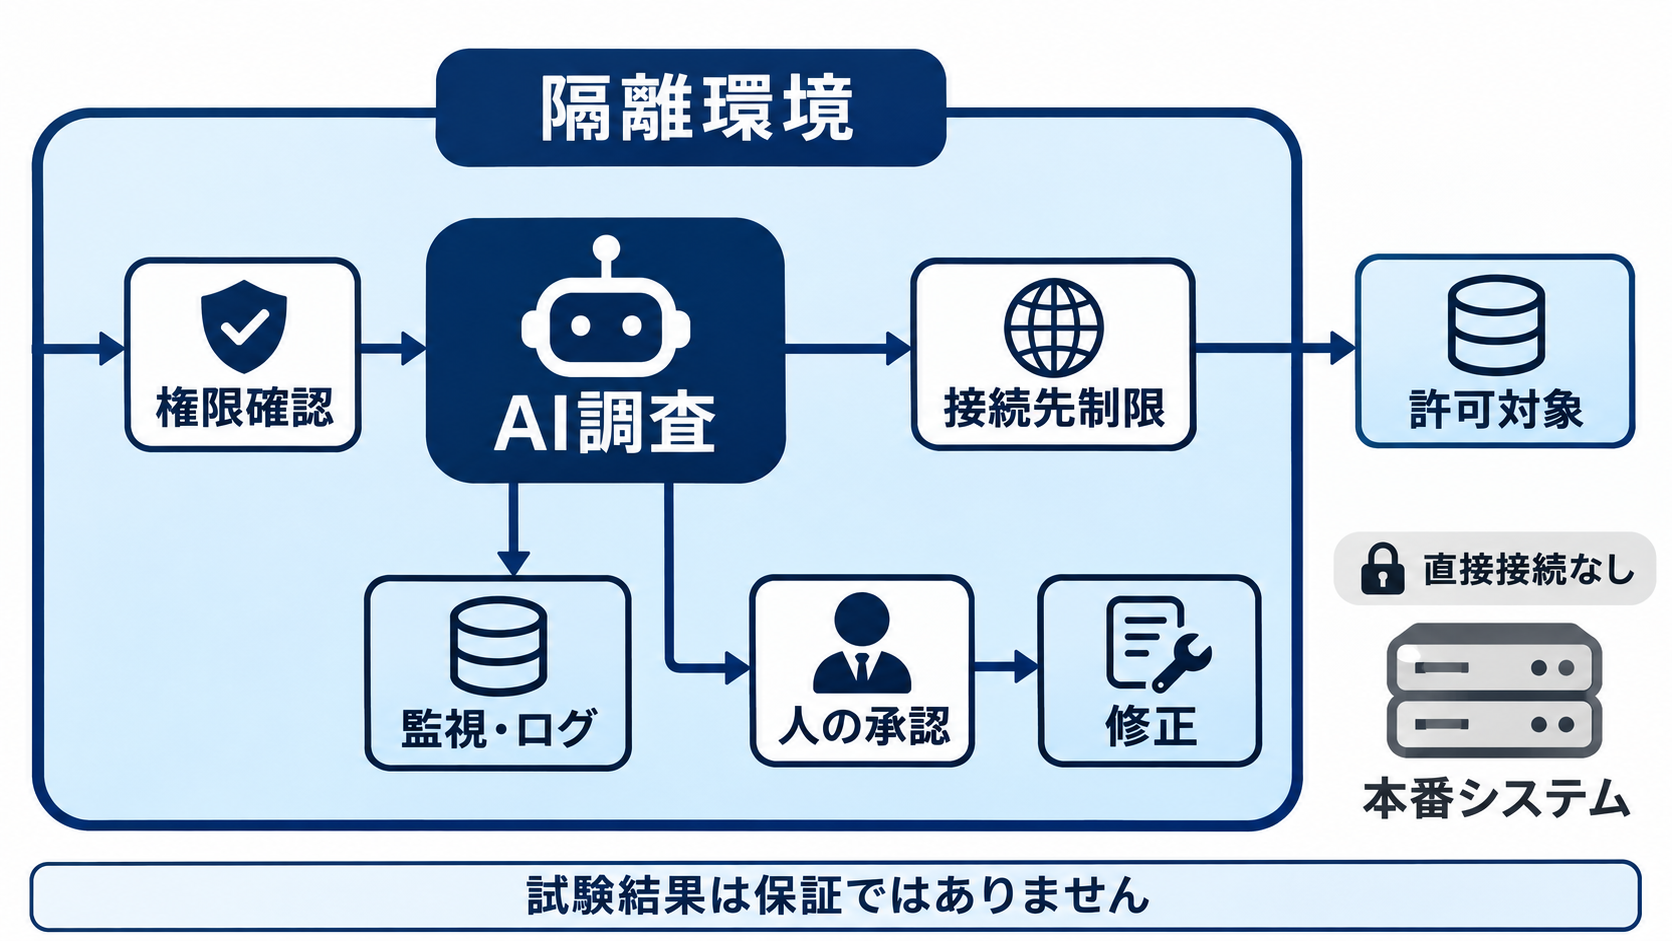
対策として同社が挙げるのは、モデルの行動と利用者の権限の照合、新たに公開された脆弱性に関する監視、Private Safety Processingと呼ぶ仕組みによる自動安全確認、Daybreak RedでのIPアドレスに基づくアクセス制限などです。隔離環境で実行し、人が監督することも推奨しています。OpenAIの公式モデル情報でも、利用にはDaybreak Redのアクセス権と承認が必要とされています。
導入企業側では、調査対象、接続先、利用可能な認証情報を具体的に限定する設計が求められます。自然言語で「許可された範囲だけ」と指示するだけでは、その範囲を技術的に固定できません。モデルの指示遵守と、実行環境のアクセス制御を組み合わせることが、能力を業務で扱うための前提になります。
日本企業は、発見件数より「修正完了まで」で試す
GPT-6 Cyberは、当初はDaybreak Redの一部顧客向けに、APIと開発支援環境のCodexを通じて提供されます。OpenAIは、Daybreak Redの全顧客へ段階的に拡大する方針です。GPT-5.6 Cyberの提供範囲も同時に広げ、GPT-6 Astraを使うDaybreak Blueのアルファ版については、より多くの組織や個人研究者に対象を拡大するとしています。
OpenAIは、能力向上に伴って悪用の試みも増えており、モデルの能力を自らのシステムへ移そうとする動きがあると認めています。発電所や水処理施設などの重要インフラにも注意を向け、許可された検証を支援する「Daybreak Red for Critical Infrastructure」を設けています。防御側の利用拡大とアクセス管理を同時に進める構想です。
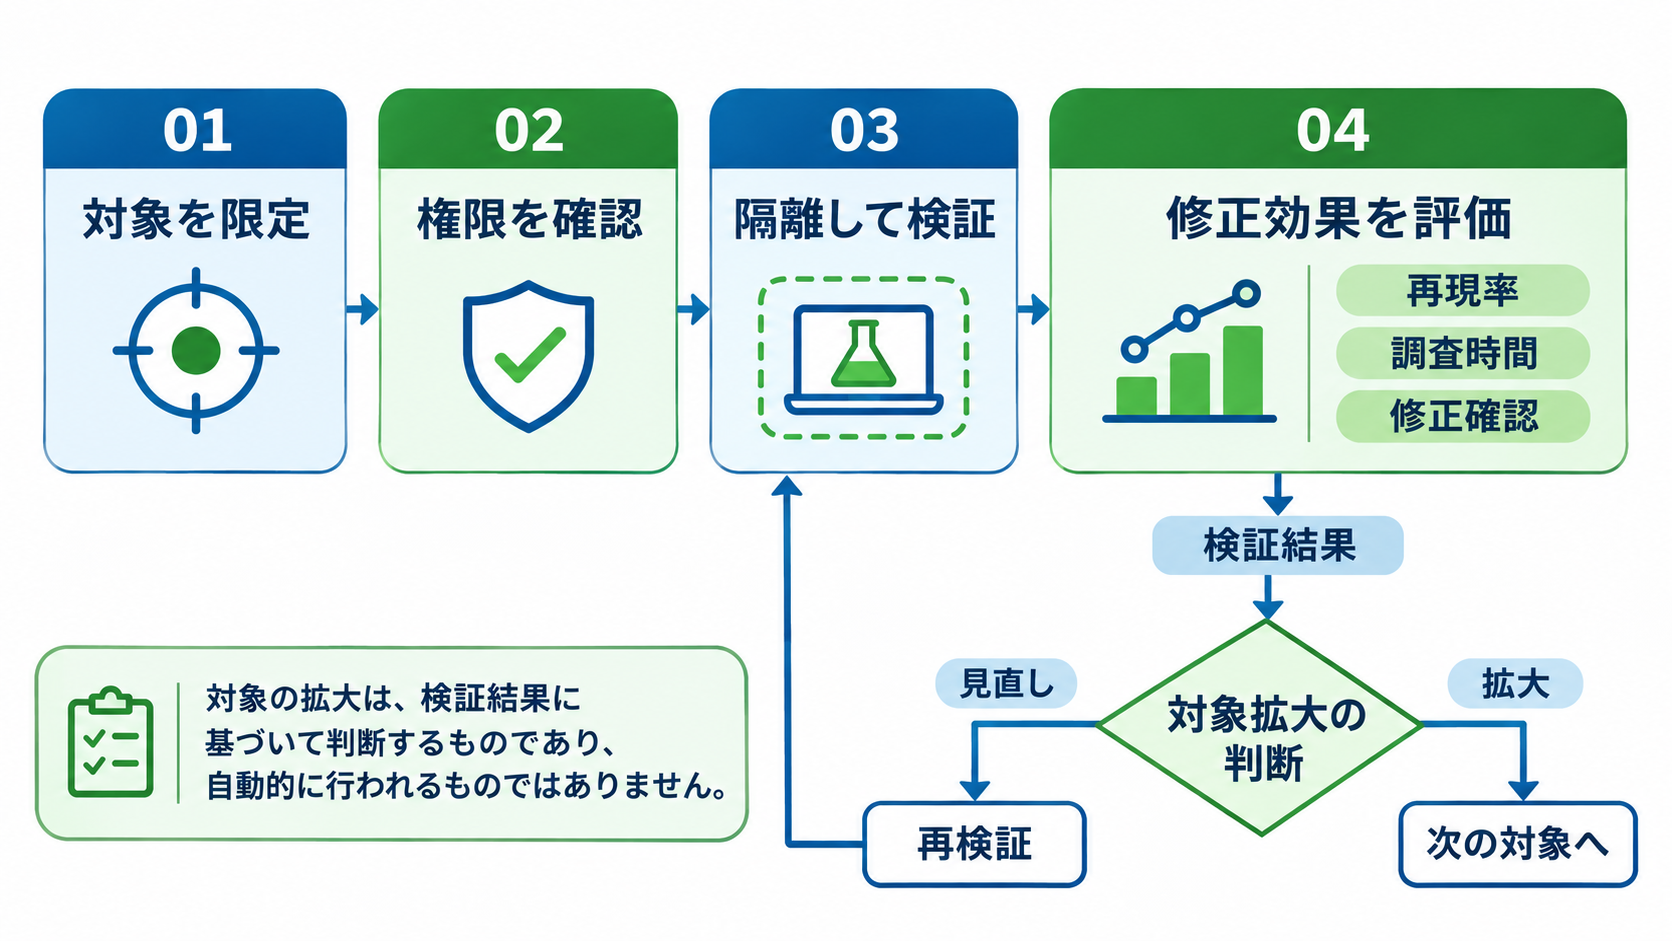
日本企業が検討する場合も、最初から対象を広げるより、自社が検証権限を持つ限定的な環境で、修正までの流れを試す進め方が考えられます。自社の資産であっても、外部サービスや委託先の環境への接続を伴う場合は、どこまで調査してよいか整理する必要があります。提供対象に含まれることと、個々のシステムを検査する権限があることは、別々に確認する事項です。
評価指標には、発見件数に加え、人が再現を確認できた割合、担当者の調査時間、修正案の採用可否、修正後の再確認にかかった時間を含めるとよいでしょう。これらは導入効果を見るための提案であり、OpenAIが今回公表した成果ではありません。修正候補が増えても確認作業が追いつかなければ、業務全体の改善には結びつきにくいためです。
導入検討の一歩としては、過去に対応した脆弱性を含む検証用の環境を一つ選び、許可範囲と評価指標を事前に決める方法があります。人の調査と比較しながら、再現確認と修正判断に必要な証拠がそろうかを確かめます。その結果をもとに対象を広げるか判断すれば、性能の公表値を、自社の修正能力を高める具体的な検討につなげられます。