
2026/11/05
AIニュース
OpenAIの文章透かし「textGrain」、編集で検出率が低下――企業が知るべき判定の限界
この記事の要点
OpenAIの文章透かし「textGrain」は、短文や編集後の文章では検出性能に限界があります。類義語への置き換え試験では検出率が大幅に低下しました。EUの透明性ルールへの適合には第三者評価も焦点となるなか、日本企業には、検出結果と制作・編集記録を組み合わせた運用が求められます。
目次
文章を整えるだけで弱まる、AI生成の手がかり
AIが作った説明文を担当者が短くし、顧客に合わせて言葉を置き換える。企業のコンテンツ制作では自然な作業ですが、その過程で「AIが生成した文章であること」を示す電子透かしが検出しにくくなる可能性があります。OpenAIの文章透かし技術「textGrain」が突きつけているのは、生成時に付けた印を、実際の編集工程を経てもどこまで追跡できるかという問題です。
OpenAIが10月に公開したtextGrainは、文章の言葉選びに、人には見えない統計的なパターンを埋め込みます。背景には、生成コンテンツを機械で識別できるようにするEUの透明性ルールがあります。ただし、透かしがあることと、公開後の文章から確実に検出できることは同じではありません。
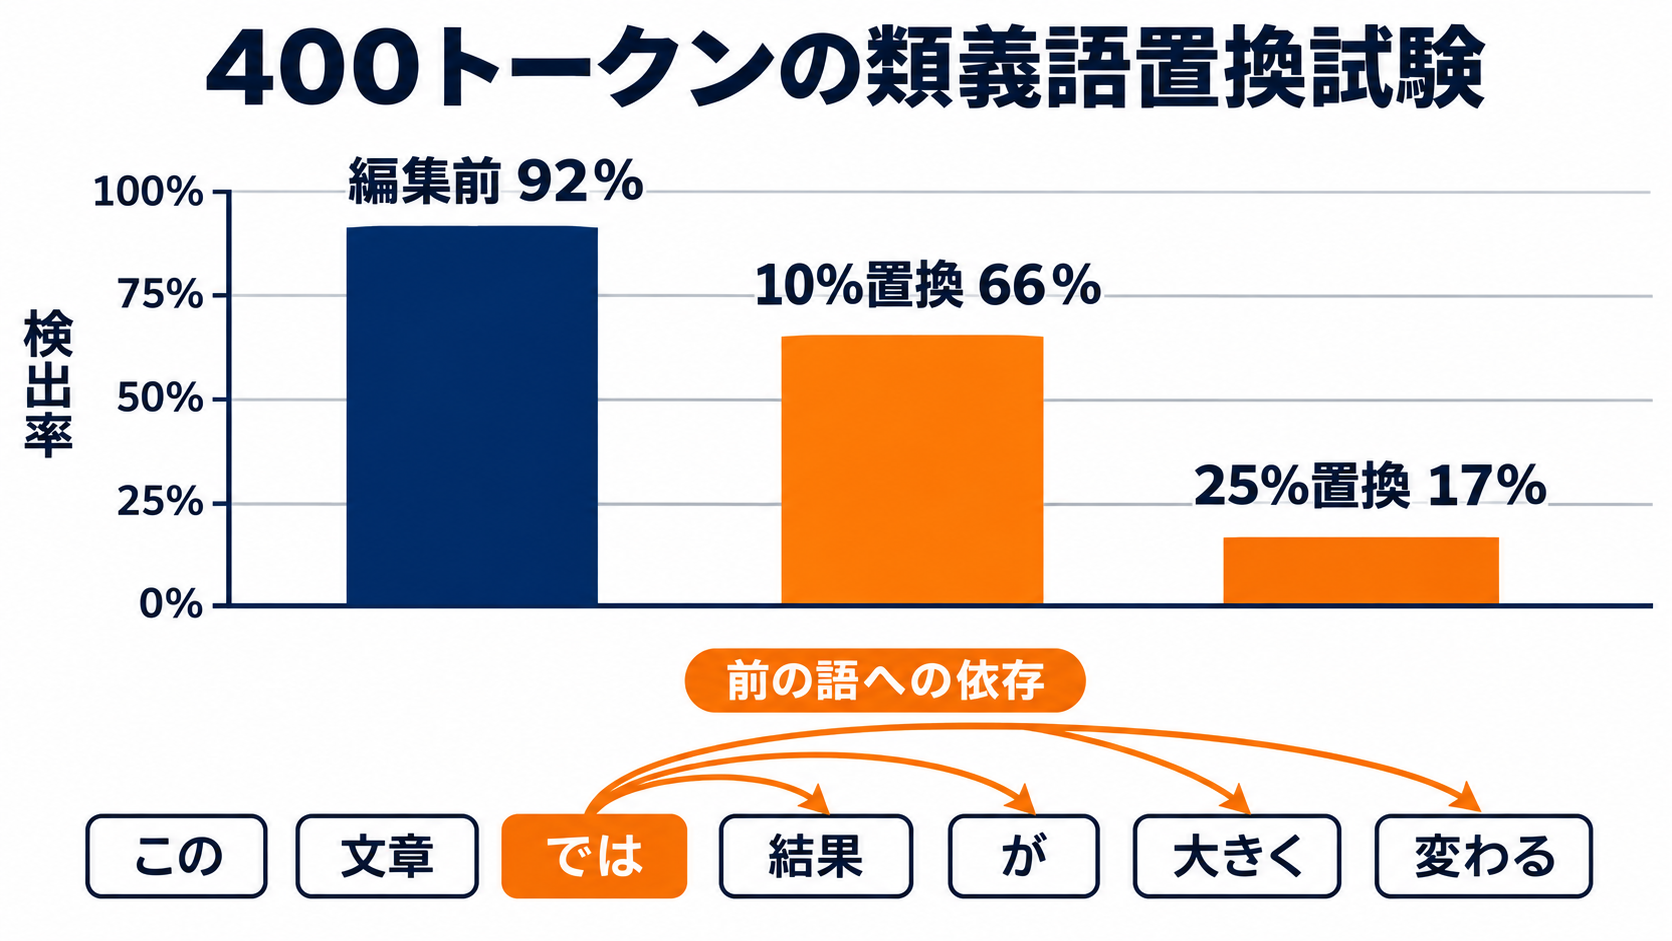
OpenAIの評価では、400トークンの文章について、単語の10%を類義語に置き換えると検出率が92%から66%に下がりました。置き換えを25%まで増やすと、検出率は17%まで低下しています。この結果は特定の試験条件で得られたものであり、あらゆる編集で同じ割合になるわけではありません。それでも、文面の変更が検出に影響することは読み取れます。
企業にとっての焦点は、透かし技術を採用しているかという製品仕様だけではないでしょう。校正、要約、翻訳など、自社で日常的に行う加工を経た文章で、どの程度の手がかりが残るかを見極める必要があります。検出結果だけで制作経緯を判断する運用には、こうした工程上の弱点がつきまといます。
textGrainが言葉の選択に印を付ける仕組み
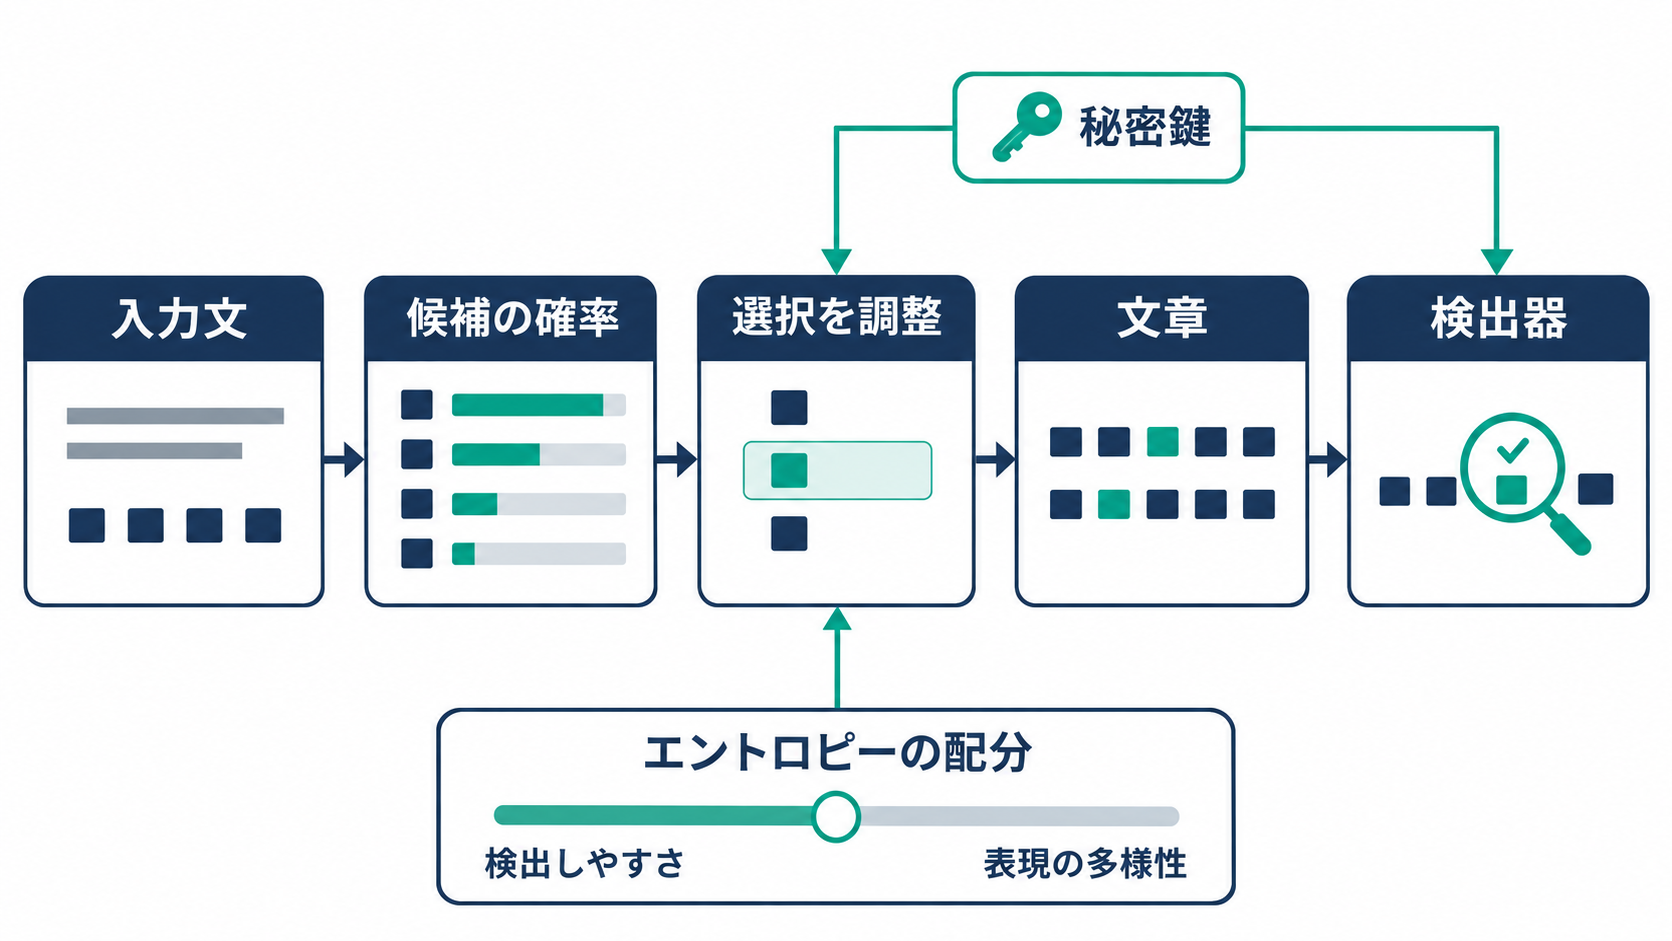
生成AIは、すでに書いた文章を踏まえ、続きに置く候補の確率を計算します。処理の単位になる「トークン」は、単語全体の場合もあれば、単語の一部分の場合もあります。例えば「今日の天気は」に続く表現として、暖かさや涼しさを示す複数の候補を比較し、その中から選ぶ処理を繰り返して文章を作ります。
文章透かしは、この選択に秘密鍵に基づく規則を加えます。秘密鍵から数学的に作る擬似乱数を使い、候補の選ばれ方に一定の偏りを持たせる仕組みです。一つの単語だけを見ても分かりませんが、文章全体を調べると、同じ鍵を使う検出器が統計的なパターンを探せます。目に見えるロゴを重ねる画像の透かしとは、印の付け方が異なります。
textGrainの特徴は、言葉の選択がどれほど予測しにくいかを表す「エントロピー」を、配分できる資源として扱う点です。技術報告の共著者で、米ペンシルベニア大学の博士研究員であるXiang Li氏は、透かしの埋め込みに使う資源の量を調整できると説明しています。開発者は目標を指定し、検出しやすい信号を残すことと、出力表現の多様性を保つことのバランスを制御します。
ここで調整しているのは、文章に付ける目印の性質です。内容の正確さを証明したり、人間による確認を代替したりする仕組みではありません。また、エントロピーを管理できるからといって、編集への耐性まで保証されるわけではありません。生成時の制御と、生成後の追跡性能は、分けて評価する必要があります。
短い文章ほど難しくなる検出と、日本語への注意点
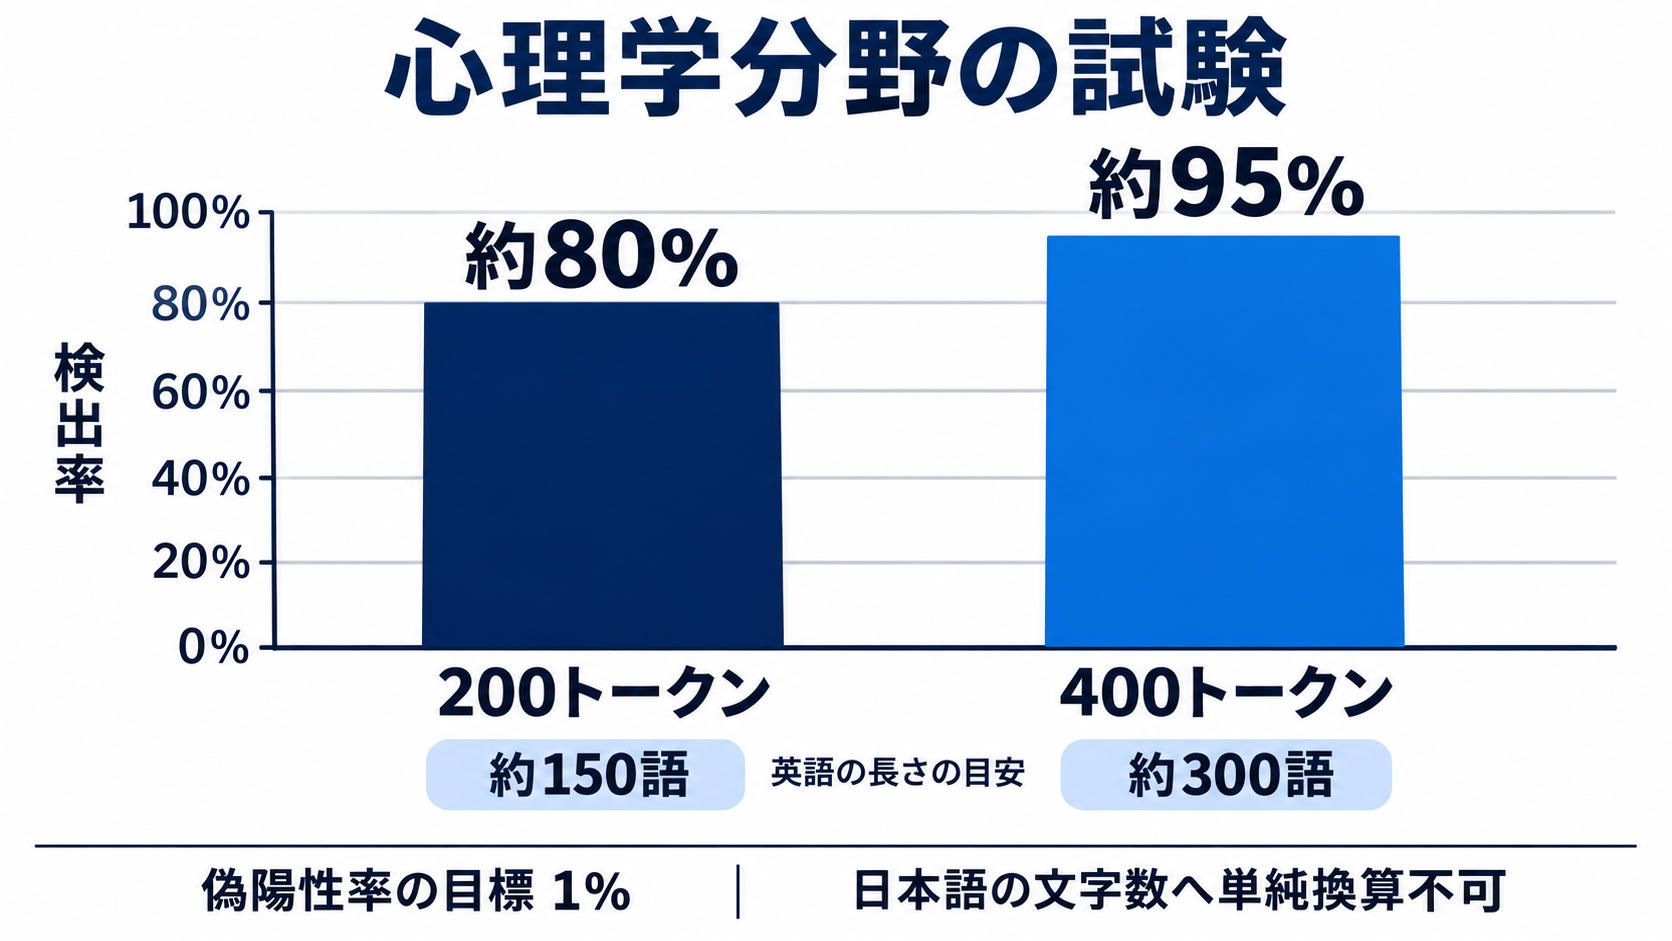
文章透かしの検出には、判断材料となる一定量のテキストが必要です。OpenAIが、オンライン掲示板Redditの質問・回答を集めたELI5データベースの心理学分野の質問を使って試験したところ、200トークンの文章では約80%、400トークンでは約95%の透かしを検出しました。英語では、それぞれ約150語、約300語に相当する長さです。
この試験は、透かしのない文章を誤って検出する「偽陽性」の目標率を1%に設定しています。偽陽性と、透かしを見逃す「偽陰性」は別の指標です。偽陽性率が1%だからといって、個々の陽性判定が99%の確率で正しいという意味にはなりません。判定対象に透かし付き文章がどの程度含まれるかも、結果の受け止め方に関わります。
Li氏は、短い文章では信頼できる検出に必要な証拠が十分に含まれない場合があり、計算量を増やしても解決が難しいと説明しています。長い文章ほど信号を集めやすいという性質は、短い製品紹介、メールの一節、見出しなどを扱う企業には無視できない条件でしょう。短文での陰性判定には、特に慎重な解釈が求められます。
日本語の運用では、英語の語数を文字数にそのまま置き換えないことも必要です。語とトークンは異なる単位であり、英語で約150語という目安から、日本語で必要な長さを一意には決められません。今回示された数値だけで、日本語の広報文や技術文書でも同じ検出率になるとは判断できないためです。導入時には、言語、文章の長さ、対象分野をそろえた評価条件を確認したいところです。
類義語への置き換えが、複数の位置の信号を崩す理由
編集による検出率の低下は、変更した単語の分だけ印が消えるという単純な現象ではありません。Li氏によると、透かしはそれまでのトークンに依存するため、一つの単語の変更が、複数の位置にある信号を乱す場合があります。文章の意味を保つ修正であっても、検出器が探す統計的な並びは変わり得ます。
OpenAIが示した400トークンの置き換え試験は、この問題を具体的に表しています。編集前の検出率92%に対し、10%の類義語置換では66%、25%の置換では17%でした。ただし、別の長さ比較試験で示された400トークンの約95%とは、評価条件を区別する必要があります。異なる試験の数字をつなぎ、一つの性能曲線のように扱うのは適切ではありません。
実務上は、検出できなかった理由を一つに決めつけないことが大切です。そもそも透かしが付いていない場合もあれば、文章が短い場合や、編集で信号が弱まった場合も考えられます。陰性という結果だけでは、それらを区別できません。反対に、陽性でも、人がどの程度執筆や編集に関わったかは分かりません。
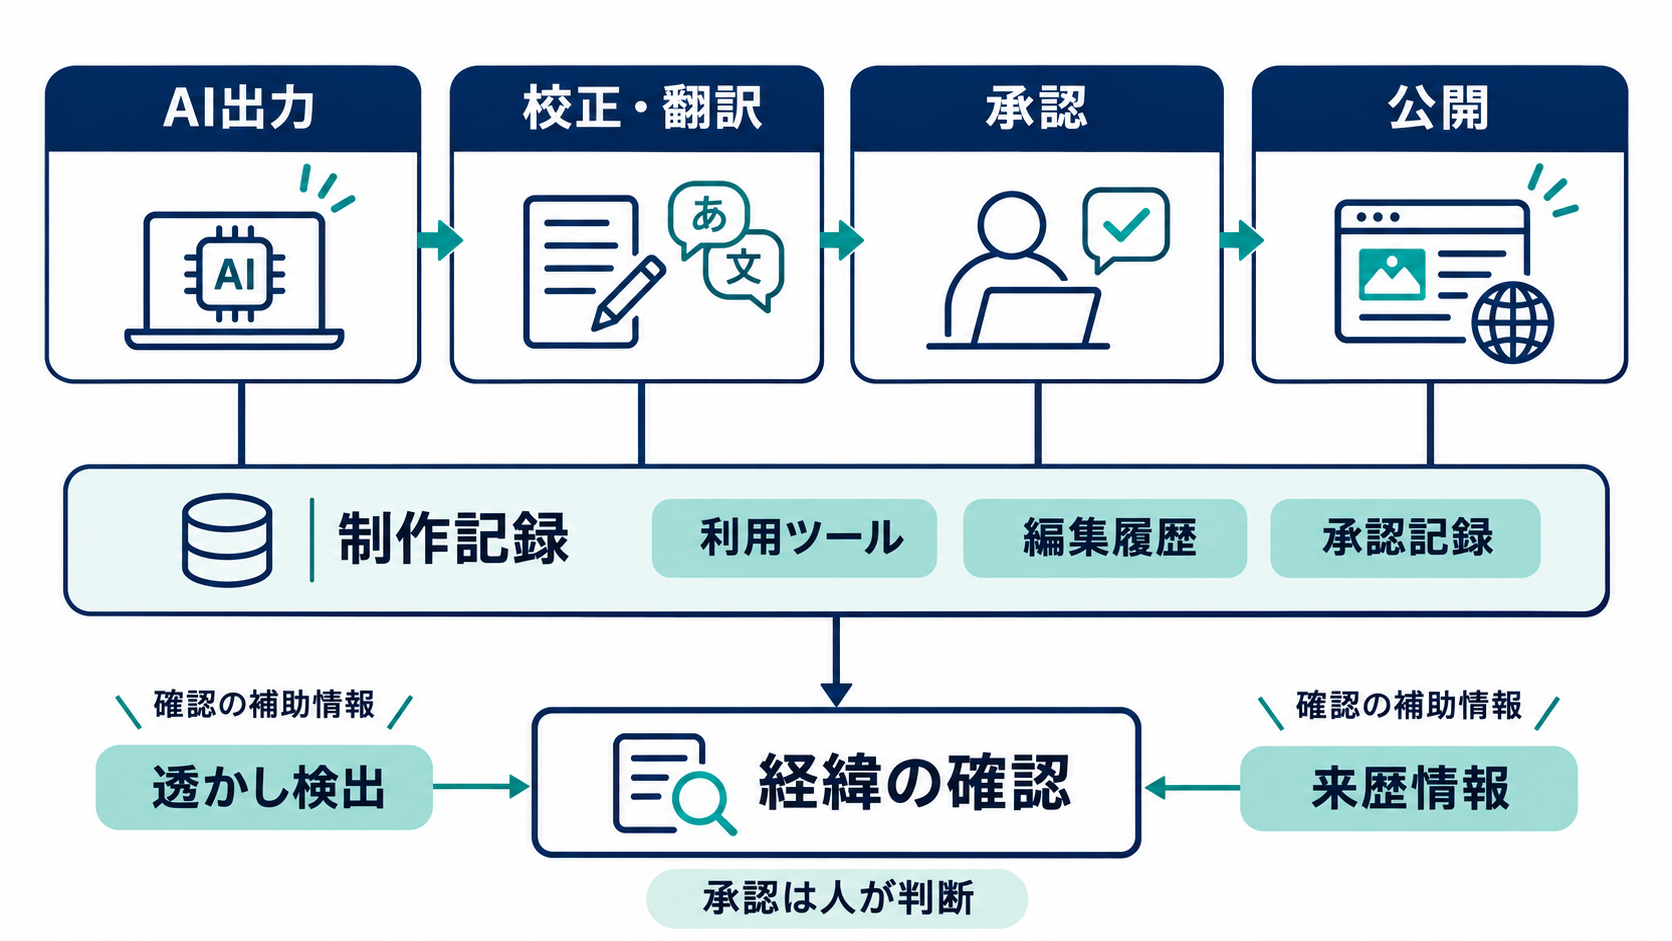
この性質を踏まえると、企業が管理すべき対象は完成稿だけでは足りないでしょう。例えば、AIの出力、編集後の稿、承認済みの公開稿を対応付けて残せば、検出結果に依存せず作業の経緯を確認できます。これは運用上の提案ですが、人とAIが共同で文章を作る現場では、二者択一の判定よりも説明に役立つと考えられます。透かしはその記録に加える手がかりとして位置づけるのが現実的です。
EUが求める透明性と、適合判断に残る不確実性
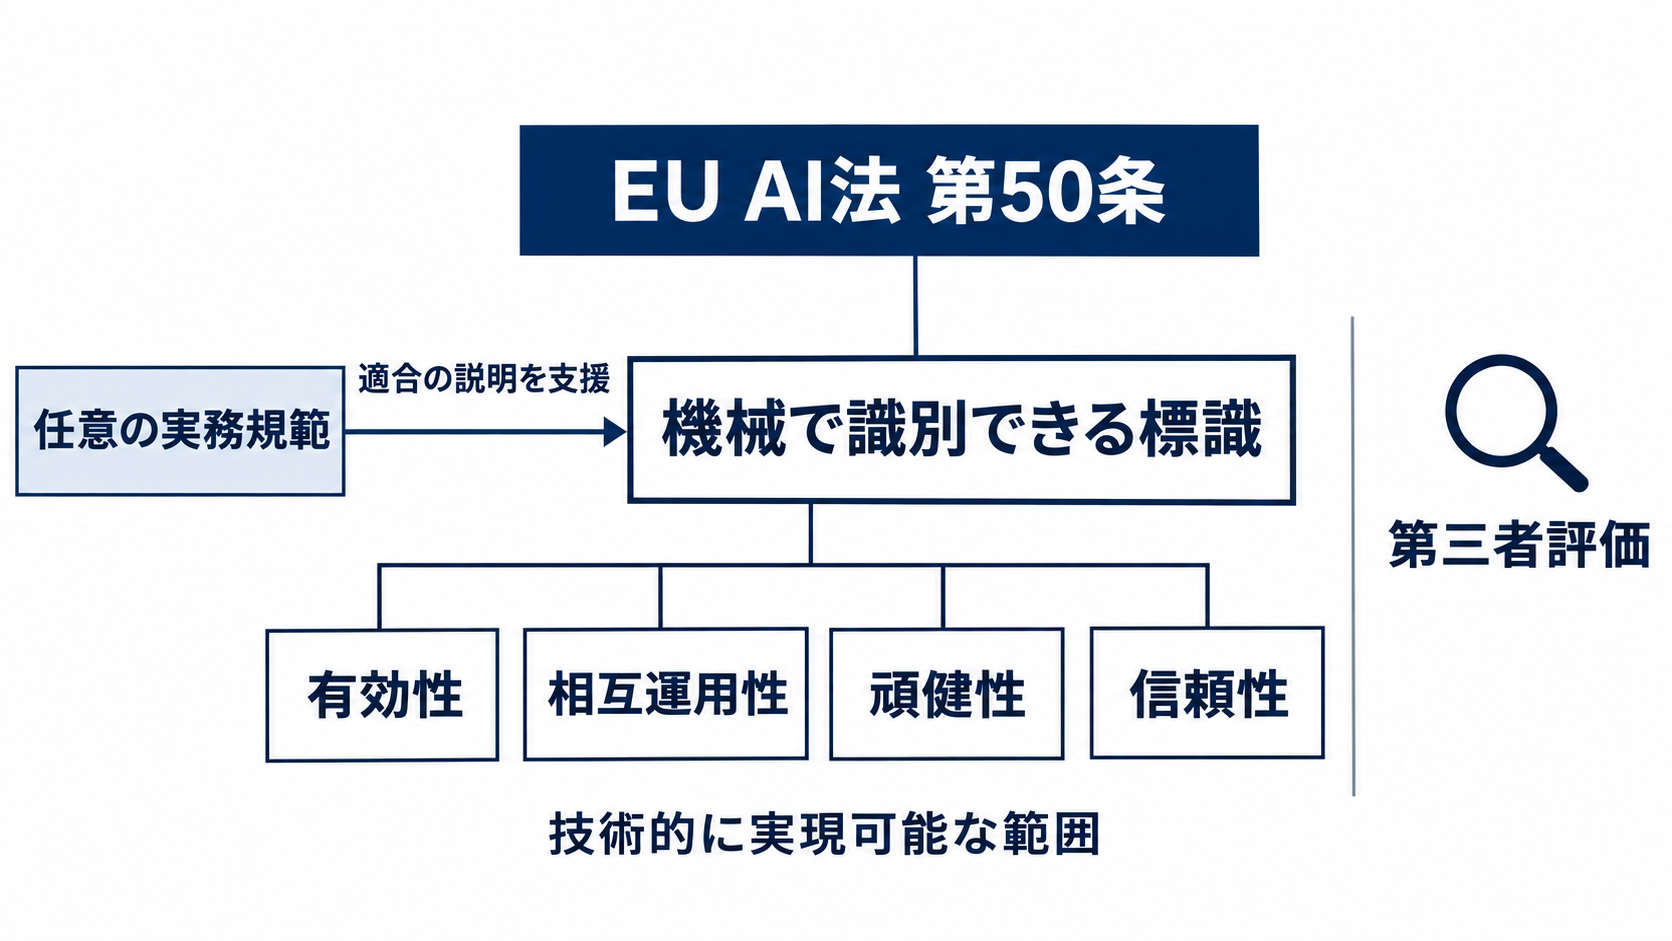
EUのAI法第50条は、合成された音声、画像、動画、文章を生成するシステムの提供者に対し、出力を機械可読な形式で標識し、人工的に生成または操作されたものとして検出できるよう求めています。透明性に関する義務は2026年8月2日から適用されています。法文は、技術的に実現可能な範囲で、有効性、相互運用性、頑健性、信頼性を備えるよう定めています。欧州委員会の第50条解説
このため、「EUはすべてのAI文章に、必ず消えない透かしを要求している」と理解すると、制度と技術の両方を単純化してしまいます。問われるのは識別を可能にする措置であり、技術上の限界も条文に織り込まれています。実務規範は、事業者が適合を示すための任意の枠組みです。法律上の義務と、実務規範への参加は区別しなければなりません。
パリの高等研究機関でAI倫理を研究するThomas Souverain氏は、textGrainの初期の方法論には信頼できる面があると評価しつつ、法令適合を判断するには時期尚早とみています。技術報告だけでなく、詳細な検証手順や独立した研究者による評価が必要という立場です。法令が求める性能について、測定可能な基準が十分に定まっていないことも判断を難しくしています。
OpenAIは、自社の試験でGoogle DeepMindの文章透かし「SynthID Text」と同等以上の性能を得たと説明しています。ただし、企業内の比較試験と第三者による再現検証は役割が異なります。購入側の企業は、競合製品より優れているという説明だけで法令適合まで推定せず、試験条件、検証主体、適合判断の根拠を個別に確認する必要があります。
日本企業は、検出器より先に制作記録を整える
日本企業がtextGrainを評価する際には、「AIの文章を見抜けるか」から、「自社の制作工程を説明できるか」へ問いを広げると、必要な対策が明確になります。翻訳や校正を重ねた文章で透かしが見つからなくても、制作時の記録が残っていれば、利用したツールや担当者の修正を確認できます。完成稿への検査だけに依存する運用では、この説明が難しくなります。
OpenAIも、文章透かしだけではAI生成かどうかを判断するのに十分ではないとしています。同社は、メタデータに含める来歴情報など、ほかの手段と組み合わせる考え方を示しています。メタデータはファイルなどに付随する情報、文章透かしは言葉の選択に含まれる信号です。保存される場所が違うため、それぞれが自社の配信経路でどのように扱われるかを確認する意味があります。
第三者評価では、言語や分野をまたいだ性能も焦点になります。検証に参加するスロバキアの研究機関KInITのDominik Macko氏は、異なる主題、言語、文章の長さに対する頑健性を試験する計画を示しています。アクセスを得た時点では評価をまだ始めていなかったため、こうした検証の計画と、すでに確認された成果を混同しない姿勢が必要でしょう。
着手するなら、自社で繰り返し作る文書を一種類選ぶ方法が考えられます。例えば製品紹介文について、AI出力から校正、翻訳、承認、公開までの各段階で何を保存しているかを洗い出します。そのうえで提供元に、該当する言語と長さでの検出性能、編集後の制約を確認します。透かしの採否を決める前に、判定が外れた場合でも制作経緯を説明できる状態を整えることが、具体的な一歩になります。