

2026/11/18
AIニュース
GPU学習はいつ終わる?272件の実運用データで見えた、追加学習の時間予測を改善する鍵
この記事の要点
Dharma-AIは、共有H200環境での272件の追加学習を分析し、実行前の設定だけを使うCatBoostで所要時間の平均絶対誤差を1.71時間に抑えました。評価やチェックポイント保存まで見積もる設計が特徴です。ただし、他のGPUへの適用や60時間を超えるジョブには課題が残ります。
目次
GPUの予定を狂わせる「計算時間」と「完了時間」の差
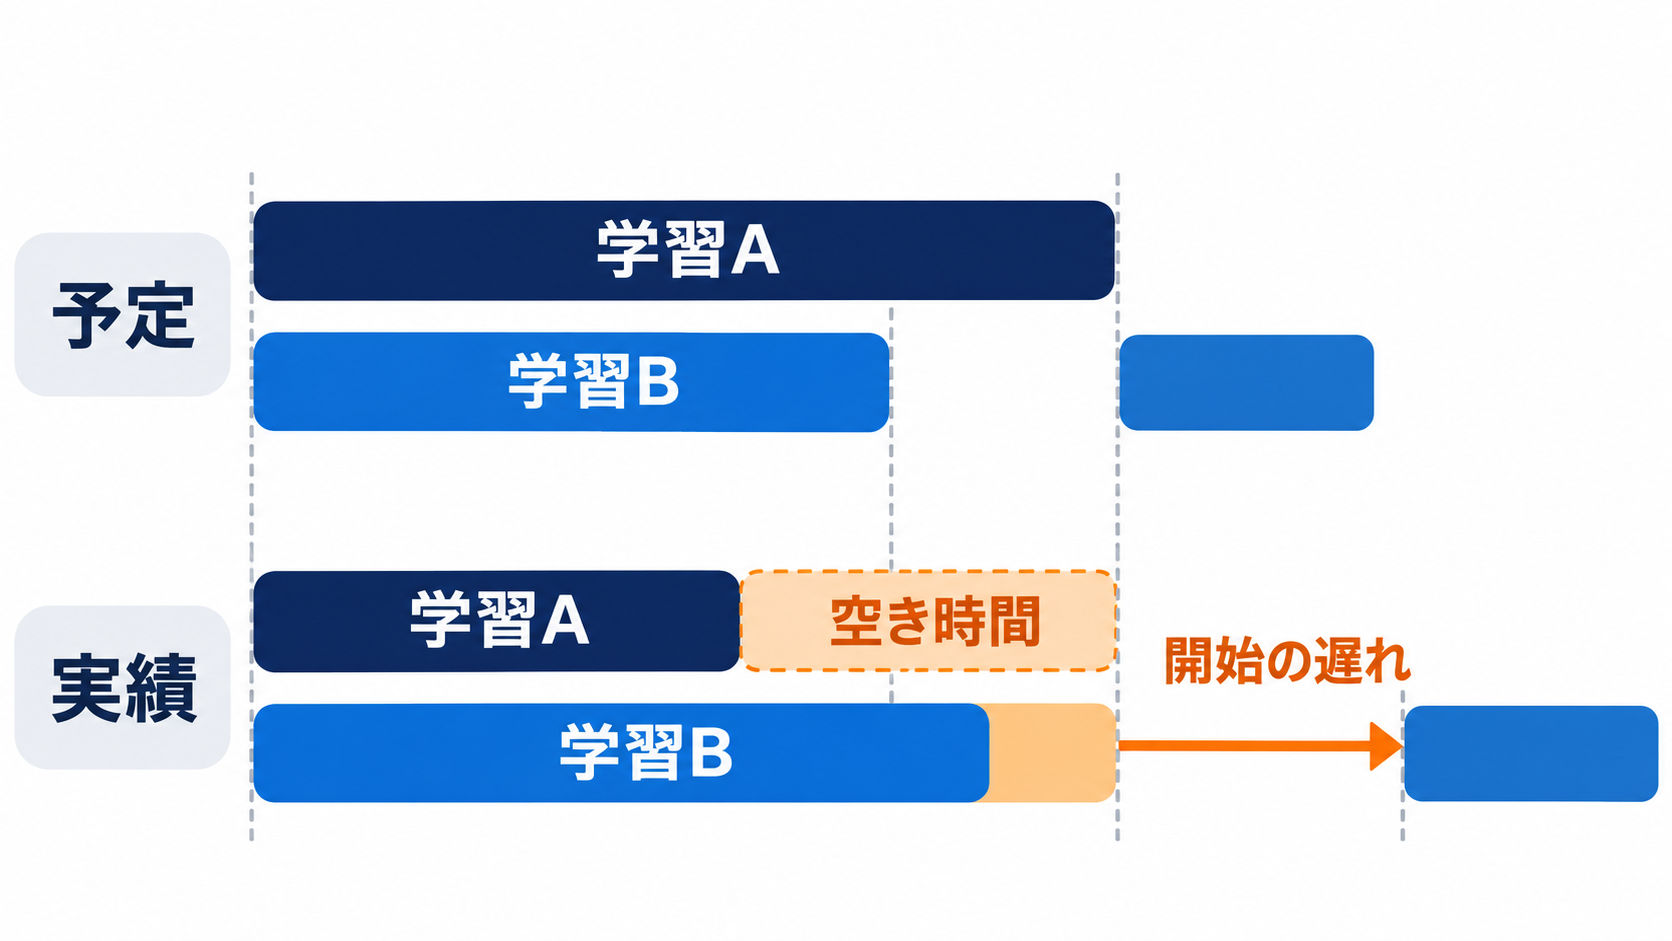
追加学習が終わるはずの時刻になっても、次の実験にGPUを回せません。反対に、予定より早く処理が終わり、次のジョブが投入されるまでGPUが空いてしまうこともあります。複数のチームでGPUを共有する企業にとって、学習時間の見積もりは、設備の稼働率と開発日程の両方に関わる問題です。
Dharma-AIがHugging Face上で公開した研究紹介は、この見積もりのずれに焦点を当てています。対象は、企業の本番環境で実行された272件の教師あり追加学習、いわゆるSFTです。SFTは、入力と望ましい出力の組を使い、言語モデルを特定の業務や応答形式に適応させる学習手法を指します。
同チームは、NVIDIA H200を使った合計約7,382 GPU時間の実行記録から、計算量に基づく見積もりと、過去の実績から学ぶ予測モデルを比較しました。注目したいのは、学習の計算処理だけでなく、GPUが割り当てられてからジョブ全体が終了するまでの経過時間を予測している点です。GPUの割り当てを待つキュー時間は含みません。
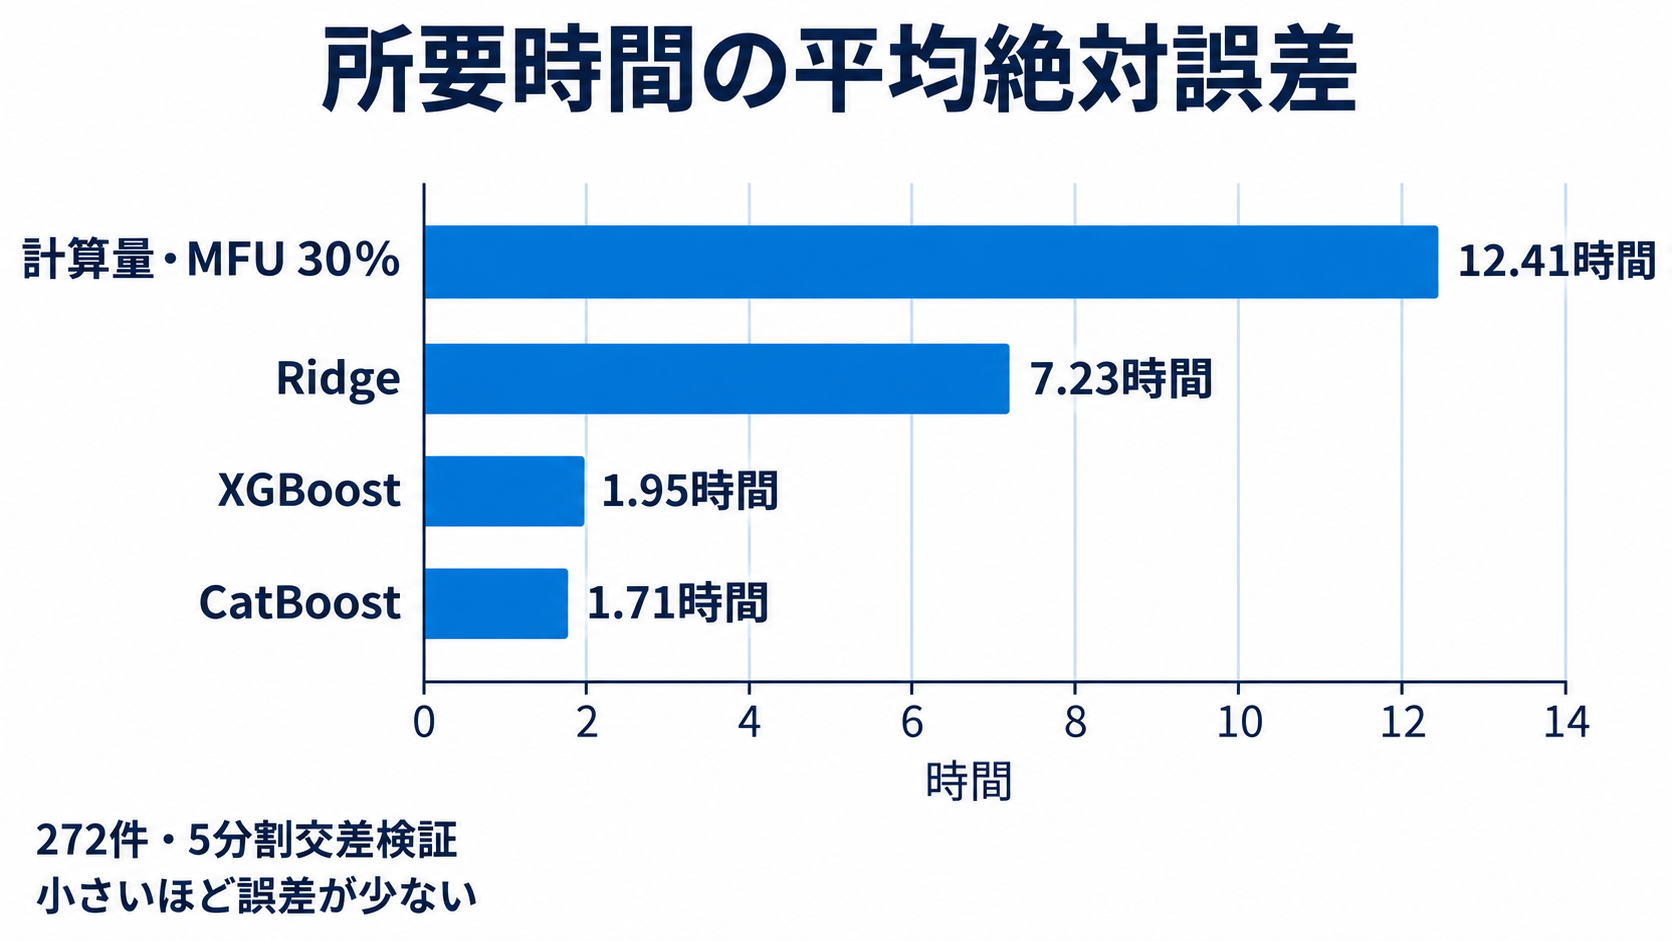
結果として、計算量に基づく比較対象の平均絶対誤差は12.41時間だったのに対し、機械学習モデルのCatBoostでは1.71時間まで縮まりました。ただし、これは同じ実行データを使った交差検証の成績です。あらゆる企業のGPU環境で、そのまま同じ精度が得られることを意味しません。
この研究が企業の運用担当者に示す中心的な論点は、モデルの大きさや学習データ量だけでは、終了時刻を十分に説明できないということです。評価や保存を含む実際の仕事全体を見積もりに取り込むことで、GPUの配置計画を改善できる可能性が見えてきます。
計算量の式から抜け落ちる、評価・保存・準備の時間
密な構造を持つTransformerでは、学習に必要な浮動小数点演算の回数を、おおむね「6×パラメーター数×学習トークン数」で近似できます。トークンは、モデルが文章を処理するときの単位です。この演算量をGPU台数と処理能力で割ると、学習時間の理論的な目安が得られます。
ただし、GPUの仕様表に記載された最大性能が、学習中にそのまま出るわけではありません。そこで使われるのが、理論上の演算性能をどの程度引き出せているかを表すMFUです。Dharma-AIは、メモリーへのアクセス、GPU間通信、処理の実装効率などによって性能が制約され、MFUは一般に30〜60%程度になると説明しています。個々のジョブに適した値は、実行前には分かりません。
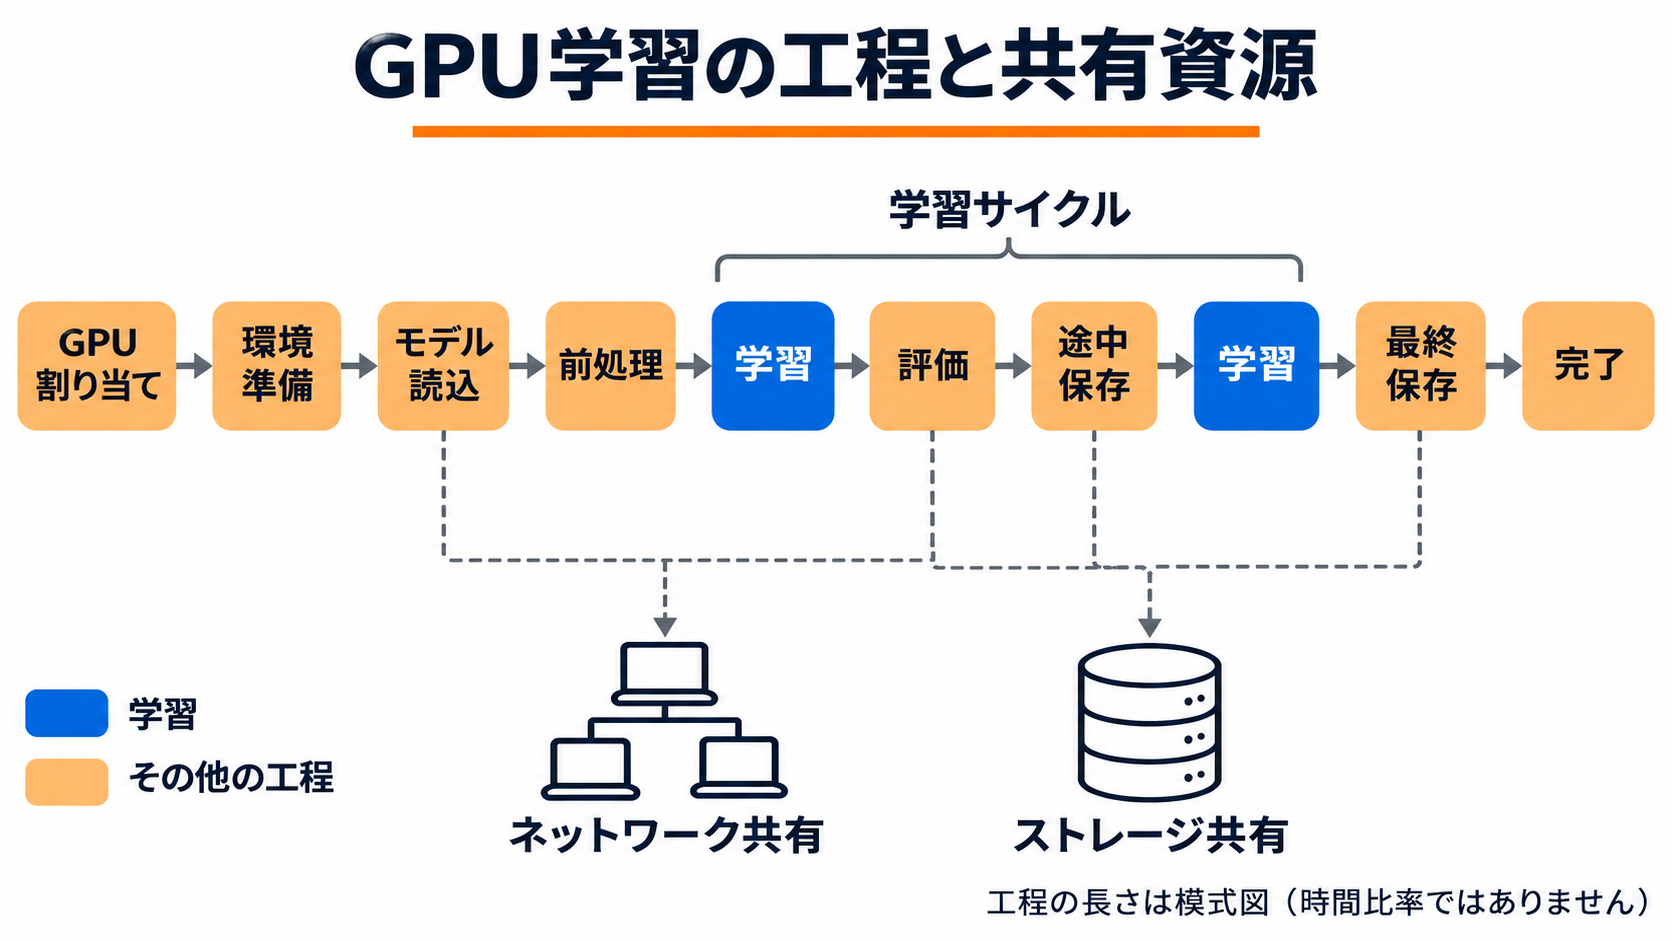
それでも、この式で主に捉えられるのは学習ループの計算時間です。実際のジョブには、実行環境の準備、モデルのダウンロードと読み込み、文章をトークンに分割する前処理があります。学習が始まってからも、途中の性能評価やチェックポイントの保存が入り、終了時には最終モデルをストレージへ転送します。
チェックポイントは、学習途中のモデルの状態を保存したものです。障害からの再開や学習結果の比較に役立ちますが、保存対象が大きければデータの書き出しや転送も発生します。複数のジョブが同じネットワークやストレージを利用していれば、それぞれが使える処理能力も一定ではありません。
したがって、演算量が同じ二つのジョブでも、評価や保存の設定によって終了時刻が数時間違うことがあります。比較の公平性を保つため、Dharma-AIは計算量による見積もりにも予定された評価トークンを含め、MFUも広い範囲で検証しました。それでも残った誤差は、MFUの調整だけでは埋められない運用上の時間があることを示唆しています。
実行前の設定だけで、ジョブ全体の所要時間を予測
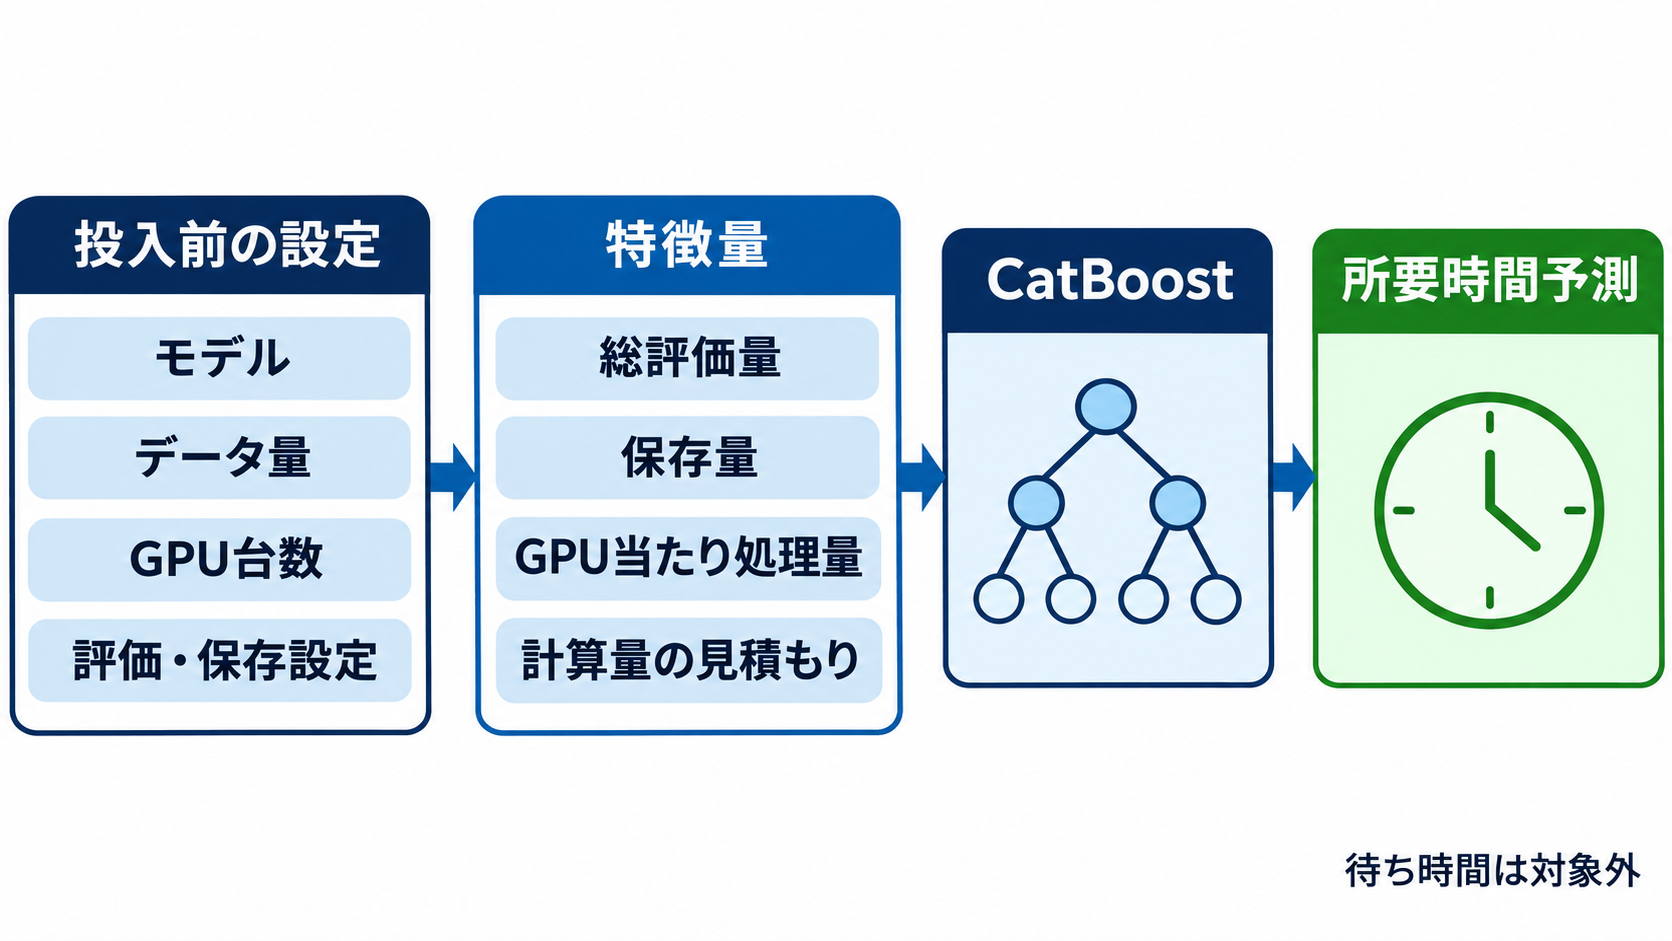
予測の仕組みは、ジョブの設定とモデルの情報から、終了までの時間を推定する回帰モデルです。回帰とは、分類先を選ぶのではなく、時間や金額のような数値を予測する方法を指します。今回の設計では、ジョブをGPUへ投入する前に分かる情報だけを入力に使いました。
この条件は、スケジューラーでの利用を考えるうえで欠かせません。実行中のログや途中経過を見れば予測に役立つ情報は増えますが、ジョブをいつ、どのGPUで動かすかを決める段階では利用できないためです。Dharma-AIは、ハイパーパラメーター、データセットの規模、モデル識別子、GPUの割り当てなどから特徴量を作っています。
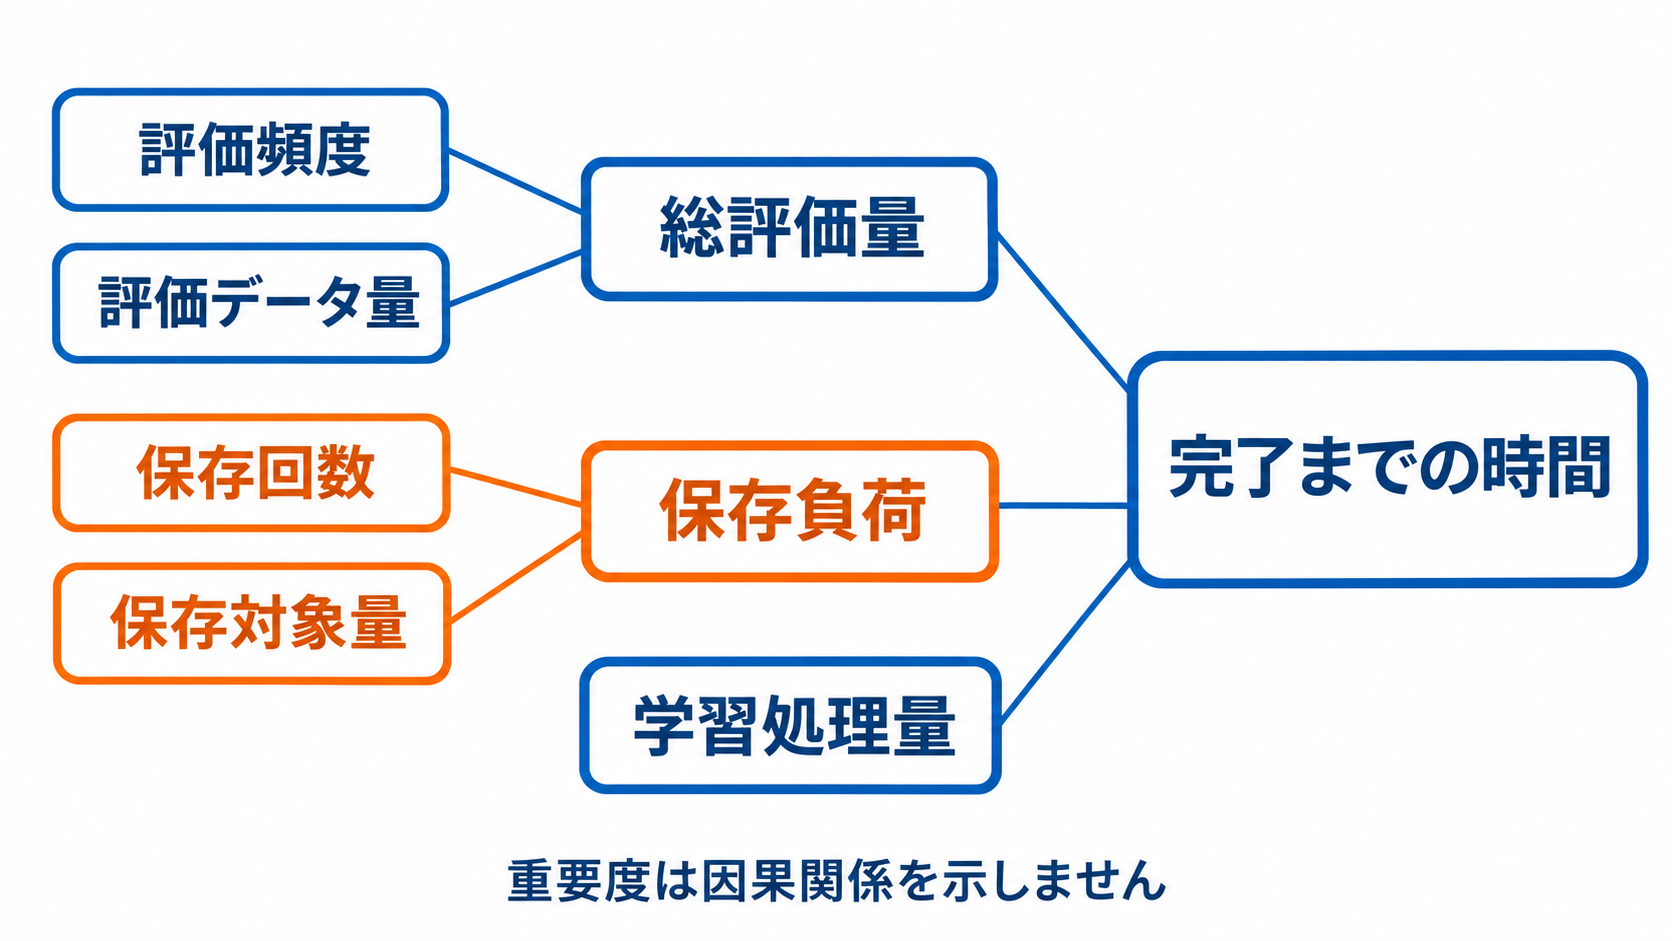
特徴量とは、予測モデルが判断に使う入力項目です。今回の工夫は、生の設定値に加え、ジョブ全体で処理する評価サンプル数、保存回数、保存対象のパラメーター量、GPU当たりのトークン量などを算出したことにあります。評価頻度だけを見るより、評価データの規模や実施回数を合わせて見るほうが、実際の処理負荷を表しやすいという考え方です。
計算量による見積もりも捨てていません。MFUを0.45に固定した推定時間を一つの特徴量として入力し、そこに必要な補正を学習させています。物理的な計算の目安と、運用履歴に現れる傾向を組み合わせた構成です。
比較対象は線形回帰、Ridge、XGBoost、CatBoostでした。後者の二つは、決定木を段階的に組み合わせて予測を改善する勾配ブースティングの手法です。単純な比例関係では表しにくい、複数の設定の組み合わせによる影響を扱えます。研究チームは18種類の特徴量セットを比較し、平均絶対誤差を基準とする設定探索を経て、最終的に24個の特徴量を使うCatBoostを採用しました。
平均誤差1.71時間という結果を、どう読むべきか
実験に使われた272件は、最大150億パラメーターの複数のモデル系列を含みます。追加する小規模なパラメーターを中心に学習するLoRAと、モデル全体のパラメーターを更新するフルファインチューニングの両方が対象です。使用GPUは各ジョブで1台、2台、4台で、共有環境ではほかの学習や推論も動いていました。
ジョブの所要時間は約1.6〜172.4時間と幅があり、平均は23.43時間、中央値は15.29時間です。単一の短い実験を繰り返したデータではありません。学習用ソフトウェアにはHugging Face TransformersとUnslothが使われ、どちらを使ったかも入力項目に含まれています。
評価には、データを五つに分けて学習用と検証用を入れ替える、層化5分割交差検証を使いました。主な結果は次のとおりです。MAEは予測と実測の差の絶対値を平均した指標で、値が小さいほど見積もりのずれが少なくなります。
| 予測手法 | 平均絶対誤差 | 決定係数R² |
| --- | --- | --- |
| 計算量による見積もり、MFU 30% | 12.41時間 | 0.31 |
| Ridge | 7.23時間 | 0.73 |
| XGBoost | 1.95時間 | 0.97 |
| CatBoost | 1.71時間 | 0.98 |
CatBoostは各指標の平均値で最も良好でしたが、XGBoostとの差は、どの指標でも標準偏差一つ分の範囲内でした。この結果から、CatBoostだけが突出して優れているとまでは判断できません。設定と所要時間の複雑な関係を扱う手法が、今回のデータに適していたと読むのが妥当でしょう。
誤差の中央値は0.51時間で、予測の80%は2.20時間以内、90%は4.31時間以内のずれに収まりました。平均誤差だけでは、締め切りに対して何時間の余裕が必要かは決められません。運用に使う際には、典型的な誤差と、大きく外れる場合の幅を合わせて確認する必要があります。
評価と保存は「付随処理」では済まない負荷
CatBoostの特徴量重要度で最上位だったのは、ジョブ全体を通じて評価するサンプルの総数でした。学習可能なパラメーター数やモデル全体のパラメーター数に加え、評価時のバッチ設定やチェックポイントの保存量に関わる項目も上位に入っています。モデルの規模だけを見て終了時刻を予測する難しさが、ここにも表れています。
予測への各項目の寄与を調べるSHAPによる分析でも、評価量が多いと予測時間が長くなる傾向が見られました。学習可能なパラメーター数の影響は単純な比例関係ではなく、特に大きなモデルで強く表れています。設定を一つ変えたときの影響が、ほかの条件によって異なることを示す結果です。
ただし、特徴量重要度は原因と結果の証明ではありません。今回のデータでは、GPU台数が多いほど予測時間を押し上げる寄与も見られましたが、研究チームは、大きなジョブに多くのGPUを割り当てていたためと説明しています。「GPUを追加すると遅くなる」という意味ではありません。過去の割り当て方針まで、予測モデルが学習している可能性に注意が必要です。
企業にとっての実務的な示唆は、学習設定のレビュー対象を広げることにあります。たとえば、評価を頻繁に行う設定には、性能の変化を細かく確認する目的があるでしょう。保存回数を増やす設定にも、障害復旧や比較のしやすさという理由があります。単に時間を短くするために減らせば、別の運用要件を損なうかもしれません。
見直すべきなのは、その設定が今回の目的に合っているかです。試行段階と最終確認の学習で、同じ評価頻度や保存方針が必要とは限りません。今回の分析は、こうした設定を慣例のまま使い続けず、品質確認や復旧に必要な条件と、占有時間への影響を一緒に検討する材料になります。
自社で使うなら、予測精度より先に測定範囲をそろえる
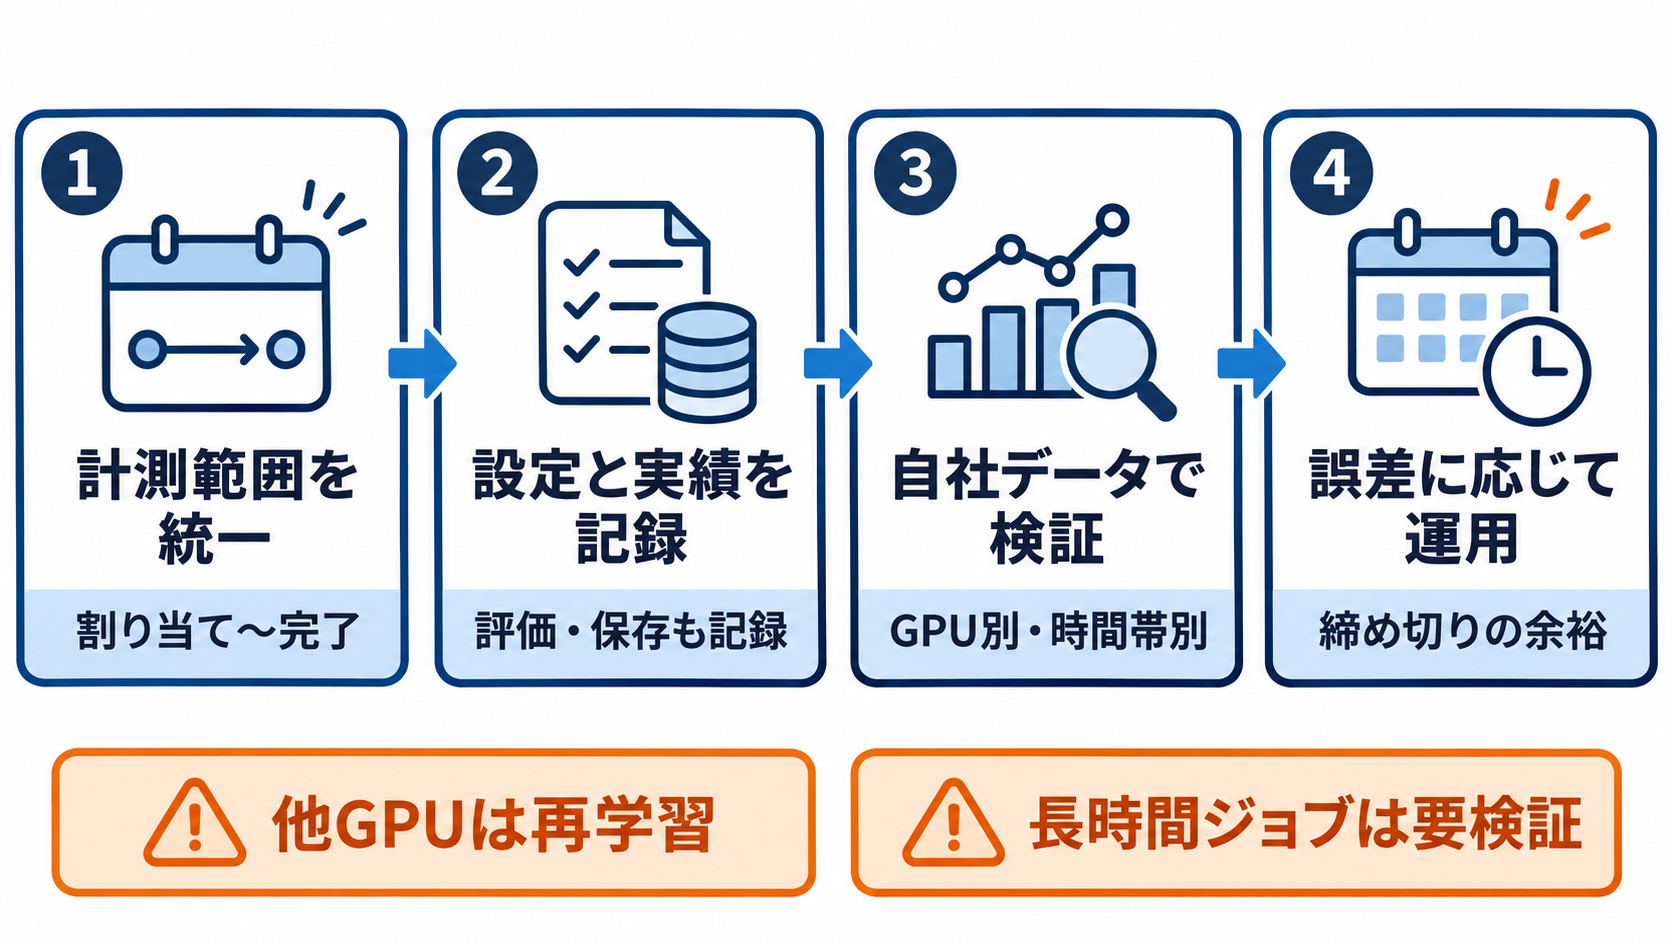
この手法を自社環境で検討するなら、出発点は、ジョブの開始と終了を何で定義するかの統一です。今回の予測対象は、GPUの割り当てからジョブ完了までで、キューでの待機時間は対象外でした。利用者への納期を見積もるには、実行時間の予測に加えて、いつGPUが空くかという運用側の判断も必要になります。
導入を考える際は、投入時の設定と、同じ基準で計測した実績時間を対応付けて残すことが、具体的な一歩になります。学習データ量やGPU台数だけでなく、評価設定、保存方針、利用ソフトウェアも記録できれば、計算量の見積もりから外れる理由を検討しやすくなるでしょう。これは今回の結果を踏まえた運用上の提案であり、実験で導入効果が確認された手順ではありません。
適用範囲にも制約があります。対象はSFTだけで、人間のフィードバックなどを使うRLHF、選好データを使うDPO、検証可能な報酬を使うRLVRといった別の学習方式は含まれません。GPUもすべてH200です。異なる世代のGPUへ予測値をそのまま移すことはできず、研究チームは再学習の必要性を示しています。異種GPUを混ぜる環境では、演算性能、メモリー容量と帯域、GPU間の接続構成なども考慮する必要があります。
長時間ジョブの精度も課題です。60時間を超えた実行は13件しかなく、この範囲の絶対誤差の中央値は5.19時間、90パーセンタイルは18.51時間でした。全体の平均誤差1.71時間を、そのまま長時間の重要案件に当てはめるのは適切ではありません。自社の運用で重視する時間帯に分けて、誤差の広がりを確認するべきです。
Dharma-AIは、研究紹介の公開時点で、特徴量の計算式や探索条件などを含む論文の完全版をarXivに公開する予定としています。自社での検討では、既存の見積もりと実績を照合し、特にずれが大きいジョブの評価・保存・準備工程を洗い出してみてください。予測モデルの導入判断に先立ち、自社が何にGPU時間を使っているかを把握する材料になります。