
2026/11/07
AIニュース
NVIDIAのDory 1.0 4B、同じモデルで推論の計算量を4段階に調整する仕組み
この記事の要点
NVIDIAのDory 1.0 4Bは、共有する内部ブロックの反復回数を1〜4回に変え、再学習せずに推論の計算量を調整できる小型モデルです。反復による処理負荷とKVキャッシュ容量の変化、モデル内の既定値と推奨設定の違いを整理し、日本企業が回答品質と所要時間を比較するための評価方法を紹介します。
目次
約40億パラメータのモデルに設けられた「計算量のつまみ」
社内向けAIを動かすとき、短い問い合わせにも複雑な計算問題にも、同じ計算資源を割り当てるべきでしょうか。応答速度と回答品質の兼ね合いを考えるうえで、NVIDIAのNemotron Labsによる小型推論モデル「Dory 1.0 4B」は、モデル内部の処理を繰り返す回数を変えるという選択肢を示しています。モデルの重みを追加したり、設定ごとに再学習したりせず、1つの学習済みモデルを4段階の計算予算で動かせる構造です。
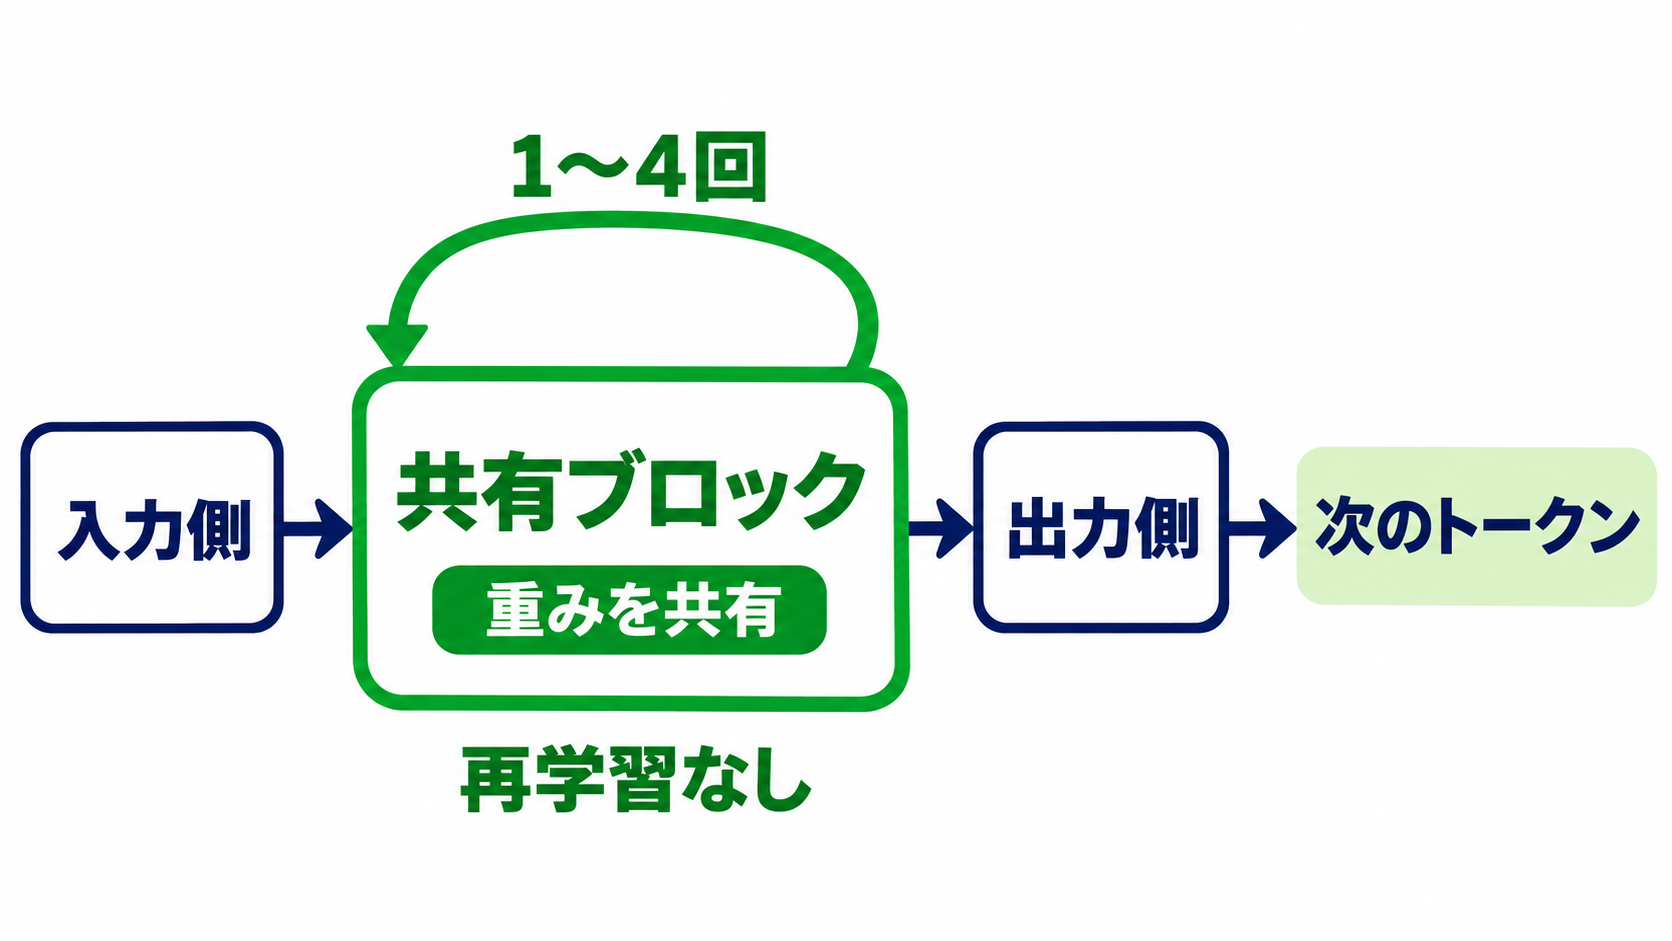
Doryでは、入力側と出力側の層の間に、重みを共有する反復ブロックを置いています。生成するトークンごとに、この中央部分を1〜4回通過させます。トークンは文章を処理する単位で、日本語では必ずしも1文字や1単語と一致しません。反復回数を増やすと、同じ重みを使う処理が増えるため、保存するパラメータ数を変えずに、トークン当たりの計算量を引き上げられます。
企業利用で注目したいのは、モデルの保管容量と、実行時に必要な計算資源を分けて考えられる点です。ただし、反復回数を増やせば、どの業務でも回答が改善するとは限りません。提示された検証内容から確認できるのは、構造に基づく負荷の予測と、設定を確かめる方法です。回答品質の向上率まで確定した情報として扱うことはできません。Doryを評価する際には、「最大の4回で動かす」ことよりも、「対象業務に必要な反復回数を測る」ことが出発点になります。

重みの共有で減らせる容量と、減らせない処理負荷
DoryのGGUFファイルを解析した結果では、モデル全体のパラメータ数は約39.8億で、そのうち約18.4億が共有する反復ブロックに含まれています。GGUFは、モデルの重みと構造などの情報を格納するファイル形式です。ここでの要点は、中央の約18.4億パラメータを、反復回数に応じて別々に保存する必要がないことです。4回反復しても、保存上のモデルが4倍の大きさになるわけではありません。
層の数え方にも注意が必要です。ファイル内の72個の層エントリーは、入力側16、反復部分40、出力側16に分かれています。ただし、これらは注意機構とMLPのエントリーが交互に並ぶ構成で、それぞれ8、20、8組に相当します。注意機構は入力のどの部分を参照するかを扱い、MLPは各位置の表現を変換する処理を担います。数字だけを見て、72個の同一構造のブロックがあると解釈すると、計算負荷を読み違えるおそれがあります。
構造から算出した比較では、4回反復は1回反復に対して、トークン当たりに適用するパラメータ量が2.51倍、重みの読み出し量が2.28倍になります。入力側と出力側など、反復回数によらず処理する部分もあるため、全体が単純に4倍になる計算ではありません。ただし、この倍率は実測した応答時間の倍率とは異なります。重みをメモリーから読み出す速度が制約になる環境では、読み出し量が性能を考える手掛かりになりますが、実際の速度はハードウェアや実装にも左右されます。容量が小さいことと、どの設定でも軽快に動くことは、分けて評価する必要があります。
モデルファイルの既定値は4回、推奨設定は2回
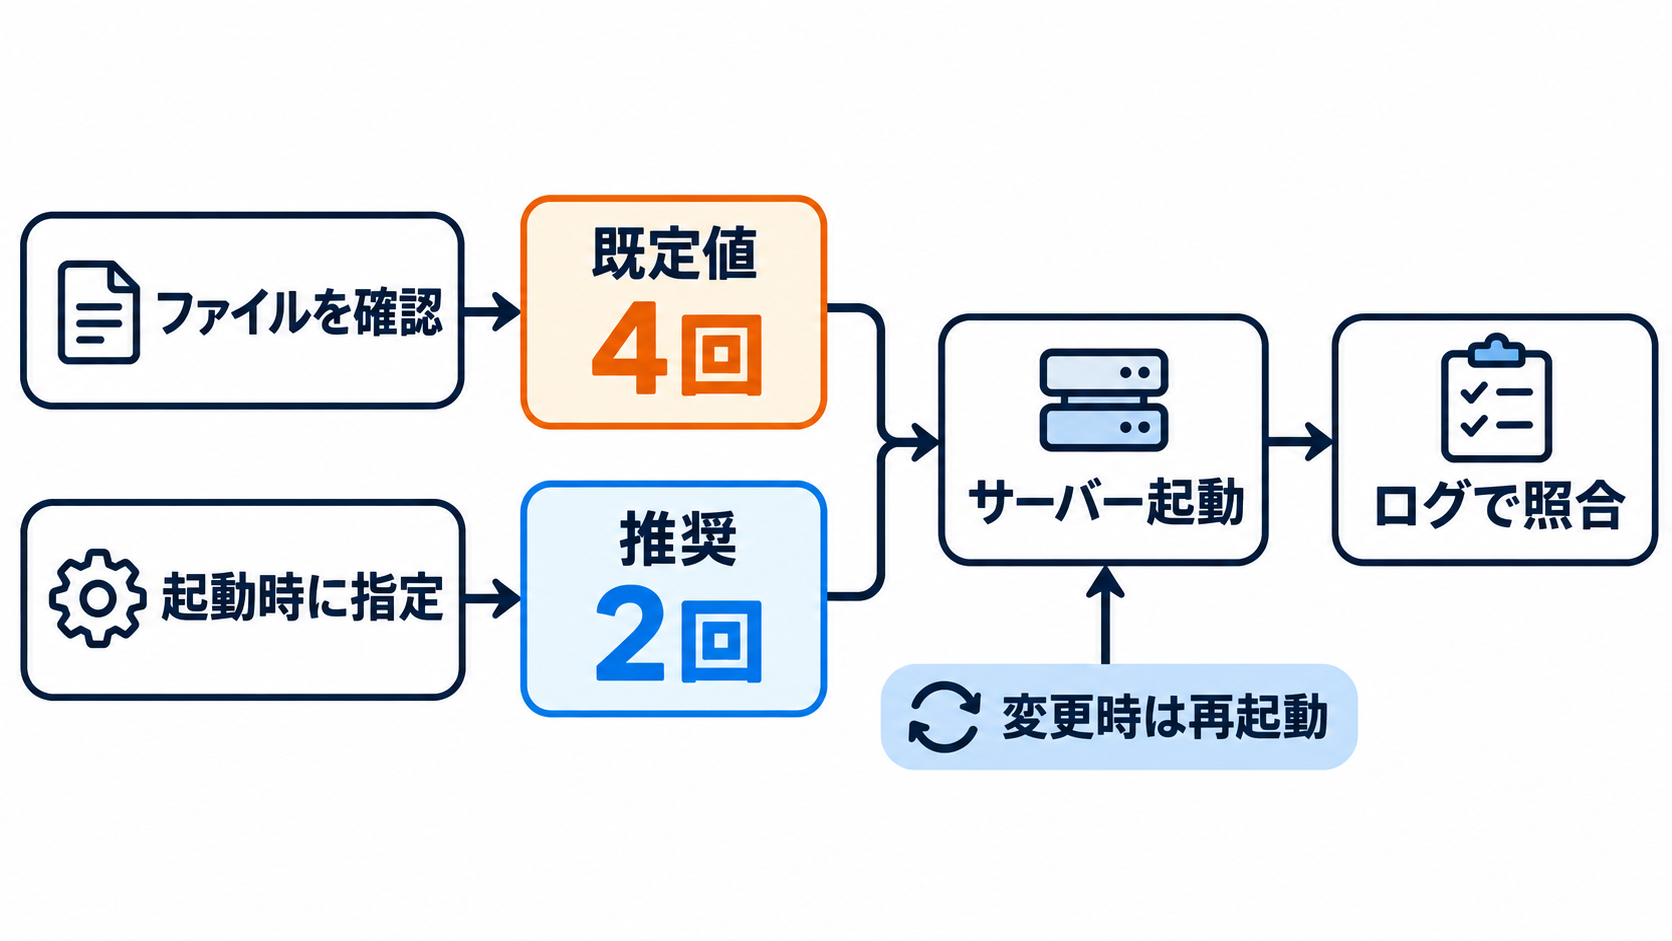
試験導入で見落としやすいのが、モデルファイルの既定値と、モデルカードが推奨する設定の違いです。モデルカードは、開発元が使い方や動作条件などを公開する説明資料です。今回提示された検証では、GGUFに記録された反復回数は4回ですが、NVIDIAのモデルカードは2回を推奨しています。上書きせずに起動すると、意図せず最も計算負荷の高い設定で動く可能性があります。
検証コードは、起動時の`--override-kv`で反復回数とキャッシュ方式を指定しています。例えば、`dory.num_loops=int:2`は反復回数を2回に設定する指定です。ここでいう上書きはモデルの再学習ではなく、読み込み時に実行条件を変える操作に当たります。反復回数とキャッシュ方式はモデルの読み込み時に決まるため、提示された手順では、設定を変えるたびにサーバーを起動し直しています。
この仕組みは、利用者からの要求ごとに反復回数を自由に切り替える運用が、そのまま実現していることを意味しません。今回の実装で条件を比較するには、設定ごとのサーバープロセスが必要です。応答速度を測る場合も、起動コマンドだけでなく、実際に適用された設定をログで確かめるべきでしょう。検証コードは、反復回数に応じて変化するキャッシュの層数を予測し、サーバーが報告する値と照合する設計です。社内の評価記録にも反復回数を残しておけば、同じモデル名なのに結果が違うという混乱を減らせます。既定値に任せず、推奨値を明示して比較を始めることが、再現性のある測定につながります。
KVキャッシュの節約は、回答の検証と組み合わせる必要
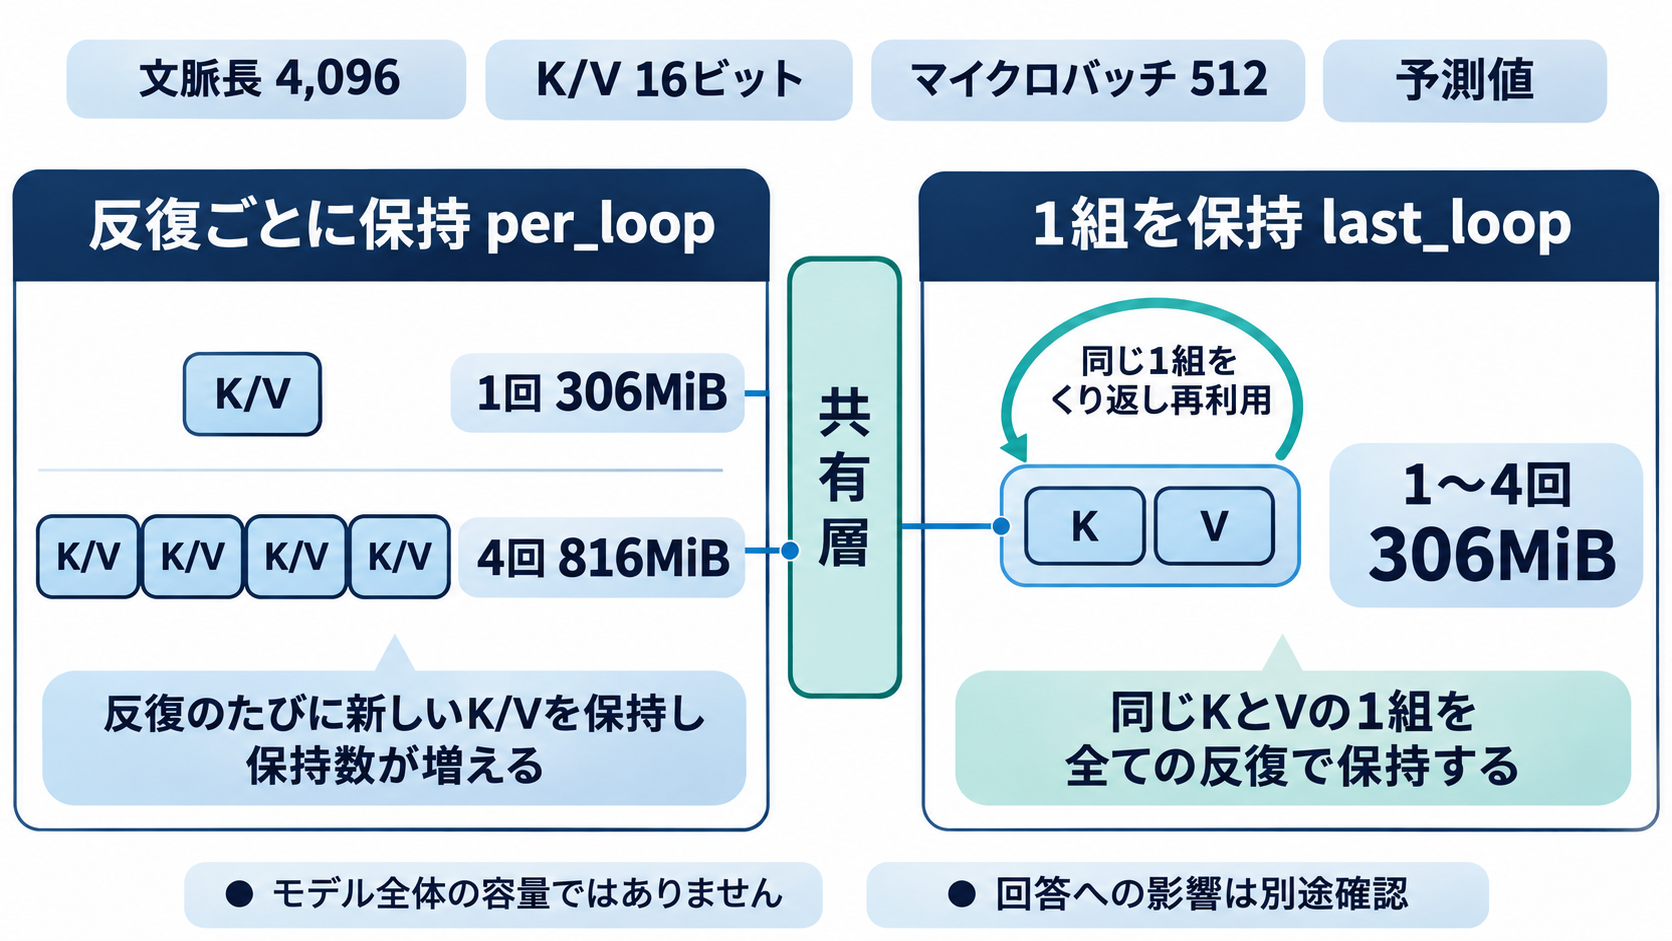
生成AIの必要メモリーは、モデルの重みだけでは決まりません。文章を生成する途中で、それまでのトークンに関する情報を保持する「KVキャッシュ」も使います。過去の処理結果を再利用するための領域で、扱う文脈の長さやモデル構造、実行方式によって必要量が変わります。Doryでは中央部分を繰り返すため、その反復に対応する情報をどう保存するかも、メモリー使用量を左右します。
提示された実装には、反復ごとに個別のキャッシュを保持する`per_loop`と、反復部分について1組のキャッシュを使う`last_loop`があります。文脈長4,096トークン、キーと値を16ビット浮動小数点で保持し、マイクロバッチを512に設定した条件では、`per_loop`の予測容量は1回反復で306MiB、4回で816MiBです。`last_loop`は反復回数によらず306MiBにとどまる計算になります。これらはキャッシュ部分の値で、モデル全体の使用メモリーではありません。
この差を見ると、限られたメモリーで動かす場合には`last_loop`が魅力的に映るかもしれません。ただし、容量を節約できることと、出力への影響がないことは別の論点です。提示されたチュートリアルも、キャッシュ方式を変えたときに予測が変わるかを検証項目に含めていますが、提供された範囲には、その結論を裏付ける結果がありません。同等の回答品質を維持できると断定するのは避けるべきです。日本企業が試す際も、メモリー量だけで方式を決めず、業務上の判断に関わる回答が変化しないかを確認する必要があります。また、上記の容量は特定条件での予測です。長い社内文書を入力する用途に、そのまま当てはめることはできません。
llama.cppで試す前に、実行コードとファイルを固定
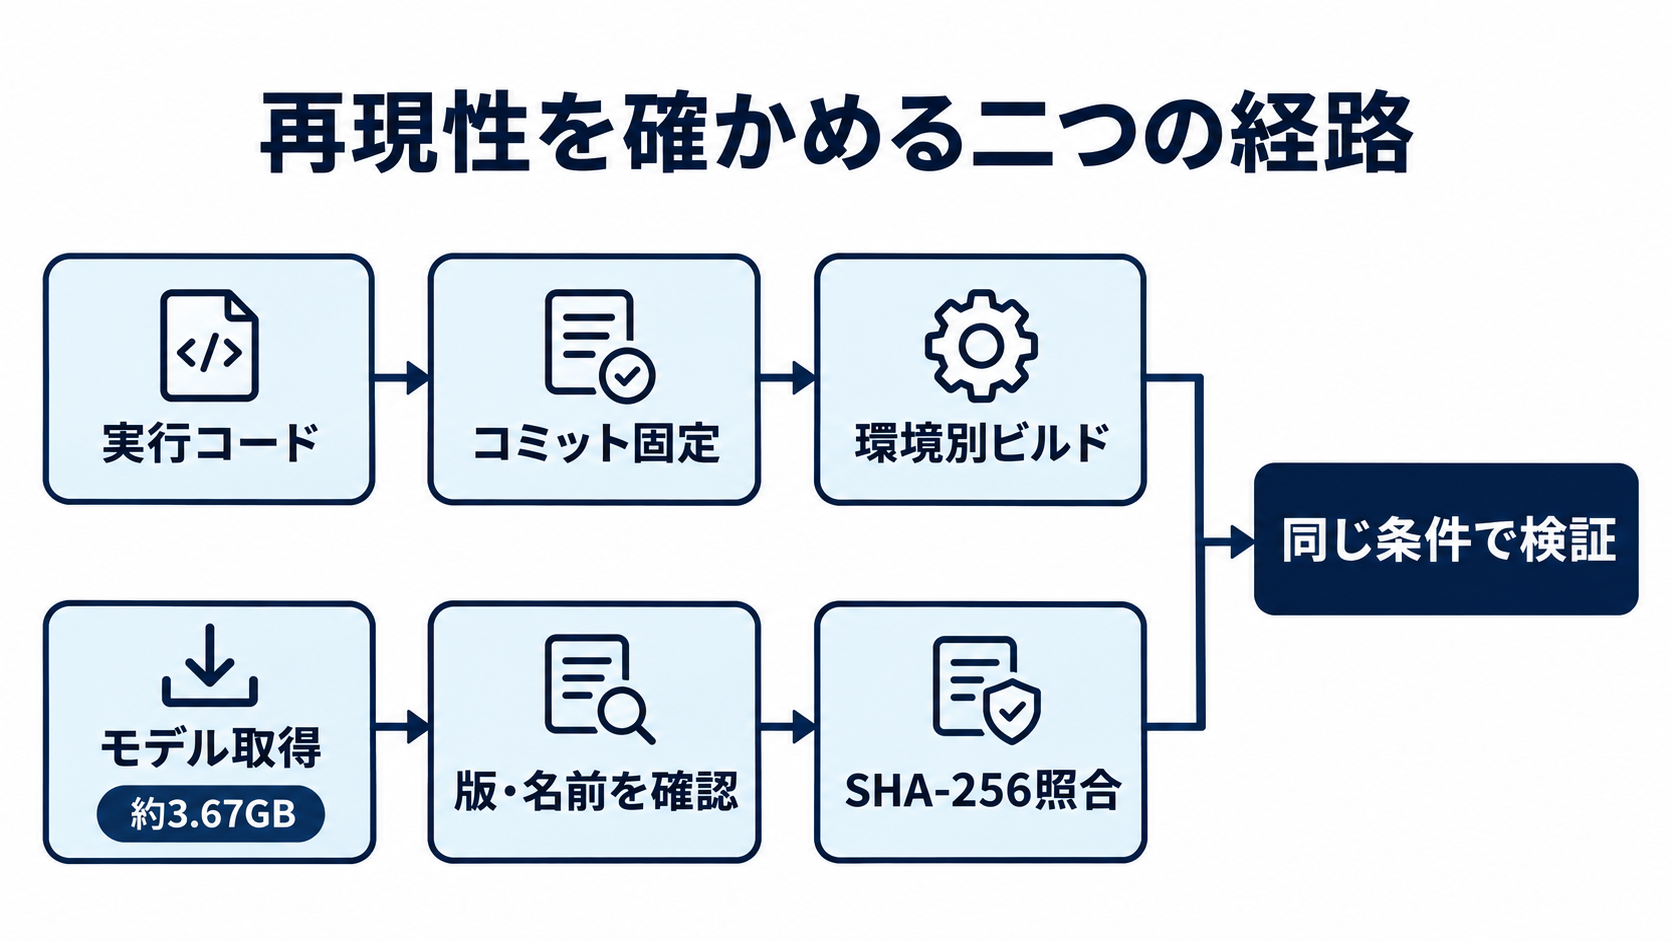
Doryを手元で動かす手順では、モデルを入手するだけでなく、対応する実行コードをそろえる必要があります。llama.cppは、言語モデルをさまざまな環境で実行するためのソフトウェアです。今回の検証手順は、Dory対応が開発途中にあることを前提に、NVIDIAのモデルカードが指定する分岐版のコードを使用しています。一般的な配布済みバイナリーで、同じように読み込めるとは想定していません。
コードは特定のコミット、つまり変更履歴上の版に固定されています。モデル側も、AIモデルなどを共有するHugging Face上のリポジトリについて取得する版を指定し、ダウンロード後にファイル容量とSHA-256を照合する構成です。SHA-256は、ファイルの内容から計算する識別値として使われます。検証対象のQ5_K_M形式のGGUFは約3.67GBで、提示された説明では、モデルカードに掲載されたチェックサムと一致しています。これは配布ファイルとの一致を確認するもので、回答品質を保証する検査ではありません。
ファイル名にも実務上の注意点があります。モデルカードのコマンドに登場する`dory-q5_k_m.gguf`という名前と、リポジトリ内の正式なファイル名は異なります。検証コードは実際の名前を指定して取得しています。こうした違いを放置すると、モデルの問題を調べる前に、ファイルが見つからない段階で作業が止まりかねません。ビルド設定も環境別で、MacではMetal、NVIDIA製GPUを使う環境ではCUDAに対応する設定を選んでいます。社内で比較結果を共有するなら、モデル名だけでなく、実行コードの版、ファイルの識別値、ハードウェア、起動条件を一緒に記録すると、別の担当者が同じ条件を再現しやすくなります。
導入判断は「速さ」より、許容できる回答を返すまでの負担
Doryの検証で企業が知りたいのは、1秒に何トークン生成できるかだけではないでしょう。反復を増やして生成が遅くなっても、必要な回答へ到達しやすくなれば、業務全体では有利になる可能性があります。反対に、回答が長くなるだけで、正確さや利用価値が変わらなければ、追加の計算を割り当てる理由は弱くなります。処理速度、回答の長さ、正答率を切り離さずに見る必要があります。
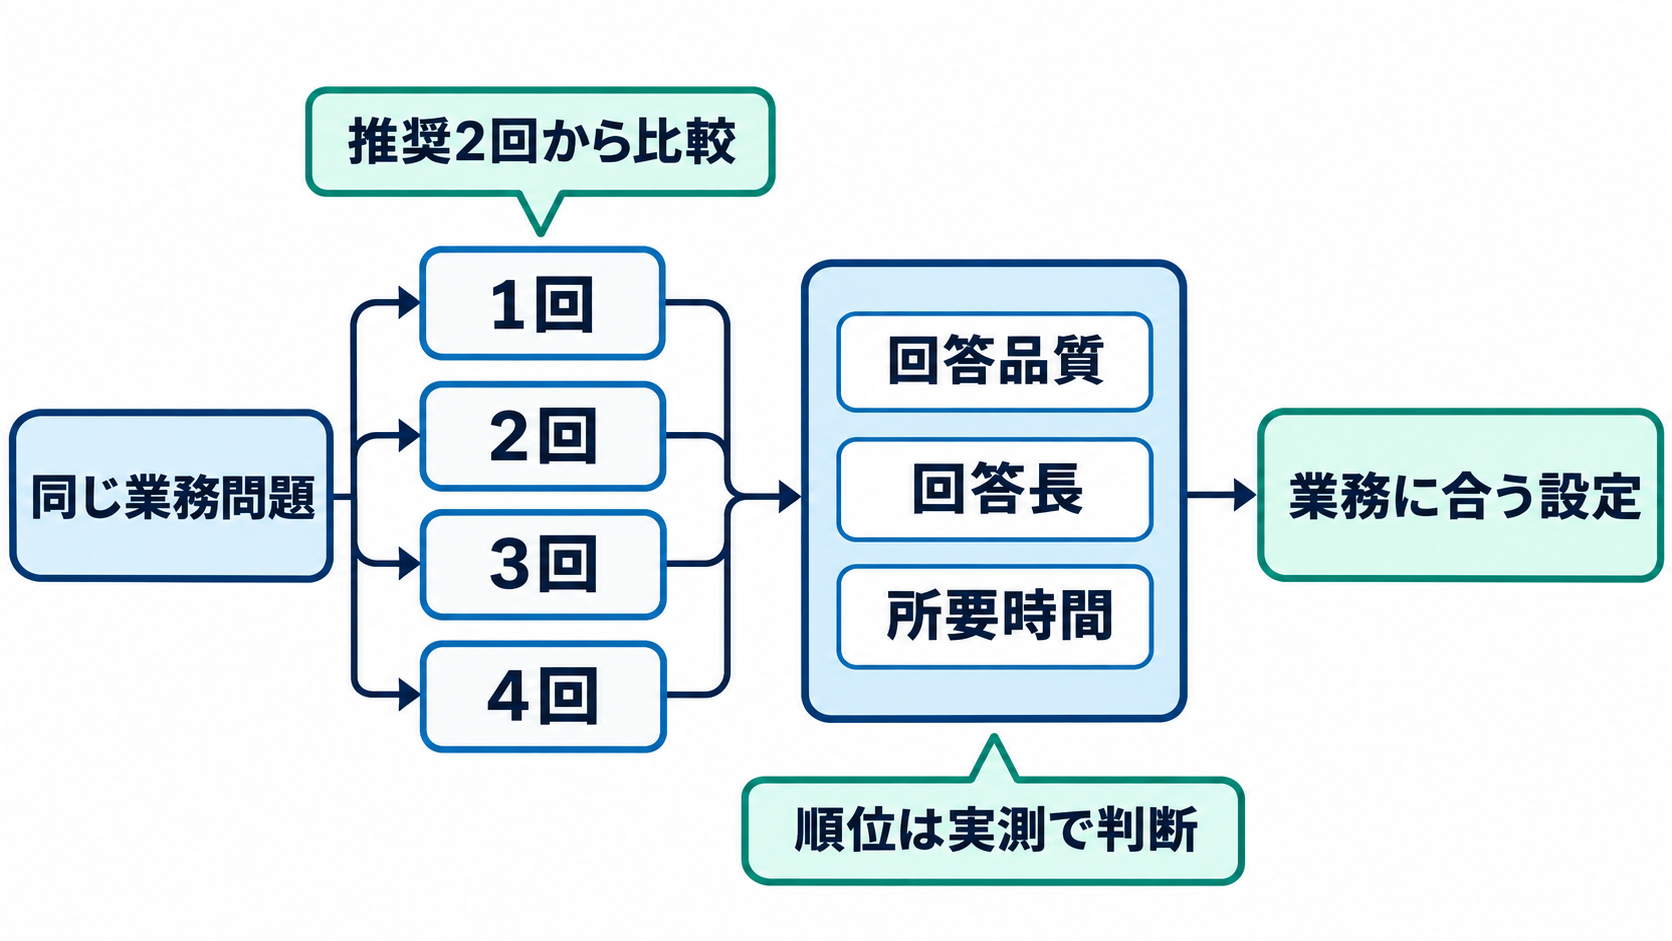
提示されたチュートリアルは、各反復回数の生成速度に加え、GSM8Kを用いた比較を計画しています。GSM8Kは、算数の文章題を使ってモデルの解答能力を評価するデータセットです。同じ問題を設定間で対応させ、正答率、回答長、正解1件当たりにかかる時間の変化を調べる設計になっています。ただし、提供された範囲には評価結果が含まれていないため、「4回が最も高精度」「2回が最も効率的」といった順位は示せません。算数の成績だけで、日本語の社内文書を扱う性能まで判断することもできません。
導入を検討する企業は、対象業務で許容できる回答の条件を先に決めると、比較の軸が明確になります。例えば、日本語での説明の正確さ、必要事項の抜け、回答を確認する担当者の負担などを、業務に応じた評価項目として設けられます。これらはDoryで確認済みの性能ではなく、社内評価を組む際の観点です。最初の一歩としては、推奨される2回反復を明示して起動し、実際に任せたい問い合わせを同じ条件で試すとよいでしょう。その結果を1回、3回、4回と比較し、追加の待ち時間に見合う改善があるかを判断します。モデルの大きさではなく、必要な回答を得るためにどれだけ計算を使うかを測ることが、Doryの構造を生かす評価になります。